


解决AI视频翻译后口型不同步与声音不自然的问题

在短视频出海和内容本地化的浪潮中,我们常遇到一种令人出戏的尴尬:画面里的人说着流利的法语或日语,但嘴唇动作却顽固地停留在中文发音的节奏上,或者声音虽然清晰,却带着一种毫无起伏的“机器人”冷漠感。这种音画割裂不仅削弱了内容的可信度,更让观众瞬间从情境中抽离。
很多创作者认为这是当前AI技术的天花板,只能忍痛接受。但实际上,口型不同步和声音不自然并非不可逾越的技术鸿沟,而是工作流中参数设置与工具选择的偏差。 只要理解背后的生成逻辑,并在关键环节进行针对性干预,完全可以将“译制片”般的违和感降至最低,甚至达到以假乱真的效果。
唇形重构:从“贴图”到“肌肉记忆”的同步
传统的配音只是替换音频轨道,而高质量的AI视频翻译必须涉及视觉层面的重构。当语言改变时,元音和辅音的口部开合形状截然不同。如果仅做音频替换,观众会敏锐地捕捉到这种生理上的不可能。
解决这一问题的核心在于使用支持“视觉重绘”或“唇形驱动”的工具。这类工具不只是调整时间轴,而是基于新生成的目标语言音频,重新计算并生成说话者的唇部运动轨迹。
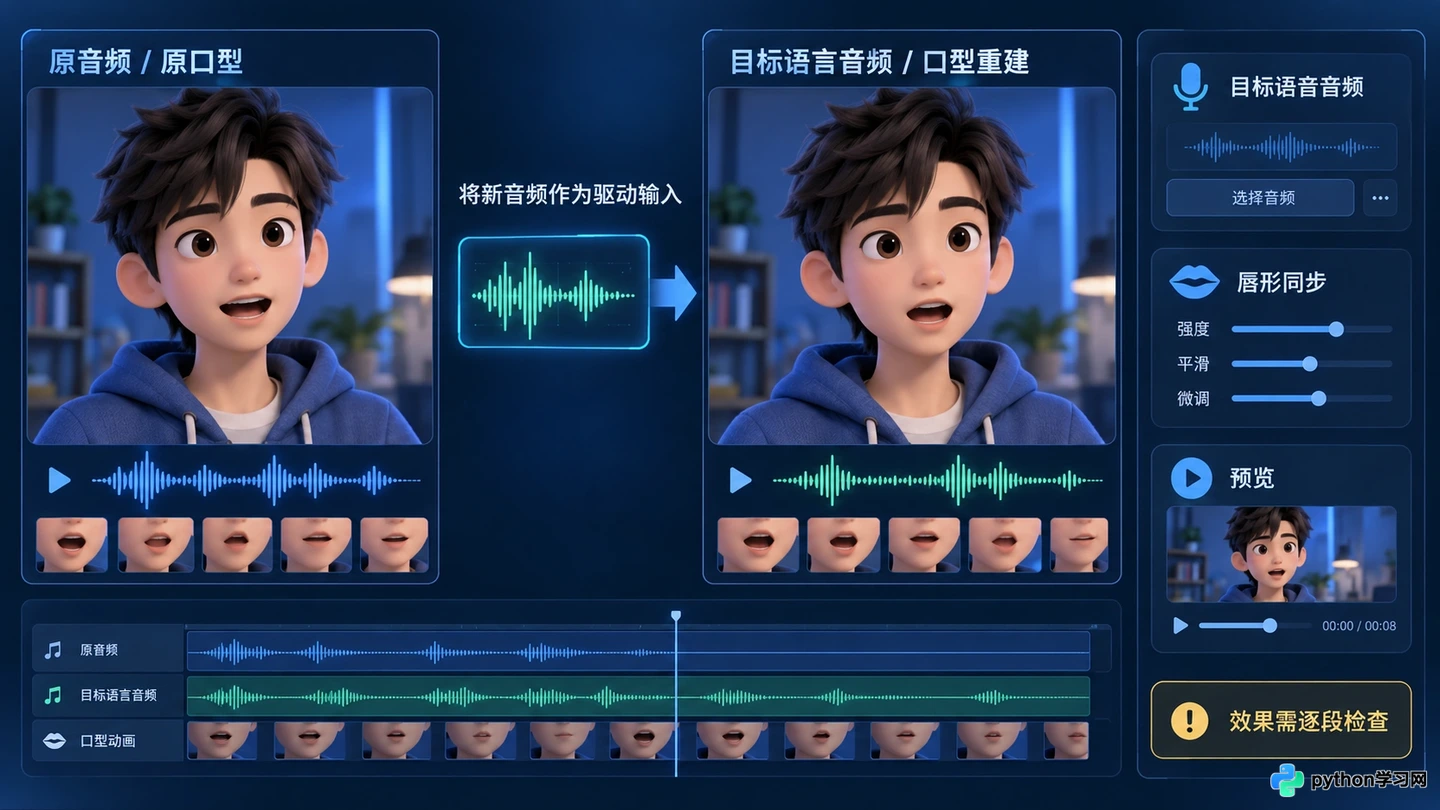
开启唇形同步功能后,AI根据新音频重新生成嘴部动画
在实际操作中,不要只关注翻译准确率,更要检查工具是否开启了“Lip Sync”(唇形同步)或“Visual Dubbing”(视觉配音)功能。以主流平台为例,开启该功能后,AI会逐帧分析原视频的嘴部关键点,并根据新音频的 phoneme(音素)序列生成对应的嘴型动画。
需要注意的是,这种重构在侧脸、快速转头或手部遮挡嘴部的场景下容易失效。因此,在拍摄源素材时,尽量保持正面平视、光线均匀且无遮挡,是为后期AI处理留出最大余地的最佳实践。 如果源视频本身存在大量遮挡,强行开启唇形同步可能导致面部扭曲,此时不如关闭该功能,转而依靠精准的剪辑来规避穿帮镜头。
声音质感:打破“机械音”的情感壁垒
即使口型完美匹配,如果声音听起来像是一个没有感情的朗读机器,观众的沉浸感依然会被破坏。许多默认设置的AI语音缺乏呼吸感、语速恒定且音调单一,这与真人说话时的随机性和情感波动相去甚远。
要解决声音不自然的问题,关键在于对“克隆音色”和“情感参数”的精细调控。首先,确保使用的工具支持“Voice Cloning”(声音克隆),并尽可能提供高质量、无背景噪音的源音频样本。样本越纯净,AI提取的音色特征就越接近本人,从而保留说话者的个人辨识度。
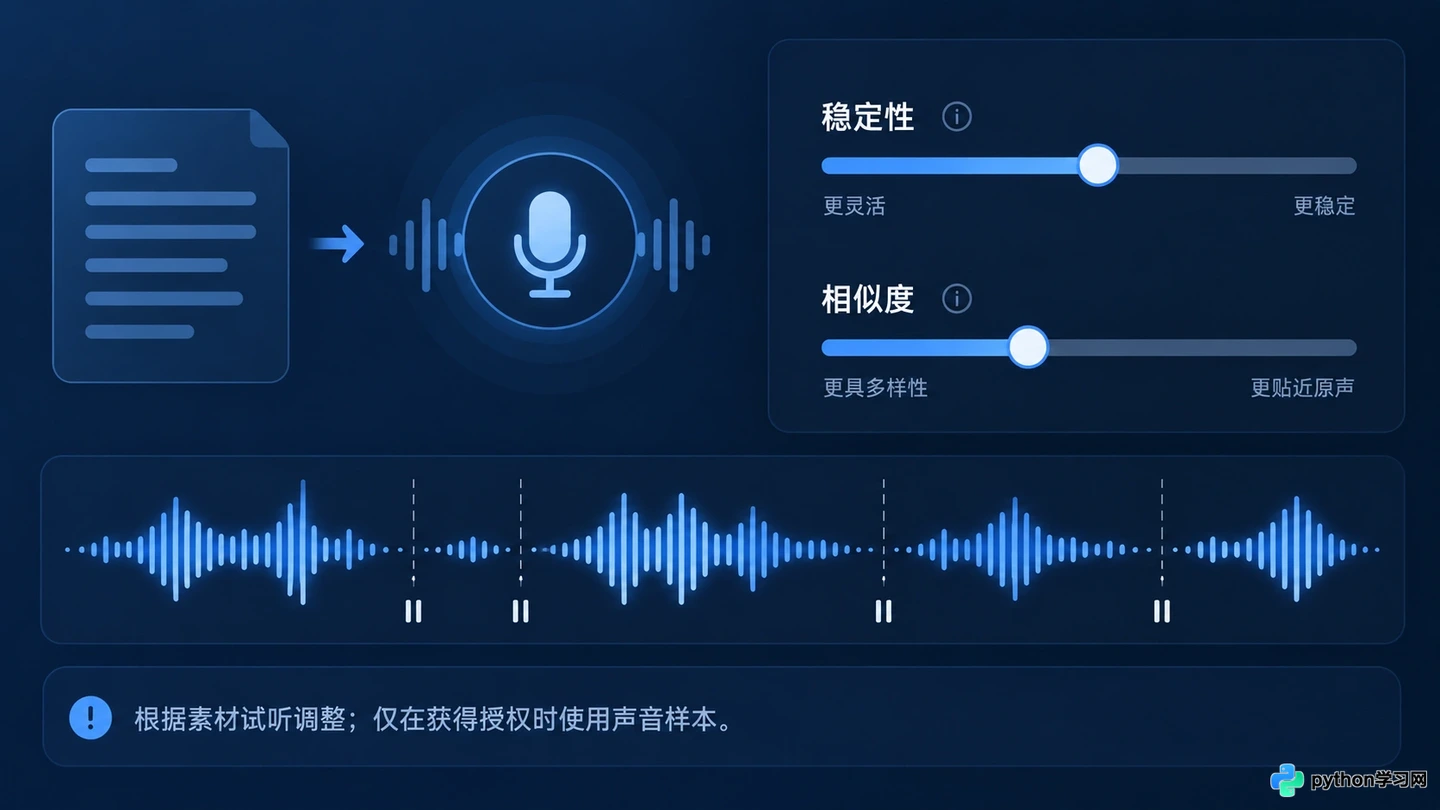
调整稳定性和相似度参数以平衡声音的自然波动与音色还原
其次,深入调整语音生成的细节参数。大多数高级工具允许调节“Stability”(稳定性)和“Similarity”(相似度)。过高的稳定性会导致声音平淡如水,适当降低稳定性可以引入自然的语气波动和呼吸声;而过高的相似度有时会保留源语言的口音痕迹,需要在两者间寻找平衡点。
此外,利用“停顿标记”或手动插入静音片段是提升自然度的捷径。真人说话时有思考的停顿和语气的转折,AI往往一气呵成。在文本输入阶段,通过添加逗号、句号或特定的停顿标签(如 <break time="0.5s" />),可以强制AI在关键位置换气,模拟真实的交流节奏。
语境适配:让翻译懂“人话”而非只懂“单词”
声音和口型的技术指标达标后,另一个隐形的杀手是“翻译腔”。直译导致的句式冗长、用词生硬,会让配音演员(即使是AI)难以用自然的语调演绎。例如,中文的短句在翻译成英语时若保留原有结构,往往显得支离破碎,导致AI配音出现不自然的断句。
优化这一环节,需要在进入TTS(文本转语音)之前,对翻译文本进行“口语化润色”。不要直接使用机器翻译的原始结果,而是借助大语言模型(LLM)进行二次加工。提示词应明确要求:“将以下文本转换为适合口语表达的[目标语言],保持简短、自然,符合当地人的说话习惯。”
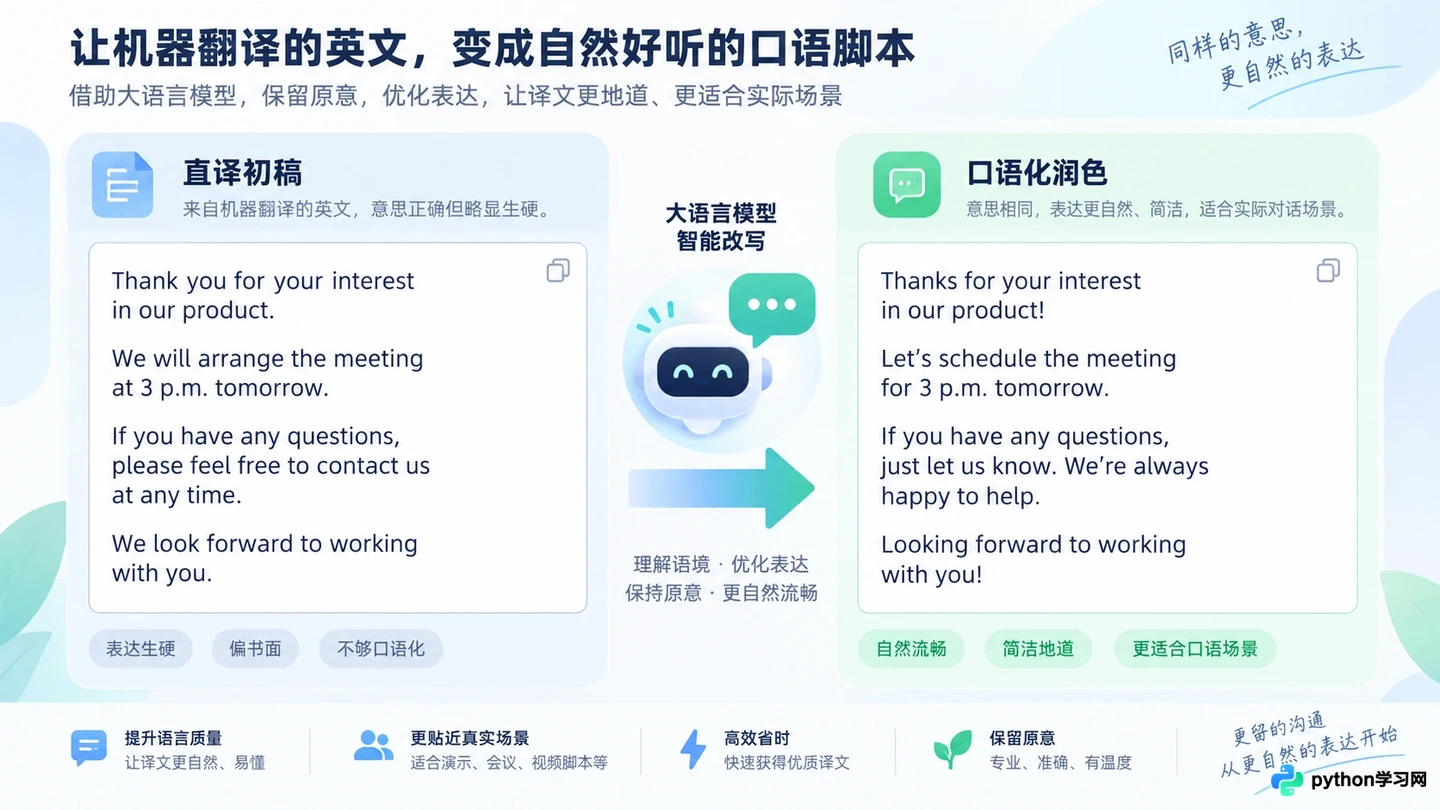
使用LLM将机器翻译文本润色为符合目标语言习惯的口语脚本
经过润色的文本,其音节数量和重音分布更符合目标语言的韵律。这不仅让听众更容易理解,也让AI语音引擎能更准确地分配重音和语调,从而在听感上更加流畅自然。记住,好的配音始于好的剧本,AI只是执行者,而非编剧。
后期兜底:视听错觉的最后防线
即便使用了最先进的端到端AI工具,偶尔仍会出现细微的不同步或瑕疵。这时,传统视频剪辑技巧就成了最后的救命稻草。不要指望AI一次性输出完美成品,预留后期调整的空间是专业工作流的标配。
在剪辑软件中,可以通过微调音频轨道的前后位移来解决轻微的音画不同步。通常,人眼对声音滞后于画面的容忍度低于声音超前,因此尝试将音频提前几帧(约0.1-0.2秒)往往能获得更佳的同步感知。
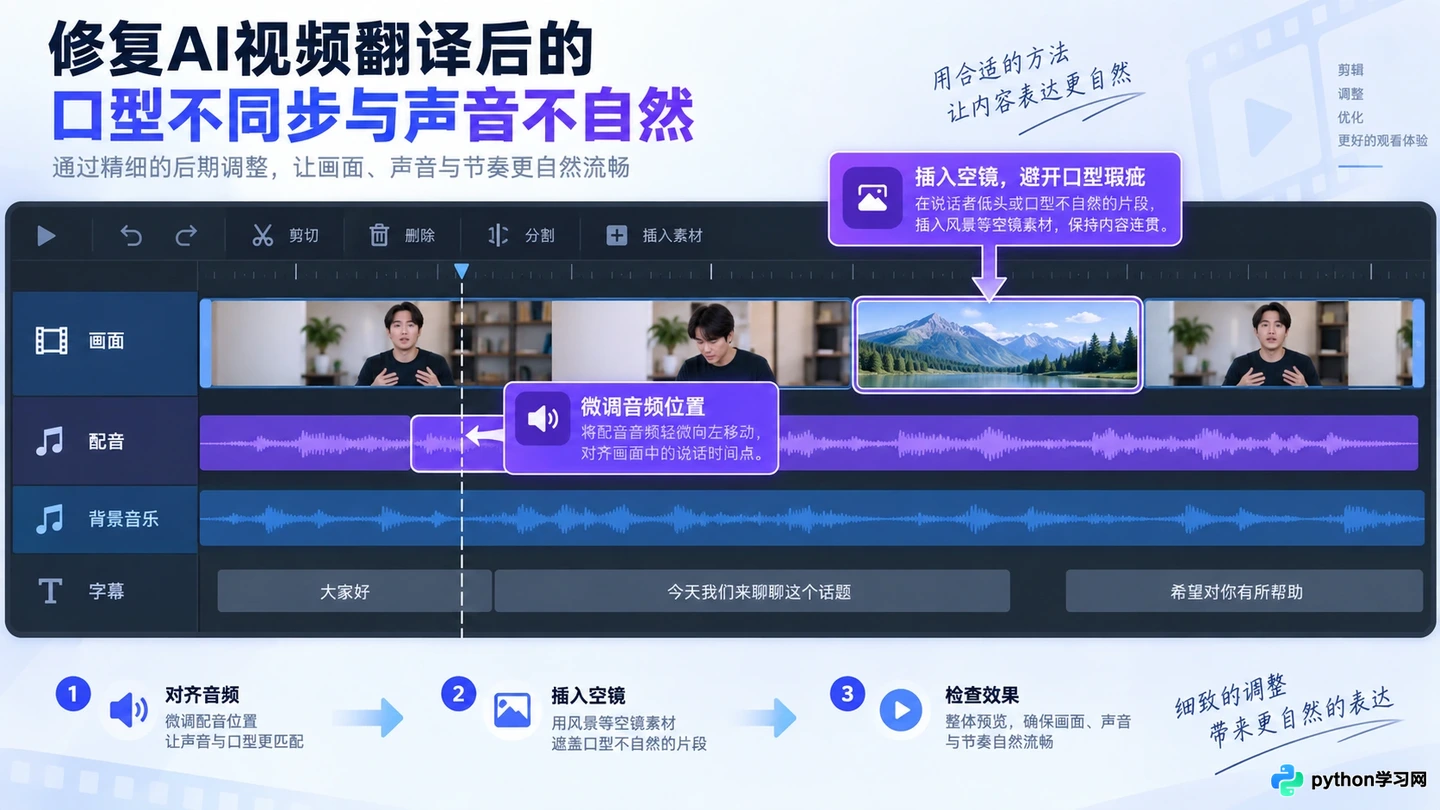
在剪辑软件中微调音频轨道位置并插入空镜以规避口型瑕疵
对于无法修复的口型错误,可以使用“遮罩”或“裁切”策略。例如,在说话者低头、转身或大笑的瞬间切入B-roll(空镜)或相关素材,避开嘴部特写。这种视听语言的转换不仅能掩盖技术缺陷,还能丰富视频的节奏感,使观众注意力从“找茬”转移到内容本身。
此外,添加背景音乐和环境音效也是掩盖AI语音瑕疵的有效手段。适度的背景音可以模糊语音边缘的生硬感,营造更真实的现场氛围,让大脑自动补全那些微小的不自然之处。
结语:技术是杠杆,审美是支点
解决AI视频翻译的口型与声音问题,本质上是一场技术与审美的博弈。我们不再仅仅追求“翻译出来”,而是追求“像当地人一样表达”。
对于新闻播报、教学课件等对准确性要求极高但情感需求较低的场景,标准的AI翻译已足够胜任;但对于访谈、Vlog或品牌故事等强人格化内容,必须投入精力在唇形同步、音色克隆和文本润色上。 只有当技术服务于内容的真实感时,AI视频翻译才能真正打破语言的巴别塔,而不是建造一座新的恐怖谷。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















