


PySpark中怎么构建可复用的NLP数据处理Pipeline

Transformer与Estimator标准组件,将文本清洗、分词、停用词去除及向量加权编排为单一管道对象,拟合后保存为静态的PipelineModel,从而在任何新的批处理或流式环境中一键加载直接使用。
一、为什么NLP处理需要统一的Pipeline架构
在常规数据处理中,开发者容易将分词、清洗与词频转换写成零散的自定义函数(UDF)。这种方式在快速实验中虽然灵活,但在工程落地时存在三个显著隐患:
- 训练与预测逻辑脱节(Data Leakage & Schema Drift): 预测阶段如果重新计算IDF(逆文档频率)或词频词表,会导致词向量维度不一致或权重偏移。
- 分布式状态无法自动传递: 像词袋词表(Vocabulary)这种依赖全局统计的元数据,若不封装为估算产物,很难在分布式节点间安全复用。
- 部署成本高昂: 下游工程人员需要重复实现与上游算法完全一样的字符串处理步骤,维护成本成倍增长。
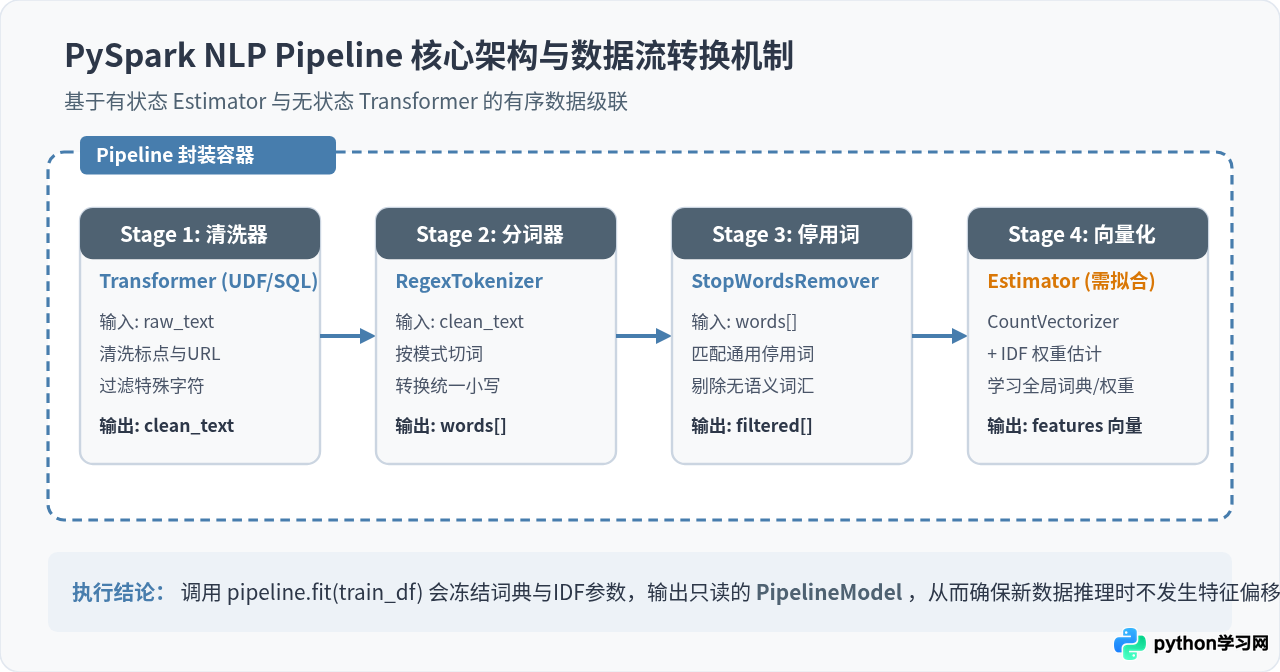
PySpark MLlib借鉴了管道模式,通过将无状态的转换操作(Transformer)与有状态的训练拟合操作(Estimator)有机串联,解决了上述问题。
二、构建NLP Pipeline的核心步骤
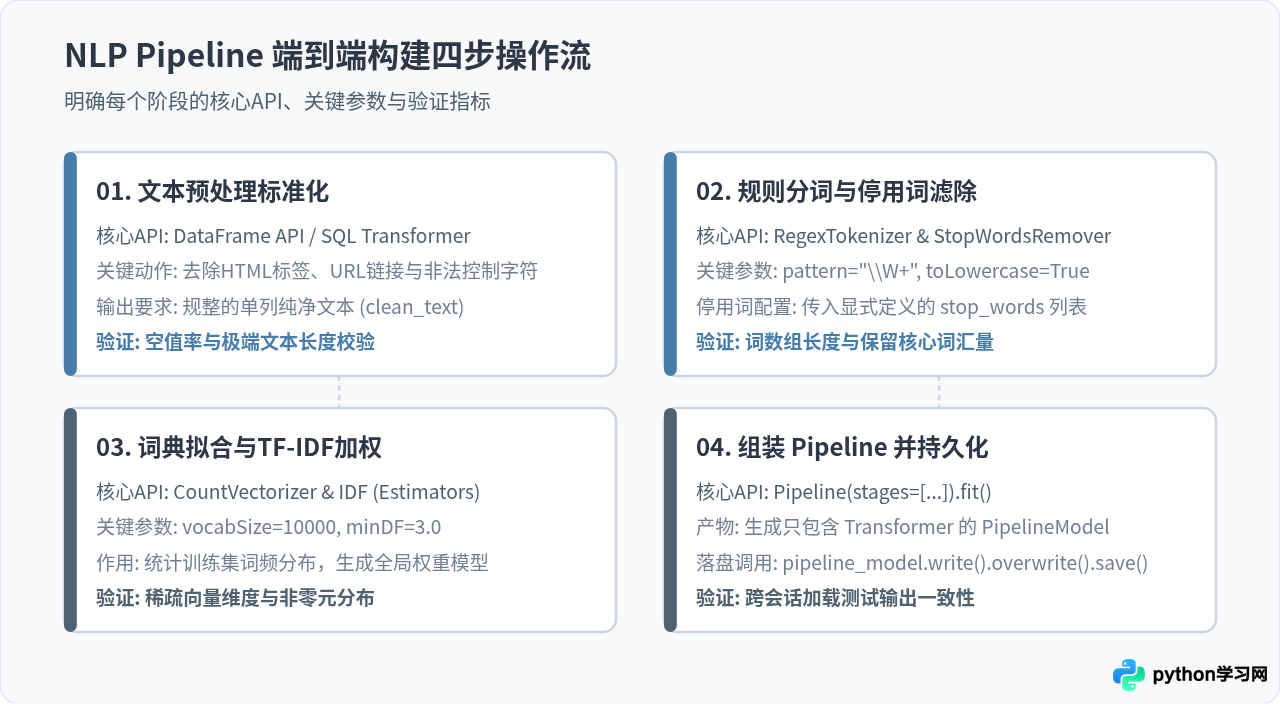
构建完整的NLP数据处理Pipeline通常分为四个递进阶段:自定义文本清洗、分词、停用词去除以及特征向量化。
1. 步骤一:数据准备与清洗组件
原生Spark未提供开箱即用的高级字符串清洗Transformer。为了使清洗步骤能直接嵌入Pipeline,推荐使用SQL表达式封装,或者实现基于Transformer与DefaultParamsWritable的标准子类。这样在保存Pipeline时,类参数也能一同被正确持久化。
2. 步骤二:正则分词(RegexTokenizer)
使用pyspark.ml.feature.RegexTokenizer可以高效替代Python自带的字符串切分。该组件支持直接在分布式节点底层调用Java层的高性能正则表达式,通过设置pattern与gaps属性,一次性完成符号切分与空白字符清理。
3. 步骤三:停用词移除(StopWordsRemover)
StopWordsRemover用于去除无实际语义的高频虚词(如“的”、“在”、“以及”等)。在复用场景下,最关键的是显式提供一个冻结的词表数组作为参数,而不是依赖环境的默认配置,保证不同集群计算结果的一致性。
4. 步骤四:词频量化与逆文档加权(CountVectorizer + IDF)
相比HashingTF,CountVectorizer在可复用工程中具有显著优势:
- 无哈希碰撞风险: 显式构建固定大小的词典,特征维度与真实词条完全映射。
- 逆向解释能力: 训练后词表直接保存在生成的
CountVectorizerModel中,方便线上排查特定特征对预测结果的影响。
三、完整可运行代码示例
以下代码演示从SparkSession初始化、数据构造、Pipeline组装、拟合、序列化保存到重新加载的完整闭环。代码可以直接在PySpark 3.x环境中执行。
from pyspark.sql import SparkSession
from pyspark.ml import Pipeline, PipelineModel
from pyspark.ml.feature import RegexTokenizer, StopWordsRemover, CountVectorizer, IDF
from pyspark.sql.functions import col, regexp_replace, trim, lower

# 1. 初始化 Spark 会话
spark = SparkSession.builder \
    .appName("Reusable-NLP-Pipeline") \
    .master("local[2]") \
    .getOrCreate()

# 2. 模拟训练与测试数据集
train_data = [
    (1, "PySpark makes NLP processing simple, fast and scalable!"),
    (2, "Data pipeline in spark is reusable across train and test."),
    (3, "Machine learning pipelines require careful schema design.")
]
schema = ["id", "raw_text"]
train_df = spark.createDataFrame(train_data, schema)

# 3. 基础文本清洗(通常在进入 Pipeline 前做通用列规范,或使用可保存的 SQLTransformer)
train_cleaned = train_df.withColumn(
    "clean_text",
    trim(lower(regexp_replace(col("raw_text"), "[^a-zA-Z0-9\\s]", " ")))
)

# 4. 定义 Pipeline 的各个阶段 (Stages)
# 阶段 A: 正则分词器
tokenizer = RegexTokenizer(
    inputCol="clean_text",
    outputCol="tokens",
    pattern="\\s+",
    gaps=True
)

# 阶段 B: 停用词移除器 (显式提供词表以保证跨环境复用一致)
custom_stopwords = ["and", "is", "in", "the", "a", "makes"]
remover = StopWordsRemover(
    inputCol="tokens",
    outputCol="filtered_tokens",
    stopWords=custom_stopwords
)

# 阶段 C: 词频向量化 (构建固定大小的高频词典)
cv = CountVectorizer(
    inputCol="filtered_tokens",
    outputCol="raw_features",
    vocabSize=1000,
    minDF=1.0
)

# 阶段 D: 逆文档频率 (TF-IDF 加权)
idf = IDF(
    inputCol="raw_features",
    outputCol="features"
)

# 5. 装配 Pipeline 并拟合数据
pipeline = Pipeline(stages=[tokenizer, remover, cv, idf])
pipeline_model = pipeline.fit(train_cleaned)

# 6. 持久化保存 PipelineModel (可导出至 HDFS / S3 / 本地磁盘)
save_path = "/tmp/reusable_nlp_pipeline_model"
pipeline_model.write().overwrite().save(save_path)
print(f"PipelineModel 已成功保存至: {save_path}")

# 7. 生产环境加载复用 (新会话或离线批量作业)
loaded_model = PipelineModel.load(save_path)

# 8. 验证新数据的无缝转换
test_data = [(4, "PySpark pipeline is fast and scalable for learning.")]
test_df = spark.createDataFrame(test_data, schema)
test_cleaned = test_df.withColumn(
    "clean_text",
    trim(lower(regexp_replace(col("raw_text"), "[^a-zA-Z0-9\\s]", " ")))
)

# 直接调用 transform,无需重复 fit
predictions = loaded_model.transform(test_cleaned)
predictions.select("id", "tokens", "filtered_tokens", "features").show(truncate=False)

spark.stop()
PipelineModel后,调用transform时输入DataFrame的列名和数据类型必须与训练时完全一致。例如本例中的clean_text列,如果缺失或类型不匹配,Spark会在解析阶段抛出AnalysisException。
四、PipelineModel 的持久化与多环境分发
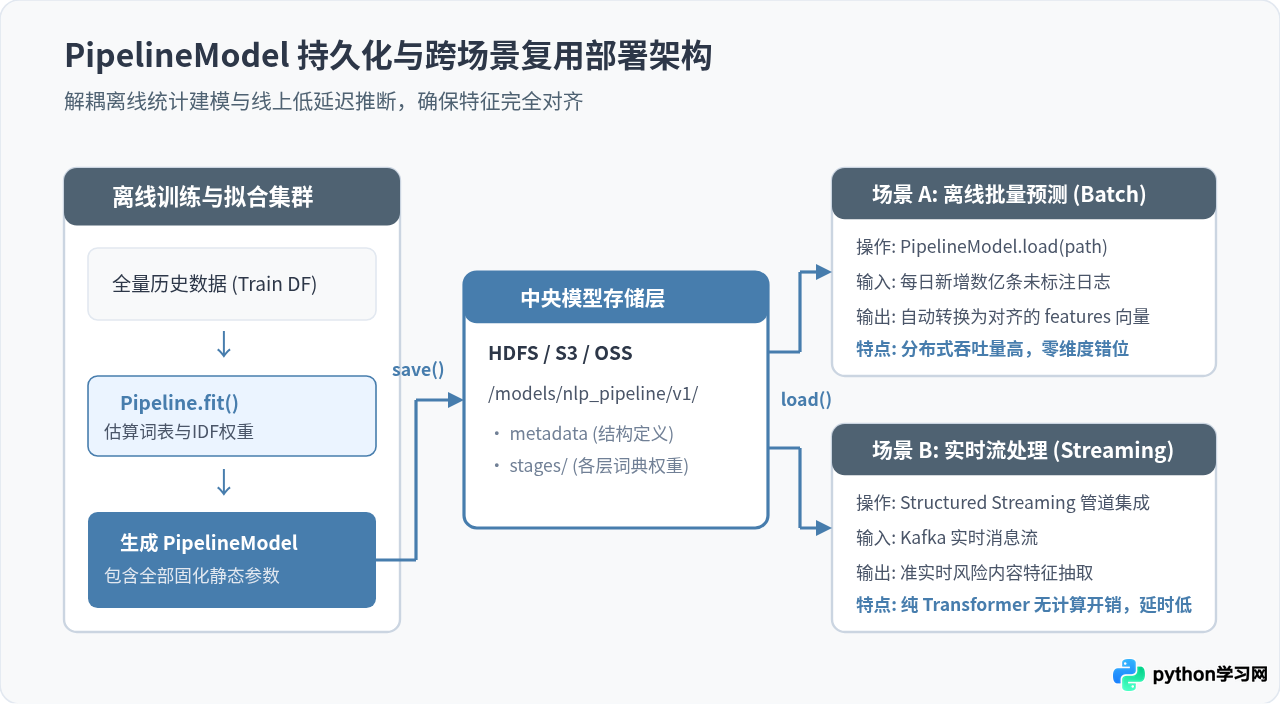
可复用性的关键衡量标准是“一次拟合,多处运行”。训练阶段产出的PipelineModel是一个自包含的目录,包含了元数据、各个Stage的超参数以及在训练集上学到的全局统计量(如词汇表vocabulary与IDF逆文档权重向量)。
五、生产落地的四个关键考量
在将可复用NLP Pipeline投入大规模生产使用时,还需要特别关注以下四个维度的设计边界:
| 考量维度 | 常见风险与问题 | 工程推荐做法 |
|---|---|---|
| 未登录词(OOV)处理 | 新数据中出现的大量未见词汇可能导致稀疏矩阵空值或维度异常。 | CountVectorizer会自动忽略不在词典中的词,无需手动兜底。但需通过调小minDF保证常见词入选。 |
| 词汇表膨胀控制 | 长尾文本导致词典无节制增加,使得模型在Executor节点间分发时产生巨大网络与内存开销。 | 严格限制vocabSize(如10,000~50,000),并设置minDF=3.0剔除极端偶发拼写错误。 |
| 自定义逻辑序列化 | 如果在Pipeline中混入未继承DefaultParamsWritable的普通Python函数,会导致save()失败。 |
复杂分词或正则应优先封装为SQL函数表达式,或通过原生PySpark标准API组装,避免非原生序列化对象。 |
| 版本与元数据追踪 | 模型更新后覆盖旧路径,导致在线正在运行的流式作业出现状态反序列化异常。 | 持久化路径按版本号隔离命名(如pipeline_model_v1.2.0),通过元数据配置服务动态指向最新生效路径。 |
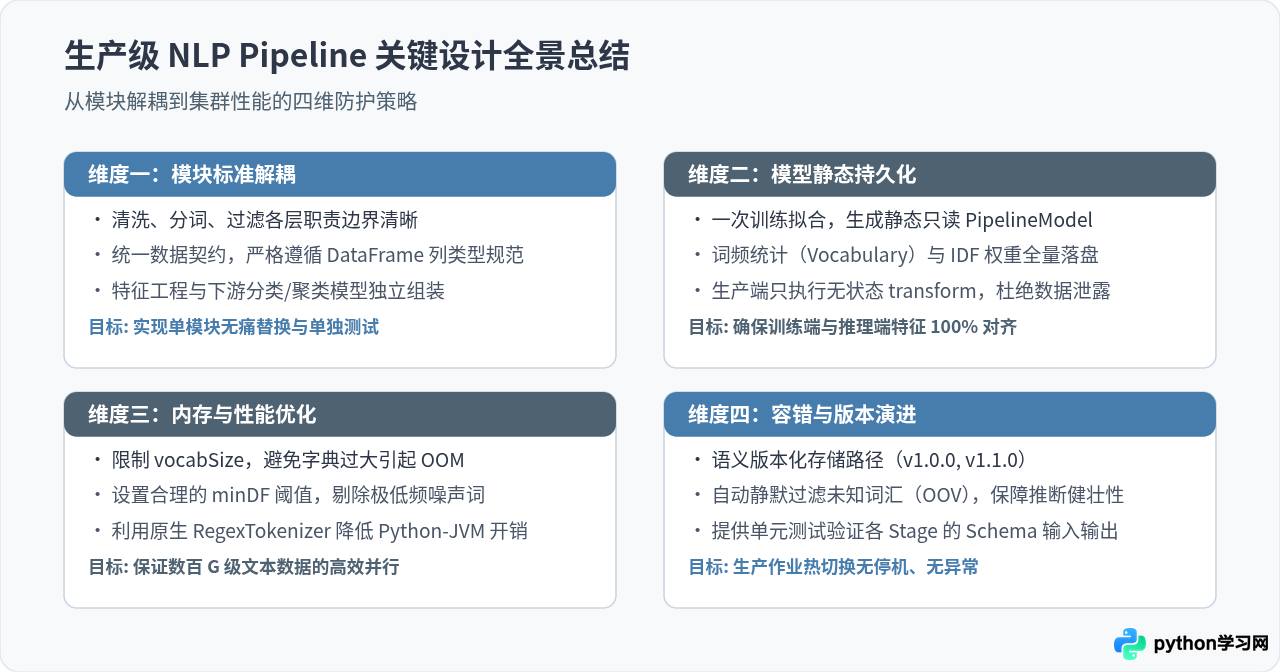
通过将NLP处理流程严格封装为PySpark ML Pipeline,不仅能够彻底摆脱传统手写清洗脚本的维护泥潭,还能直接无缝衔接Spark内置的各类分类、聚类与回归模型,为构建稳定、高吞吐的工业级大数据NLP系统打下坚实的基础。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















