


Python装饰器中怎么正确透传原函数的返回值

在编写Python装饰器时,正确透传原函数返回值的核心操作是在内层包装函数(wrapper)内部显式使用变量接收被修饰函数的调用结果,并在包装函数的末端将其显式返回(即 result = func(*args, **kwargs) 与 return result)。若遗漏返回语句,Python包装函数将隐式返回 None,导致外部调用者完全无法获取原函数的计算产物。
一、常见故障:被装饰器“吞噬”的返回值
初学者在编写装饰器时,注意力往往集中在前置校验、耗时统计或日志打印等附加逻辑上,容易忘记将原函数的执行结果传回给调用方。以下是一段典型的错误示例:
# 错误示例:遗漏了 return 语句
def record_log(func):
    def wrapper(*args, **kwargs):
        print(f"正在调用函数: {func.__name__}")
        func(*args, **kwargs)  # 执行了原函数,但未接收返回值,也未返回任何内容
    return wrapper

@record_log
def calculate_sum(a, b):
    return a + b

# 示例调用
total = calculate_sum(10, 20)
print("计算结果:", total)  # 示例输出:计算结果: None
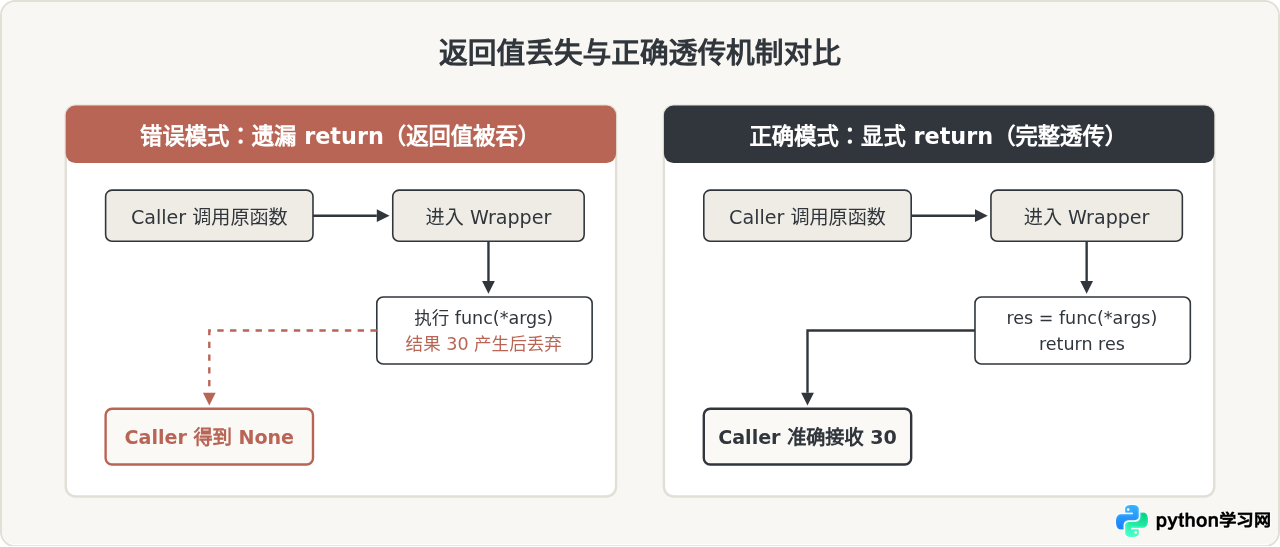
在上述代码中,calculate_sum(10, 20) 本应返回数值 30,但外部实际接收到的却是 None。
这是因为语法糖 @record_log 的本质等价于 calculate_sum = record_log(calculate_sum)。完成装饰后,外部调用 calculate_sum(10, 20) 实际执行的是 wrapper(10, 20)。Python规定函数内部如果没有显式的 return 语句(或仅写了空 return),函数运行结束时会自动返回 None。因此,即使原函数在内部完成了运算,其返回值由于没有被 wrapper 返回,就此中断并丢失。
二、标准写法:正确透传返回值的四步法
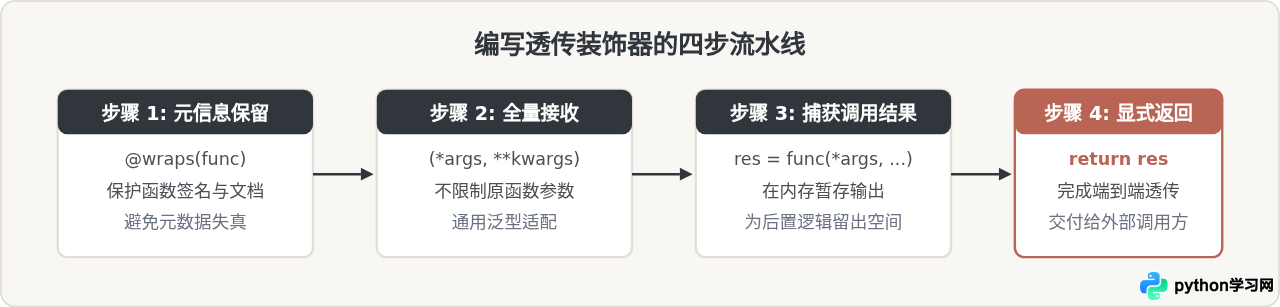
为了确保装饰器具有良好的通用性且不破坏原有业务逻辑,构建一个标准装饰器应遵循以下四个关键步骤:
- 保留原函数元信息:导入
functools.wraps并在wrapper上进行修饰,确保函数名(__name__)与文档字符串(__doc__)不被覆盖。 - 完整接收全部参数:包装函数使用
*args, **kwargs签名,保证能兼容修饰任何位置参数与关键字参数的原函数。 - 执行原函数并用变量捕获产物:执行
result = func(*args, **kwargs),暂存原函数计算所得的数据。 - 在包装函数尾部显式返回:使用
return result,将数据送回外部调用链路。
下面是符合规范的标准实现代码:
import functools
import time

def measure_time(func):
    """通用耗时统计装饰器,严格透传原函数返回值"""
    @functools.wraps(func)
    def wrapper(*args, **kwargs):
        start_time = time.perf_counter()

        # 核心:执行原函数并用变量接收其返回值
        result = func(*args, **kwargs)

        elapsed = time.perf_counter() - start_time
        print(f"[{func.__name__}] 运行完成,耗时: {elapsed:.6f} 秒")

        # 核心:必须显式将原函数的执行结果返回
        return result

    return wrapper

@measure_time
def fetch_user_data(user_id):
    # 模拟业务函数,返回字典数据
    return {"id": user_id, "name": "Alice", "role": "developer"}

# 验证调用
user_info = fetch_user_data(1001)
print("获取到的数据:", user_info)
# 示例输出:
# [fetch_user_data] 运行完成,耗时: 0.000003 秒
# 获取到的数据: {'id': 1001, 'name': 'Alice', 'role': 'developer'}
通过这种写法,无论是基本数据类型(整数、字符串)、复合容器(列表、字典),还是自定义对象,都可以被完整、无损地递交给外部调用者。
三、实际应用:包含后置操作与异常保障的返回值流转
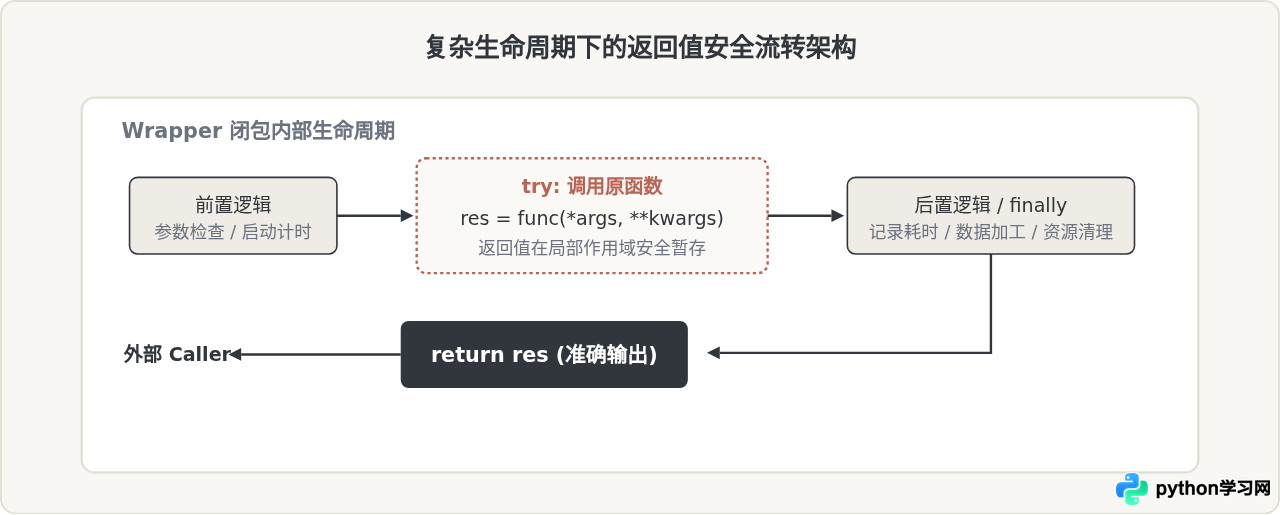
在生产环境中,装饰器往往承担更复杂的工作,比如资源清理、事务提交或异常重试。如果在执行原函数后发生了异常,或者后置逻辑需要访问原函数的返回值,就需要考虑执行生命周期的安全性。
1. 使用 try...finally 保证清理与返回安全
当装饰器需要确保某段清理代码(如关闭连接、重置上下文)必定执行时,应将原函数的调用及后置代码放入 try...finally 块中:
def safe_execution_logger(func):
    @functools.wraps(func)
    def wrapper(*args, **kwargs):
        print(f"准备开始执行: {func.__name__}")
        try:
            # 在 try 块中获取原函数返回值
            result = func(*args, **kwargs)
            return result
        finally:
            # 无论原函数成功还是抛出异常,finally 都会执行
            # 但若未抛异常,try 中的 return result 仍能正常交付
            print(f"执行生命周期结束: {func.__name__}")
    return wrapper
2. 对返回值进行校验或包装后再透传
有些装饰器的职能是对返回值做统一规范化(例如将原始数据封装成统一API响应格式)。此时虽然对返回值进行了修饰,但依然属于“基于原返回值的数据加工”,同样必须通过 return 输出:
def api_response_wrapper(func):
    @functools.wraps(func)
    def wrapper(*args, **kwargs):
        raw_result = func(*args, **kwargs)
        # 加工或校验原返回值
        wrapped_result = {
            "code": 200,
            "data": raw_result,
            "status": "success"
        }
        return wrapped_result
    return wrapper
四、常见误区与特别注意事项
1. 条件分支中的“漏网之鱼”
若包装函数内部包含了条件判断(如权限校验、缓存命中分支),必须确保每一个代码退出分支都显式处理了返回值:
def cache_decorator(func):
    cache_store = {}

    @functools.wraps(func)
    def wrapper(*args):
        if args in cache_store:
            # 分支 1:命中缓存时,必须返回缓存中的数据
            return cache_store[args]

        # 分支 2:未命中时,计算并回写缓存,最后返回新结果
        result = func(*args)
        cache_store[args] = result
        return result  # 若此处漏写,首次计算将返回 None

    return wrapper
2. 原函数为生成器(含有 yield)时的透传
当被装饰的原函数是一个生成器函数时,执行 result = func(*args, **kwargs) 得到的并不是单个具体的数值,而是一个生成器对象(Generator Object)。
此时直接 return result 依然是完全正确的,调用方拿到生成器对象后即可正常执行 for item in result 或 next(result)。但需要注意的是,原函数内部的代码只有在外部迭代发生时才会真正执行,因此包装函数后置的计时或日志语句若写在 return result 之前,仅代表“生成器对象构建完成的时间”,并不代表“全部数据迭代生成完毕的时间”。
3. 带参数装饰器的多层嵌套结构
当装饰器自身接收参数时,代码会演变成三层嵌套结构。请务必牢记:透传返回值的动作始终发生在最内层的具体执行包装函数中,外层各函数分别负责接收配置参数和原函数对象:
def retry(max_attempts=3):
    """带参数的装饰器:最外层接收装饰器配置"""
    def decorator(func):
        """中间层接收被修饰的原函数"""
        @functools.wraps(func)
        def wrapper(*args, **kwargs):
            """最内层负责实际调用并透传返回值"""
            last_exception = None
            for attempt in range(1, max_attempts + 1):
                try:
                    result = func(*args, **kwargs)
                    return result  # 成功时直接返回结果
                except Exception as e:
                    last_exception = e
                    print(f"第 {attempt} 次尝试失败,重试中...")
            raise last_exception
        return wrapper
    return decorator
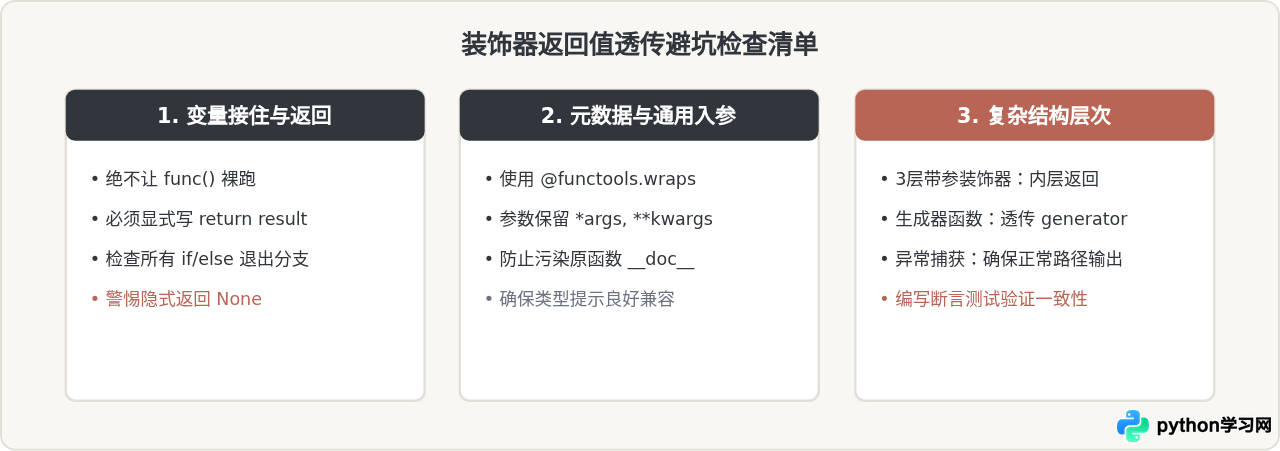
编写任何装饰器时,请时刻牢记:“入参用全能解包(*args, **kwargs),执行必捕获(result = func(...)),退出必显式(return result)”。只要在编写包装函数的最后一步加上这一行返回语句,就能从根本上避免返回值被吞噬的静默缺陷。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















