


Python类与实例的关系是什么

一、类与实例的核心概念:蓝图与实体
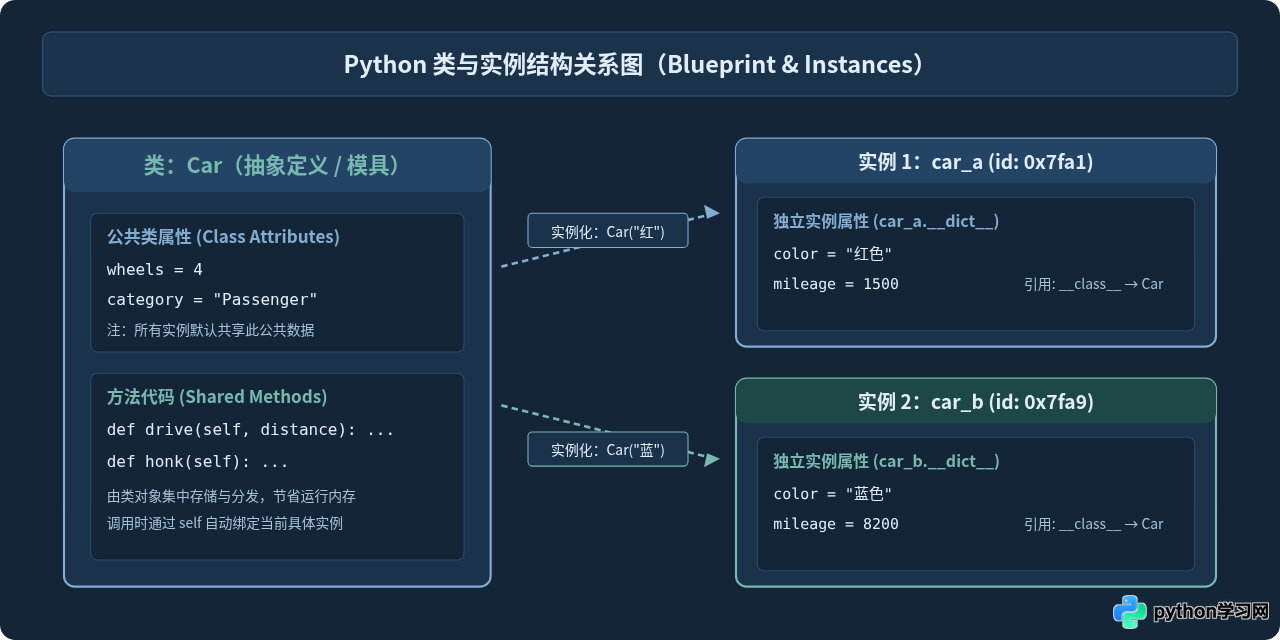
假设你正在开发一套车辆管理系统。如果每登记一辆车都要重新编写计算行驶里程的方法、重新声明车辆的状态字段,代码很快就会变得混乱不堪。在面向对象编程中,我们通过“类”定义出通用的汽车标准,包含品牌、油量以及加速、制动等行为;而马路上跑的红色汽车、蓝色汽车,则是根据这份标准制造出来的一辆辆具体“实例”。
在Python的内存视图中,这种对应关系尤为清晰:类本身也是一个在内存中只存在一份的对象,保存着公共方法和类层级的属性;通过类实例化得到的具体对象,各自拥有一块独立的内存空间,用于存储属于该实体的专属状态。
二、从类到实例:创建过程的执行步骤
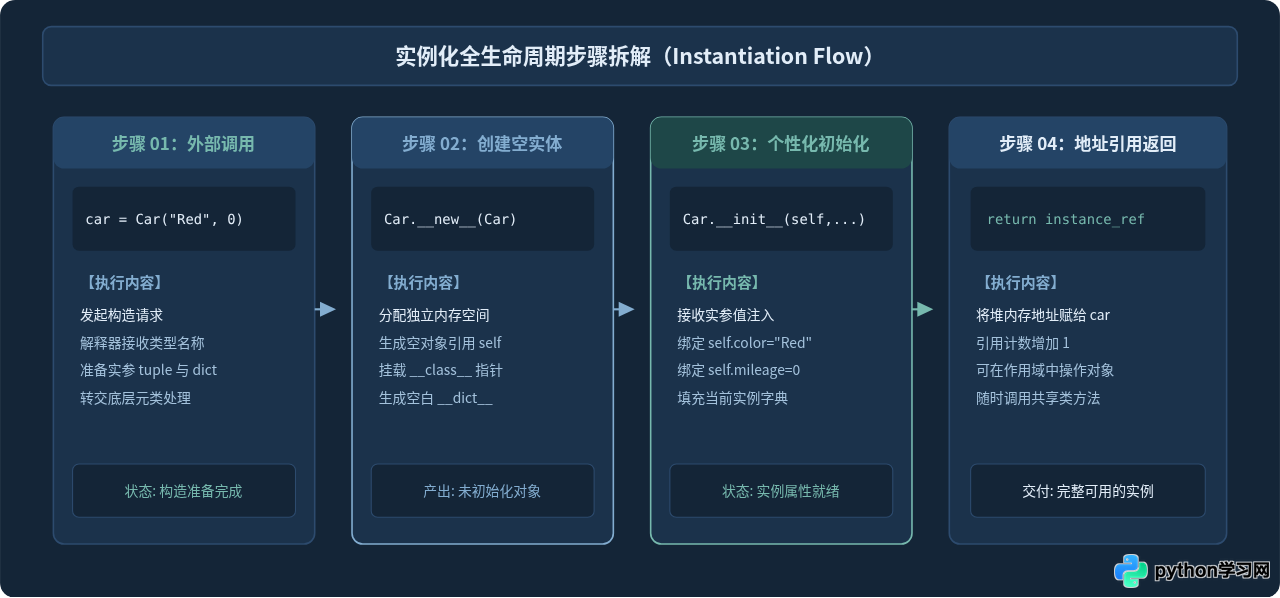
当我们写下 my_car = Car("红色", 1500) 时,Python解释器在后台究竟执行了哪些操作?许多初学者会误以为 __init__ 负责创建对象,但实际上对象的创建与初始化是分步完成的。
完整的实例化流水线包含四个核心阶段:
- 调用类构造器:执行
Car(...)触发类对象的调用协议type.__call__。 - 分配内存实体(
__new__):首先调用类的静态方法Car.__new__(Car, ...),由底层解释器在堆内存中为新实例开辟存储空间,返回尚未初始化的新实例对象。 - 初始化属性赋值(
__init__):将刚刚创建的空实例作为第一个参数self传递给Car.__init__(self, "红色", 1500),在self的局部属性字典中写入color与mileage。 - 变量绑定:把配置完毕的实例对象内存地址返回给左侧变量
my_car。
为了直观感受代码中的定义方式,我们编写一个标准示例:
class Car:
    # 类属性(所有实例共享)
    wheels = 4

    def __init__(self, color, mileage=0):
        # 实例属性(属于每个具体实例独有)
        self.color = color
        self.mileage = mileage

    def drive(self, distance):
        # 实例方法,第一个参数 self 会自动绑定调用它的实例
        self.mileage += distance
        print(f"[{self.color}车] 行驶了 {distance} 公里,总里程:{self.mileage}")

# 实例化两个不同对象
car_a = Car("红色", 100)
car_b = Car("蓝色", 500)

car_a.drive(50)
car_b.drive(200)

# 打印实例属性字典
print("car_a 字典:", car_a.__dict__)
print("car_b 字典:", car_b.__dict__)
输出示例:
[红色车] 行驶了 50 公里,总里程:150
[蓝色车] 行驶了 200 公里,总里程:700
car_a 字典: {'color': '红色', 'mileage': 150}
car_b 字典: {'color': '蓝色', 'mileage': 700}
从打印的 __dict__ 可以验证:car_a 与 car_b 内部只保存了各自被赋予的 color 与 mileage,而共享的 wheels 和 drive 并不重复存放在实例字典中。
三、属性与方法的查找机制:查找链(Lookup Chain)
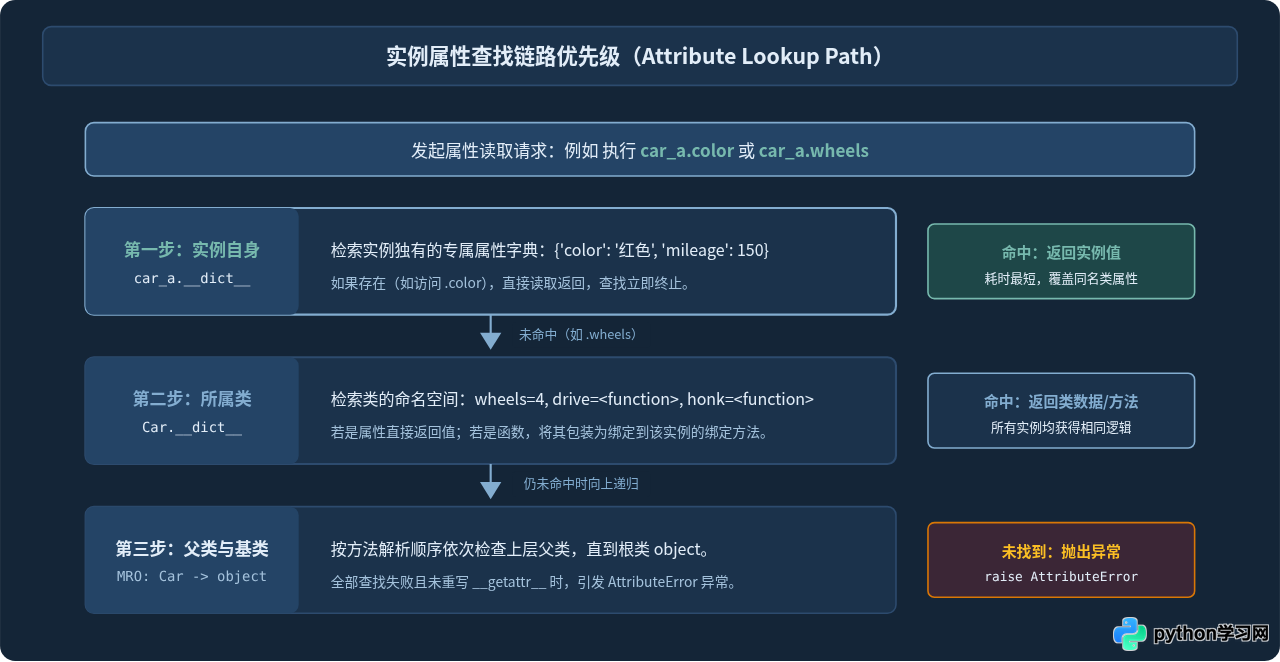
既然 car_a 的字典里没有 wheels 和 drive,那么当我们执行 print(car_a.wheels) 或 car_a.drive(10) 时,Python 是如何正确找到它们的?
答案是 Python 的属性查找链(Attribute Lookup Chain)。当你通过点号操作符 instance.attr 读取属性时,解释器遵循固定的优先次序:
- 第一优先级:实例的命名空间。优先检查
instance.__dict__是否含有该名称。如果找到,立即返回对应的值。 - 第二优先级:类的命名空间。如果在实例本身未找到,转向
type(instance).__dict__(即Car.__dict__)查找。如果找到且该对象是普通函数,Python会利用描述符机制将其打包为绑定方法(Bound Method),把instance作为self自动注入;如果是类属性,则直接返回值。 - 第三优先级:继承链上的基类。若在当前类中依然不存在,顺着方法解析顺序(MRO,Method Resolution Order)依次向上级父类及根类
object查找。 - 终止与报错:遍历整条链均未命中时,触发
__getattr__钩子;若未定义该钩子,则抛出AttributeError异常。
当你在实例上执行写操作 car_a.wheels = 6 时,Python并不会去修改类上面的 Car.wheels,而是在 car_a.__dict__ 中写入一个新的键值对 'wheels': 6。
此时,由于实例字典处于查找链第一顺位,之后访问 car_a.wheels 会得到 6,遮蔽了类的 4;而其他实例(如 car_b.wheels)依然读取到类上的 4。只有通过 Car.wheels = 6 进行显式赋值,才会真正改变所有未发生遮蔽的实例的默认值。
四、类与实例的维度对比与设计边界
理解类与实例的关系,核心在于明确两者承担的不同职责。下面的表格总结了类与实例在实际开发中的关键维度差异:
| 对比维度 | 类(Class) | 实例(Instance) |
|---|---|---|
| 概念定位 | 数据规格与行为规范的“模板”、“类型” | 承载具体业务属性的“实体”、“对象” |
| 内存存在数量 | 在同一个进程/命名空间中通常只有唯一一份 | 可按需创建任意多个,彼此内存相互隔离 |
| 内部存储字典 | Class.__dict__(存储类属性、公共方法定义) |
instance.__dict__(存储该实例特有的字段值) |
| 方法中的 self 绑定 | 不自动绑定,调用需手动传入实例:Car.drive(car_a, 10) |
语法糖自动绑定:car_a.drive(10) 等价绑定当前实例 |
| 修改影响范围 | 修改类属性会影响所有未遮蔽该属性的已有及后续实例 | 修改实例属性仅对当前实例生效,绝不影响同类其他实例 |
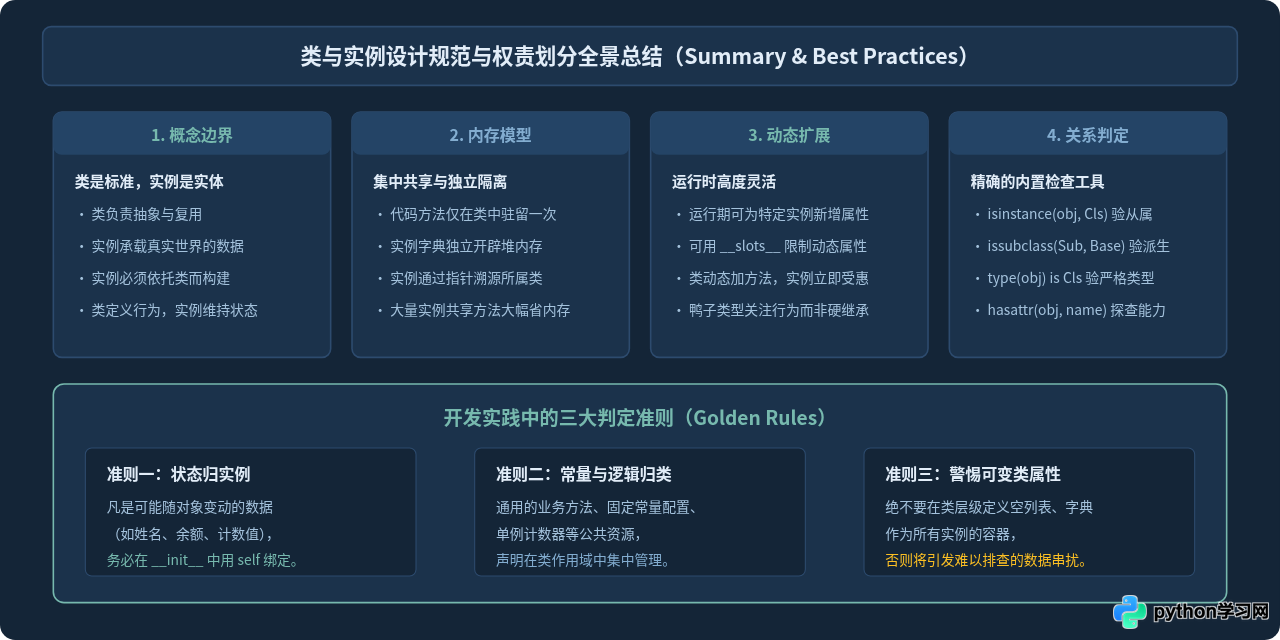
我们可以总结出一套清晰的知识全景图,帮助在系统设计时精准划分属性归属:
五、最容易踩坑的常见误区:可变对象陷阱
在理解了类属性是全局共享之后,必须特别警惕在类层级使用可变对象(如 list、dict 或 set)。
请观察以下有问题的代码:
# 错误示范:在类属性中放置可变列表
class Student:
    courses = []  # 这是类属性,所有学生共享同一个列表!

    def __init__(self, name):
        self.name = name

    def add_course(self, course_name):
        self.courses.append(course_name)

alice = Student("Alice")
bob = Student("Bob")

alice.add_course("Python编程")
print("Bob的课程:", bob.courses)
输出结果:
Bob的课程: ['Python编程']
原因剖析:self.courses.append(...) 并没有对 self.courses 重新赋值,而是执行了原位修改(in-place modification)。当解释器查找 self.courses 时,实例中没有这个键,于是沿查找链在 Student 类中找到了同一个列表对象并向其添加元素。结果导致 Alice 选的课自动出现在了 Bob 的列表里。
class Student:
    def __init__(self, name):
        self.name = name
        self.courses = []  # 每次实例化都会新建一个独立的列表对象
六、总结
总结而言,Python中的“类”与“实例”构成了面向对象程序设计的基石:
- 类是规范与模具:定义同一类事物共通的数据结构与行为逻辑。在内存中集中存放方法代码与类变量,减少冗余开销。
- 实例是独立执行单元:依托类蓝图生成,通过私有的
__dict__隔离数据,在被方法操作时将自身作为self传入,实现“逻辑统一、数据独立”。 - 查找链是连接纽带:通过“实例命名空间 → 类命名空间 → 父类继承链”的优先级顺序,Python巧妙地兼顾了实例属性的灵活重写(遮蔽)与类级别代码的高度复用。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















