


Python查重库对比:fuzzywuzzy、sklearn与textdistance评测

在 Python 文本处理中,文本查重与相似度计算是一项基础却极易出现工程偏差的任务。面对同一批文本,选择 fuzzywuzzy、scikit-learn (sklearn) 还是 textdistance,不仅决定了代码的编写复杂度,更直接影响比对结果的准确率与大规模运行时的耗时上限。本文不进行脱离实际场景的泛化讨论,而是从算法底层机制、工程使用代码、计算复杂度瓶颈与真实选型决策链四个维度展开实测剖析,帮助读者为具体的查重需求选定合适的技术路径。
一、三库核心定位与算法原理对比
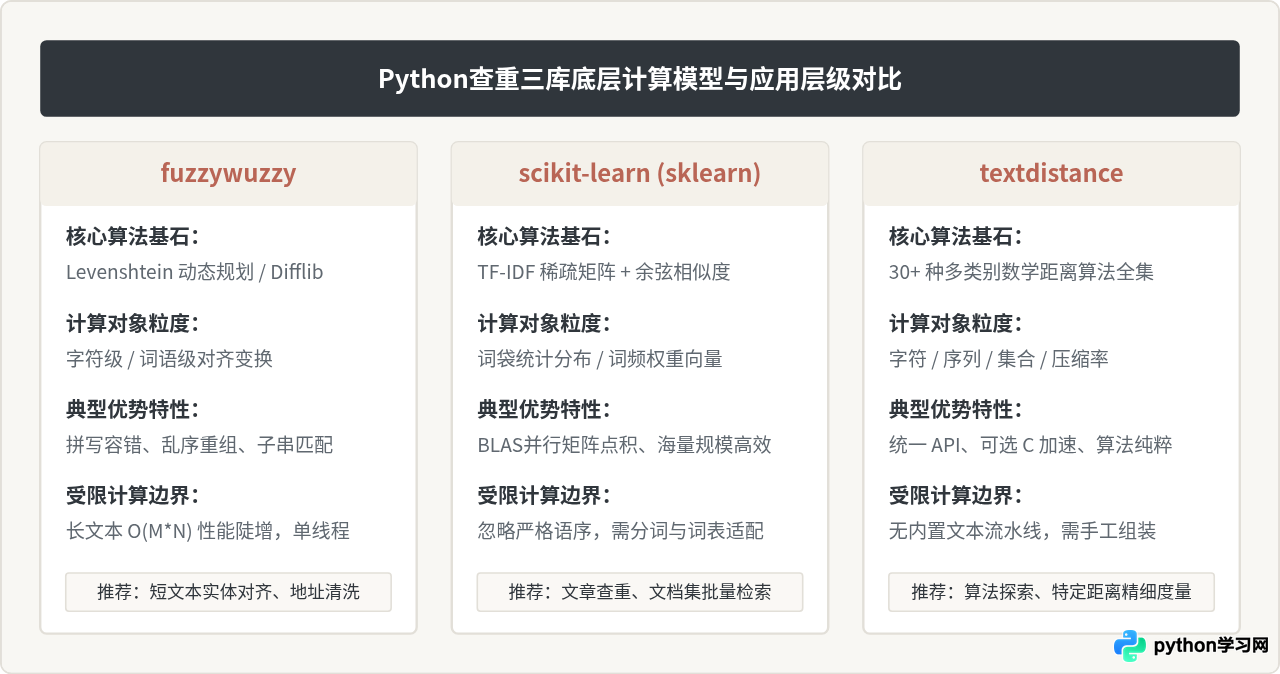
很多开发者在技术选型时常将这三个库置于并列位置,但它们的数学模型和设计初衷截然不同:
- fuzzywuzzy:基于 Levenshtein 编辑距离与 Python 内置的
difflib,核心用于短文本之间的容错对齐。它通过动态规划寻找最长公共子序列与字符替换成本,尤其擅长处理打字拼写失误、单词乱序、前后缀缺失等噪声文本。 - scikit-learn (sklearn):立足于统计机器学习与高维向量空间模型 (VSM)。它通过词频-逆文档频率(TF-IDF)或词频计数将整个语料库转化为稀疏矩阵,再利用余弦相似度(Cosine Similarity)进行批量矩阵点积计算,专长于中长篇文档与海量文本集的高效去重。
- textdistance:纯算法度量集合库,实现了包括 Levenshtein、Damerau-Levenshtein、Jaro-Winkler、Jaccard、Cosine、Sørensen-Dice 等在内的 30 余种距离与相似度算法。它不绑定特定的工程管线,为需要精细定制特定数学距离的场景提供了纯净的统一接口。
二、使用方法与可执行代码对比
为了直观展现各库的语法风格与输出差异,我们在相同环境下对比三者对同一组测试文本的处理表现。
pip install fuzzywuzzy python-Levenshtein scikit-learn textdistance jieba。注:
python-Levenshtein 为可选 C 扩展模块,能使 fuzzywuzzy 和 textdistance 的底层计算加速 4 至 10 倍。
1. fuzzywuzzy:短文本对齐与启发式打分
fuzzywuzzy 提供了四种常用打分方法,返回值均为 0 到 100 之间的整数分数:
fuzz.ratio:完整字符精确对齐。fuzz.partial_ratio:子串匹配,用于较短文本完全包含在较长文本中的情况。fuzz.token_sort_ratio:对分词后的单词重新按字母排序后再匹配,消除语序倒装影响。fuzz.token_set_ratio:先取词汇交集,忽略重复词与冗余修饰,容错度最高。
from fuzzywuzzy import fuzz

text1 = "Python 数据分析与可视化入门"
text2 = "入门 Python 可视化与数据分析"
text3 = "数据分析"

# 1. 基础匹配(对语序敏感)
print("ratio:", fuzz.ratio(text1, text2))               # 示例输出: 50

# 2. 部分匹配(子串检测)
print("partial_ratio:", fuzz.partial_ratio(text3, text1)) # 示例输出: 100

# 3. 词序重排匹配(消除语序干扰,中文默认按字符处理)
print("token_sort_ratio:", fuzz.token_sort_ratio(text1, text2)) # 示例输出: 93

# 4. 词集匹配(过滤多余冗余词)
print("token_set_ratio:", fuzz.token_set_ratio(text1, text2))  # 示例输出: 100
2. scikit-learn:向量化与批量矩阵相似度
sklearn 的核心是 TfidfVectorizer 结合 cosine_similarity。对于中文文本,必须提供合理的分词逻辑,否则默认按空格拆分词汇无法提取中文词袋。
from sklearn.feature_extraction.text import TfidfVectorizer
from sklearn.metrics.pairwise import cosine_similarity
import jieba

docs = [
    "Python 数据分析与可视化入门实战",
    "入门实战 Python 可视化与数据分析",
    "深度学习自然语言处理与大模型实战"
]

# 中文需使用分词器切分成以空格隔开的词串
tokenized_docs = [" ".join(jieba.cut(doc)) for doc in docs]

# 构建 TF-IDF 特征矩阵
vectorizer = TfidfVectorizer()
tfidf_matrix = vectorizer.fit_transform(tokenized_docs)

# 计算 N*N 相似度矩阵
similarity_matrix = cosine_similarity(tfidf_matrix, tfidf_matrix)

print("文档 0 与文档 1 的余弦相似度:", round(similarity_matrix[0][1], 4)) # 示例输出: 1.0
print("文档 0 与文档 2 的余弦相似度:", round(similarity_matrix[0][2], 4)) # 示例输出: 0.1412
3. textdistance:精准数学度量与多样化算法选择
textdistance 提供了统一的面向对象接口,支持返回归一化的相似度(0.0 至 1.0)或未归一化的绝对距离。
import textdistance

s1 = "Python数据分析"
s2 = "Python数据清洗"

# 1. Levenshtein 归一化相似度 (基于编辑距离)
lev_sim = textdistance.levenshtein.normalized_similarity(s1, s2)
print("Levenshtein 相似度:", round(lev_sim, 4)) # 示例输出: 0.8

# 2. Jaro-Winkler 相似度 (对相同前缀赋予更高权重,适合名字、短标题匹配)
jw_sim = textdistance.jaro_winkler.similarity(s1, s2)
print("Jaro-Winkler 相似度:", round(jw_sim, 4)) # 示例输出: 0.8867

# 3. Jaccard 相似度 (集合交并比,关注公有字符集合)
jaccard_sim = textdistance.jaccard.similarity(s1, s2)
print("Jaccard 相似度:", round(jaccard_sim, 4))     # 示例输出: 0.7778
三、工业级文本查重流水线与工程落地
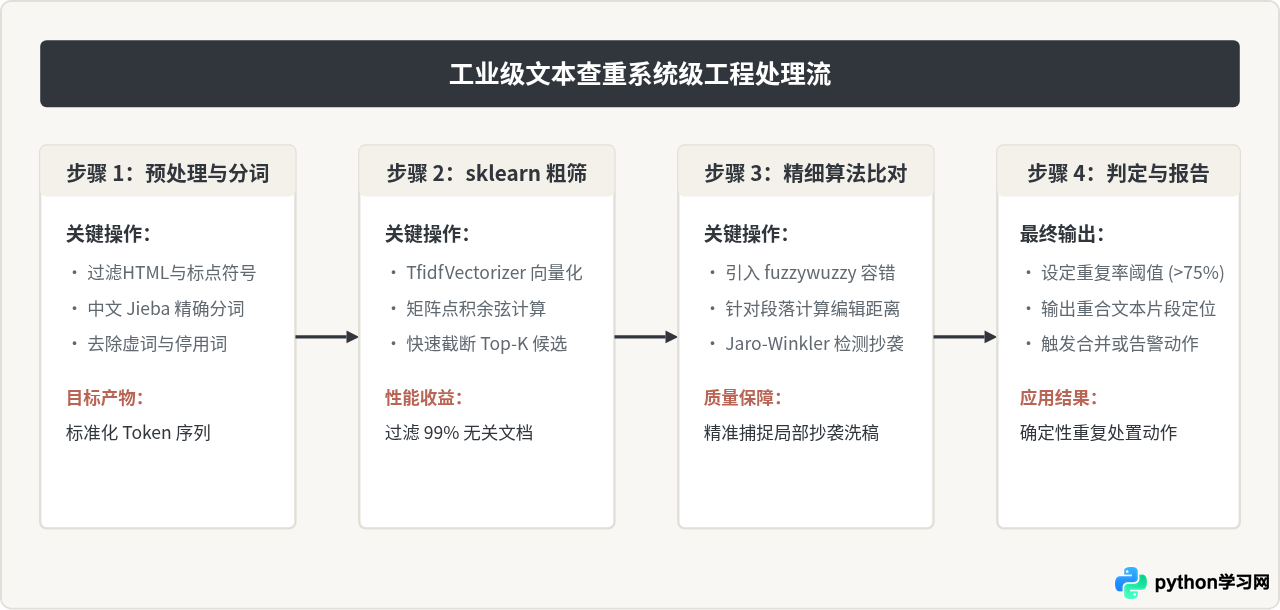
在实际生产环境中,若直接对成千上万篇文档使用 fuzzywuzzy 或 textdistance 进行两两遍历,计算耗时将随着文档数量呈指数级膨胀($O(N^2)$)。工业级查重系统通常采用“粗筛 + 精排”的两阶段流水线设计:先用 sklearn 快速收敛候选集,再用 fuzzywuzzy 或 textdistance 进行微观重合校对。
四、计算开销与数据规模适应性
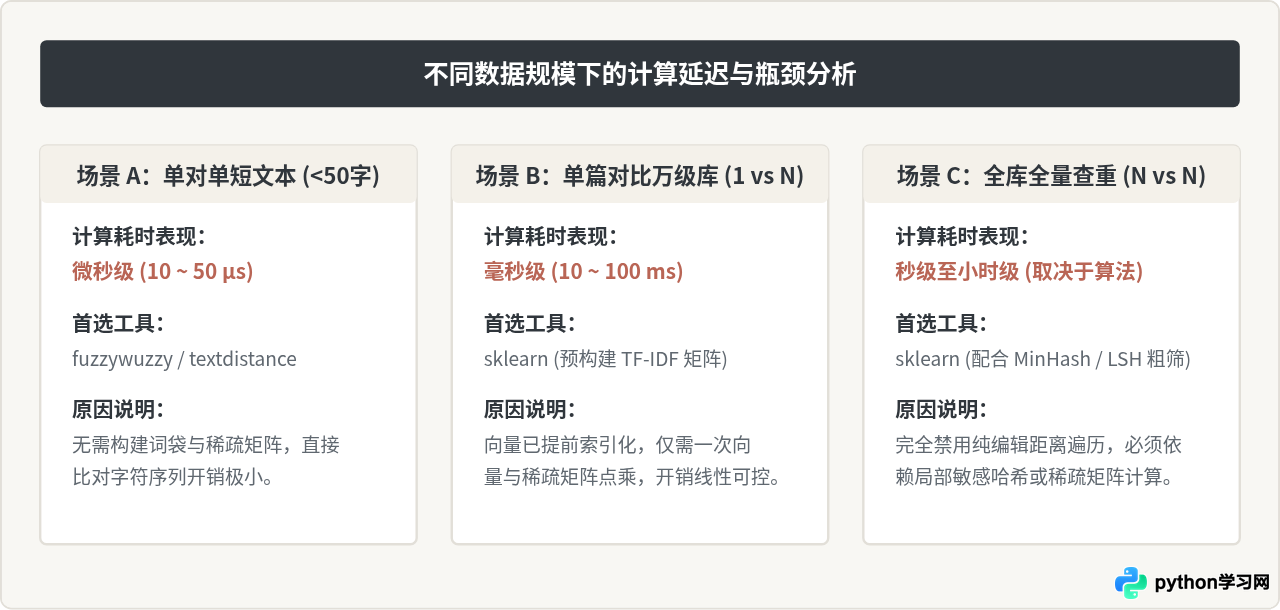
评估查重库的实用性,不能脱离数据规模谈效果。两两匹配的计算开销直接决定了系统架构的选型:
- 短文本对齐(如商品名、人名、收货地址):文本长度一般在 10 至 50 字符之间。使用
fuzzywuzzy(配合python-Levenshtein)或textdistance处理单次比对仅需微秒级(约 5~30 μs),对 1000 条以内的短文本做两两匹配开销完全在可承受范围内。 - 长篇文档全量查重(如博文、论文、报告):单篇文本在数千字以上。若使用编辑距离算法,两篇长文档比对需要构建 $M \times N$ 的动态规划矩阵,计算复杂度直接达到毫秒乃至秒级。此时,
sklearn利用底层 C/Fortran 优化的稀疏矩阵向量乘法,能够以极高的并行吞吐量完成数万篇文档的余弦相似度矩阵扫描。
五、中文处理常见问题与避坑指南
1. fuzzywuzzy 处理中文的分词陷阱
fuzzywuzzy 原生设计基于英文文本。其 token_sort_ratio 和 token_set_ratio 默认依赖内置正则 \W+(按空格和英文字符)来切分 Token。在中文语境下,连续的汉字之间没有空格,如果不显式分词,整个中文句子会被当成单个巨大 Token,导致高级比对方法直接退化为普通 ratio。在处理中文时,建议在传入前使用 jieba 将中文短语拼接为空格分隔的词串。
2. sklearn 的停用词与高频虚词干扰
在长文档查重中,如果直接使用 TfidfVectorizer 而不加载中文停用词表,“的、了、在、是、和”等高频虚词仍可能残留在特征维度中。虽然 IDF 会惩罚全语料高频词,但在小规模测试集上,虚词仍可能虚高文档间的余弦相似度。必须配合成熟的中文停用词表(如哈工大或百度停用词表)使用。
3. textdistance 的算法特异性与选择依据
textdistance 包含了数十种算法,但不可盲目选用:
- 对于含有大量缩写、错别字或打字颠倒的文本,推荐 Damerau-Levenshtein(支持相邻字符对调)。
- 对于人名、地址等前缀重要度高于后缀的场景,推荐 Jaro-Winkler。
- 对于词汇共现率高但顺序极度混乱的段落,推荐 Jaccard 或 Cosine。
六、综合选型决策矩阵与总结
综合以上实测指标,下表给出了三库在核心维度上的直观横向比对:
| 评估维度 | fuzzywuzzy | scikit-learn (sklearn) | textdistance |
|---|---|---|---|
| 主打算法 | Levenshtein 编辑距离 + Difflib | TF-IDF 向量化 + Cosine 相似度 | 30+ 种经典数学距离(涵盖编辑、Token等) |
| 最佳文本长度 | 短文本(10 ~ 100 字符) | 中长文本(数百字至数万字) | 灵活(根据所选具体算法而定) |
| 计算吞吐能力 | 单次比对极快,全量批处理较慢 | 矩阵批量并行极快,内存友好 | 单次比对快,纯 Python 较慢(可配 C 加速) |
| 外部依赖体积 | 轻量(依赖 python-Levenshtein) | 重量(需 numpy, scipy 等大包) | 超轻量(纯 Python 默认无必选依赖) |
| 中文处理复杂度 | 需前置分词以发挥 token_* 方法 | 必须配置自定义 tokenizer/分词 | 大部分算法直接支持 Unicode 字符流 |
| 核心典型场景 | 用户输入纠错、数据库实体名对齐 | 文章原创度检测、论文/报告查重 | 算法精度评测、指定数学距离严格度量 |
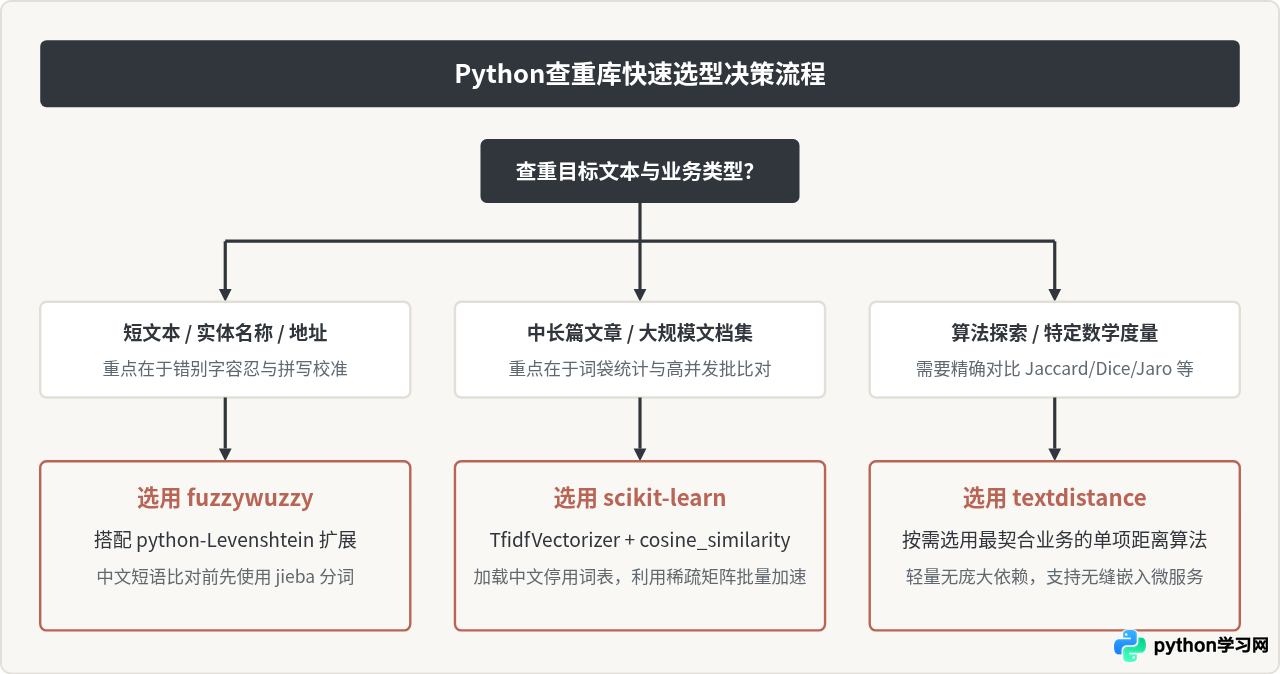
综上所述,三者并非互斥关系。在成熟的查重工程中,以 sklearn 负责海量文档特征索引与初筛,以 fuzzywuzzy 或 textdistance 负责高嫌疑片段的字符级精排复验,是兼顾吞吐效率与查重准确率的理想工程实践。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















