


Python脚本和Python程序有什么区别

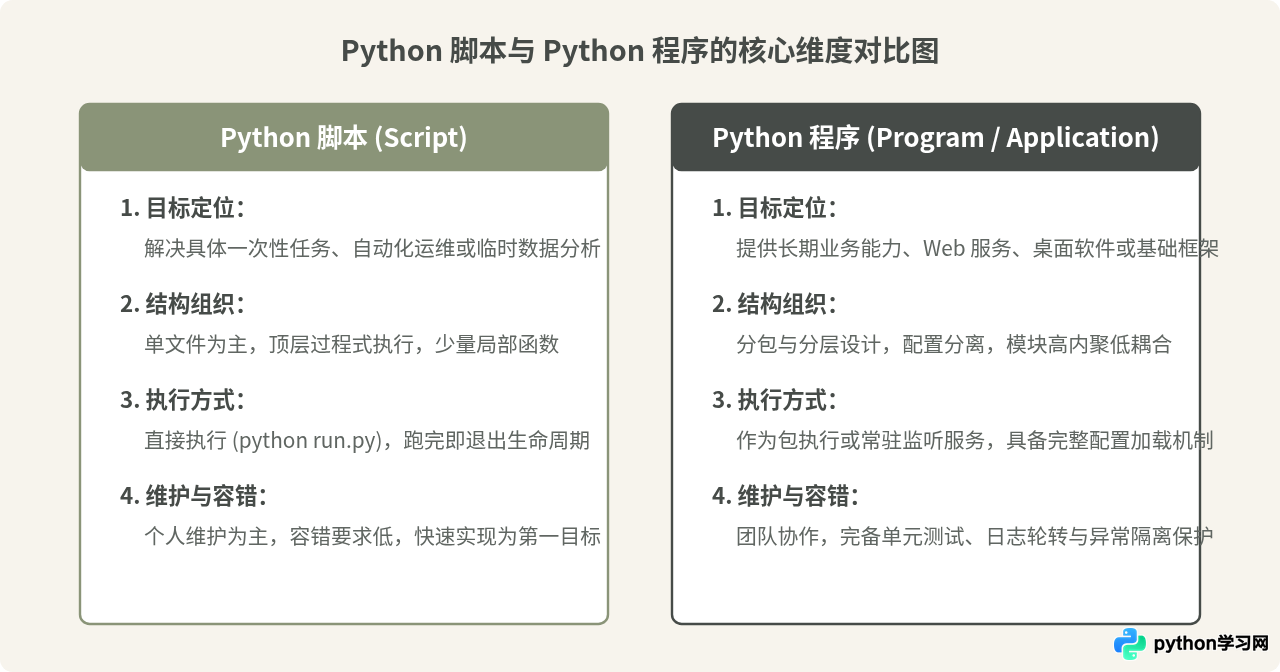
在 Python 语法层面,解释器执行单个 .py 文件和运行大型工程并没有本质的语法差异,两者的底层字节码机制也是相同的。然而在软件工程实践中,“Python脚本(Script)”与“Python程序(Program / Application)”在目标定位、架构组织、生命周期管理以及错误容忍度上存在明确的边界区分。简而言之:脚本是以任务为中心、偏向单次执行与流程自动化的单一模块或简短代码;程序则是以架构为中心、具备分层设计、长期维护性与健壮状态管理的应用系统。
一、核心维度对比:从单点操作到系统工程
许多初学者容易产生一种混淆,认为“行数少的叫脚本,行数多的叫程序”。代码行数虽然能在表面上体现复杂度,但它并不是衡量两者的科学依据。一个处理复杂数学公式的批处理脚本可能长达几百行,而一个微型 HTTP 健康检查服务可能只需几十行代码便构成了一个常驻程序。
两者的根本区别在于解决问题的思维范式与架构约束:
- 关注核心:脚本关注“输入-处理-输出”这一条直线的达成;程序关注模块解耦、状态控制、可测试性与团队协作。
- 依赖与环境:脚本通常假定本地已安装所需依赖,直接调用系统命令或第三方库;程序通过环境隔离、配置文件(如
pyproject.toml)及打包工具来保证不同机器上的行为一致性。 - 异常处理:脚本遇到意外错误时通常直接抛出异常或退出;程序则需要细分业务异常、降级恢复、记录日志并向外界返回标准的错误码或交互提示。
二、从脚本到程序:典型的代码演进与结构演化
为了直观展现两者差异,我们可以观察一个常见场景:定期拉取天气并导出告警信息。
1. 脚本形态(单文件、过程式、硬编码)
在脚本形态下,开发者往往追求以最短路径解决当下问题。配置、网络请求、数据解析和文件落地混杂在同一个文件内部:
# weather_script.py - 典型的 Python 脚本
import json
import urllib.request

# 硬编码配置与密钥
API_URL = "https://api.example.com/weather?city=beijing"

def run():
    req = urllib.request.urlopen(API_URL)
    data = json.loads(req.read().decode('utf-8'))
    temp = data["temperature"]
    print(f"当前气温: {temp}")
    if temp > 35:
        with open("alert.txt", "w", encoding="utf-8") as f:
            f.write(f"高温预警: {temp} 度")

if __name__ == "__main__":
    run()
运行该脚本只需在终端输入:
python weather_script.py这段脚本能够正常运行,但它存在明显局限:如果网络断开会直接中断崩溃;配置被写死在代码中;外部模块无法复用获取天气的逻辑;也无法编写自动化的单元测试。
2. 程序形态(模块化、分层架构、依赖注入)
若将上述逻辑作为企业运维系统中的一个“监控报警程序”,它会被拆解为具有清晰依赖关系的多个子模块:
weather_monitor/
├── pyproject.toml              # 项目依赖与元数据声明
├── config/
│   └── settings.yaml          # 环境配置外部化
├── src/
│   └── weather_app/
│       ├── __init__.py
│       ├── __main__.py        # 程序入口
│       ├── client.py          # 专门负责与外部通信的客户端
│       ├── parser.py          # 领域数据解析与校验
│       └── notifier.py        # 告警通道抽象(文件、邮件、Webhook)
└── tests/
└── test_parser.py # 单元测试覆盖在程序组织中,client.py 仅关注接口协议与重试逻辑,notifier.py 面向抽象接口编程,__main__.py 负责组装这些组件并统一处理全局退出信号。此时可以通过模块方式启动:
python -m weather_app --config ./config/settings.yaml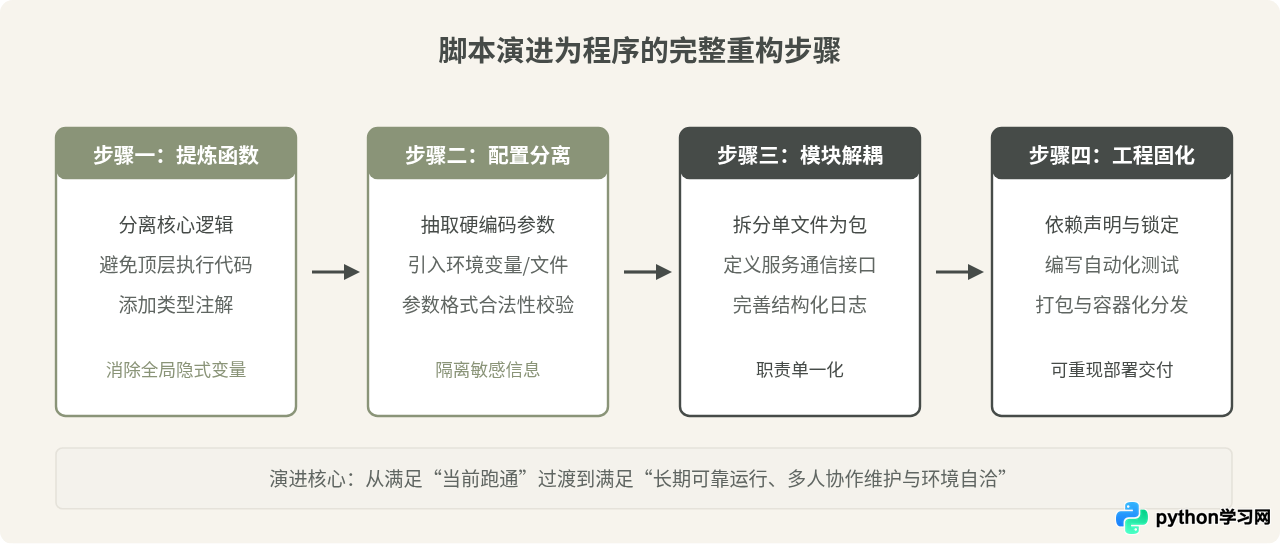
三、运行机制与解释器行为:__name__ 的分水岭
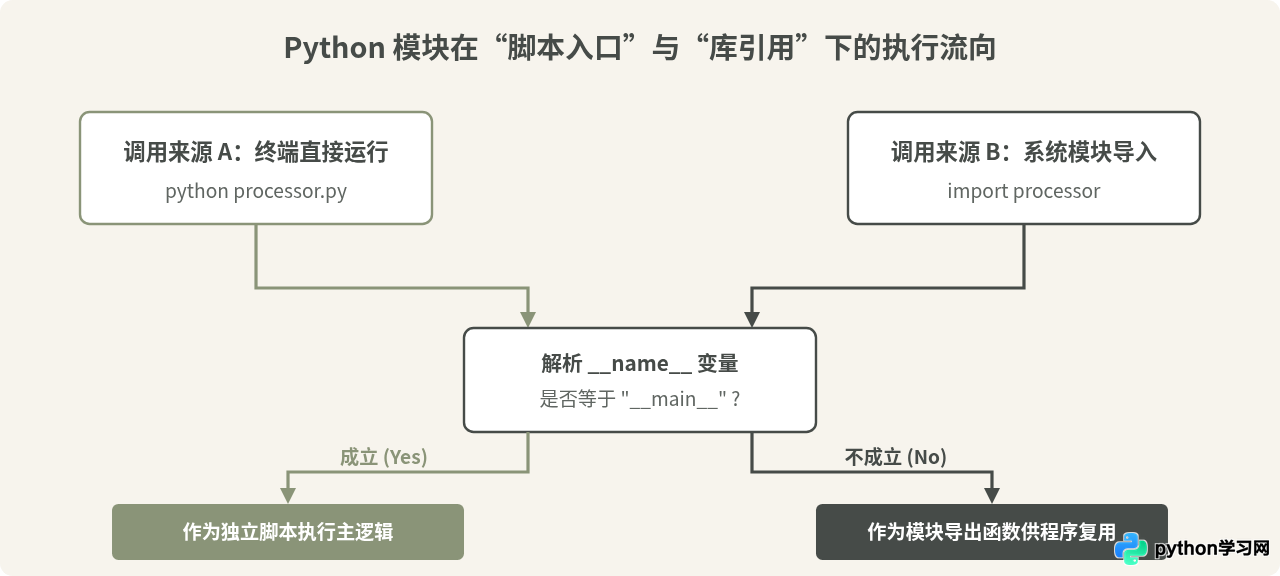
在 Python 语言本身的设计中,最能体现脚本与程序模块双重身份的语法特征是 if __name__ == "__main__": 保护块。
当 Python 解释器读取一个 .py 文件时:
- 如果该文件作为顶层执行入口直接运行(例如
python file.py),解释器会自动将该模块内置变量__name__赋值为全局字符串"__main__"。此时该文件充当了“脚本/程序主入口”的职责。 - 如果该文件被其他文件通过
import file导入,解释器会将其__name__设置为模块本来的名字(如"file")。此时保护块内的代码不会被触发,它充当了可复用“库/程序子组件”的职责。
四、容易混淆的常见说法辨析
围绕“脚本”与“程序”的定义,社区中存在几种流传甚广但在特定场景下并不严谨的说法。客观辨析这些说法有助于更准确地建立工程认知:
观点一:“解释型语言写出来的都是脚本,编译型语言写出来的才是程序。”
辨析:这是一种带有历史局限性的误解。早期像 Bash、Perl 确实主要承担自动化胶水任务,而 C/C++ 多用于构建大型系统。但如今 Python 既能编写简单的单行批处理,也能构建像 Instagram 后端、Django 复杂企业级平台以及大型科学计算系统。程序的本质在于软件架构设计的严密性,而不在于运行时的编译执行形式。
观点二:“写在单个 .py 文件里的代码就一定是脚本。”
辨析:并不绝对。例如基于 FastAPI 编写的微服务,即使所有路由和逻辑集中在一个文件内,只要它承担了持久监听 HTTP 端口、具备标准的依赖声明和容器化部署配置,它在工程属性上就属于一个微型应用程序。反之,若一个任务被机械地拆分成了多个 .py 文件,但没有统一的生命周期与配置规范,依然属于脚本集合。
五、工程决策:何时该写脚本,何时该做成程序?
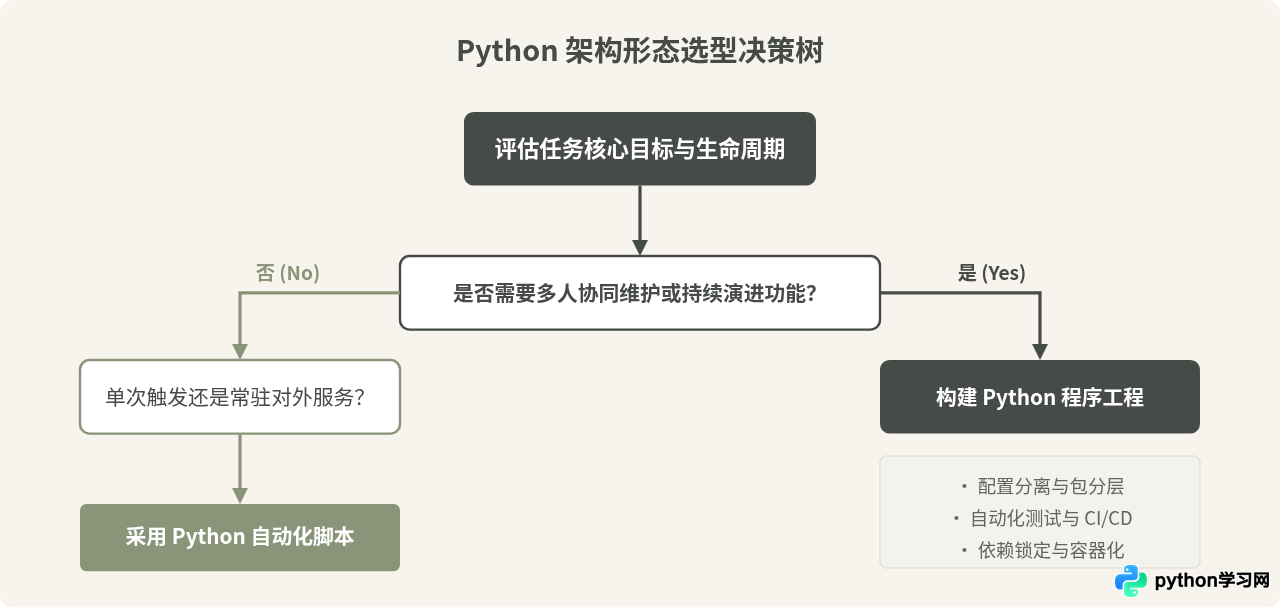
过度设计(Over-engineering)与缺乏架构设计同样有害。为一个单次的数据清洗任务搭建复杂的多层分包和接口注入,只会浪费开发时间;而把一个需要长期维护的核心账单对账逻辑写成充斥着全局变量的单文件脚本,则会在未来带来灾难性的维护成本。
| 决策考量项 | 适合采用 Python 脚本 | 应该构建为 Python 程序 |
|---|---|---|
| 需求存续周期 | 临时任务、一次性数据迁移、短期调试工具 | 长期运行、定期迭代、对外提供核心功能 |
| 执行频次与环境 | 在开发者个人电脑上手动触发或本地简单 Crontab | CI/CD 自动化部署、云原生容器运行、集群管理 |
| 输入与输出要求 | 标准输入输出(stdout/stdin)、直接覆写本地文件 | 严格的协议交互(RESTful、gRPC)、事务数据库存储 |
| 测试与质量保障 | 人工观察终端打印输出即可验证 | 依赖自动化测试套件(pytest)、覆盖率报告要求高 |
| 协作规模 | 单人使用或仅交付给熟悉命令行的工程人员 | 多人协作开发、业务团队协同、非技术用户使用 |
六、总结与实践建议
Python 之所以能在数据科学、自动化运维、Web 体系以及大型分布式后端开发中保持通用性,正是因为它能够在“随手即写”的轻量脚本与“严谨健壮”的企业级工程之间无缝切换。
在实际工作中,最健康的开发策略是从脚本起步,按需演进为程序:当原型探索阶段或验证某个想法时,写一个几十行的简短脚本快速看到结果;而一旦该逻辑被纳入日常运维、需要接入监控告警或需要移交给其他成员共同维护时,及时启动重构,抽取配置、定义接口、补齐单元测试,使其平稳蜕变为合格的 Python 程序。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















