


Python代码重复执行导致变量累加怎么避免

在数据处理或交互式开发中,经常遇到这样的现象:一段本应提取10条记录的代码,在多次点击运行后结果变成了20条、30条;或者一个计算总和的函数,连续调用多次后输出数值成倍膨胀。这种由于代码重复执行引发的变量非预期累加,核心根源在于可变对象在生命周期内没有被重新初始化,被后续逻辑反复原地修改。避免这一问题的核心途径,是建立明确的作用域隔离,确保可变容器在每次执行逻辑入口处均有确定的重置机制,并彻底规避可变默认参数等语言陷阱。
一、变量累加的典型场景与触发机理
设想一个具体场景:在交互式 Notebook 的一个代码单元中,开发者为了清洗数据编写了数据追加语句。当发现上一行代码有格式错误并修改重跑该单元时,列表长度莫名翻倍。这是因为 Python 中的列表(list)、字典(dict)以及集合(set)属于可变对象(Mutable Objects)。当它们驻留在持久的作用域中,任何向其追加或修改的操作都会直接作用于同一块内存空间,而不会自动创建新副本。
触发重复累加的典型情况主要有三种:
- 交互式单元格(Jupyter / IPython)跨单元共享容器:变量的初始化在上方单元格,而追加操作位于下方单元格。反复运行下方单元格,下方单元格复用了仍存活于内核全局内存中的同一个列表对象。
- 函数的可变默认参数:函数定义形如
def append_item(val, container=[]),由于默认参数在函数定义时仅求值一次,多次调用该函数会导致所有调用共享同一个列表。 - 模块级或类级全局属性:将容器声明为模块全局变量或类的公有类属性,由多个请求或同一逻辑反复访问并直接修改。
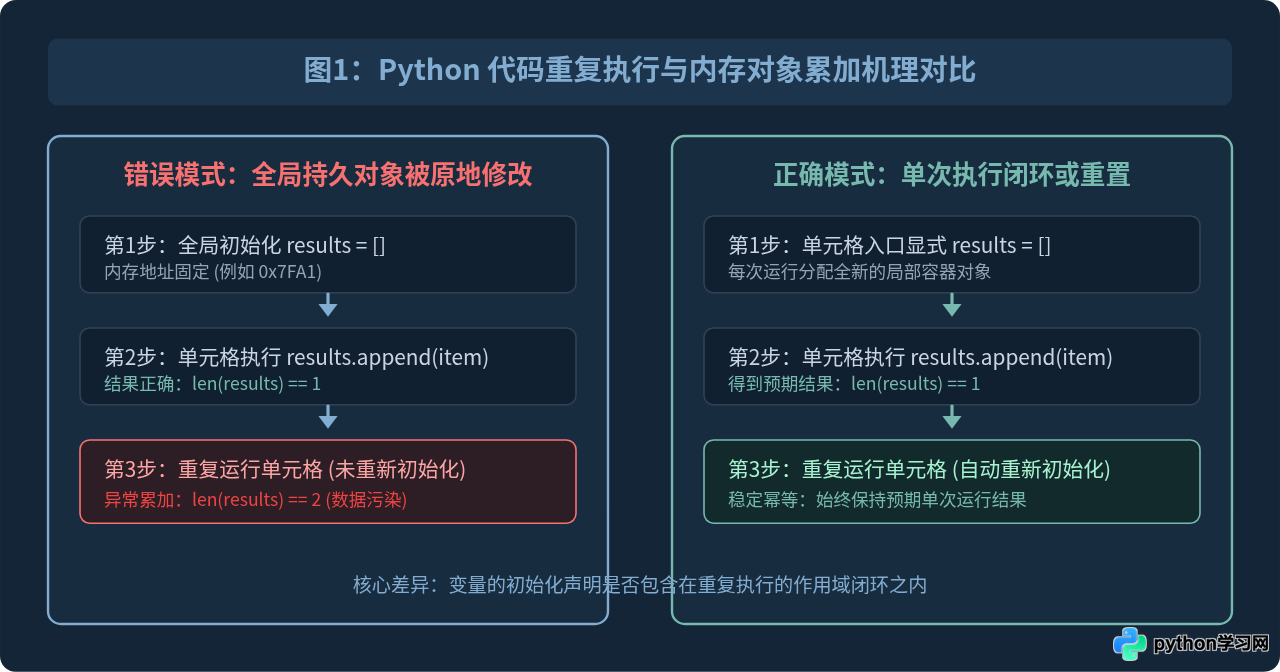
二、排查与消除累加的标准操作步骤
要从根本上避免重复执行导致的数据异常累加,建议遵循标准化排查与重构流程。从变量声明位置确认,到生命周期绑定,最后进行彻底的重启验证。
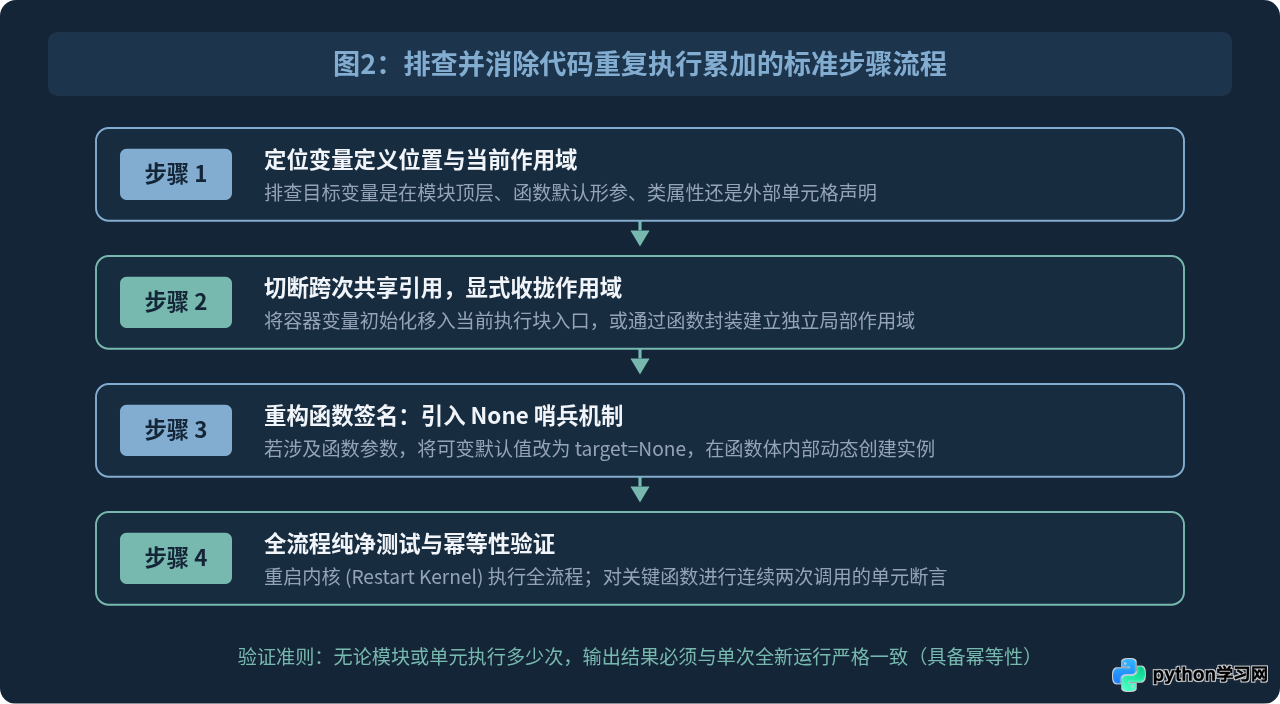
具体操作说明:
- 定位变量定义位置:在编辑器中使用全局搜索或逐行审查,确认报错变量首次被赋值的语句。特别注意是否脱离了核心循环或执行块,被孤立地写在了最顶层。
- 收拢作用域:将原本跨执行块共享的赋值语句(如
clean_records = [])移动到当前要重复执行的逻辑头部。如果这是一个独立的清洗逻辑,将其封装为一个接收原始数据、返回新数据的纯函数。 - 引入不可变默认值:将所有函数定义中的
def fn(data=[])或def fn(opt={})修改为def fn(data=None),确保默认参数仅使用不可变标量。 - 验证幂等性:在 Jupyter 中点击菜单项 Kernel -> Restart & Run All。如果是脚本或服务模块,编写自动化单元测试,确保连续调用函数两次时,第二次调用返回的集合长度与首次完全相同。
三、核心代码解决方案与对比示例
方案一:Jupyter Notebook 单元格中的结构解耦
在 Notebook 开发时,最容易出现“变量初始化”与“变量处理追加”分散在两个单元格的情况:
# 【问题代码:分布在两个不同单元格中】
# 单元格 1(只运行了一次):
user_ids = []

# 单元格 2(开发者反复调试、点击了 3 次运行):
new_data = [101, 102, 103]
user_ids.extend(new_data)
print(f"当前长度: {len(user_ids)}")
# 第一次运行输出: 当前长度: 3
# 第二次运行输出: 当前长度: 6 (累加产生)
# 第三次运行输出: 当前长度: 9 (严重污染)修复策略:保持单元格的“独立可重入性(Reentrancy)”。如果单元格需要输出结果,要么在该单元格首行显式重置;要么将逻辑打包成独立函数,通过局部变量完成计算后返回:
# 【推荐修复方案:单元格闭环与局部作用域】
def process_user_batch(raw_list):
    # 局部作用域内初始化,执行完毕后由垃圾回收,不污染全局
    current_ids = []
    for item in raw_list:
        current_ids.append(item)
    return current_ids

# 无论当前单元格运行多少次,输出始终确定
new_data = [101, 102, 103]
batch_result = process_user_batch(new_data)
print(f"清洗后长度: {len(batch_result)}")
# 无论点击多少次运行,始终输出: 清洗后长度: 3
方案二:防御函数默认可变参数陷阱(None 哨兵法)
Python 语言规范明确规定,def 语句在模块加载时被执行,函数对象的 __defaults__ 属性仅在此时创建一次。如果在默认形参中指定了可变对象,多次调用且未显式传参时,实际上是在持续向该默认对象追加数据:
# 【问题代码:可变默认参数】
def register_node(node_name, cluster=[]):
    cluster.append(node_name)
    return cluster

print(register_node("Node-A"))  # 输出: ['Node-A']
print(register_node("Node-B")) # 输出: ['Node-A', 'Node-B'] (产生非预期累加)修复策略:采用 None 作为哨兵值(Sentinel Value),并在函数体内动态创建新的独立容器:
# 【推荐修复方案:不可变哨兵】
def register_node(node_name, cluster=None):
    if cluster is None:
        cluster = []  # 每次调用时独立在当前栈帧分配全新列表
    cluster.append(node_name)
    return cluster

print(register_node("Node-A"))  # 输出: ['Node-A']
print(register_node("Node-B"))  # 输出: ['Node-B'] (相互隔离,无累加)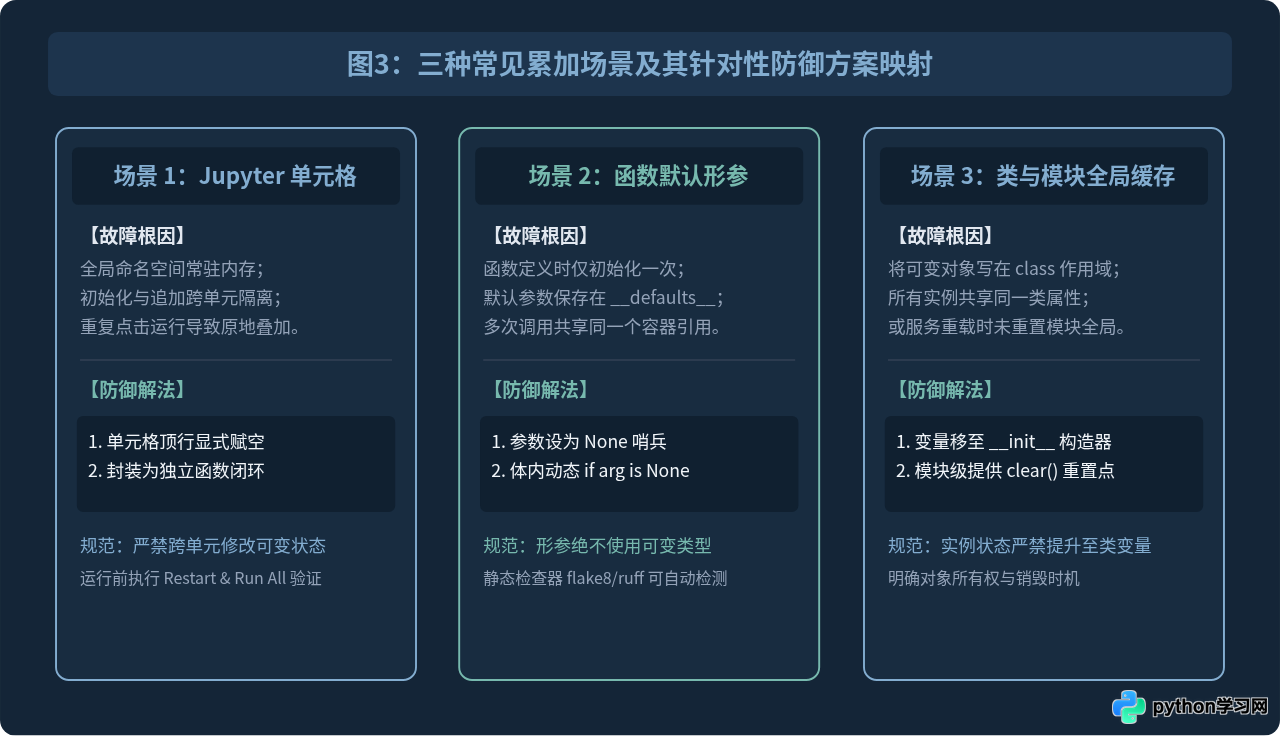
方案三:类属性与实例属性混淆的防范
在面向对象设计中,直接在类体内声明列表属性,会导致该类的所有实例化对象共享这同一个列表:
# 【问题代码:类属性被多实例共享累加】
class MetricCollector:
    records = []  # 这是类属性!所有实例共用同一个列表对象

    def add(self, val):
        self.records.append(val)

c1 = MetricCollector()
c1.add("cpu_90")
c2 = MetricCollector()
c2.add("mem_80")
print(c2.records) # 输出: ['cpu_90', 'mem_80'] (跨实例意外累加)修复策略:在 __init__ 构造函数内绑定到 self,保证每个实例在初始化时持有完全独立的堆内存对象:
# 【推荐修复方案:实例属性隔离】
class MetricCollector:
    def __init__(self):
        self.records = []  # 每次实例化独立分配,互不干扰

    def add(self, val):
        self.records.append(val)

c1 = MetricCollector()
c1.add("cpu_90")
c2 = MetricCollector()
c2.add("mem_80")
print(c1.records)  # 输出: ['cpu_90']
print(c2.records)  # 输出: ['mem_80'] (完全隔离)
四、工程实践中的注意事项与防范准则
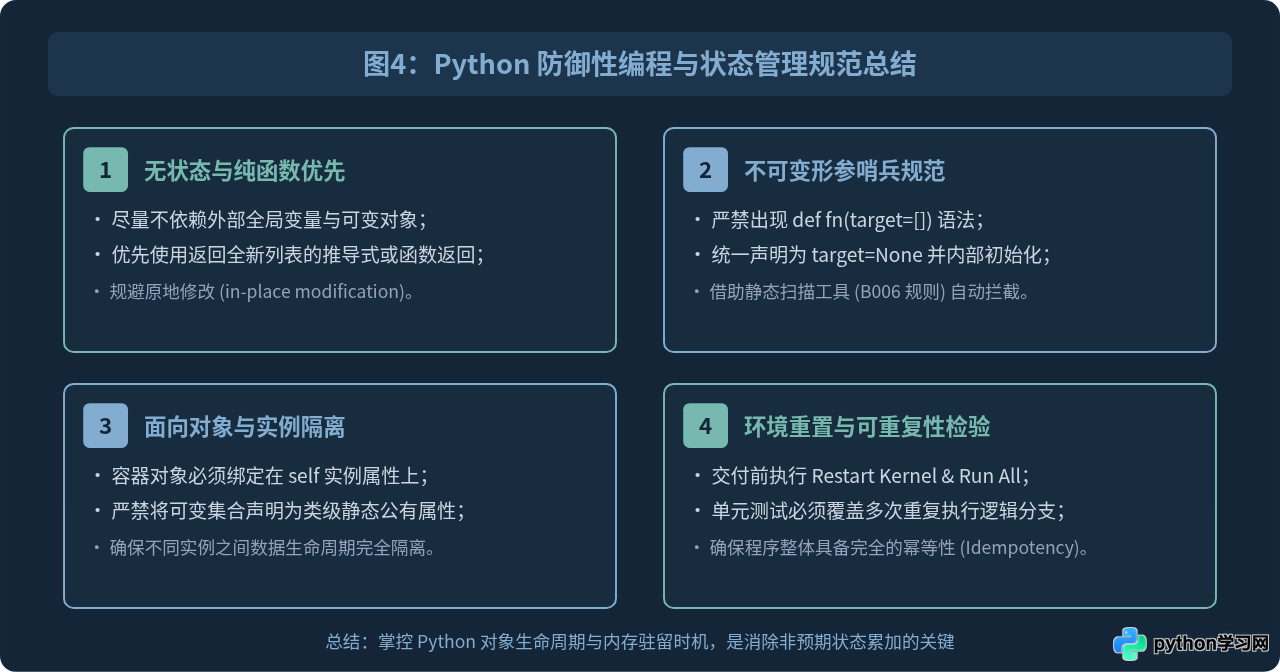
1. 严禁在函数形参中使用 list()、[] 或 {}: 现代静态分析工具(如 ruff、flake8 配合 B006 规则)可以直接检测出该问题,建议在项目 CI 流程中强制开启该项规则拦截。
2. Notebook 交付前一键重跑: 不要在包含多次执行状态的 Notebook 环境中直接导出产物。在最终保存或汇报前,必须点击执行“Restart Kernel & Run All Cells”,以零状态检验代码是否具备线性可重现性。
3. 优先编写无副作用的纯函数(Pure Functions): 尽量采用返回新数据副本的方式(例如使用列表推导式 [x for x in data if cond]),代替对传入参数执行 data.extend() 或 data.append() 等原地修改操作。
五、总结
Python 中代码重复执行导致变量累加并不是复杂的底层故障,而是由于作用域跨越、可变对象内存驻留与执行入口未重置等编程习惯引起的逻辑偏差。只要在交互式环境(Jupyter)中将变量初始化置于可重复执行的逻辑闭环之内,在函数定义中严格执行 None 哨兵替换可变默认参数,并在类设计中规范区分实例属性与类属性,就能彻底杜绝变量多次累加的问题,编写出稳定、幂等且易于维护的高质量代码。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















