


Python字典增删改查操作汇总:对应的方法有哪些

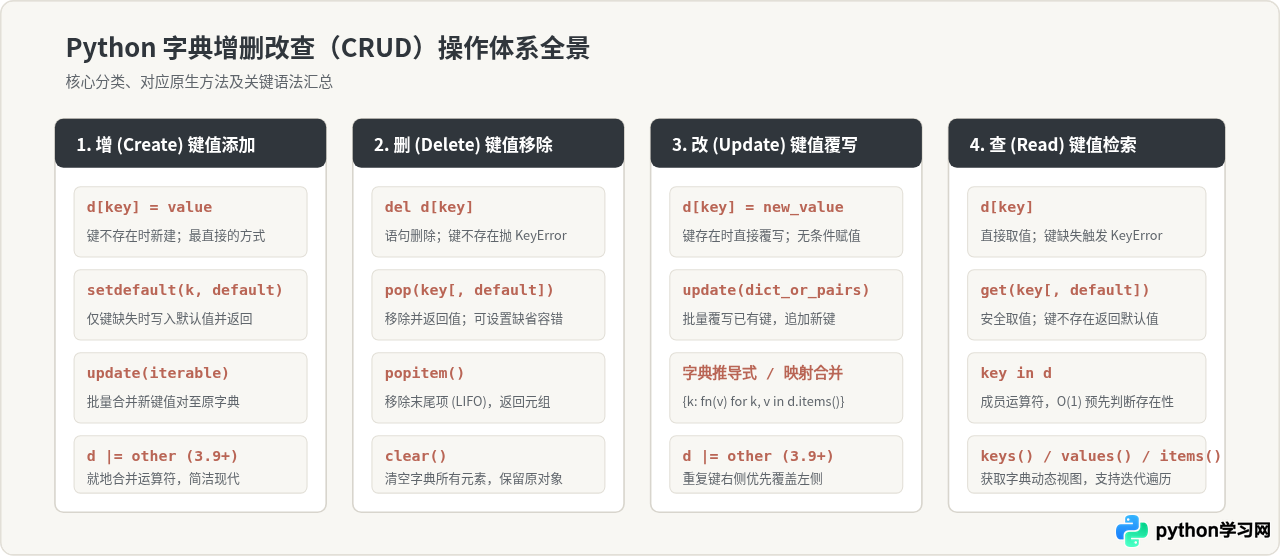
dict)是基于哈希表实现的可变键值对映射结构。所谓“增删改查”(CRUD),分别对应向字典添加键值对、从字典中删除指定键、修改现有键所映射的值以及检索查询键值数据。本文将系统梳理 Python 字典原生支持的所有操作方法与对应语法,对比不同方式在键存在与缺失时的行为差异,帮助你在编写代码时做出准确、健壮的技术选择。
一、增与改:键值写入与批量更新
在 Python 中,“增加新键值”与“修改已有键的值”在语法层面有极高的重合度。这是因为字典键具有唯一性约束:当目标键不存在时执行新增,当目标键已存在时则覆盖原有映射。
1. 下标索引赋值:d[key] = value
下标直接赋值是日常开发中最常见、开销最小的方式。其行为极为明确:如果 key 存在于字典中,将其旧值替换为 value;如果 key 不存在,则在字典哈希表中新建该键,并绑定对应值。
# 初始化示例字典
user_info = {"name": "Alice", "role": "developer"}

# 1. 修改已有键:role 的值被直接更新
user_info["role"] = "tech_lead"

# 2. 增加全新键:department 原先不存在,直接插入
user_info["department"] = "Infrastructure"

print(user_info)
# 示例输出:{'name': 'Alice', 'role': 'tech_lead', 'department': 'Infrastructure'}
2. 批量更新:d.update() 与合并运算符 |=
当需要同时追加或修改多个键值对时,反复写单行赋值既繁琐又不利于性能。Python 提供了 update() 方法,可以接收另一个字典、键值对序列(如列表嵌套元组)或关键字参数。
config = {"debug": True, "timeout": 30}

# 传入另一个字典进行合并(覆写 debug,新增 port)
config.update({"debug": False, "port": 8080})

# 也可以使用关键字参数进行更新
config.update(retries=3, timeout=60)

print(config)
# 示例输出:{'debug': False, 'timeout': 60, 'port': 8080, 'retries': 3}
在 Python 3.9 及更高版本中,引入了字典合并运算符:|(生成新字典)与 |=(原地更新字典)。config |= extra_config 在语义上等价于 config.update(extra_config),且语法更为直观。
3. 条件性写入:d.setdefault(key, default)
setdefault() 是一个容易被误解但功能强大的方法。它的核心逻辑是:仅在键不存在时,才向字典中写入指定的默认值,并返回该键当前的值。如果该键已经存在,它不会做任何修改,直接返回现有值。
# 常见场景:按分类归集数据的分组器
grouped_items = {}

items = [("fruit", "apple"), ("vegetable", "carrot"), ("fruit", "banana")]

for category, name in items:
    # 若 category 键不存在,则初始化一个空列表 [];若已存在,直接返回已有列表
    # 随后直接调用 .append() 将元素推入
    grouped_items.setdefault(category, []).append(name)

print(grouped_items)
# 示例输出:{'fruit': ['apple', 'banana'], 'vegetable': ['carrot']}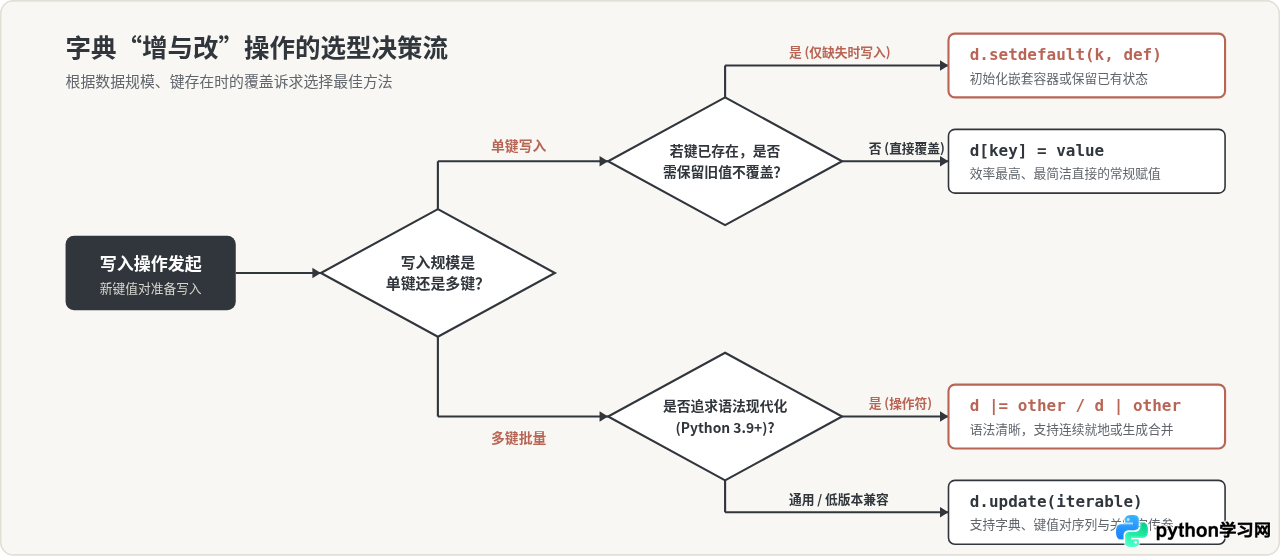
二、查:安全读取与视图访问
查询是字典最核心的使用场景之一。由于字典采用哈希表定位,按键查找的平均时间复杂度为 \(O(1)\)。但在实际业务中,未命中键的处理方式直接关系到代码的健壮性。
1. 下标访问与 KeyError
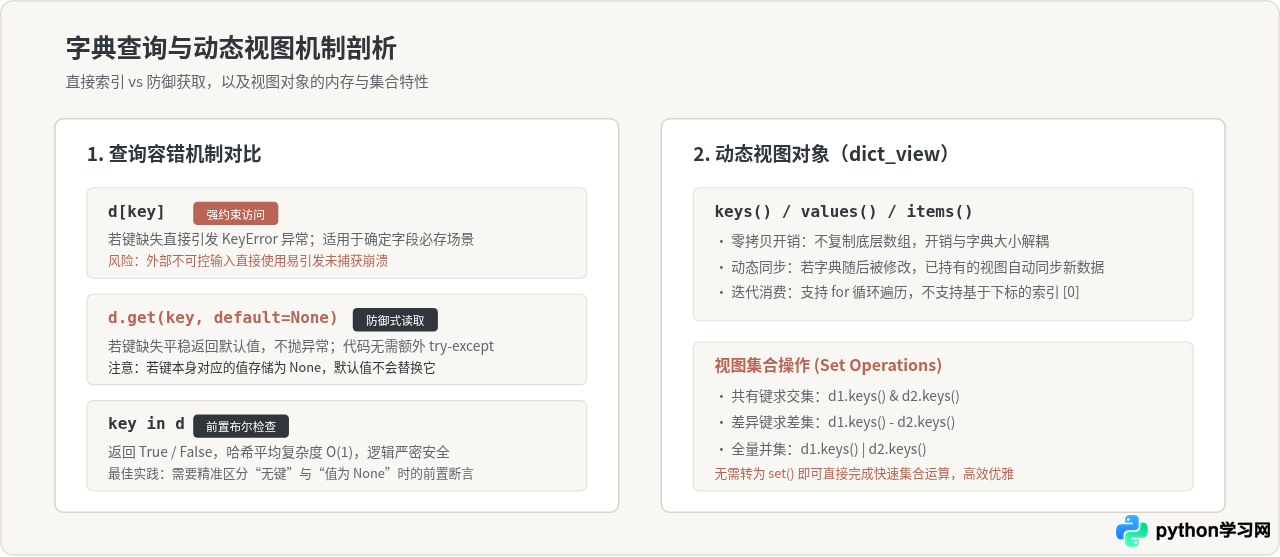
通过 d[key] 读取值是最纯粹的方式。它的执行假设是“该键必须存在”。一旦给入一个字典中不存在的键,Python 会立即抛出 KeyError 并中断程序。
profile = {"id": 1001, "name": "Bob"}

# 正常读取
print(profile["name"])  # 输出:Bob

# 潜在风险:读取不存在的键将抛出异常
# print(profile["email"])  # 触发 KeyError: 'email'
因此,只有在业务逻辑严格要求该键必须存在(若缺失属于严重异常数据)时,才建议裸用 d[key]。
2. 防御性读取:d.get(key, default=None)
get() 方法是处理不确定键的核心工具。当目标键存在时,它返回对应的值;当目标键不存在时,它不会抛出异常,而是返回默认值(默认为 None,也可以由第二个参数显式指定)。
# 即使 email 键不存在,也不会引发崩溃
email = profile.get("email")
print(email)  # 输出:None

# 提供回退默认值
status = profile.get("status", "inactive")
print(status) # 输出:inactiveNone,例如 {"email": None},那么 profile.get("email", "unknown") 依然会返回 None,而不会返回 "unknown"。因为只有在键完全缺失时,默认值才会生效。如果需要区分“键不存在”还是“键的值为 None”,应结合成员运算符 in 进行判断。
3. 存在性检查:key in d
通过 key in d 可以直接得到布尔值(True 或 False)。得益于哈希结构,这一检查的平均开销同样是 \(O(1)\),避免了遍历整个字典,比通过 key in d.keys() 更精炼高效。
4. 字典视图(Views):keys()、values() 与 items()
在 Python 3 中,d.keys()、d.values() 和 d.items() 返回的不再是固定列表,而是动态视图对象(dict_view)。
- 动态联动性:视图并不占用与键值对等同的独立列表内存,当原字典发生修改时,已创建的视图会实时反映这些变更。
- 集合运算支持:
keys()和items()视图支持数学上的集合操作,如交集(&)、并集(|)、差集(-),能极其优雅地对比两个字典的键差异。
三、删:键值移除与清空机制
删除操作用于释放无用内存或调整数据状态。Python 提供了多种删除途径,它们的区别主要在于:是否返回被删除的值、在目标键不存在时是否崩溃,以及是清除局部条目还是重置整个容器。
1. 语句删除:del d[key]
del 是 Python 的内置关键字语句,不仅能删变量,还能直接从字典中移除指定键的条目。由于是语句而非函数,它不返回任何值。若删除的键不存在,将引发 KeyError。
data = {"a": 1, "b": 2, "c": 3}

del data["a"]
print(data)
# 示例输出:{'b': 2, 'c': 3}

# 若执行 del data["not_exist"] 将引发 KeyError
2. 弹出并获取值:d.pop(key[, default])
pop() 是最推荐的删除方法,因为它同时兼顾了“获取旧值”与“容错处理”:
- 如果只传入
key:删除该键并返回其对应的值;若键不存在则抛出KeyError。 - 如果传入了
default参数:当键不存在时,不会报错,而是平稳返回该默认值。
cache = {"token": "xyz123", "ttl": 3600}

# 1. 弹出并取出旧值
token_val = cache.pop("token")
print(token_val)  # 输出:xyz123

# 2. 安全删除可能不存在的键(无视 KeyError 风险)
expired_val = cache.pop("expired_at", None)
print(expired_val)  # 输出:None
3. 栈式弹出末尾条目:d.popitem()
自 Python 3.7 起,字典在语言规范层面严格保证插入顺序(Insertion Order)。popitem() 会以后进先出(LIFO)的顺序弹出并返回字典末尾的 (key, value) 元组。如果对空字典调用 popitem(),将引发 KeyError。
tasks = {"task1": "pending", "task2": "running", "task3": "done"}

last_item = tasks.popitem()
print(last_item)  # 输出:('task3', 'done')
print(tasks)      # 输出:{'task1': 'pending', 'task2': 'running'}
4. 原地清空容器:d.clear()
当需要抹去字典中的全部条目时,新手常通过重新赋值 d = {} 来操作。但这存在巨大的对象引用陷阱:如果其他变量也持有着该字典的引用,d = {} 只是将 d 指向了一个全新的空字典,而其他引用指向的原字典依然保留全部数据。
使用 d.clear() 会直接清空该字典对象本身内部的所有数据,所有共享该引用的对象均会同步观察到清空结果。
# 引用隔离测试
shared_ref = {"count": 10}
local_alias = shared_ref

# 原地清空
shared_ref.clear()
print(local_alias)  # 输出:{},共享对象内部数据被彻底清空
四、操作汇总速查表
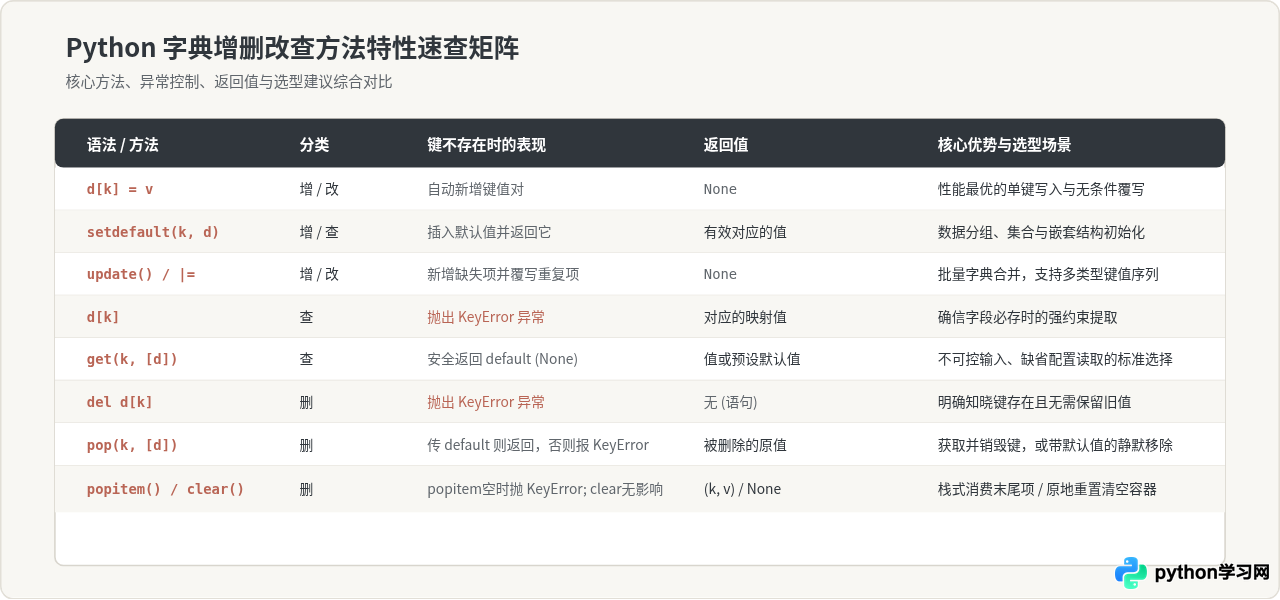
为了在开发中快速对齐各个方法的参数、返回值和异常规则,下表对 Python 字典增删改查的所有原生方法进行了集中归纳:
| 操作类型 | 方法 / 语法 | 键不存在时的行为 | 返回值 | 典型适用场景 |
|---|---|---|---|---|
| 增 / 改 | d[k] = v |
直接新增该键 | 无(None) |
最基础的单键设置,无条件覆盖 |
| 增 / 查 | setdefault(k, default) |
写入默认值并返回该默认值 | 键当前的值 | 分组聚合、嵌套字典默认初始化 |
| 增 / 改 | update(other) |
新增缺失键,覆盖已有键 | 无(None) |
批量合并多个键值对 |
| 增 / 改 | d |= other (3.9+) |
新增缺失键,覆盖已有键 | 无(就地变动) | 现代 Python 中的批量合并运算 |
| 查 | d[k] |
抛出 KeyError |
键对应的值 | 强断言键必须存在的数据提取 |
| 查 | get(k, [default]) |
返回 default(默认 None) |
键对应的值或默认值 | 安全的防御性读取,规避异常 |
| 查 | k in d |
返回 False |
布尔值 | 前置条件判断,复杂度 \(O(1)\) |
| 查 | keys() / values() / items() |
— | 动态视图对象 | 遍历循环、键集合交并差运算 |
| 删 | del d[k] |
抛出 KeyError |
无(关键字语句) | 已知键存在且无需返回旧值 |
| 删 | pop(k, [default]) |
若传默认值则返回它,否则抛异常 | 被删除键的值或默认值 | 消费并取出值,或安全的静默删除 |
| 删 | popitem() |
若字典为空抛出 KeyError |
最后一条 (key, value) |
LIFO 栈式提取、循环消费队列 |
| 删 | clear() |
无影响(依然为空) | 无(None) |
原地重置清空容器,保持引用不变 |
五、高频踩坑点与最佳实践
1. 遍历过程中修改字典长度
在遍历字典的同时直接增删键值对,会导致底层哈希表结构变更,从而触发 RuntimeError: dictionary changed size during iteration。
scores = {"math": 85, "physics": 59, "history": 92}

# 错误做法:在循环迭代时直接删除键
# for subject, score in scores.items():
#     if score < 60:
#         del scores[subject]  # 报错:RuntimeError

# 正确解法一:遍历键的静态副本(通过 list 包装)
for subject in list(scores.keys()):
    if scores[subject] < 60:
        del scores[subject]

# 正确解法二:使用字典推导式生成符合条件的新字典
filtered_scores = {k: v for k, v in scores.items() if v >= 60}
2. 键的可哈希性(Hashability)要求
由于字典查找依赖于哈希计算,字典的键必须是可哈希(不可变)对象。常见的字符串、整数、浮点数、元组(其元素也必须不可变)均可作为键;但列表、集合和字典本身属于可变对象,无法计算稳定哈希值,尝试将其作为键会抛出 TypeError: unhashable type。如果需要复合数据作为键,务必转换为元组(tuple)或冻结集合(frozenset)。
3. 合理选用 collections.defaultdict
如果代码中充斥着大量的 d.setdefault(key, []) 或 if key not in d 嵌套初始化,可以考虑引入标准库中的 collections.defaultdict。它在实例化时接收一个工厂函数(如 list、int),在任何未注册键被访问时自动执行初始化,使业务代码更轻量纯粹。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















