


DeepSeek R1推理模型有什么特点?思维链机制解析

你是不是也遇到过这种情况:问大模型一道复杂的数学题或逻辑谜题,它往往脱口而出一个答案,虽然自信满满,但仔细一推敲却是错的?或者在写一段稍微绕弯的代码时,它直接给出了结果,却没法解释中间的逻辑断层。
这其实是传统大语言模型的通病——它们太急于给出“下一个字”,而忽略了“想清楚再说话”。DeepSeek R1 的出现,正是为了解决这个痛点。它不像以前的模型那样靠海量数据硬背答案,而是学会了一种类似人类解题时的“打草稿”习惯,也就是我们常说的思维链(Chain of Thought, CoT)。
从“直觉反应”到“慢思考”
大多数通用大模型在处理问题时,依赖的是概率预测。就像人凭直觉答题,速度快但容易出错。DeepSeek R1 的核心变化在于,它在输出最终答案前,会强制自己生成一段长长的推理过程。
这个过程不是简单的废话文学,而是包含了对问题的拆解、假设的验证、错误的自我纠正以及步骤的复盘。你可以把它想象成一个学生在考试时,不再直接写答案,而是在试卷空白处画满了推导公式和逻辑草图。只有当这些“草稿”逻辑自洽后,它才会提炼出最终结论。
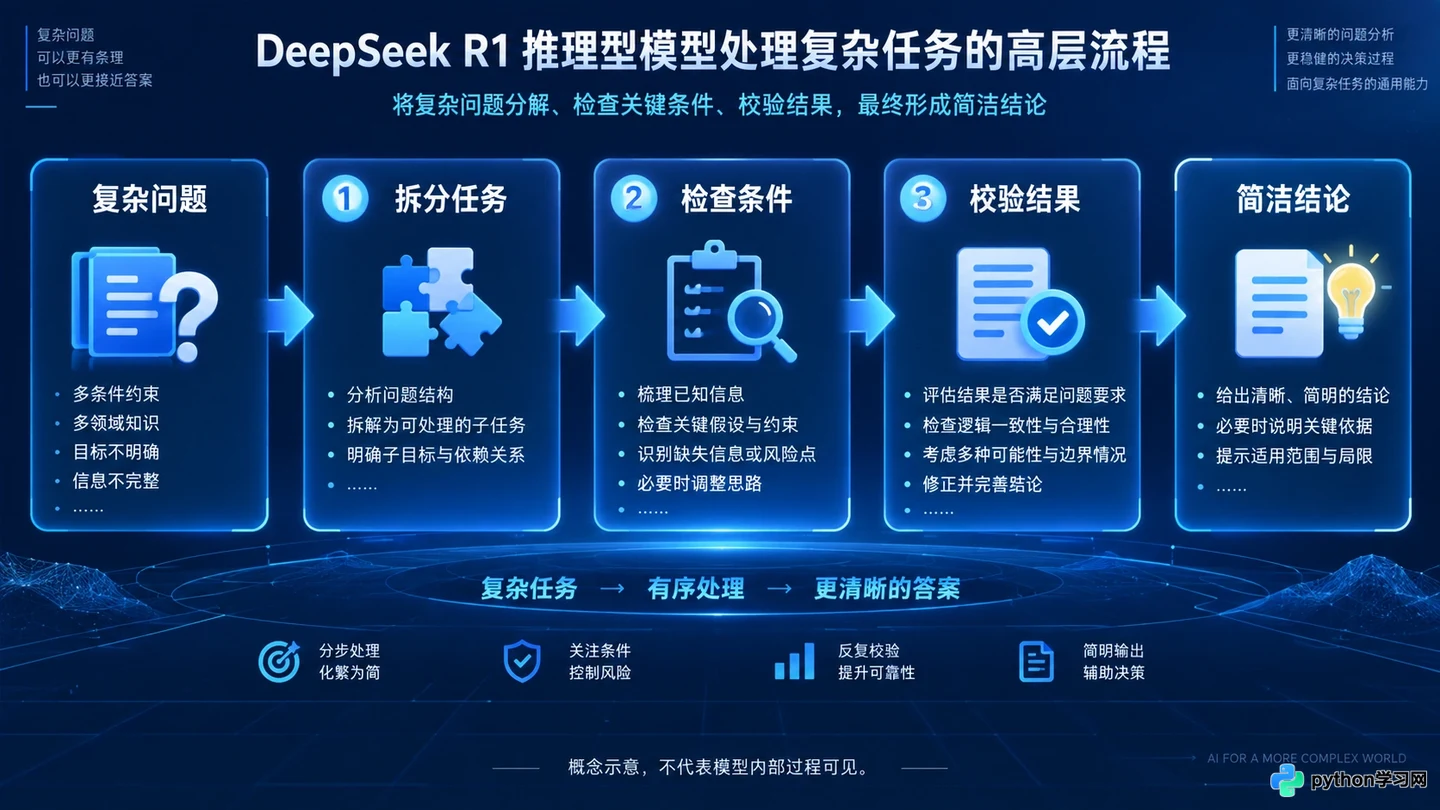
DeepSeek R1在输出答案前生成的内部推理路径
这种机制带来的最直观感受是“慢”。但在处理奥数题、复杂代码调试或科学推理时,这种“慢”换来了极高的准确率。它不再是猜谜,而是在真正地进行逻辑推演。
强化学习:让模型自己学会“反思”
DeepSeek R1 之所以能拥有如此高质量的思维链,关键不在于喂给它多少教科书,而在于训练方法的革新。它大量使用了强化学习(Reinforcement Learning, RL),特别是针对推理任务的专项优化。
在传统训练中,模型只要答案对就算得分。而在 R1 的训练框架下,模型不仅要看结果,还要看过程。如果推理路径中存在逻辑跳跃、自相矛盾或无效重复,即使最终答案蒙对了,也会受到惩罚。反之,如果模型能够识别出自己的错误并进行修正(Self-Correction),则会获得更高的奖励。
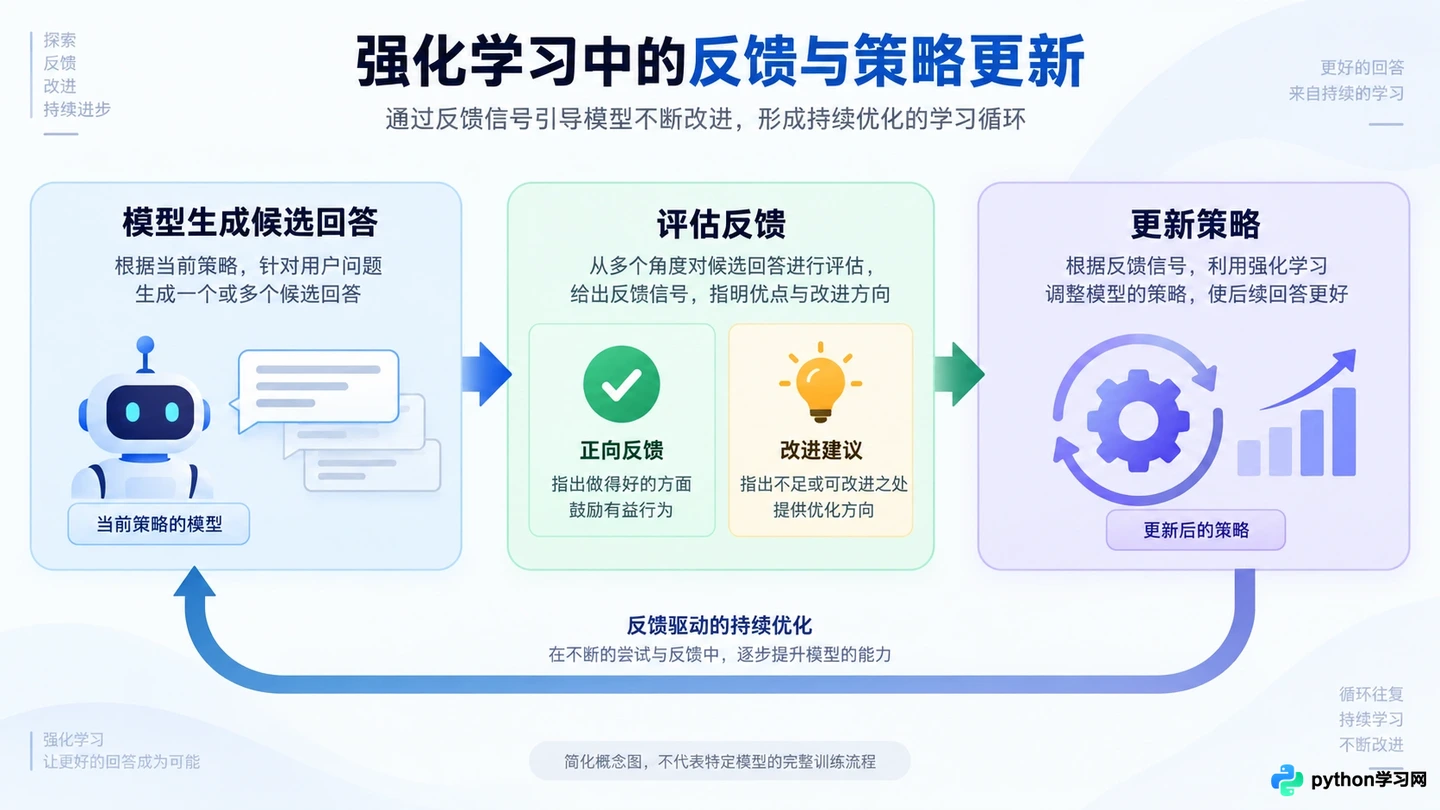
强化学习如何通过奖励机制优化推理路径
这就好比请了一位严厉的教练,不仅检查你的作业答案,还逐行批改你的解题步骤。久而久之,模型就内化了一套严谨的思维规范:遇到难题先拆解,遇到死胡同会回溯,不确定时会尝试多种路径验证。这种能力不是硬编码的规则,而是模型在数百万次试错中自己“悟”出来的。
复杂任务中的实际表现
这种思维链机制在哪些场景下最有用?首先是数学和科学领域。面对需要多步推导的微积分或物理问题,R1 能够清晰地列出已知条件、选择公式、代入计算并检查量纲,极大地减少了计算幻觉。
其次是代码生成。对于复杂的算法实现,R1 会在编写代码前先分析数据结构、边界条件和时间复杂度。如果中间发现逻辑漏洞,它会在思维链中明确指出并调整方案,而不是生成一堆看似正确实则无法运行的代码。
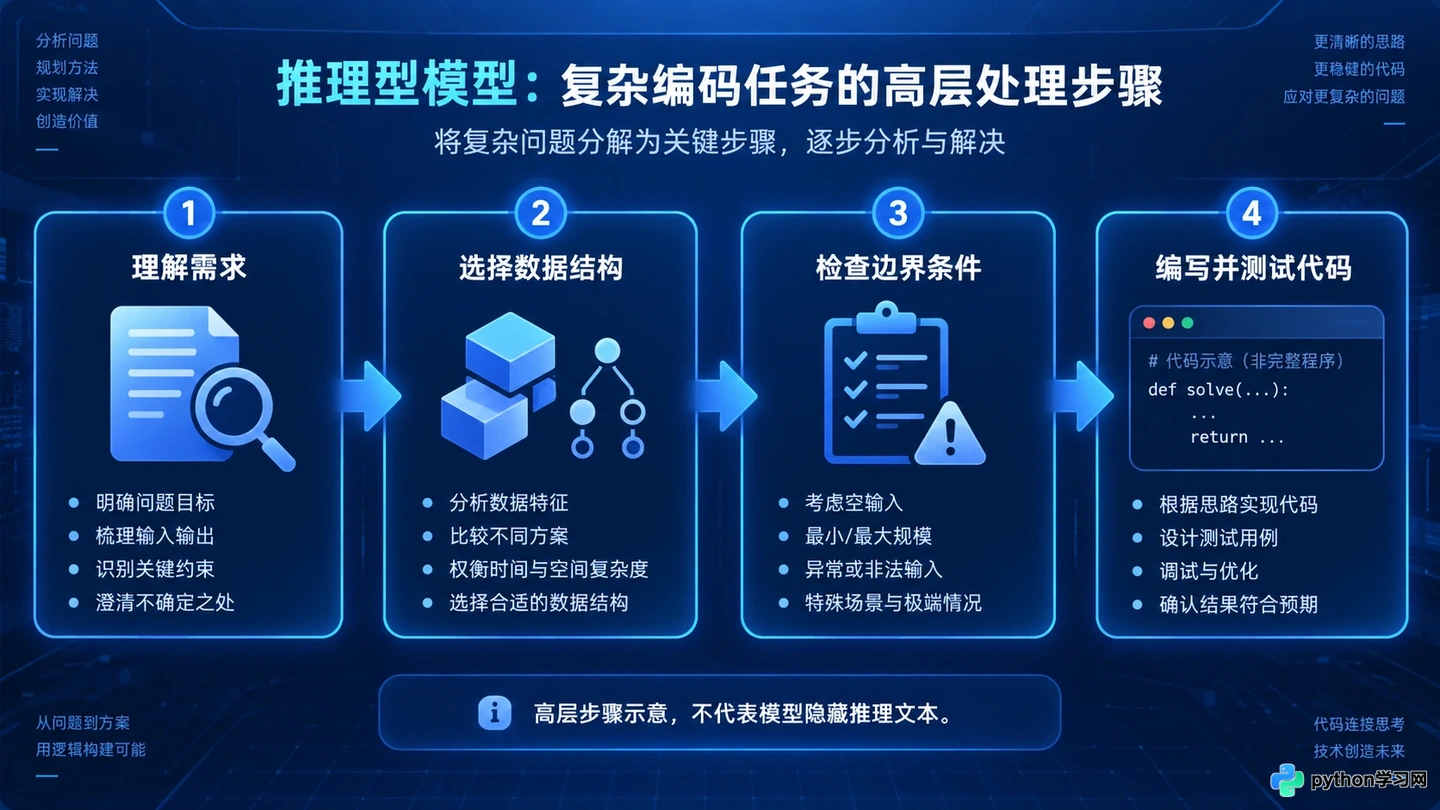
R1在编写代码前的逻辑分析思维链展示
最后是逻辑推理和常识判断。在处理包含多重否定、陷阱选项的智力题时,R1 会通过逐步排除法来锁定正确答案,而不是依赖关键词匹配。这种表现让它在需要高可靠性的专业辅助场景中,比传统模型更具参考价值。
如何看待推理模型的局限
当然,DeepSeek R1 并非万能。思维链机制意味着更高的计算成本和更长的响应时间。对于简单的问答,如“今天天气如何”,启用完整的推理过程显然是杀鸡用牛刀,既浪费资源又降低体验。
此外,虽然模型学会了自我纠正,但它依然可能陷入“一本正经地胡说八道”的循环,特别是在缺乏足够知识储备的冷门领域。它的逻辑可能很严密,但前提如果是错的,结论自然也是错的。
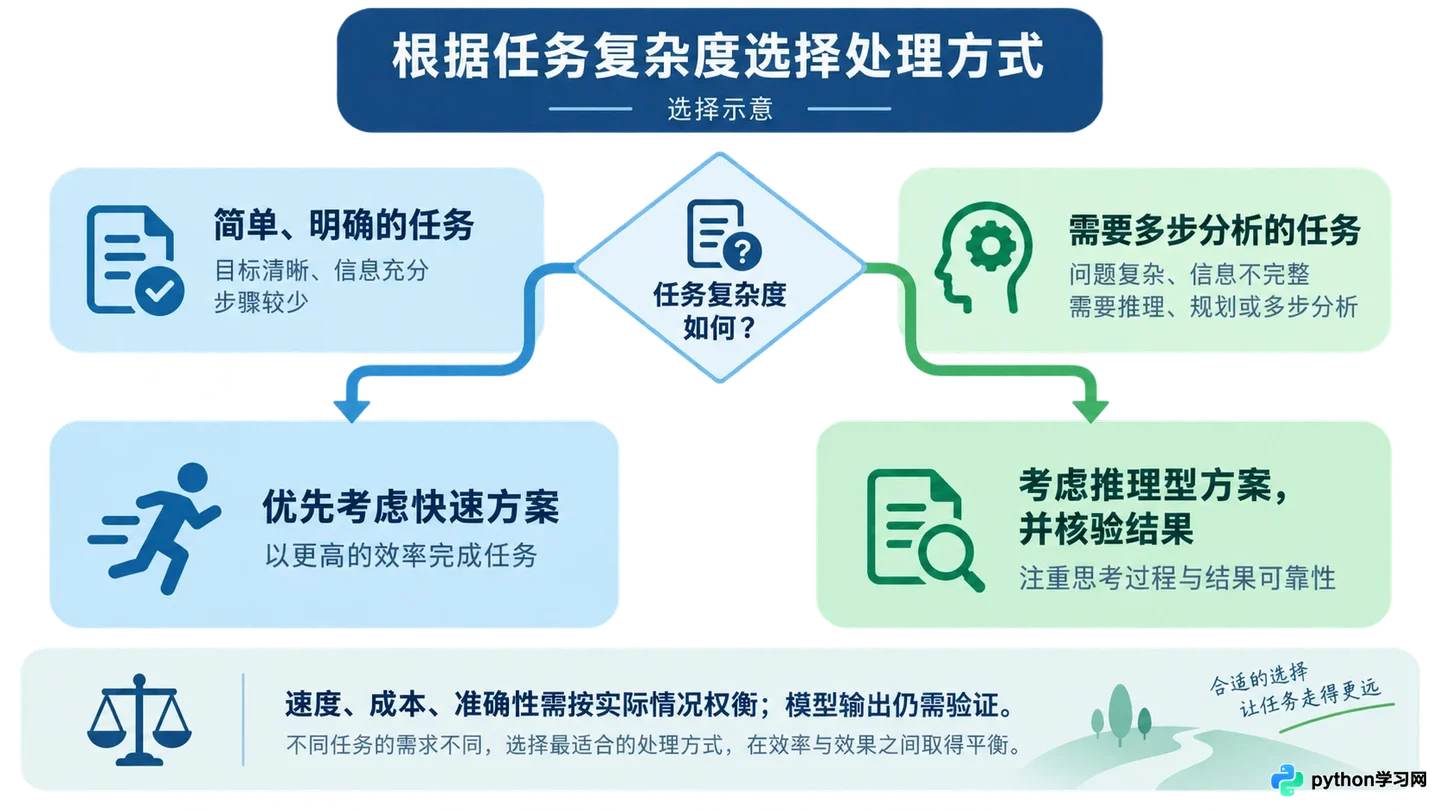
不同任务类型下模型选择的决策示意
因此,在使用这类推理模型时,最佳策略是将其视为“高级分析师”而非“搜索引擎”。让它处理那些需要深度思考、多步验证的复杂任务,而对于简单的事实查询,传统的高效模型或许仍是更好的选择。理解这一点,才能在实际应用中发挥出 DeepSeek R1 的最大价值。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















