


Python列表含混合类型时怎么安全进行倒序排序?

在 Python 3 中,直接对包含整数、浮点数、字符串甚至 None 的混合类型列表调用 list.sort(reverse=True) 或 sorted(lst, reverse=True),会立即触发 TypeError: '<' not supported between instances 运行时异常。出现该报错的根本原因在于 Python 3 彻底放弃了异构类型间的隐式大小比较,而 Python 排序算法在执行倒序时底层依旧依赖严格的偏序关系。要实现真正安全且语义明确的倒序排序,核心方法是通过 key 参数构造包含类型优先级的多级比较元组,或在排序前进行类型隔离分流与独立处理。
一、混合类型直接排序的报错根源
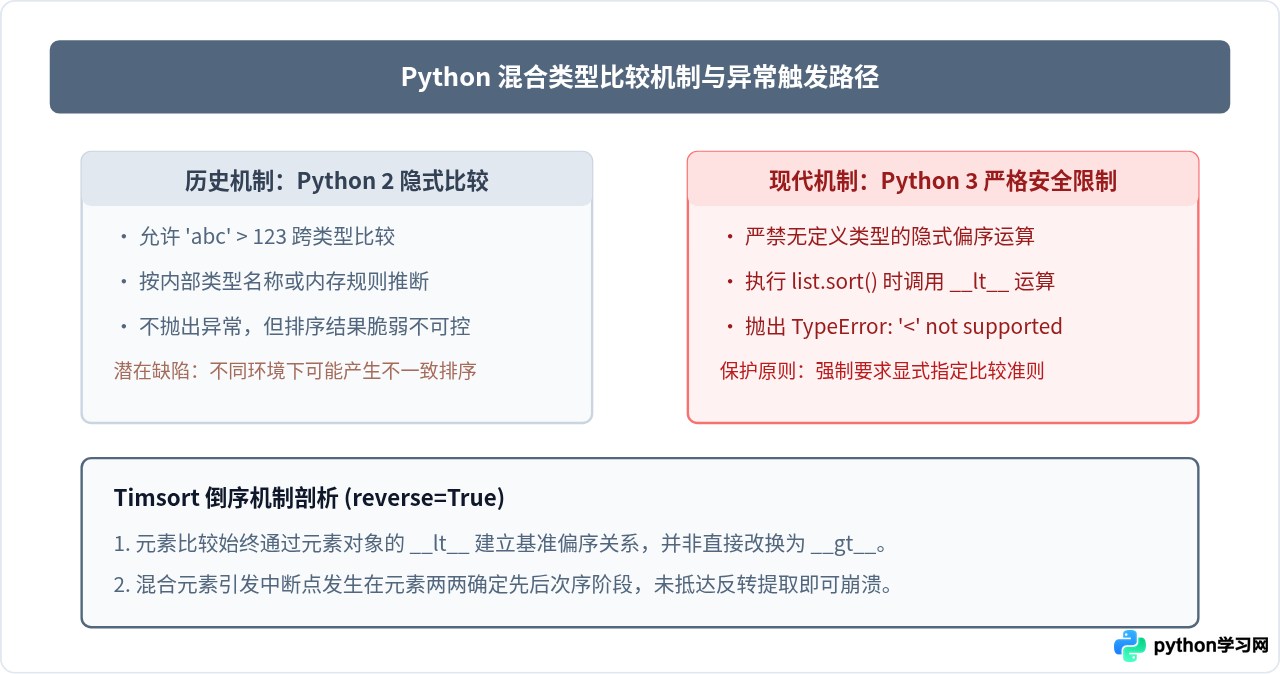
在早期的 Python 2 中,跨类型的比较是允许的,解释器会按照类型名称的硬编码规则或内存地址做出比较判断(例如数字始终小于字符串)。这种设计虽然表面上避免了报错,却造成了大量反直觉的隐蔽缺陷。Python 3 确立了严格类型安全原则,当两个不同类型的对象之间未定义 __lt__(小于)运算时,直接比较即判定为非法。
很多开发者初次遇到该问题时会疑惑:明明传入了 reverse=True,按理说应该使用“大于”(>)比较,为何错误信息依然显示 '<' not supported?这是因为 Python 内置的 Timsort 算法在实现逆序时,并非将所有比较符号替换为 >,而是为了保持排序算法的稳定性与规范化,依旧统一使用 __lt__ 建立元素的正序偏序关系,随后在算法内层反转提取顺序或反向重排。因此,任何未提供安全键转换的直接比较都会在遇到不同类型时中断。
二、方案一:多级元组键函数(推荐度最高)
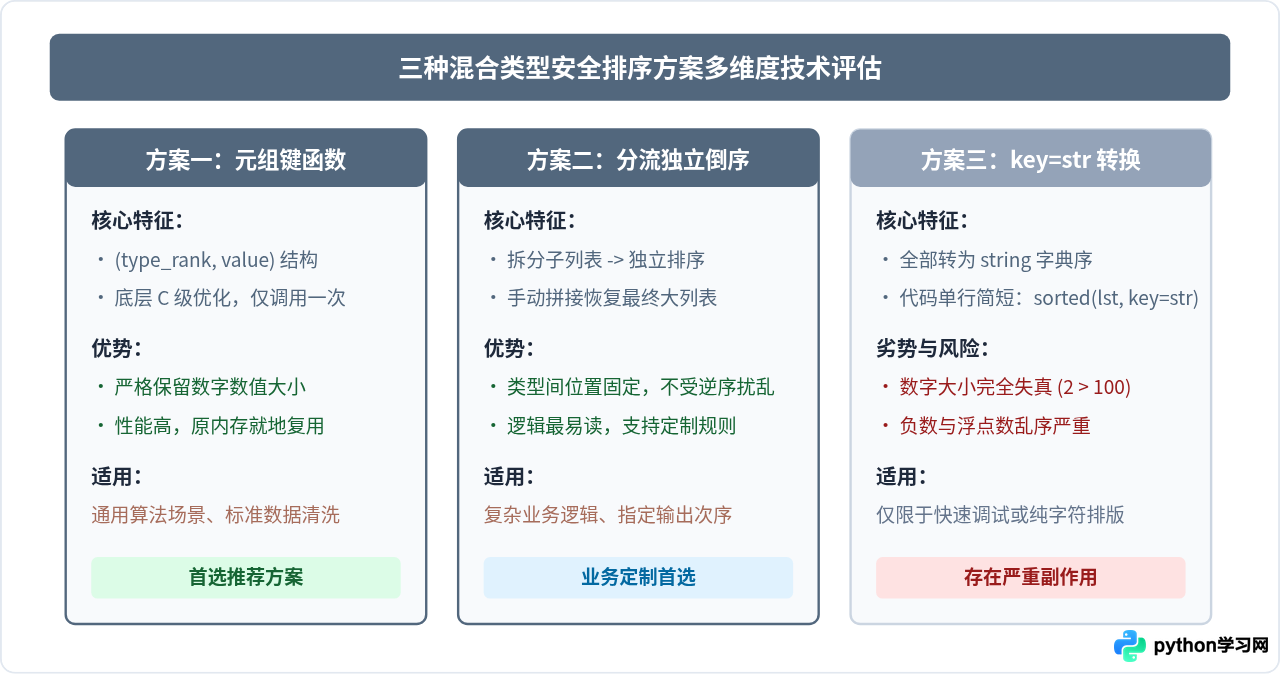
在 Python 中,元组(tuple)之间支持逐项对比:比较两个元组时,解释器先比较第一个元素;若相同,再递归比较第二个元素。利用这一语言特性,我们可以通过 key 参数将列表中的每个元素转换为一个结构整齐的元组:(类型权重, 归一化可比值)。
在处理倒序需求时,需要特别注意 reverse=True 的整体翻转效应:它不仅会使“同类型内部”的值按倒序排列,也会使“类型权重”发生逆转。如果业务要求“高权重类型在先且内部倒序”,则直接使用 reverse=True 即可。
标准实现示例
def mixed_sort_key(item):
    # 数值类型(int, float)合并为同组,注意避开 bool
    if isinstance(item, (int, float)) and not isinstance(item, bool):
        return (3, item)
    elif isinstance(item, str):
        return (2, item)
    elif isinstance(item, bool):
        return (1, int(item))
    elif item is None:
        return (0, "")
    else:
        # 其他未枚举类型统归到最低优先级,转换为字符串比较
        return (-1, str(item))

raw_list = [42, "banana", 3.14, "apple", None, True, 100, False]
sorted_desc = sorted(raw_list, key=mixed_sort_key, reverse=True)
print("安全倒序排序结果:", sorted_desc)
# 输出:[100, 42, 3.14, 'banana', 'apple', True, False, None]bool 是 int 的子类(isinstance(True, int) 为 True)。如果不加 and not isinstance(item, bool) 进行显式分流,布尔值 True 和 False 就会被视作数字 1 和 0 混入数值队列中。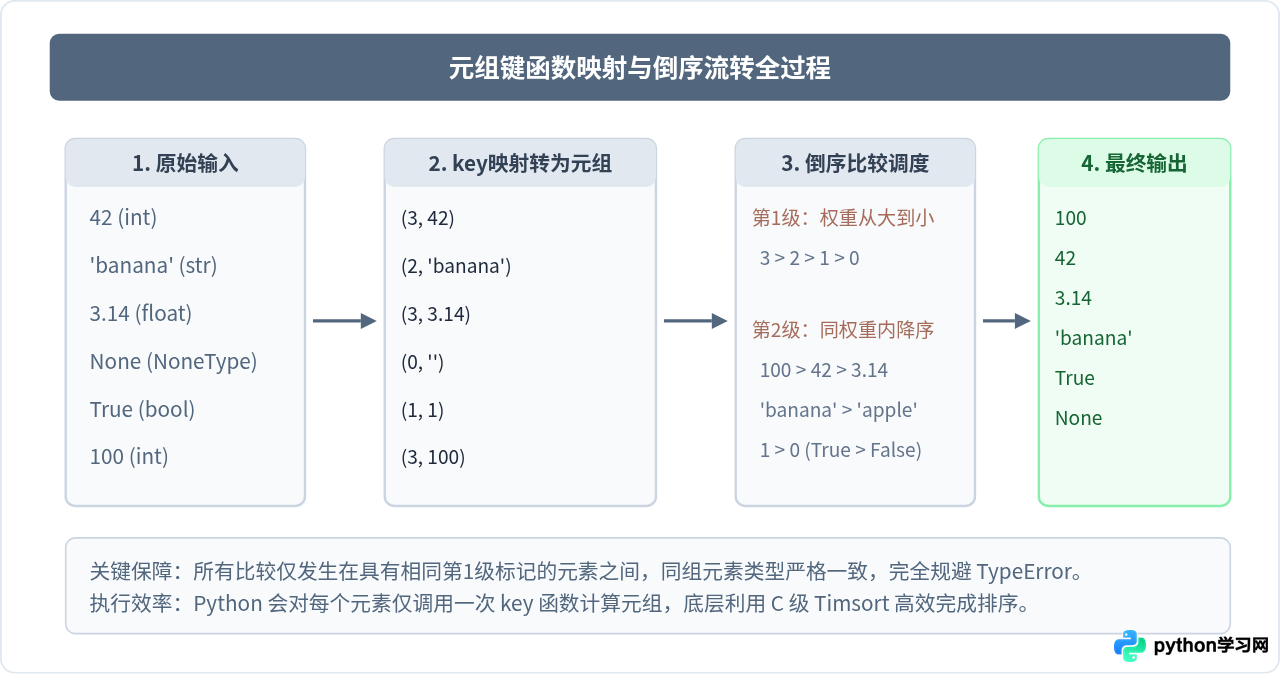
三、方案二:类型分组过滤与独立倒序拼接
在很多现实业务场景中,“类型与类型之间的前后顺序”是由业务规则人为硬性规定的,不应受 reverse=True 翻转操作的影响。例如业务要求:“不论正序还是倒序,所有字符串必须在前,数字必须在后;但字符串内部要按字母倒序,数字内部要按从大到小倒序”。
此时若单纯使用单个元组函数配合 reverse=True,类型的先后顺序也会跟着被倒置。更清晰直观、且易于后续维护的方式是:先按类型将元素分流到不同的子列表中,对各个子列表分别执行独立的倒序排序,最后按照业务顺序重新拼接。
实现代码
def safe_group_reverse_sort(items, type_priority_order=None):
    # 初始化常见类型的分流桶
    buckets = {
        'numbers': [],
        'strings': [],
        'booleans': [],
        'nones': [],
        'others': []
    }

    # 步骤1:单次遍历分流
    for x in items:
        if isinstance(x, bool):
            buckets['booleans'].append(x)
        elif isinstance(x, (int, float)):
            buckets['numbers'].append(x)
        elif isinstance(x, str):
            buckets['strings'].append(x)
        elif x is None:
            buckets['nones'].append(x)
        else:
            buckets['others'].append(x)

    # 步骤2:各同构子列表独立执行安全倒序
    buckets['numbers'].sort(reverse=True)
    buckets['strings'].sort(reverse=True)
    buckets['booleans'].sort(key=int, reverse=True)
    buckets['others'].sort(key=str, reverse=True)

    # 步骤3:按明确的业务次序组装
    # 默认业务次序:字符串组在先、数字组居中、布尔在后、None殿后
    return buckets['strings'] + buckets['numbers'] + buckets['booleans'] + buckets['others'] + buckets['nones']

data = [10, "cherry", 2.5, "apple", None, False, 100, True]
result = safe_group_reverse_sort(data)
print("业务定制倒序拼接结果:", result)
# 输出:['cherry', 'apple', 100, 10, 2.5, True, False, None]
该方案不仅逻辑极为透明,排查故障方便,而且对无法相互比较的自定义业务实体对象也能轻松拓展容纳,是复杂项目中最稳妥的工程实践。
四、方案三:字符串化(str)转换的简易性与局限陷阱
许多初学者往往倾向于使用极简的一行写法:sorted(lst, key=str, reverse=True)。这种做法将所有元素强制调用 str() 转换成字符串后再做逆序比较。
key=str 会使数值失去原本的数学大小意义,完全转变为“字典序”(ASCII / Unicode 编码顺序)。例如在数字倒序中,数值 20 会排在 100 之前,因为字符 '2' 的 ASCII 码大于字符 '1'。| 输入数据 | 预期数学倒序 | key=str 倒序结果 | 产生偏差原因 |
|---|---|---|---|
[2, 10, 100] |
[100, 10, 2] |
[2, 100, 10] |
字符 '2' > '1',字典序颠倒了数值大小 |
[-5, -1, 3] |
[3, -1, -5] |
[3, -5, -1] |
负号相同比较下一位,'5' > '1' 导致 -5 被排在前面 |
[None, "apple"] |
依业务决定 | ['apple', None] |
'apple' 字典序前于 'None' |
结论非常清晰:只有在所有混合元素本就主要用于控制台展示、日志文本打印,且完全不在乎数字实际数值大小的场景下,才可以临时采用 key=str。严禁在带有业务计算或数值排名的逻辑中使用该方法。
五、综合落地决策指南
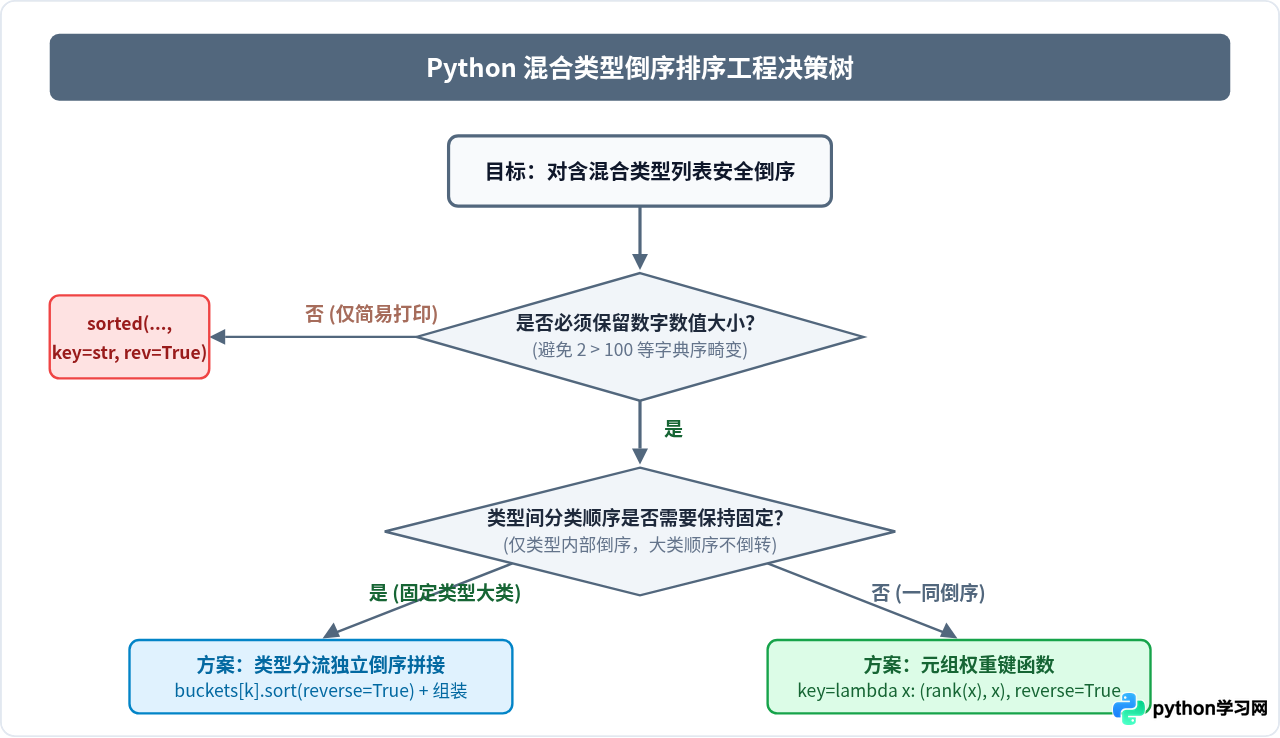
在工程项目中遇到混合类型列表倒序需求时,切忌盲目套用简易脚本。开发者可按照以下决策链条快速选定最适合当前场景的高质量方案:
- 明确列表内是否包含真实数字:若包含且其数值大小关系至关重要,立刻排除
key=str。 - 确定组间顺序与组内逆序的关联:
- 如果要求类型权重与内容一并逆序翻转,选用多级元组键(Tuple Key);
- 如果要求类型大分类保持绝对固定(例如字符串始终排在前面),必须选用类型分流独立倒序拼接法。
- 防御特殊类型干扰:确认是否有
bool、None或未定义__lt__的自定义类实例,在key映射中完成针对性归一化与保底降级。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















