


Python切片基础语法:列表与字符串截取示例

发布时间:2026-10-22 |
5人浏览过
在Python中,切片(Slicing)是从有序序列(如列表、字符串、元组)中快速提取指定子集的核心语法。通过简单紧凑的中括号表示法 sequence[start:stop:step],开发者无需编写显式循环即可实现区间读取、间隔采样、局部复制以及序列倒序。掌握切片语法的关键在于理清起始与结束边界的前闭后开规则,以及正负索引在序列中的实际映射关系。
一、切片基本语法与区间开闭机制
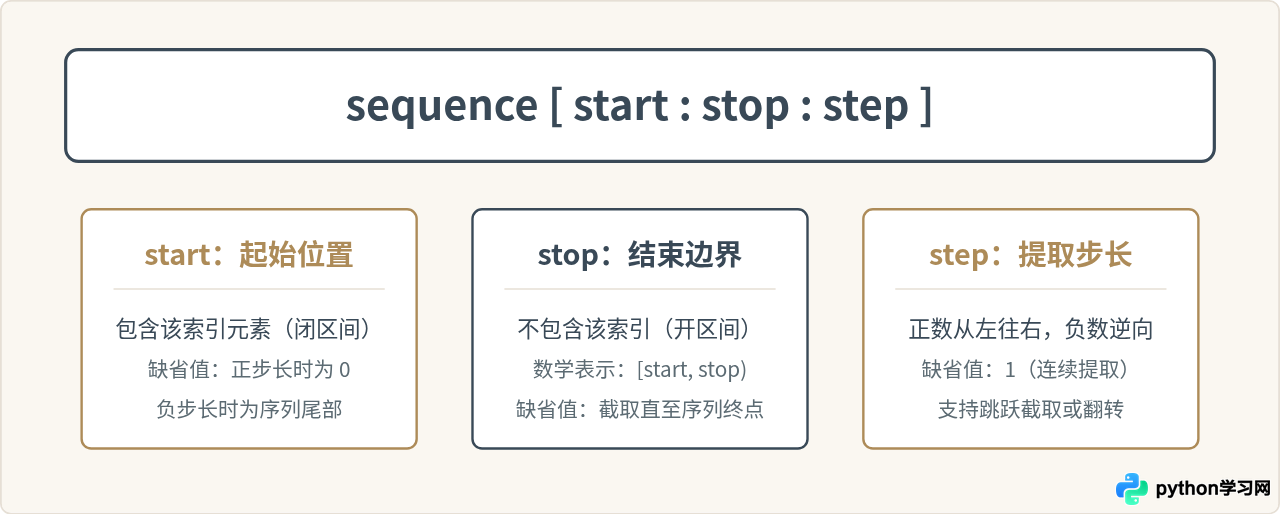
Python切片操作通过三个参数定义截取范围:起始位置 start、终止位置 stop 和步长 step。其标准格式写在变量名后的一对方括号内,参数间用英文冒号分隔:
# 标准语法格式
sub_sequence = sequence[start:stop:step]
关于这三个参数的核心定义如下:
- start(起始索引):切片提取的起点,该位置的元素包含在结果中(闭区间)。若省略,步长为正时默认从序列开头(索引0)开始。
- stop(结束索引):切片提取的终点,该位置的元素不包含在结果中(开区间)。若省略,步长为正时默认截取到序列末尾(包含最后一个元素)。
- step(步长):每次提取元素时的移动跨度。默认为1,表示逐个连续提取;若为大于1的正整数,表示间隔提取;若为负数,表示逆向遍历。
二、双向索引体系:正向与负向对照
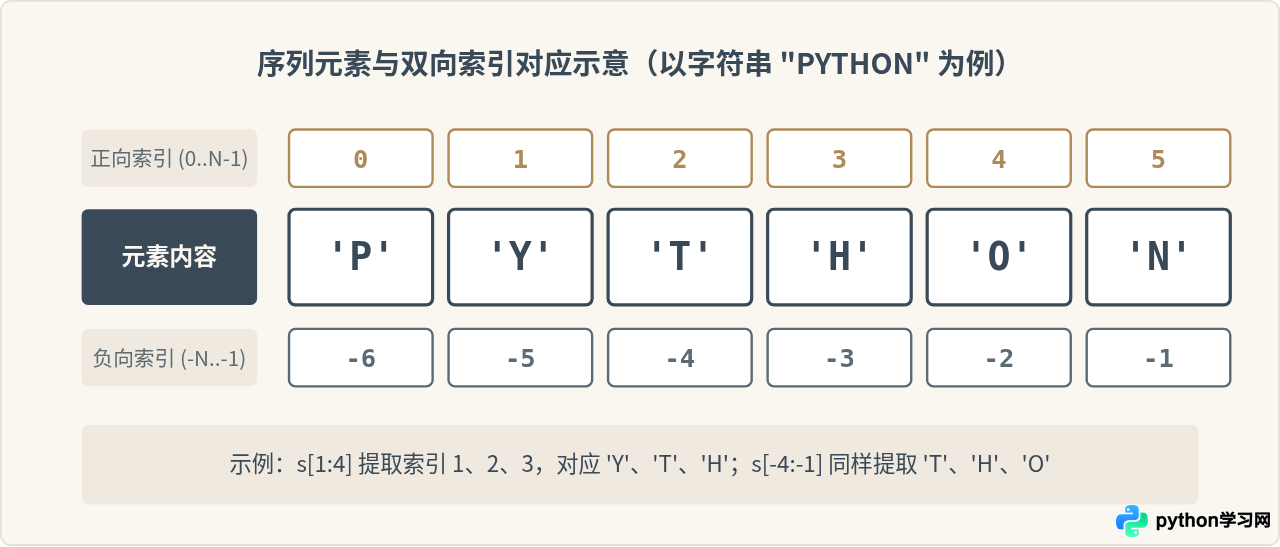
要精准编写切片代码,首先必须建立对Python双向索引的直观认识。任何长度为 \(N\) 的序列都支持两种编号:
- 正向索引:从序列第一个元素开始,自左向右编号,起始值为
0,终止值为N-1。 - 负向索引:从序列最后一个元素开始,自右向左编号,起始值为
-1,首元素的负向索引为-N。
安全边界机制:与单元素索引访问
sequence[index] 超出范围时抛出 IndexError 不同,切片操作对越界索引具有天然的容错性。当 stop 超过序列长度时,Python会自动截断在序列末尾而不会报错。
三、列表切片实战与典型操作
列表(List)是可变序列,切片不仅支持数据读取,还支持对特定区间的批量替换与修改。
1. 常用提取操作示例
# 准备示例列表
languages = ["Python", "JavaScript", "Rust", "Go", "C++", "Java"]

# 提取前3个元素 (索引 0, 1, 2)
front_three = languages[:3]
# 示例输出: ['Python', 'JavaScript', 'Rust']

# 提取末尾2个元素
last_two = languages[-2:]
# 示例输出: ['C++', 'Java']

# 截取中间片段:从索引 1 到 4 (不含4)
middle_part = languages[1:4]
# 示例输出: ['JavaScript', 'Rust', 'Go']

# 复制整个列表(浅拷贝)
list_copy = languages[:]
# 示例输出: ['Python', 'JavaScript', 'Rust', 'Go', 'C++', 'Java']
2. 列表切片的原地赋值与替换
由于列表可变,将可迭代对象赋值给切片区间可以实现批量替换、插入或删除:
nums = [10, 20, 30, 40, 50]

# 替换中间连续区间 nums[1:3] (即 20, 30)
nums[1:3] = [200, 300]
# 结果: [10, 200, 300, 400, 500]

# 通过切片在特定位置插入多个元素
nums[2:2] = [250]
# 结果: [10, 200, 250, 300, 400, 500]

# 将切片设置为空列表以批量删除
nums[1:4] = []
# 结果: [10, 400, 500]
四、字符串切片与步长采样
字符串(str)是不可变序列,因此字符串切片始终返回一个全新字符串,绝不影响原始变量。步长参数 step 在字符串截取与格式处理中发挥着核心作用。
1. 字符串截取常规应用
filename = "report_2026_q1.pdf"

# 提取扩展名(最后4个字符)
ext = filename[-4:]
# 示例输出: '.pdf'

# 提取文件基础名(除后4位外的前半部分)
base_name = filename[:-4]
# 示例输出: 'report_2026_q1'

# 提取年份部分
year = filename[7:11]
# 示例输出: '2026'
2. 步长控制与逆序截取技巧
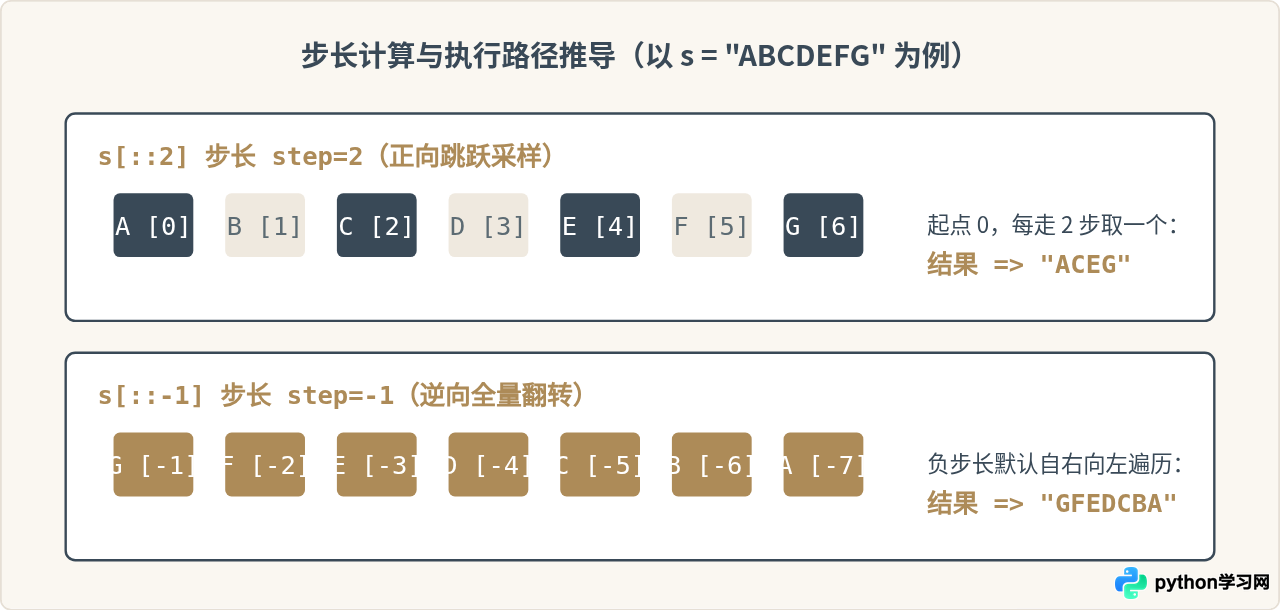
text = "ABCDEFGH"

# 偶数位字符截取 (索引 0, 2, 4, 6)
even_chars = text[::2]
# 示例输出: 'ACEG'

# 奇数位字符截取 (从索引 1 开始,步长 2)
odd_chars = text[1::2]
# 示例输出: 'BDFH'

# 序列字符串整行反转
reversed_text = text[::-1]
# 示例输出: 'HGFEDCBA'

# 带明确起止位置的倒序截取 (从索引 5 到 1,不含1)
reverse_segment = text[5:1:-1]
# 示例输出: 'FEDC'
五、切片常见盲点与避坑准则
初学者在使用切片时,常因为参数方向冲突或区间理解偏差导致提取出空序列或非预期结果。以下是必须关注的三个典型问题:
方向冲突引发的空序列:当
step > 0 时,start 必须位于 stop 的左侧;若指定了 start >= stop(例如 [5:2]),Python无法正向遍历到达终点,将直接返回空序列 [] 或 "",而不会逆向处理。同理,若 step < 0,start 必须位于 stop 右侧(例如 [5:2:-1] 正确,而 [2:5:-1] 为空)。
六、综合总结与实践要点
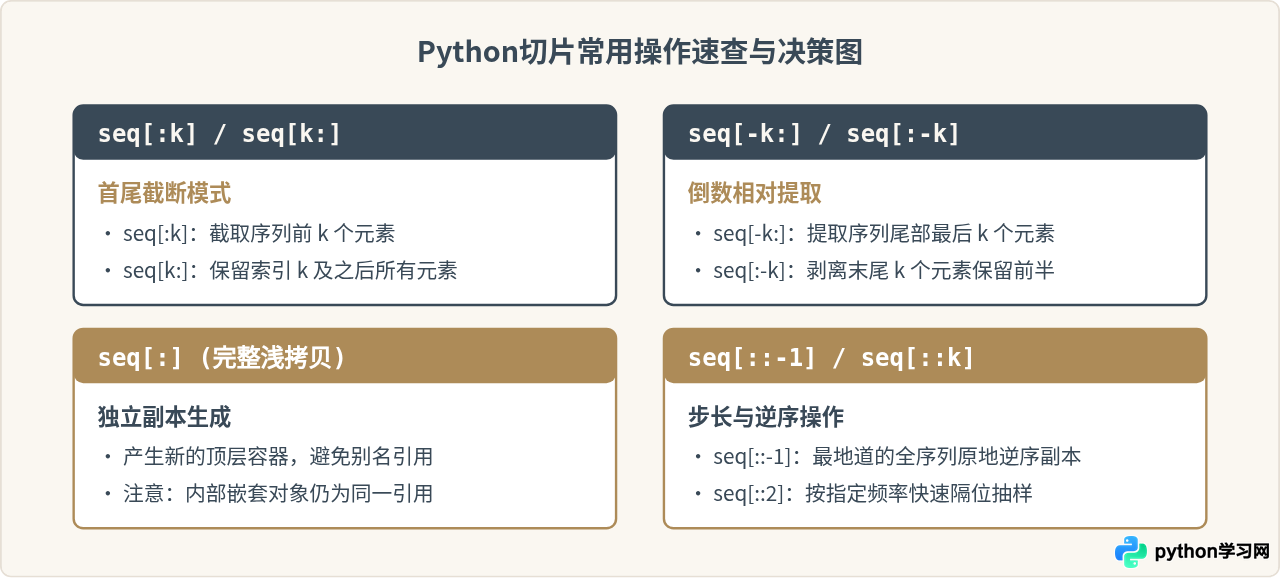
| 操作模式 | 语法形式 | 核心作用 | 边界特性 |
|---|---|---|---|
| 基础区间 | seq[start:stop] |
提取指定左闭右开区间 | 包含 start,排除 stop;越界自动截断 |
| 前缀截取 | seq[:n] |
提取前 n 个元素 | 若 n <= 0 则返回空序列 |
| 后缀截取 | seq[-n:] |
截取尾部 n 个元素 | 常用于提取文件扩展名、最后几项记录 |
| 跳跃采样 | seq[::step] |
按步长间隔取值 | step 为负数时自动转向自右往左提取 |
| 全量逆序 | seq[::-1] |
快速翻转序列 | 返回反转后的全新副本,原序列保持不变 |
通过灵活结合 [start:stop:step] 以及正负索引,Python切片能够以极高的数据处理效率和紧凑的代码表达力完成大多数日常截取任务。在编写切片逻辑时,牢记前闭后开和步长正负与检索方向一致这两条基本原则,即可避免绝大多数因边界误判产生的数据截取偏差。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















