


Python列表底层实现原理:动态数组机制与内存分配策略

假设你正在编写一个数据采集程序,随着网络请求不断返回,你使用 data = [] 创建了一个空列表,并在循环中连续调用 data.append(item) 写入几十万条记录。在整个过程中,你既没有预先声明列表的长度,也没有遇到内存溢出的错误,甚至感受不到写入性能的剧烈波动。许多初学者因此将 Python 列表视作无所不能的“黑盒”,甚至误以为它是通过前后指针串联的双向链表。事实上,Python 列表在底层是基于连续内存块构建的动态数组(Dynamic Array)。本文将基于官方 CPython 解释器实现,直接解剖列表在 C 语言层面的结构体定义、连续指针数组的物理排布,以及每次扩容与缩容时的内存分配策略,帮助你真正看清列表在内存中的运转机制。
一、PyListObject:动态数组的内存组织模型
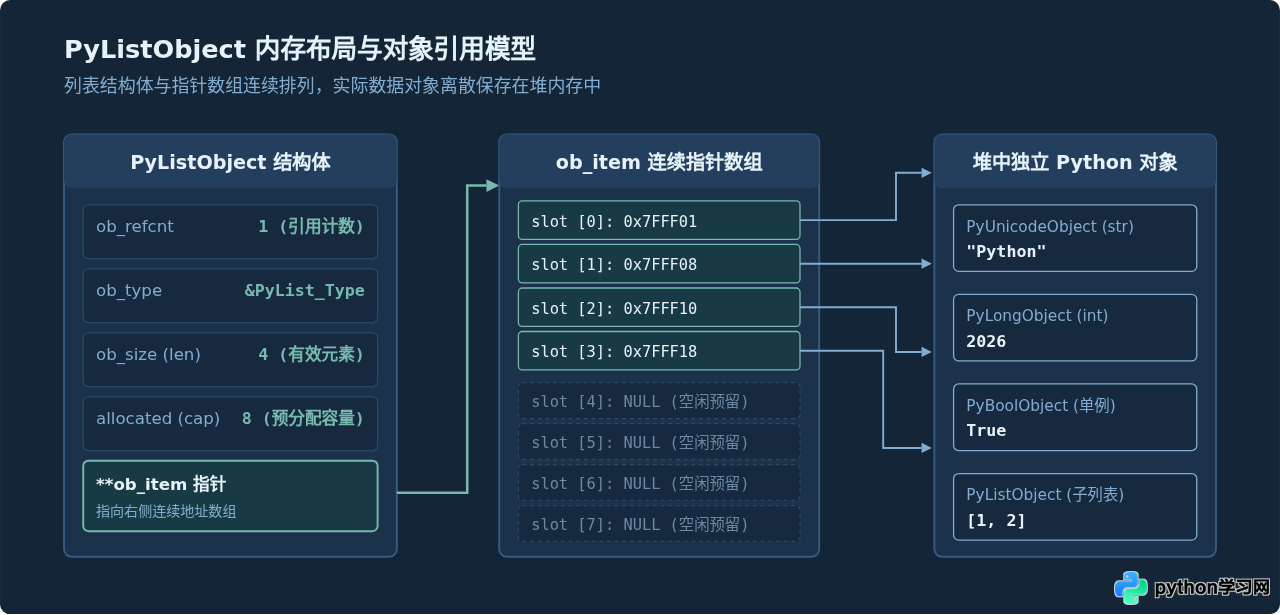
在 CPython 源码(Include/cpython/listobject.h)中,Python 列表对应的数据类型为 PyListObject。与很多人直觉中“链表节点各自分散在内存各处”不同,Python 列表的核心是一段连续的内存地址,专门用来存放对象的引用指针。
其简化的 C 语言结构体定义如下:
typedef struct {
    PyObject_VAR_HEAD
    PyObject **ob_item;      /* 指向指针数组首地址的二级指针 */
    Py_ssize_t allocated;    /* 当前实际已分配的底层内存槽位数 */
} PyListObject;
这个结构体包含了四个关键组成部分:
- ob_refcnt(引用计数):由变长对象头
PyObject_VAR_HEAD展开得到,记录当前列表对象自身被引用的次数,供垃圾回收机制使用。 - ob_type(类型指针):指向
&PyList_Type,表明这是一个列表对象。 - ob_size(逻辑长度):记录列表当前容纳的有效元素个数,即我们在 Python 中调用
len(lst)返回的数值。 - ob_item(连续指针数组):这是一个二级指针,指向一块连续分配的指针数组空间。数组中的每个元素都是一个指针(
PyObject*),分别指向存储在 Python 堆内存中的实际对象实例。 - allocated(物理容量):记录当前
ob_item数组在操作系统堆上实际申请的槽位总数。allocated的值始终大于或等于ob_size。
这种设计的核心精髓在于:列表本身只负责管理指针数组,而不直接内嵌存放具体数据。无论你在列表中放入的是一个 28 字节的整数、一段几千字符的字符串,还是另一个复杂的自定义对象,ob_item 数组中每个槽位所占的物理空间都是固定的 8 字节(在 64 位操作系统环境下)。因此,列表索引操作 lst[i] 的底层寻址公式极其简单:
target_item_address = ob_item + (i * sizeof(PyObject*));CPU 仅需一次基址偏移加法,就能在常数时间 $O(1)$ 内直接定位到目标对象的内存地址,这也是 Python 列表能够支持高效随机访问的物理基础。
二、过度分配机制:list_resize 核心扩容算法
既然 ob_item 是一块连续的内存数组,那当我们源源不断向列表追加元素时,如果初始申请的内存空间耗尽了,Python 是如何处理的?
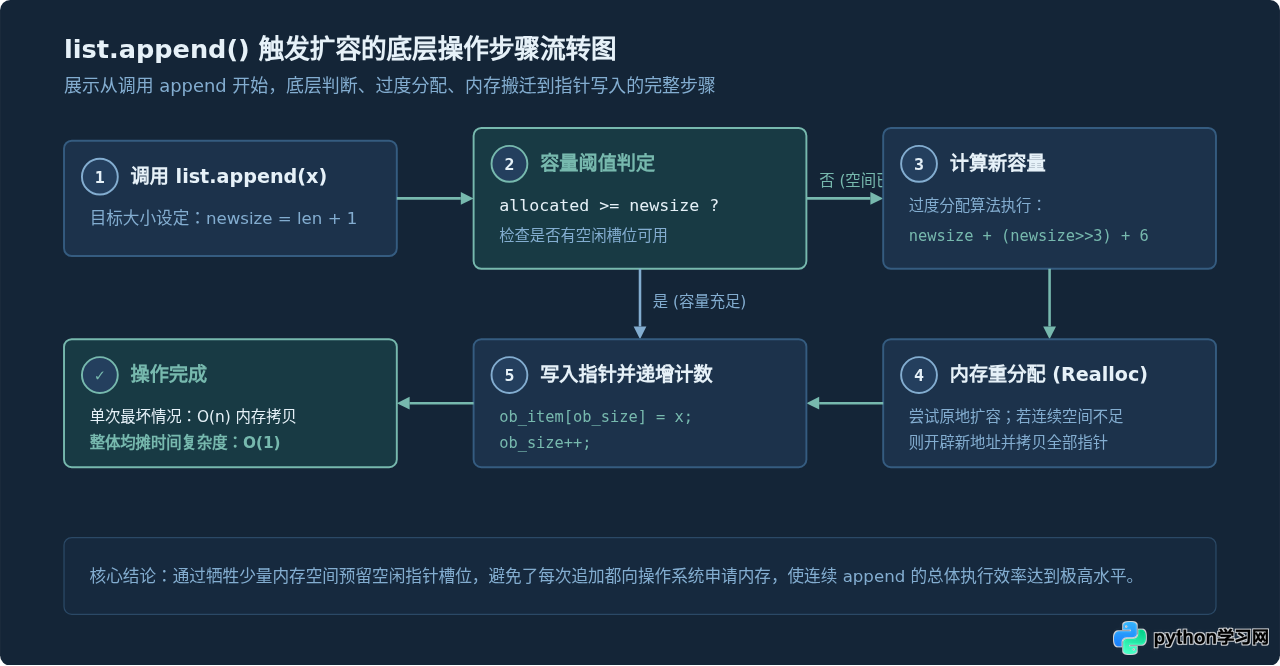
如果每次追加元素都向操作系统重新申请一个额外位置,那么每次追加都需要触发一次内存分配与数据拷贝,这将直接导致追加操作的时间复杂度退化为 $O(n)$。为了解决这个问题,CPython 采取了过度分配(Over-allocation)策略:在空间耗尽触发扩容时,预先分配比当前需求更多的内存槽位。
负责这一核心逻辑的底层函数是 Objects/listobject.c 中的 list_resize()。其核心计算公式在 CPython 源码中如下:
/* CPython list_resize 扩容槽位算法 (Objects/listobject.c) */
static int
list_resize(PyListObject *self, Py_ssize_t newsize)
{
    PyObject **items;
    size_t new_allocated, num_allocated_bytes;
    Py_ssize_t allocated = self->allocated;

    /* 如果当前有效需求 newsize 仍处于已分配容量的合理区间内,无需重新申请内存 */
    if (allocated >= newsize && newsize >= (allocated >> 1)) {
        assert(self->ob_item != NULL || newsize == 0);
        Py_SET_SIZE(self, newsize);
        return 0;
    }

    /* 过度分配核心递推公式 */
    new_allocated = ((size_t)newsize + (newsize >> 3) + (newsize < 9 ? 3 : 6)) & ~(size_t)3;

    if (newsize == 0)
        new_allocated = 0;

    num_allocated_bytes = new_allocated * sizeof(PyObject *);
    items = (PyObject **)PyMem_Realloc(self->ob_item, num_allocated_bytes);
    if (items == NULL) {
        PyErr_NoMemory();
        return -1;
    }
    self->ob_item = items;
    Py_SET_SIZE(self, newsize);
    self->allocated = new_allocated;
    return 0;
}
细致分析这条位运算公式:
new_allocated = ((size_t)newsize + (newsize >> 3) + (newsize < 9 ? 3 : 6)) & ~(size_t)3;
newsize >> 3:相当于将需求大小除以 8(增加约 12.5% 的额外冗余空间)。这意味着当列表越大时,单次扩容预留的绝对空间越多,从而降低扩容触发频率。newsize < 9 ? 3 : 6:这是一个小规模修正项。当列表规模极小(小于 9)时,直接额外赠送 3 个槽位;规模稍大时赠送 6 个槽位。这是为了避免小列表因为基数太小而频繁扩容。& ~(size_t)3:将计算结果向下对齐为 4 的整数倍(因为末两位被清零)。在多数系统架构下,4 的倍数能更好地契合内存分配器(如 mimalloc 或 pymalloc)的对齐边界,减少内存碎片。
三、扩容阶梯与内存占用实测验证
为了直观观察这个分配策略的真实运转,我们可以通过 Python 标准库提供的 sys.getsizeof() 观察列表在连续追加元素时的物理内存增长。
sys.getsizeof(lst) 返回的是列表对象本身的字节数(即结构体本体加上 allocated * 8 字节的指针数组),不包含所引用的实际对象大小。在 64 位系统上,空列表 [] 的基础结构体占用 56 字节。
执行以下测试脚本:
import sys

lst = []
print(f"初始状态: len={len(lst)}, 占用字节={sys.getsizeof(lst)}")

prev_size = sys.getsizeof(lst)
for i in range(1, 30):
    lst.append(i)
    curr_size = sys.getsizeof(lst)
    if curr_size != prev_size:
        # 字节增加表明底层触发了内存重分配
        allocated_slots = (curr_size - 56) // 8
        print(f"触发扩容 -> 当前 len={len(lst)}, 物理容量 allocated={allocated_slots}, 占用字节={curr_size}")
        prev_size = curr_size
在 Python 3.10+ / 64位环境下的典型输出结果如下:
初始状态: len=0, 占用字节=56
触发扩容 -> 当前 len=1, 物理容量 allocated=4, 占用字节=88
触发扩容 -> 当前 len=5, 物理容量 allocated=8, 占用字节=120
触发扩容 -> 当前 len=9, 物理容量 allocated=16, 占用字节=184
触发扩容 -> 当前 len=17, 物理容量 allocated=25, 占用字节=256
触发扩容 -> 当前 len=26, 物理容量 allocated=35, 占用字节=336
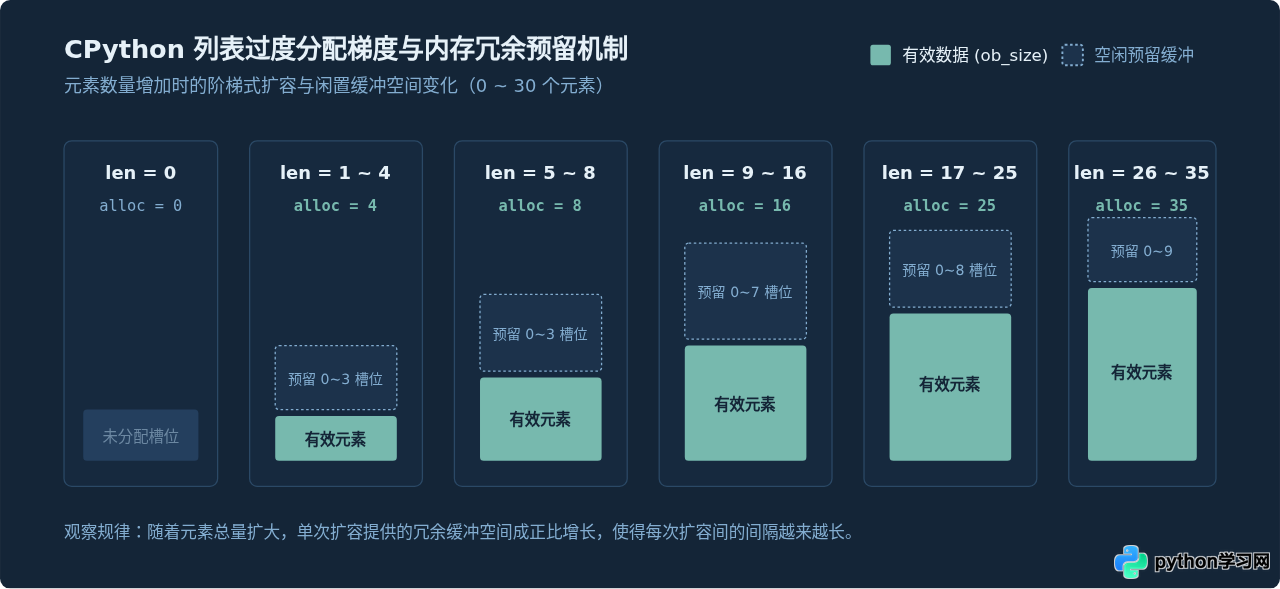
根据公式计算与实际输出,我们可以归纳出 CPython 列表在初期的容量跃迁序列:
| 元素数量 (len) | 物理分配容量 (allocated) | 空闲预留槽位数 | 触发扩容动作 |
|---|---|---|---|
| 0 | 0 | 0 | 初始空列表,未分配指针数组 |
| 1 ~ 4 | 4 | 3 ~ 0 | 加入第 1 个元素时一次性申请 4 个槽位 |
| 5 ~ 8 | 8 | 3 ~ 0 | 加入第 5 个元素时扩容至 8 个槽位 |
| 9 ~ 16 | 16 | 7 ~ 0 | 加入第 9 个元素时扩容至 16 个槽位 |
| 17 ~ 25 | 25 | 8 ~ 0 | 加入第 17 个元素时扩容至 25 个槽位 |
| 26 ~ 35 | 35 | 9 ~ 0 | 加入第 26 个元素时扩容至 35 个槽位 |
四、内存缩容机制:滞后缓冲与空间释放
既然列表会在元素增加时自动扩容,那么当大量调用 pop() 或 del 移除元素时,它会立刻归还物理内存吗?
回顾前文 list_resize() 中的判断条件:
if (allocated >= newsize && newsize >= (allocated >> 1)) {
    Py_SET_SIZE(self, newsize);
    return 0;
}这个判断揭示了一个关键策略:缩容具有明显的滞后性(Hysteresis Buffer)。
只有当列表有效元素数量 newsize 跌破当前分配容量的一半(即 newsize < allocated / 2)时,才会真正触发 PyMem_Realloc 进行内存收缩。如果元素数量仅仅小幅度减少,CPython 只是简单地将 ob_size 计数器减小,被移出的槽位标记为不可见,而底层的连续物理内存块完全保留。
这种滞后设计极其精妙:如果只要减少一个元素就立即缩容,那么当程序在容量临界点反复交替执行 append() 和 pop() 时,就会陷入“每次 append 扩容申请、每次 pop 缩容释放”的性能灾难(Thrashing 颠簸)。通过引入 50% 的容量缓冲带,有效保障了删除操作的平均性能。
调用
lst.clear() 或 del lst[:] 会直接触发 list_resize(self, 0),此时 new_allocated 计算为 0,Python 会立即通过 PyMem_Realloc 彻底释放底层指针数组,将内存归还给解释器的内部内存池。
五、常见操作的底层时间复杂度与性能陷阱
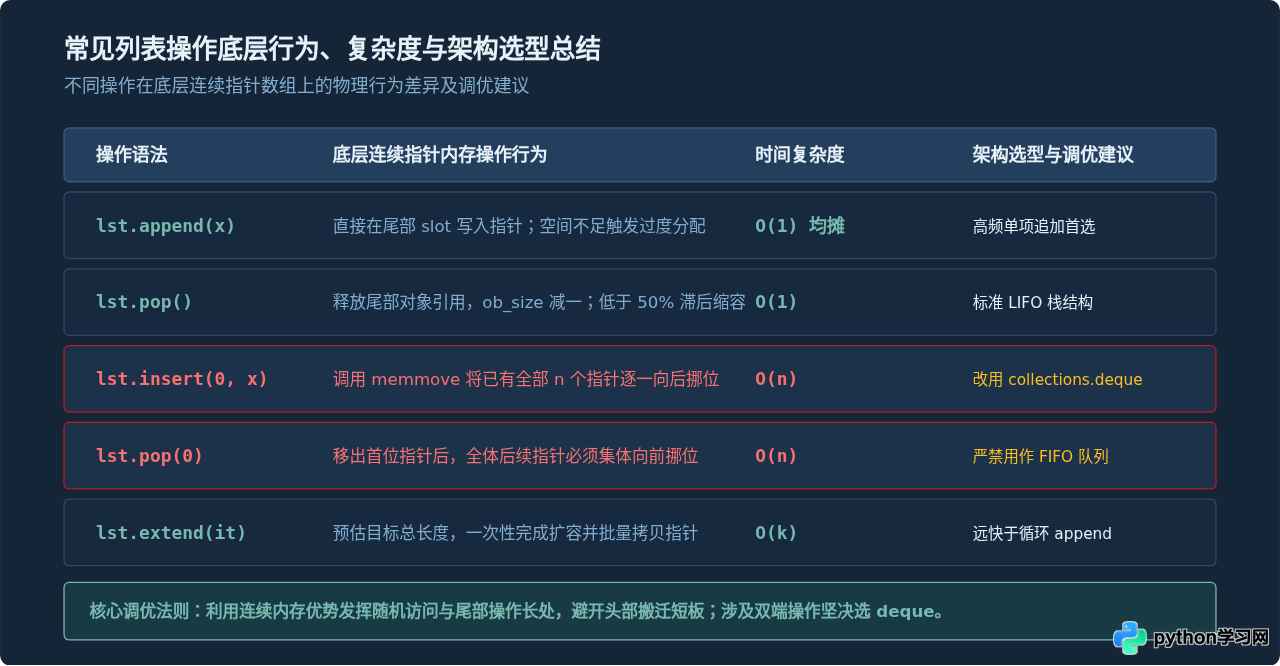
深入理解了连续指针数组与扩容机制后,我们就能清晰解释为什么不同的列表操作在性能上有着天壤之别:
1. 尾部追加与弹出:append() / pop()
在尾部操作时,由于直接通过 ob_item[ob_size] 存取指针,既不需要移动任何已存在的其他元素,也不会改变现有元素的内存偏移。只要容量充足,耗时就是纳秒级的常数时间;即便偶发扩容,其数学均摊时间复杂度依然是稳定的 $O(1)$。
2. 头部插入与弹出:insert(0, x) / pop(0)
这是 Python 开发者最容易踩中的性能深坑。当你在索引 0 处插入一个新指针时,为了腾出第一格位置,底层的 list_insert() 必须调用系统的 memmove() 函数,将整个数组中的 $n$ 个指针整齐向后搬移一个槽位。同理,pop(0) 也必须将后面的 $n-1$ 个指针全部向前平移一位。这意味着每次头部操作的时间复杂度都是严格的 $O(n)$。若在一个 10 万长度的列表上循环执行 pop(0),累计移动指针的次数将高达 50 亿次,程序会直接卡死。
3. 切片操作:lst[start:end]
切片并不是在原列表上建立视图,而是创建了一个全新的 PyListObject 实例,并开辟一段新的指针数组,将指定范围内的指针逐一复制过去。切片执行速度快(因为由底层高效的内存批量拷贝完成),但由于是指针拷贝,它属于浅拷贝(Shallow Copy),新旧列表共享底层的实际 Python 数据对象。
六、高性能开发实践建议
结合 CPython 的动态数组机制,在编写涉及大量数据的 Python 代码时,遵循以下工程建议能够显著提升程序性能:
-
队列场景严格使用
collections.deque
如果你的业务逻辑中存在频繁的“先进先出(FIFO)”操作(例如任务队列、广度优先搜索),千万不要使用普通列表并调用pop(0)。请直接引入标准库中的collections.deque。双端队列基于固定大小的双向块链表(Block-linked List)构建,其头部插入与删除的时间复杂度为真正的 $O(1)$。 -
批量合并优先使用
extend()
当需要将一个序列的所有数据追加到当前列表时,避免使用for item in new_data: lst.append(item)。使用lst.extend(new_data)可以使解释器在 C 语言层面提前根据迭代器长度完成一次性扩容,避免多次中间状态的扩容与函数调用开销。 -
优先使用列表推导式(List Comprehension)
相较于先定义res = []再通过for循环调用append,列表推导式由底层专门的LIST_APPEND字节码优化执行,省去了每次循环中的属性查找与方法包装开销,执行速度通常有 20%~30% 的明显提升。 -
海量同构数值数据转向专门容器
每个存放进列表的整数除了占用 8 字节的指针,在堆上本身还要消耗 28 字节的PyLongObject。如果要存储数百万个浮点数或整数,普通列表会产生极大的内存开销和缓存不命中。此时应优先使用标准库的array.array或第三方的numpy.ndarray,它们将原始二进制数值紧凑存放在单一连续内存中,内存利用率和 CPU 向量化计算性能成倍提升。
结语
Python 列表并非黑盒,它的本质就是 C 语言中管理对象引用的连续动态数组。通过 PyListObject 的连续指针布局,Python 实现了高效的常数级随机查找;通过 list_resize 的过度分配与滞后缩容算法,Python 成功将动态追加的代价平摊为极小的常数开销。搞清内存搬迁与容量阶梯的物理逻辑,能帮助我们在编写代码时自觉避开 $O(n)$ 的平移陷阱,让 Python 程序在高并发与海量数据处理中依然保持从容高效。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















