


怎么在Python项目中本地部署并调用轻量级LLM

在 Python 项目中本地部署并调用轻量级大语言模型(参数规模通常在 0.5B 至 3B 之间),核心在于选择结构轻量、开销可控的量化模型与高效的本地推理后端。目前工程实践中最成熟且零外部服务依赖的方案,是采用 GGUF 格式模型搭配 llama-cpp-python 库实现进程内原生推理。本文以兼顾中文理解力与紧凑体积的 Qwen2.5-1.5B-Instruct(4-bit 量化版)为例,详细讲解环境准备、模型下载、Python 同步与流式调用、参数配置及常见运行排障的具体操作。
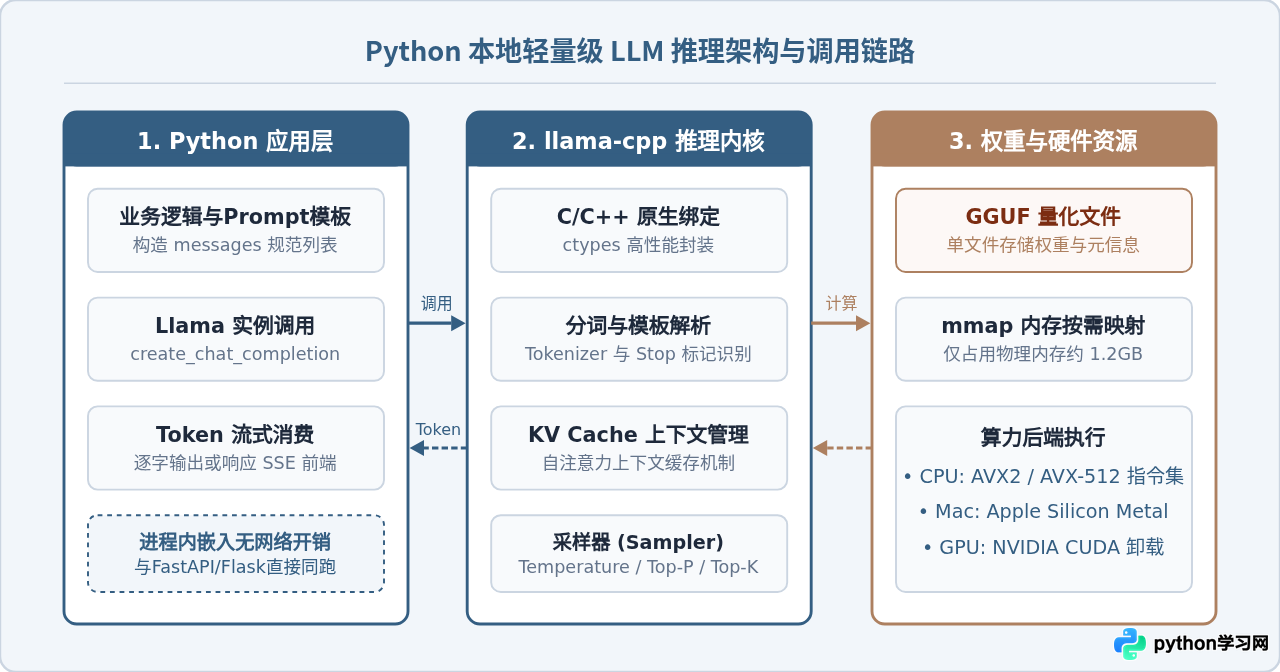
一、技术选型:模型规格与部署架构对比
在 Python 体系中集成大语言模型,主要有“进程内嵌入式推理”与“本地独立服务调用”两种技术路线。在确定方案前,需要根据业务的并发要求、机器规格以及工程集成复杂度作出权衡。
1. 轻量级模型规格的确定
对于单台日常开发机、个人服务器或小型边缘设备,参数量在 0.5B 至 3B 之间的模型是性价比最高的选择:
- 0.5B ~ 1.5B 参数(如 Qwen2.5-1.5B):4-bit 量化后权重体积仅 1.0GB ~ 1.2GB,全 CPU 推理生成速度通常可达每秒 20~40 Token,能够胜任文本分类、意图提取、简短问答和结构化 JSON 生成任务。
- 3B 参数(如 Qwen2.5-3B、Llama-3.2-3B):量化后占用内存约 2.2GB ~ 2.6GB,推理逻辑更强,适合需要多步推理、摘要提炼或代码短句补全的场景。
2. 为什么选择 GGUF 格式?
传统的 Hugging Face Safetensors 格式通常需要依赖完整的 PyTorch 或 HuggingFace Transformers 框架,启动时需加载多套大型依赖,初始化内存动辄 4GB~8GB。而 GGUF(GPT-Generated Unified Format) 是为本地量化推理专门设计的单文件二进制封装格式,将模型权重、词表(Tokenizer)、超参数和元数据统一打包在单个 .gguf 文件中,结合操作系统 mmap 机制,能够以极低内存极速载入。
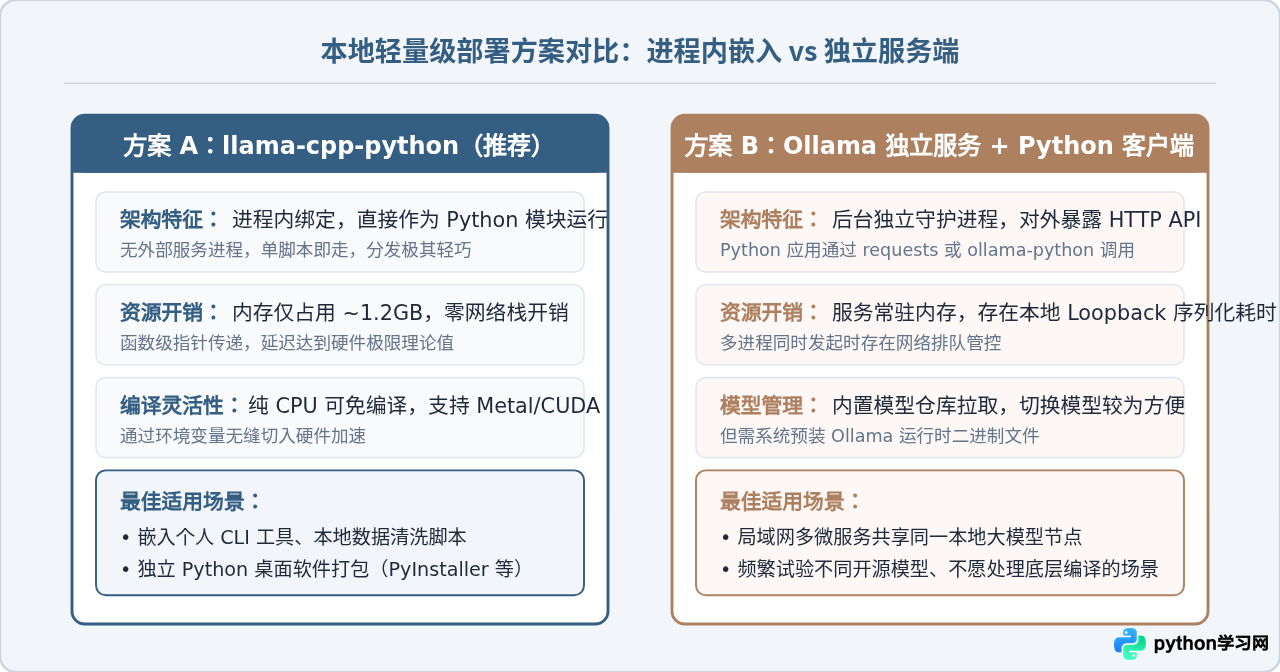
二、环境准备与依赖安装
为了保证项目的纯净性,建议在独立的虚拟环境中进行依赖安装与配置。
1. 创建虚拟环境
# 创建工作目录并进入
mkdir local_llm_demo && cd local_llm_demo

# 创建 Python 3.10+ 虚拟环境
python3 -m venv venv

# 激活虚拟环境 (macOS/Linux)
source venv/bin/activate

# 激活虚拟环境 (Windows PowerShell)
# .\venv\Scripts\Activate.ps1
2. 安装 llama-cpp-python
llama-cpp-python 是当前连接 Python 与底层 llama.cpp C++ 推理库最稳固的桥梁。你可以根据当前机器的硬件架构选择对应的安装方式:
方式 A:纯 CPU 推理(通用最简安装,无需额外编译环境)
pip install llama-cpp-python方式 B:Apple Silicon (M1/M2/M3/M4) 开启 Metal 硬件加速
CMAKE_ARGS="-DGGML_METAL=on" pip install llama-cpp-python --force-reinstall --no-cache-dir方式 C:NVIDIA GPU 开启 CUDA 硬件加速 (Linux / Windows)
CMAKE_ARGS="-DGGML_CUDA=on" pip install llama-cpp-python --force-reinstall --no-cache-dir注意:如果不需要极高吞吐,纯 CPU 模式在现代多核 CPU(支持 AVX2 指令集)上运行 1.5B 规模的模型已具备极佳的响应流畅度,初学者可先从方式 A 着手验证链路。
3. 获取 GGUF 模型文件
推荐选用阿里云开源的 Qwen2.5-1.5B-Instruct-GGUF。其中 Q4_K_M 量化等级兼顾了精度与体积(约 1.1GB)。可以通过官方提供的 huggingface_hub 工具或 modelscope 快速下载至项目 models/ 目录下:
# 安装快速下载客户端
pip install huggingface_hub

# 创建模型存放目录
mkdir -p models

# 下载指定的 GGUF 单文件
huggingface-cli download Qwen/Qwen2.5-1.5B-Instruct-GGUF \
  qwen2.5-1.5b-instruct-q4_k_m.gguf \
  --local-dir ./models \
  --local-dir-use-symlinks False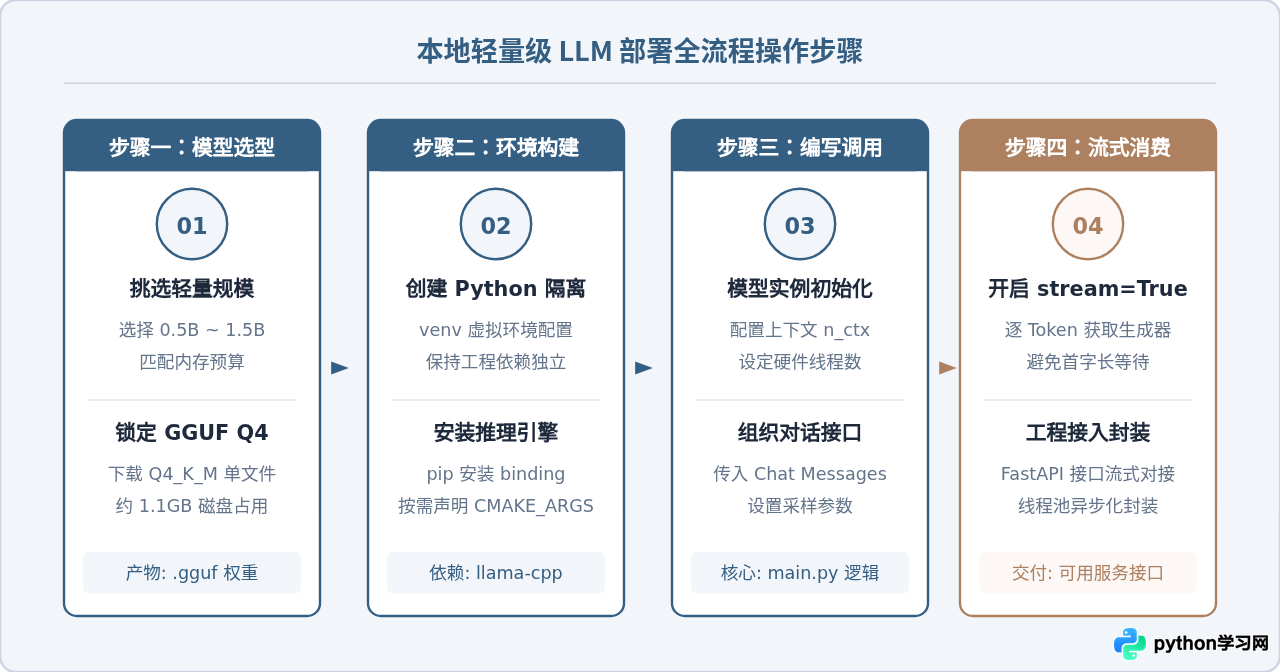
三、核心实战:Python 调用代码编写
在项目中调用本地模型时,通常建议使用高阶的 create_chat_completion 接口,该接口不仅与 OpenAI 格式对齐,还会自动帮我们处理不同模型特有的分词与 Chat Template(如 <|im_start|>、<|im_end|> 等控制字符)。
1. 一次性返回的基础调用示例
创建 simple_chat.py 文件,写入如下代码:
from llama_cpp import Llama

# 1. 初始化模型实例
# model_path: 本地 GGUF 文件绝对路径或相对路径
# n_ctx: 上下文窗口大小 (tokens),根据需要设置,越大消耗内存越多
# n_threads: CPU 计算线程数,推荐设为当前机器物理核心数
# n_gpu_layers: 卸载到 GPU 的层数,纯 CPU 模式填 0,全部卸载填 -1
llm = Llama(
    model_path="./models/qwen2.5-1.5b-instruct-q4_k_m.gguf",
    n_ctx=2048,
    n_threads=6,
    n_gpu_layers=0,
    verbose=False
)

# 2. 构造符合标准格式的消息列表
messages = [
    {"role": "system", "content": "你是一个严谨且实用的助手,回答简明扼要。"},
    {"role": "user", "content": "请用Python写一个读取JSON文件并统计键数量的函数。"}
]

# 3. 发起调用
response = llm.create_chat_completion(
    messages=messages,
    temperature=0.7,
    max_tokens=512
)

# 4. 解析结果
result_text = response["choices"][0]["message"]["content"]
print("模型输出内容:\n", result_text)
2. 流式输出(Streaming)调用实现
大语言模型生成完整段落需要数秒时间。在前端交互或 CLI 终端中,流式逐字输出能显著提升体验。将 stream=True 传入接口即可获取生成器:
from llama_cpp import Llama
import sys

# 初始化模型
llm = Llama(
    model_path="./models/qwen2.5-1.5b-instruct-q4_k_m.gguf",
    n_ctx=2048,
    n_threads=6,
    n_gpu_layers=0,
    verbose=False
)

messages = [
    {"role": "system", "content": "你是一名资深工程师。"},
    {"role": "user", "content": "简要列出在生产环境中运行Python轻量级模型的三个重要注意事项。"}
]

print("回答开始:\n")

# 获取流式迭代器
stream = llm.create_chat_completion(
    messages=messages,
    temperature=0.6,
    max_tokens=600,
    stream=True
)

# 逐 Token 实时打印到终端
for chunk in stream:
    delta = chunk["choices"][0].get("delta", {})
    if "content" in delta:
        content = delta["content"]
        sys.stdout.write(content)
        sys.stdout.flush()

print("\n\n回答结束。")
3. 核心调用参数详细解析
| 参数名 | 典型推荐值 | 含义及调优指导 |
|---|---|---|
model_path |
路径字符串 | 指向 .gguf 格式模型的磁盘路径。 |
n_ctx |
2048 / 4096 | 上下文大小。切勿无故开到 32768,上下文越大预分配的 KV Cache 内存越大。 |
n_threads |
物理核心数 | CPU 并行计算工作线程。不要超过宿主机真实物理核心数,否则多线程竞争反而变慢。 |
n_gpu_layers |
0 或 -1 | 卸载至 GPU 的层数。显存不足时可设置部分层数(例如 10 层),实现 CPU+GPU 混合推理。 |
temperature |
0.2 ~ 0.7 | 采样温度。需要精确输出(代码、分类、提取)设为 0.2,发散性文本设为 0.7。 |
四、工程化集成与常见排错指南
在将轻量级 LLM 接入到实际工程(例如 FastAPI 接口或后台脚本)中时,常见的瓶颈往往不是模型本身,而是对运行时并发、内存以及模板标记的处理不当。
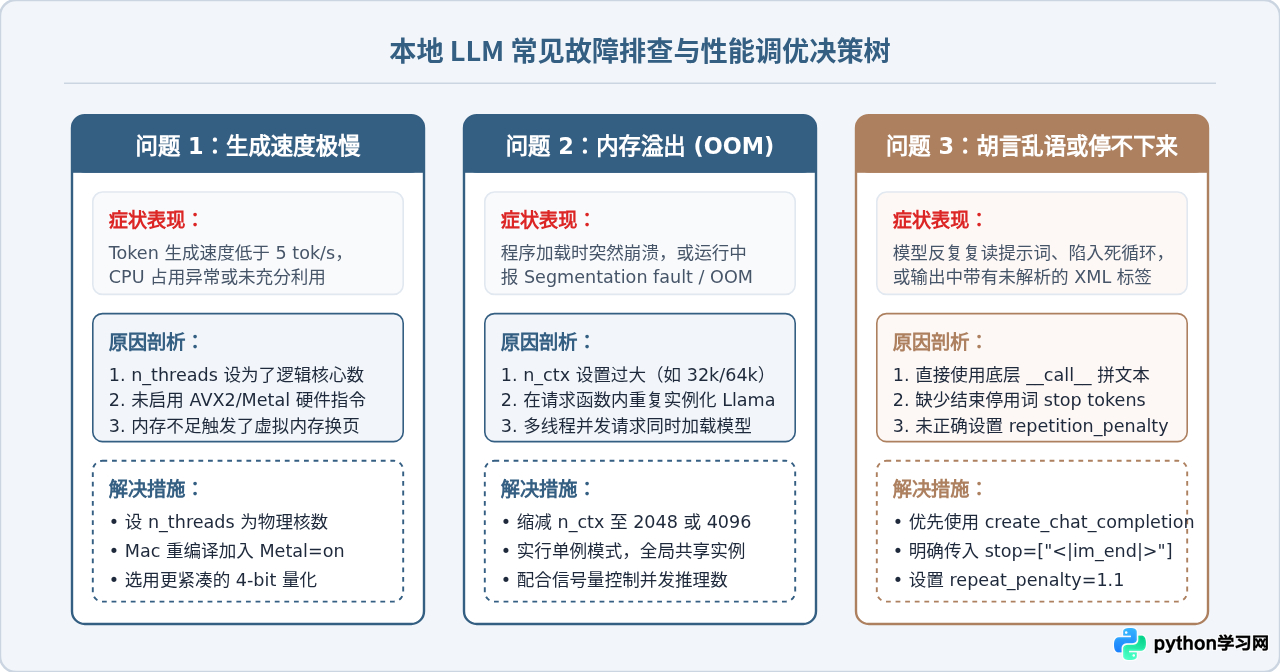
1. 在 Web 框架(FastAPI)中防范事件循环阻塞
由于 llama-cpp-python 是 CPU/GPU 密集型同步计算,如果在 FastAPI 的 async def 路由中直接执行推理,会导致整个事件循环被挂起,无法响应其它请求。正确做法是将其放入独立的线程池执行:
import asyncio
from fastapi import FastAPI
from pydantic import BaseModel
from llama_cpp import Llama

app = FastAPI()

# 全局单例加载模型,避免每个请求重复载入权重
llm_instance = Llama(
    model_path="./models/qwen2.5-1.5b-instruct-q4_k_m.gguf",
    n_ctx=2048,
    n_threads=4,
    verbose=False
)

class QueryRequest(BaseModel):
    prompt: str

def run_inference_sync(prompt: str) -> str:
    response = llm_instance.create_chat_completion(
        messages=[{"role": "user", "content": prompt}],
        max_tokens=256,
        temperature=0.3
    )
    return response["choices"][0]["message"]["content"]

@app.post("/api/chat")
async def chat_endpoint(request: QueryRequest):
    # 使用 asyncio.to_thread 转移到独立工作线程,避免阻塞主循环
    answer = await asyncio.to_thread(run_inference_sync, request.prompt)
    return {"reply": answer}
2. 验证完成与总结
通过本文的步骤,你在 Python 项目中仅依赖两个核心要素即可完成轻量级 LLM 的闭环运行:一是单个 .gguf 权重文件,二是轻量的 llama-cpp-python 原生绑定。整套流程不需要开启外部重量级服务端,不依赖外部网络连接,单机内存消耗可精准稳定在 1.2GB 上下。以此为基础,你可以进一步将本地模型扩展至结构化数据清洗、私有敏感文本脱敏、自动化本地报告生成等多样化工程场景中。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















