


Python怎么对含数字的字符串列表进行自然排序

在 Python 中对包含数字的字符串列表进行排序时,很多开发者会遇到 ['file1.txt', 'file10.txt', 'file2.txt'] 这种违背直觉的排序结果。解决这一问题的核心途径有两个:如果不想引入第三方依赖,可使用标准库 re 模块编写键函数(Key Function),将字符串切分为“文本与整型数值”的元组后再进行比较;如果在工程或生产环境中需要处理更复杂的文件名、版本号或浮点数,直接使用第三方库 natsort 是最简洁稳健的选择。本文将深入剖析两种实现方式的具体步骤、底层原理以及边界注意事项。
一、问题复现:为什么默认排序会出现“file10排在file2前面”
Python 内置的 sorted() 函数和列表的 sort() 方法默认采用“字典序”(Lexicographical Order,即根据字符的 Unicode / ASCII 编码逐位比较)。
我们可以观察以下简单的示例代码:
# 默认排序示例
files = ['file1.txt', 'file10.txt', 'file2.txt', 'file21.txt', 'file3.txt']
result = sorted(files)
print(result)
# 输出: ['file1.txt', 'file10.txt', 'file2.txt', 'file21.txt', 'file3.txt']
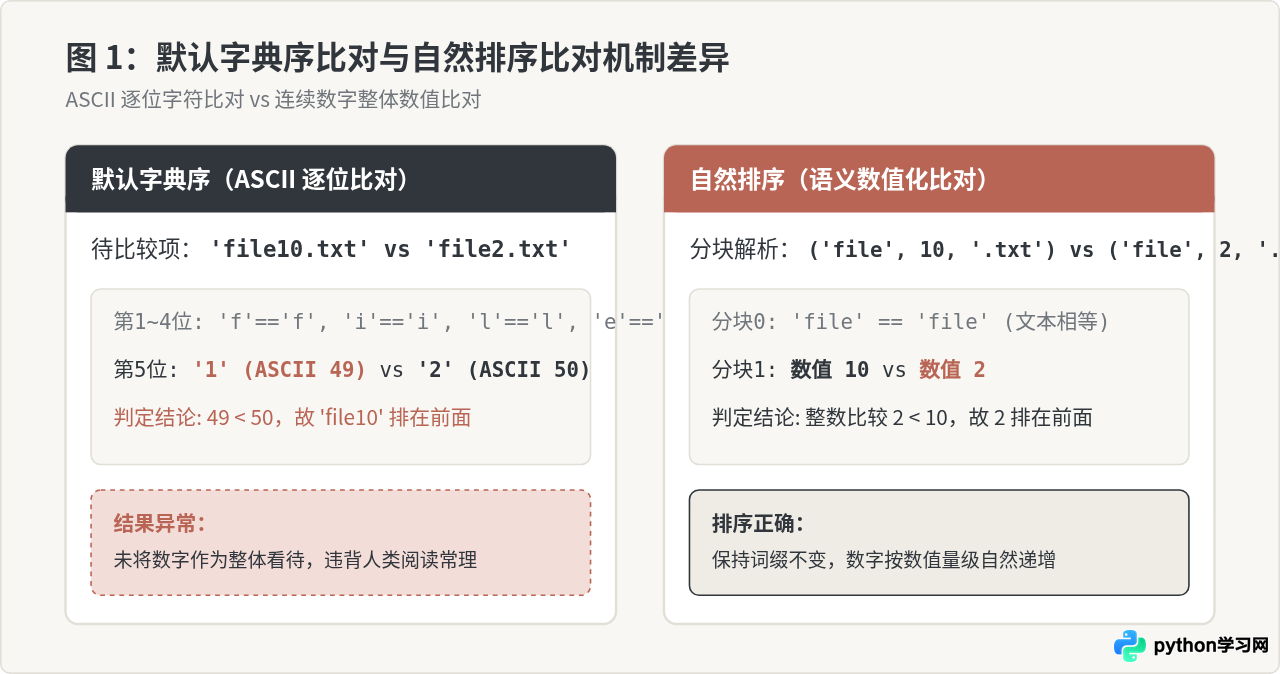
在逐字符比对过程中,当比较 'file10.txt' 与 'file2.txt' 时,前四个字符 'f', 'i', 'l', 'e' 完全一致。到达第五个字符时,字符 '1' 的 ASCII 码为 49,而字符 '2' 的 ASCII 码为 50。由于 49 < 50,Python 在当前位置判定 'file10.txt' 小于 'file2.txt',排序流程终止,导致数值更大的 10 排在了 2 的前面。
所谓“自然排序”(Natural Sort 或 Human Sort),是指在比较包含数字的字符串时,将连续的数字字符视作一个整体的数值量级(即把 10 作为整数十,而不是字符一加字符零),从而让 2 排在 10 之前。
二、核心原理:Key 函数与分块元组比对
Python 的 sorted(iterable, key=func) 允许传入一个自定义的 key 函数。在排序时,Python 会先将每个元素传入该函数生成对应的比较键,然后基于生成的键来决定最终排序。
实现自然排序的关键在于:构造一个将连续数字转换成整型数值的分块列表或元组。
Python 原生支持元组与列表之间的比较,规则如下:
- 先比较元组的第一项;如果第一项能分出大小,直接确定胜负。
- 如果第一项相等,继续比较第二项,以此类推。
- 在对应位置上,数字与数字按整型比较,文本与文本按字典序比较。
例如,比较 ['file', 2, '.txt'] 和 ['file', 10, '.txt']:第 0 项均为 'file';第 1 项为整数比较,由于 2 < 10,前一个列表自然排在前面。
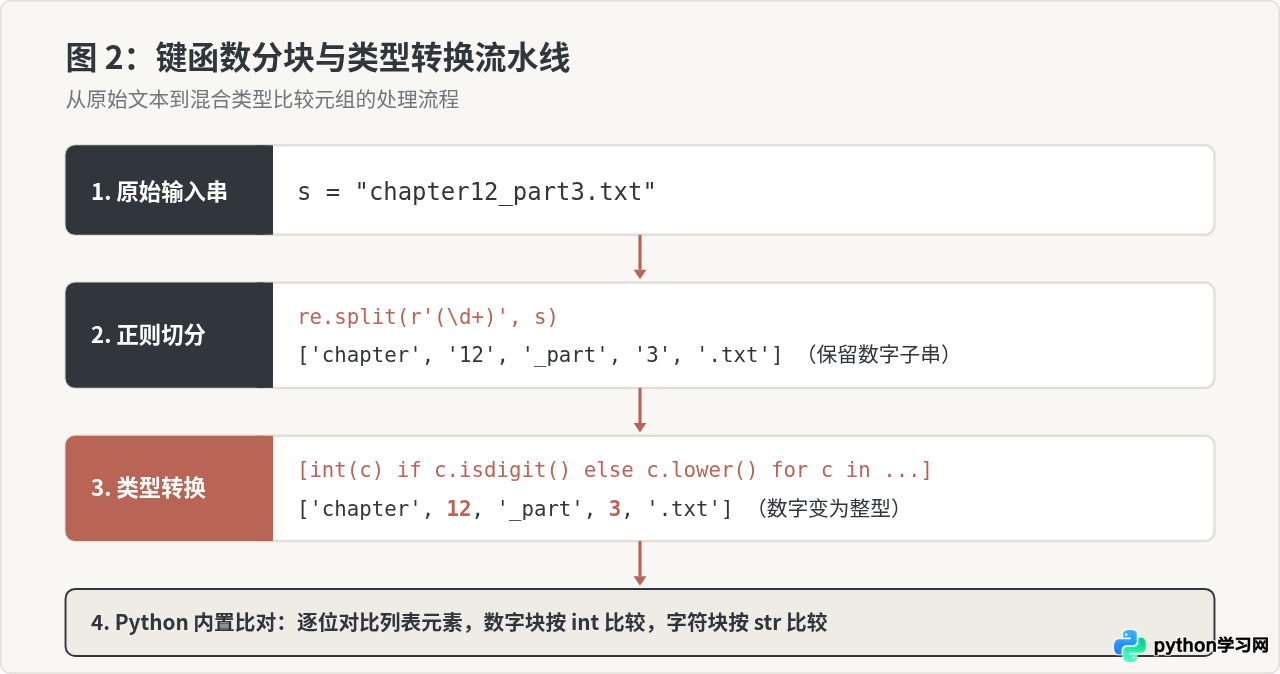
要将字符串切分为“文本块”和“数字块”,最有效的方法是标准库的 re.split() 函数。当正则表达式中使用带有捕获括号的模式 r'(\d+)' 时,匹配到的数字不仅作为分隔符,还会被完整保留在返回的列表中:
import re

text = 'chapter12_part3.txt'
chunks = re.split(r'(\d+)', text)
print(chunks)
# 输出: ['chapter', '12', '_part', '3', '.txt']
随后,只需遍历该列表,对纯数字字符串调用 int() 转换,非数字字符串保留原样,即可构建出符合自然排序比较要求的键。
三、方案一:使用标准库 re 模块(无外部依赖)
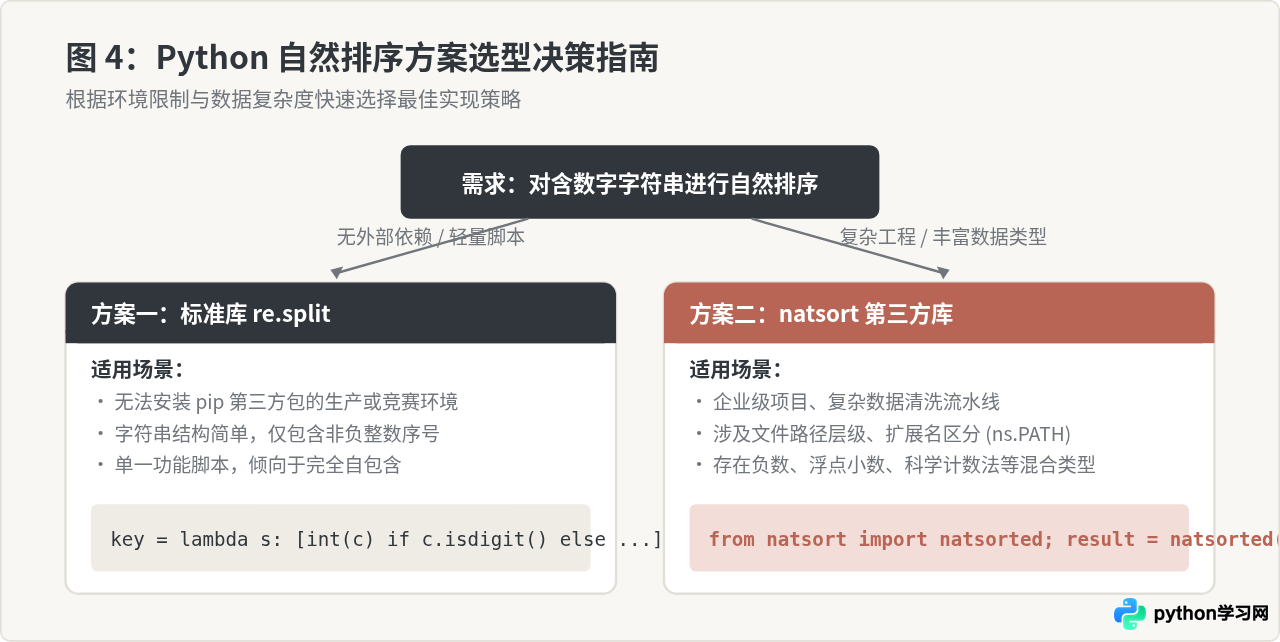
在绝大多数日常脚本或不方便安装第三方包的受限环境中,使用标准库 re 是最通用且高效的方案。
完整代码示例
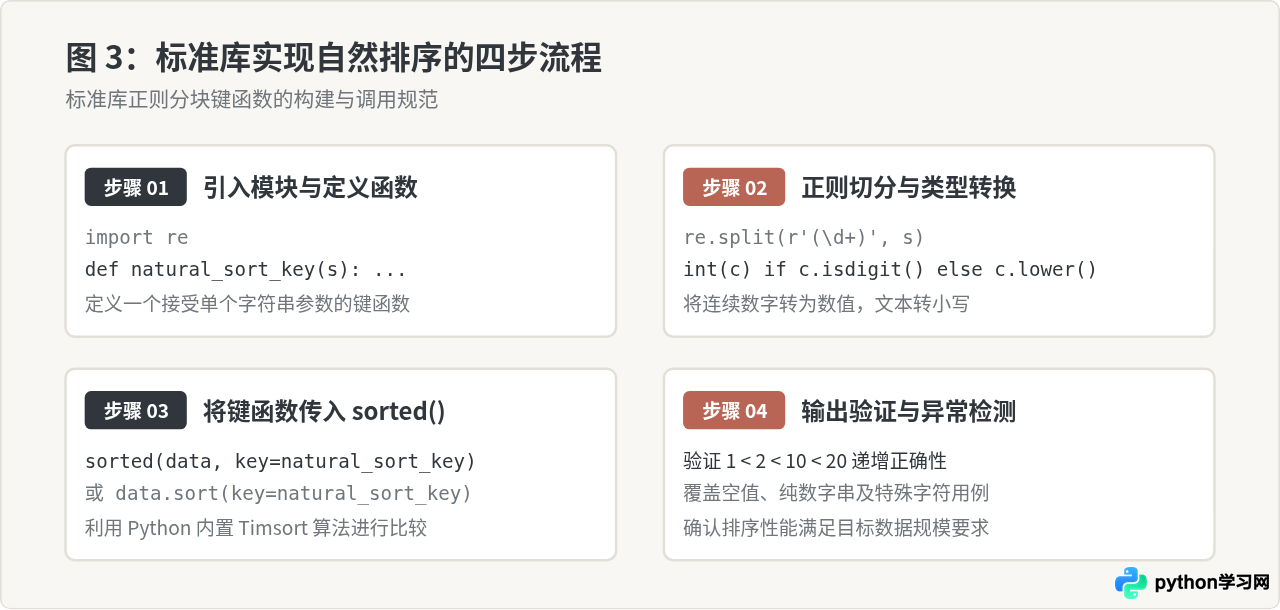
import re

def natural_sort_key(s):
    """
    将输入字符串拆分为文本与整型数值的列表,用于自然排序。
    """
    if not isinstance(s, str):
        s = str(s)
    # 使用正则表达式按连续数字切分,括号保证切出的数字也包含在结果列表中
    return [int(text) if text.isdigit() else text.lower() for text in re.split(r'(\d+)', s)]

# 测试用例
items = [
    'item10b.jpg',
    'item2a.jpg',
    'item1a.jpg',
    'item20.jpg',
    'item2b.jpg',
    'item10a.jpg',
    'item3.jpg'
]

# 执行自然排序
sorted_items = sorted(items, key=natural_sort_key)

print("排序前:", items)
print("排序后:", sorted_items)
运行输出结果
排序前: ['item10b.jpg', 'item2a.jpg', 'item1a.jpg', 'item20.jpg', 'item2b.jpg', 'item10a.jpg', 'item3.jpg']
排序后: ['item1a.jpg', 'item2a.jpg', 'item2b.jpg', 'item3.jpg', 'item10a.jpg', 'item10b.jpg', 'item20.jpg']
实现细节与边界说明
- 大小写敏感性:在上面的代码中,非数字部分使用了
text.lower()。如果不加.lower(),在 ASCII 码中大写字母(A~Z: 65~90)会排在小写字母(a~z: 97~122)之前。若希望保持严格大小写不敏感,统一转小写是标准做法。 - 原地排序支持:如果待排序的是一个已有列表,并且不需要保留原列表副本,可以直接调用
items.sort(key=natural_sort_key),节省内存开销。 - 空字符串与纯文本:如果列表项中没有数字,
re.split(r'(\d+)', s)会返回只包含原字符串的单元素列表[s.lower()],退化为普通字符串排序,行为安全可控。
四、方案二:使用第三方 natsort 库(工程化开箱即用)
在大型工程项目或需要处理丰富数据类型的场景下,自己用正则切分可能会遇到各种极端边界情况(如带负号、浮点小数、带扩展名的文件路径、语义版本号等)。此时推荐使用被广泛验证的第三方库 natsort。
安装方法
pip install natsort基础使用
natsort 提供了 natsorted() 函数,用法与 Python 内置的 sorted() 完全一致,无需手动编写任何键函数:
from natsort import natsorted

files = ['file10.txt', 'file2.txt', 'file1.txt', 'file20.txt']
result = natsorted(files)
print(result)
# 输出: ['file1.txt', 'file2.txt', 'file10.txt', 'file20.txt']
高级特性与实用参数
natsort 不仅能识别整数,还能处理非常复杂的工程需求:
- 文件路径感知(Path-aware 排序):处理如
folder/file10.txt这种路径时,普通自然排序可能会因为斜杠和扩展名干扰排序。传入alg=ns.PATH可以让系统优先比较目录层级和文件名主体,最后比较扩展名。 - 原生支持就地排序:提供
natsort_keygen()生成高效的键函数,可直接用于列表的.sort()方法:from natsort import natsort_keygen data = ['img12.png', 'img2.png'] data.sort(key=natsort_keygen()) print(data) # 输出: ['img2.png', 'img12.png'] - 浮点数与科学计数法:当列表中含有如
['model_1.5', 'model_1.10']时,默认按整数拆分可能会将1.10视作大于1.5(因为 10 > 5)。natsort提供了ns.FLOAT选项,可精准识别浮点数值。
v1.2.10 和 v1.2.2),它不是浮点数,而是由点分隔的多级整数。此时普通的自然排序或 re.split 会将 10 作为整数对比,因此 v1.2.2 必定排在 v1.2.10 前面,完全符合版本迭代逻辑。
五、技术选型与综合对比
两种方案在特性覆盖、依赖成本和开发效率上各有侧重,具体差异如下表所示:
| 对比维度 | 标准库 re 自定义方案 | 第三方 natsort 库方案 |
|---|---|---|
| 外部依赖 | 零依赖(Python 内置标准库) | 需执行 pip install natsort |
| 代码量 | 需手写 3~5 行键函数 | 单行直接调用 natsorted() |
| 基本整数自然排序 | 完全支持 | 完全支持 |
| 浮点数/科学计数法 | 需复杂正则适配 | 内置选项开箱即用 |
| 文件路径与扩展名 | 需额外拆分路径逻辑 | 支持 ns.PATH 算法参数 |
| 适用场景 | 独立小脚本、竞赛环境、轻量部署 | Web 系统、数据管道、大型自动化工具 |
总结
解决 Python 含数字字符串排序混乱的问题,本质上是纠正字典序将数字逐字符拆解的缺陷。对于轻量、无外部依赖的需求,基于 re.split(r'(\d+)', s) 将数字转换为整型的键函数完全足够且极其高效;而对于包含复杂目录、版本号或浮点数的工程化系统,引入 natsort 则是更省心且容错率更高的最佳实践。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















