


AI智能体应用工程师需要掌握哪些核心技术栈

看着别人用几行代码就让AI自动查天气、订机票,自己上手时却卡在“为什么它记不住上一句话”或者“怎么让它别胡编乱造”上?这种落差感在刚接触AI Agent开发时特别常见。其实,智能体不是魔法,而是一套精密的工程组合。
最值得先理清的不是哪个模型参数最大,而是数据如何在你的代码和模型之间流动。很多新手一上来就啃复杂的数学公式,结果连个简单的RAG(检索增强生成)都跑不通。真正的核心在于理解上下文窗口、工具调用机制以及如何把非结构化数据变成模型能读懂的向量。
1. 吃透LLM的“脾气”与Prompt工程
别被“大语言模型”这个名字骗了,它本质上是个概率预测机。作为应用工程师,你不需要从头训练模型,但必须懂它的边界。比如,为什么温度参数设为0时回答更稳定,设为1时更有创意?为什么同样的提示词,换个顺序效果天差地别?
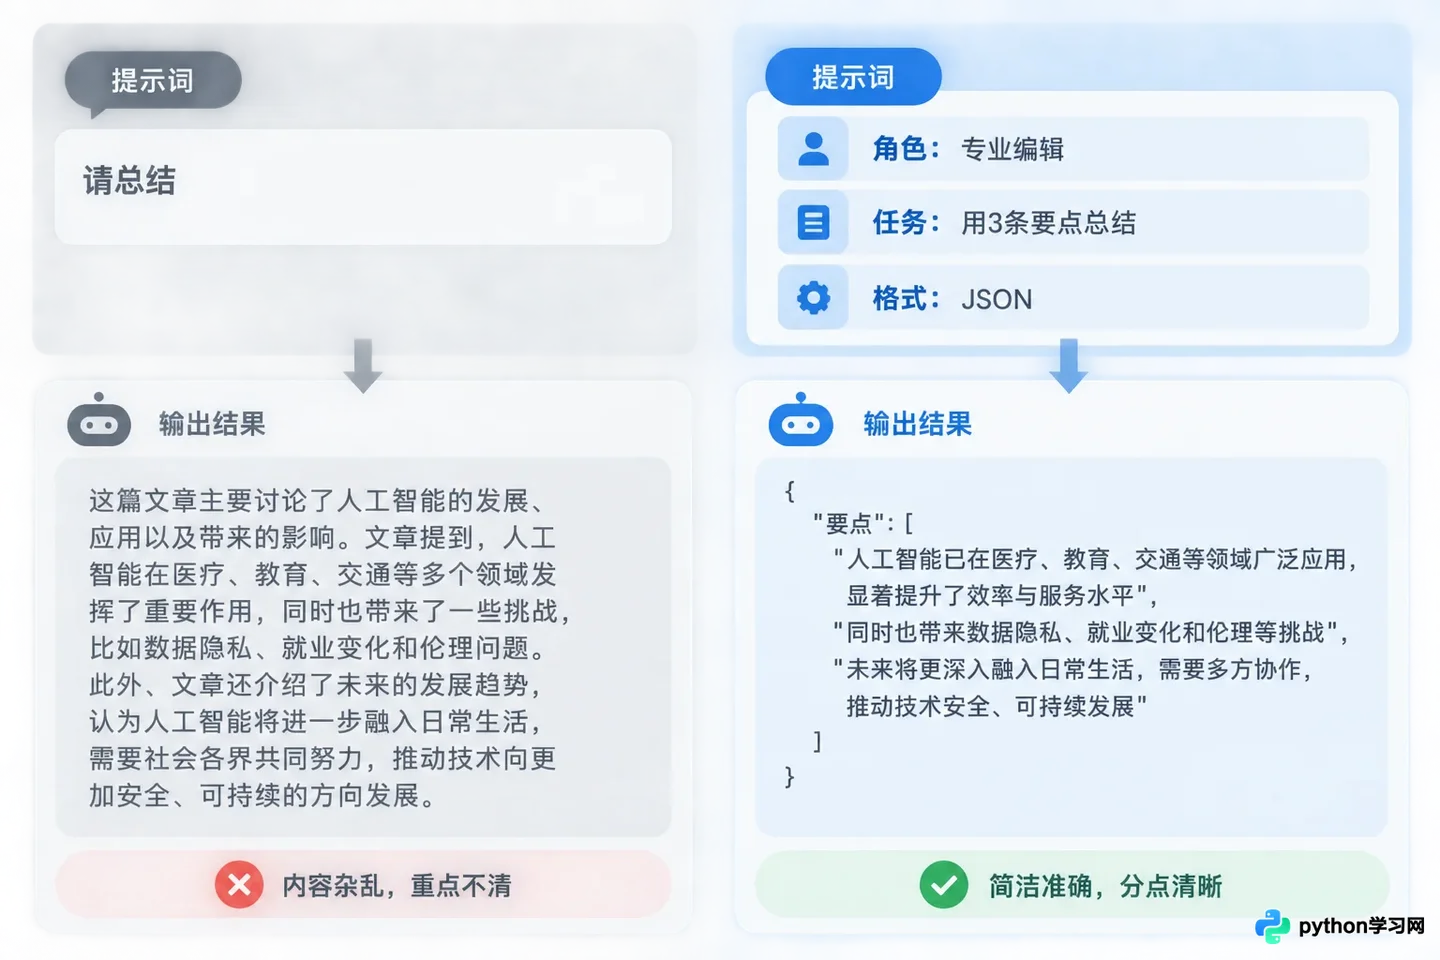
左侧为普通提示词,右侧为包含角色、步骤和格式的结构化提示词,展示输出质量的差异。
这里的关键是掌握结构化Prompt技巧。不要只写“请帮我总结”,而要定义角色、任务步骤和输出格式。学会使用Few-shot Learning(少样本学习),在提示词里给出一两个正确示例,模型的准确率会大幅提升。同时,要熟悉不同模型的上下文限制,知道何时该截断文本,何时该分块处理。
2. 驾驭编排框架:LangChain与LlamaIndex
如果说LLM是大脑,那编排框架就是神经系统。目前主流的两派是LangChain和LlamaIndex,它们各有侧重。
LangChain更像是一个通用的工具箱,适合构建复杂的多步工作流。你需要熟练掌握它的Chain(链)概念,把多个LLM调用、数据处理步骤串起来。比如,先让AI提取关键词,再去搜索,最后总结。它的模块化程度高,但调试起来也相对繁琐,容易陷入“回调地狱”。
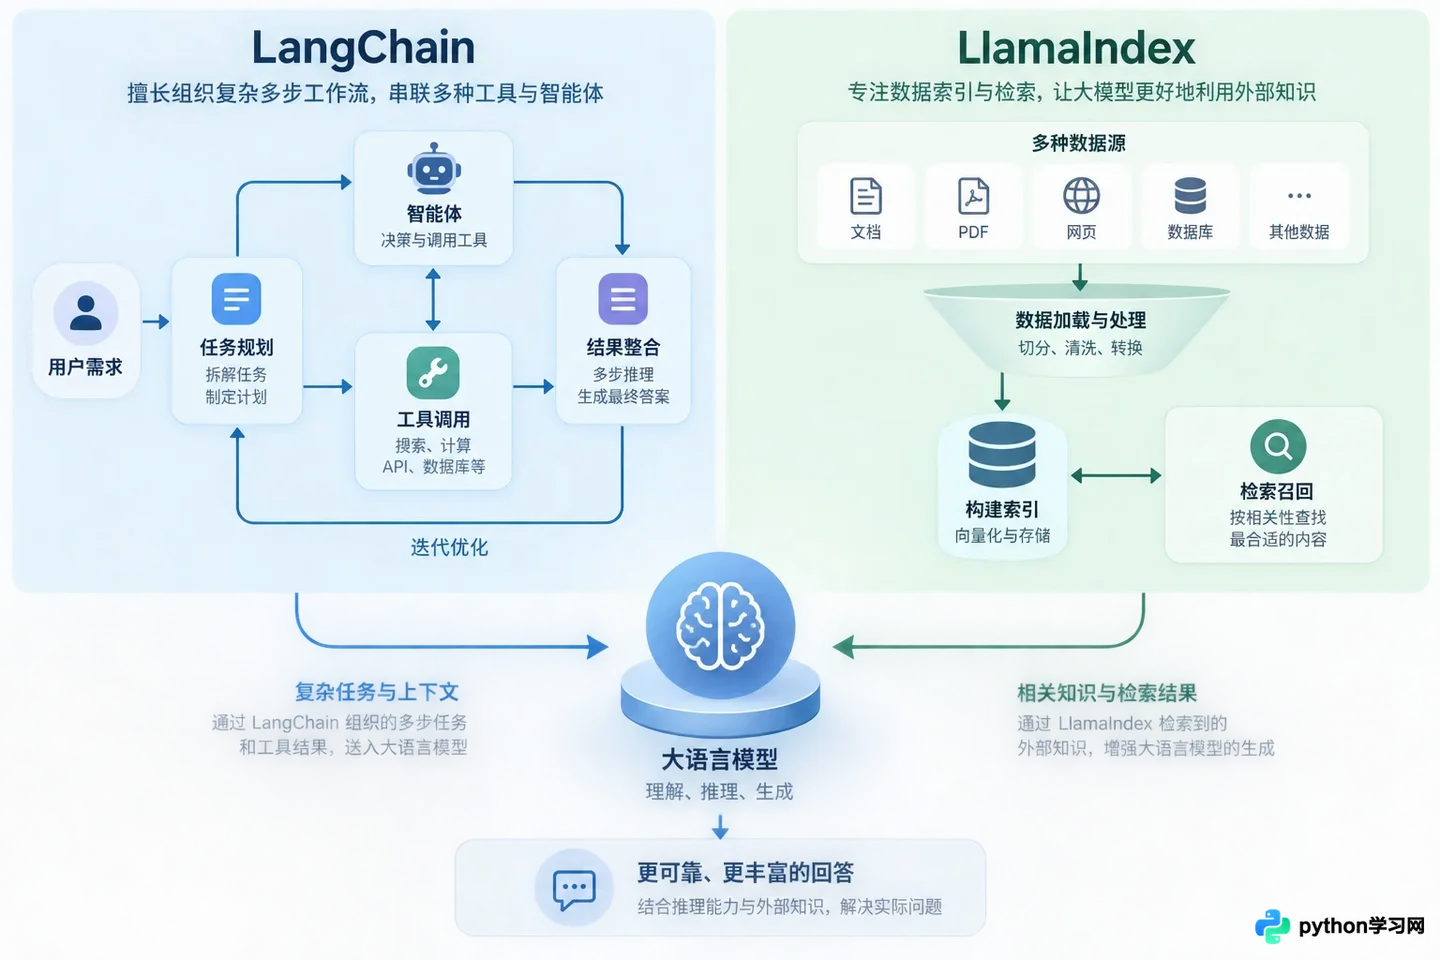
LangChain侧重于多步工作流编排,LlamaIndex侧重于数据索引与检索流程。
LlamaIndex则专注于数据索引和检索,特别适合做RAG应用。如果你的核心需求是让AI基于私有文档回答问题,LlamaIndex的数据加载器和索引结构会更顺手。它简化了从PDF、数据库到向量的转换过程,让你更关注数据本身的质量而非连接逻辑。
建议初学者先从LlamaIndex入手理解数据流向,再深入LangChain学习复杂逻辑编排。两者并非互斥,现在很多项目会混合使用。
3. 给AI装上“长期记忆”:向量数据库
LLM最大的痛点是“健忘”,上下文窗口有限且无法实时更新知识。向量数据库就是解决这个问题的外置硬盘。你需要掌握如何将文本转化为向量(Embedding),并存储到如Chroma、Pinecone或Milvus这样的数据库中。
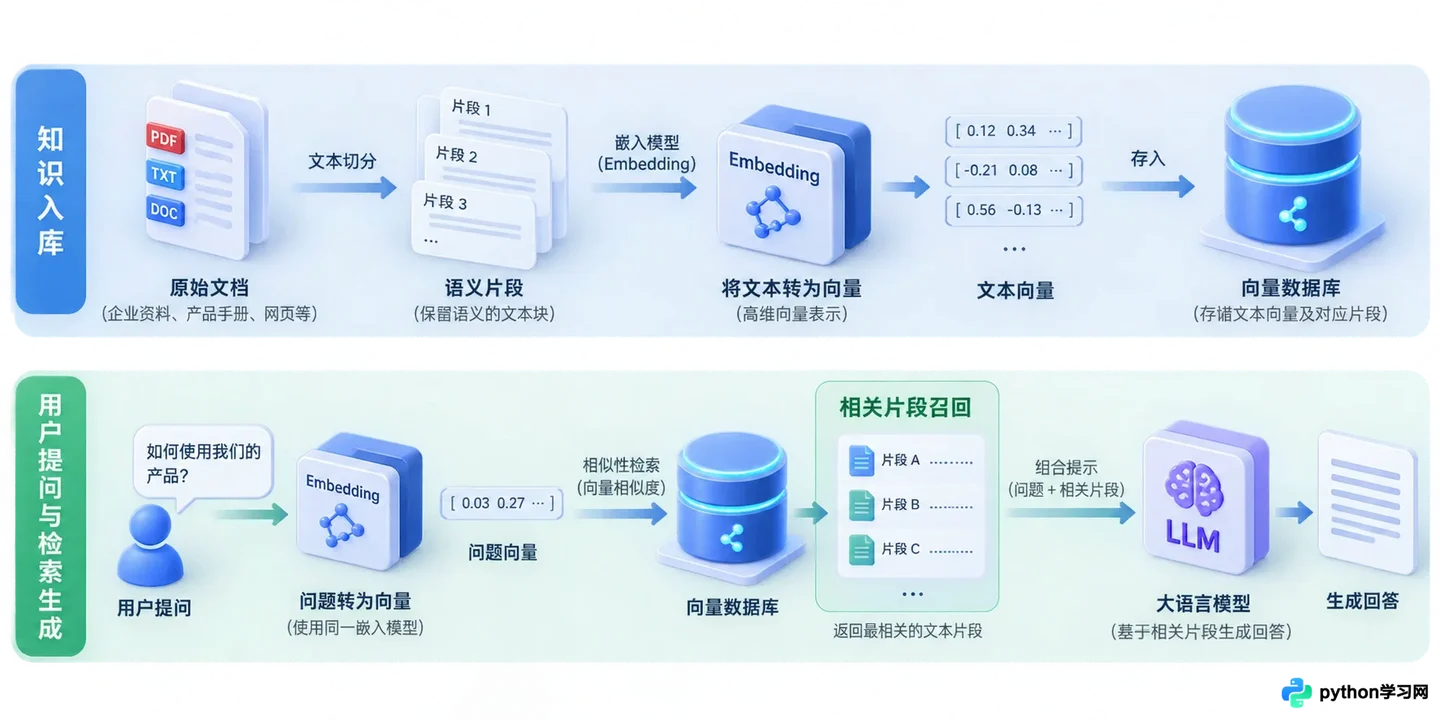
展示文本分块、向量化存入数据库,以及查询时召回相关片段的过程。
这里的难点不在于安装数据库,而在于选择合适的嵌入模型和分块策略。如果分块太大,检索到的信息噪音多;分块太小,又可能丢失语义连贯性。你需要观察检索结果的相关性得分,调整chunk size和overlap参数。当用户提问时,系统先在向量库中找回最相关的片段,再连同问题一起发给LLM,这就是RAG的核心流程。
4. 让智能体“动手”:工具调用与函数执行
真正的智能体能干活,不只是聊天。这需要掌握Function Calling(函数调用)技术。你需要定义清晰的JSON Schema,告诉模型有哪些工具可用(比如搜索API、计算器、数据库查询接口),以及每个工具的参数要求。
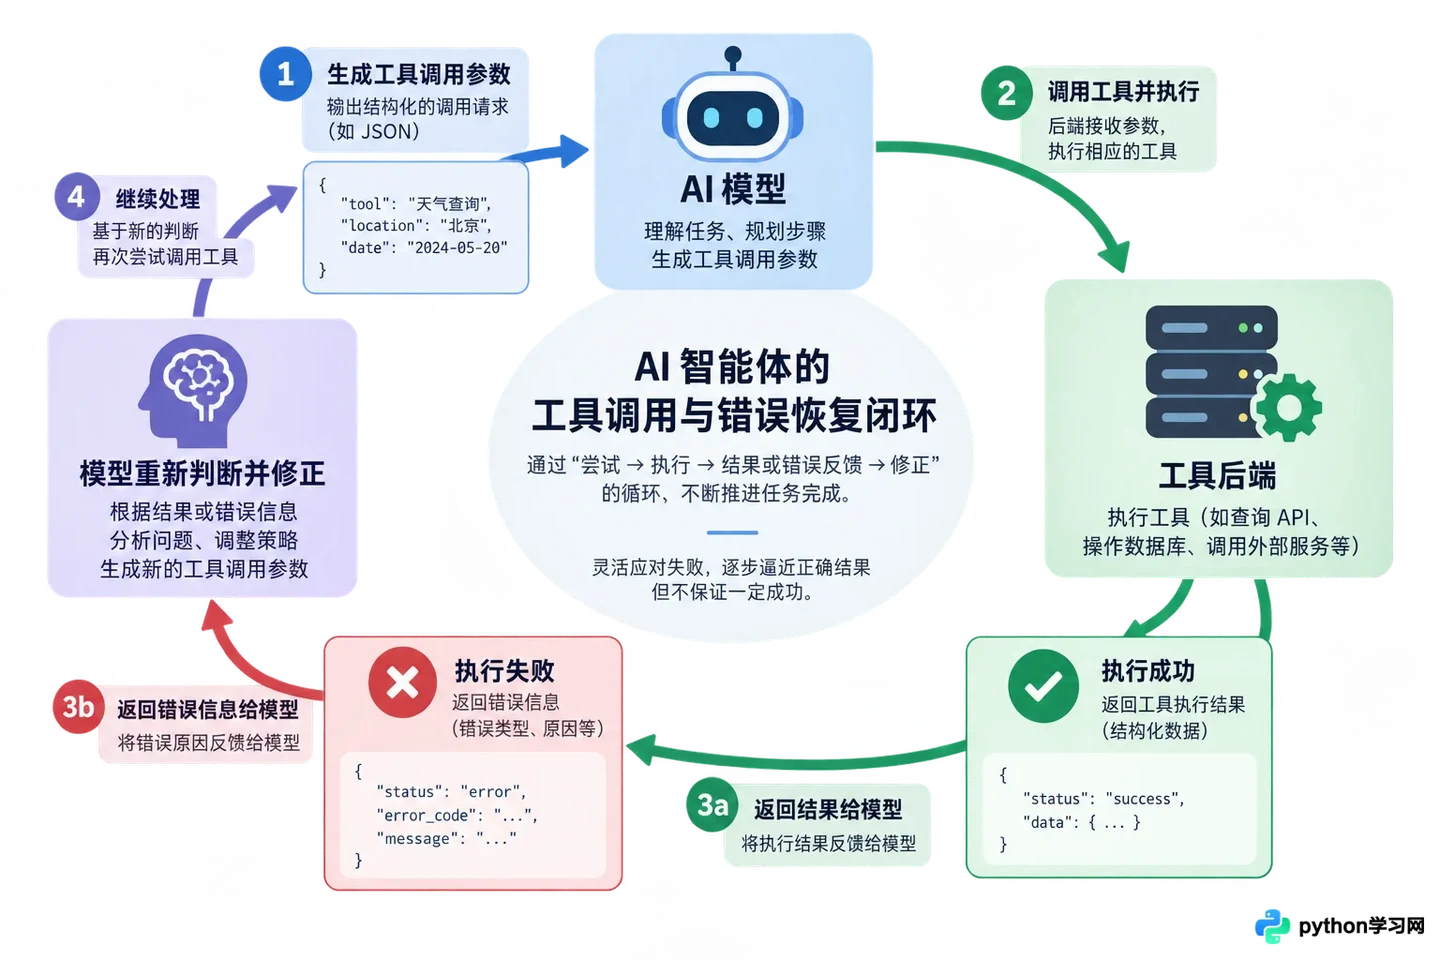
展示模型生成工具参数、后端执行、返回结果并反馈给模型的闭环过程。
关键在于错误处理。模型可能会生成错误的参数格式,或者调用不存在的工具。你的代码必须能捕获这些异常,并把错误信息反馈给模型,让它自我修正。这是一个循环过程:模型尝试->执行报错->反馈错误->模型重试。只有处理好这个闭环,智能体才具备实际可用性。
5. 拒绝黑盒:评估与调试体系
最后,也是最重要的一点:你怎么知道你的Agent变好了?不能靠肉眼盯着聊天记录看。你需要建立一套评估体系,使用如Ragas或TruLens等工具,量化回答的相关性、忠实度和答案正确率。
调试时,不要只看最终输出,要查看中间步骤的日志。看看检索到了什么文档?Prompt是怎么拼接的?模型在哪一步产生了幻觉?通过可视化追踪工具,你能清晰地看到数据流转的每一个节点,从而精准定位问题。
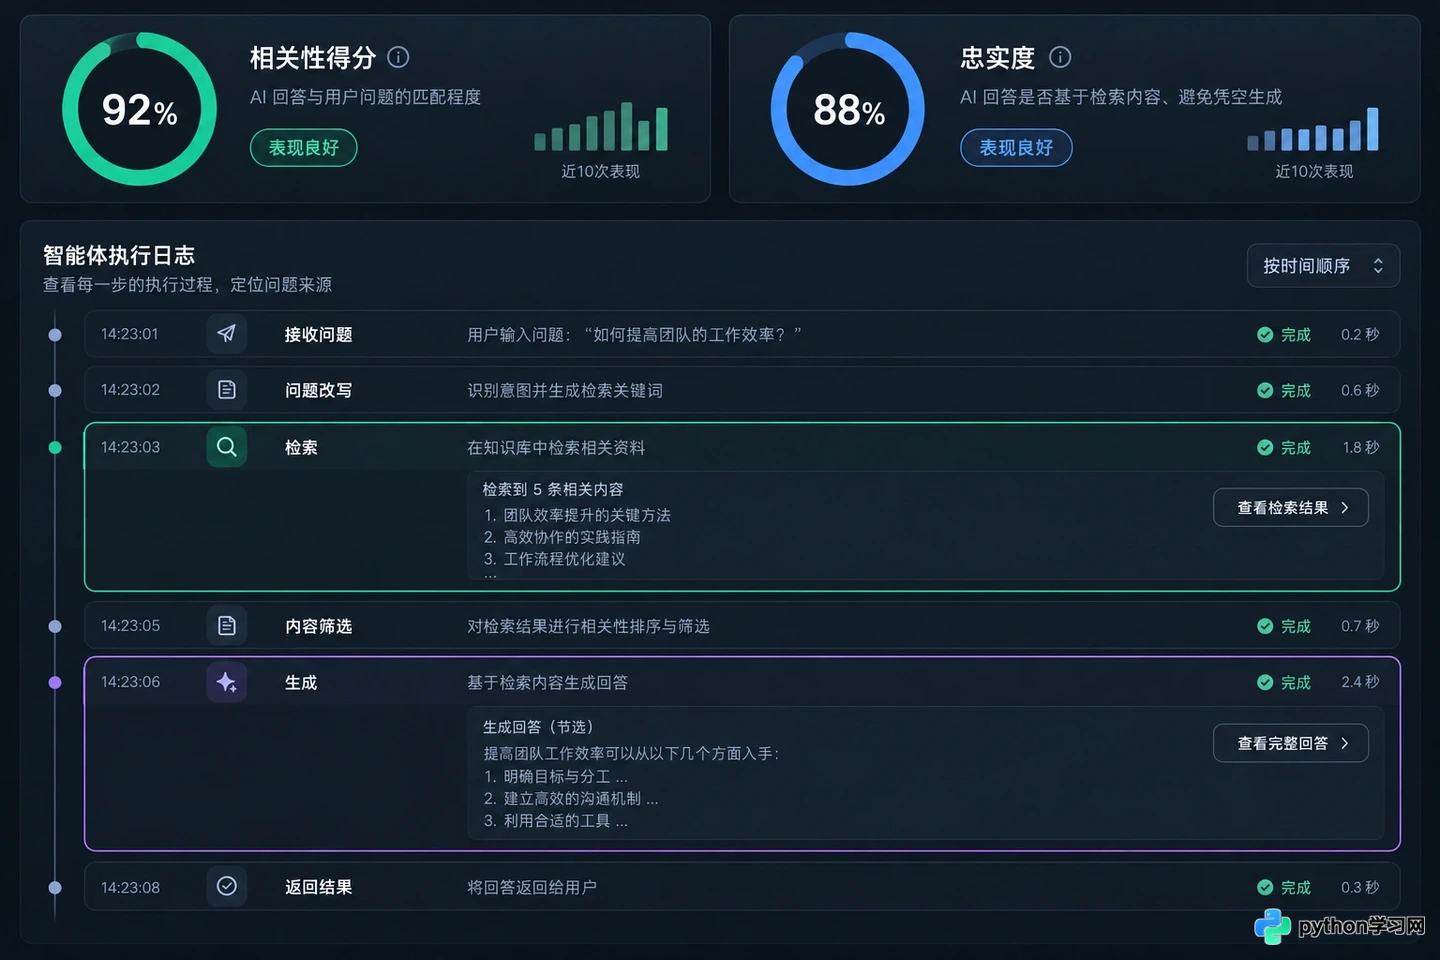
展示包含相关性得分、忠实度指标和中间步骤日志的调试界面。
从理解模型原理到搭建评估闭环,这条路径没有捷径。但不必一次性掌握所有细节,先跑通一个最小的RAG Demo,再逐步添加工具调用和多步推理功能。在实践中遇到的每一个bug,都是对技术栈最深刻的理解。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















