


LangChain与LlamaIndex中怎么集成自定义RAG知识库

手里攥着一堆PDF报告、Markdown笔记或者公司内部的Wiki页面,想让大模型基于这些“私货”回答问题,而不是只靠它训练时的那点旧知识?这就是典型的RAG(检索增强生成)场景。很多开发者卡在第一步:怎么把这些非结构化的文件,变成LangChain或LlamaIndex能理解的“知识库”。
别被复杂的架构图吓到,核心逻辑其实就三步:把数据读进来、切成小块、存进向量数据库。今天我们就看看在这两个最主流的框架里,具体该怎么动手。
LangChain:灵活组装你的数据管道
LangChain的特点是组件化,你可以像搭积木一样选择加载器、分割器和存储后端。对于自定义知识库,最关键的是选对DocumentLoader。
如果你处理的是本地文件夹里的多种格式文件,DirectoryLoader配合UnstructuredFileLoader是个万金油选择。它能自动识别txt、pdf、docx等格式。加载完成后,数据会变成一堆Document对象,这时候直接塞进向量库往往效果不佳,因为段落太长会干扰检索精度。
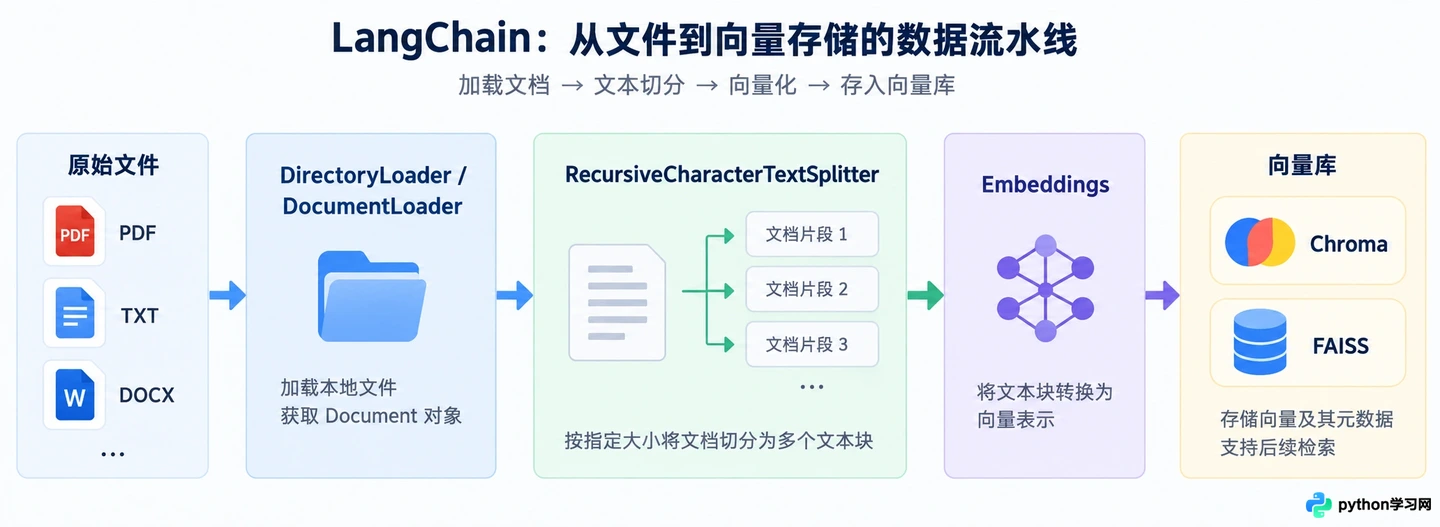
LangChain中从文件加载到向量存储的标准流水线
接下来必须做文本分割。RecursiveCharacterTextSplitter是首选,它会优先按段落换行符切分,保持语义完整性。设置chunk_size为500-1000,chunk_overlap为100-200,能保证上下文不丢失。最后,调用向量数据库(如Chroma或FAISS)的from_documents方法,一步完成嵌入和存储。
from langchain_community.document_loaders import DirectoryLoader
from langchain_text_splitters import RecursiveCharacterTextSplitter
from langchain_chroma import Chroma

# 1. 加载数据
loader = DirectoryLoader("./my_knowledge_base")
docs = loader.load()

# 2. 分割文本
text_splitter = RecursiveCharacterTextSplitter(chunk_size=800, chunk_overlap=100)
splits = text_splitter.split_documents(docs)

# 3. 存入向量库
vectorstore = Chroma.from_documents(documents=splits, embedding=embeddings)
注意,这里的embeddings需要你预先初始化,比如使用OpenAIEmbeddings或本地的HuggingFace模型。存好后,后续查询只需通过vectorstore.as_retriever()获取检索器,再传给LLM即可。
LlamaIndex:以数据为中心的索引构建
相比LangChain的“管道”思维,LlamaIndex更强调“索引”的概念。它默认假设你要处理的是结构化或半结构化数据,因此在处理自定义知识库时,它的SimpleDirectoryReader更加开箱即用。
在LlamaIndex中,你不需要手动管理分割细节,除非你有特殊需求。它的VectorStoreIndex会自动处理文本拆分和嵌入。你只需要告诉它数据在哪里,以及用什么嵌入模型。
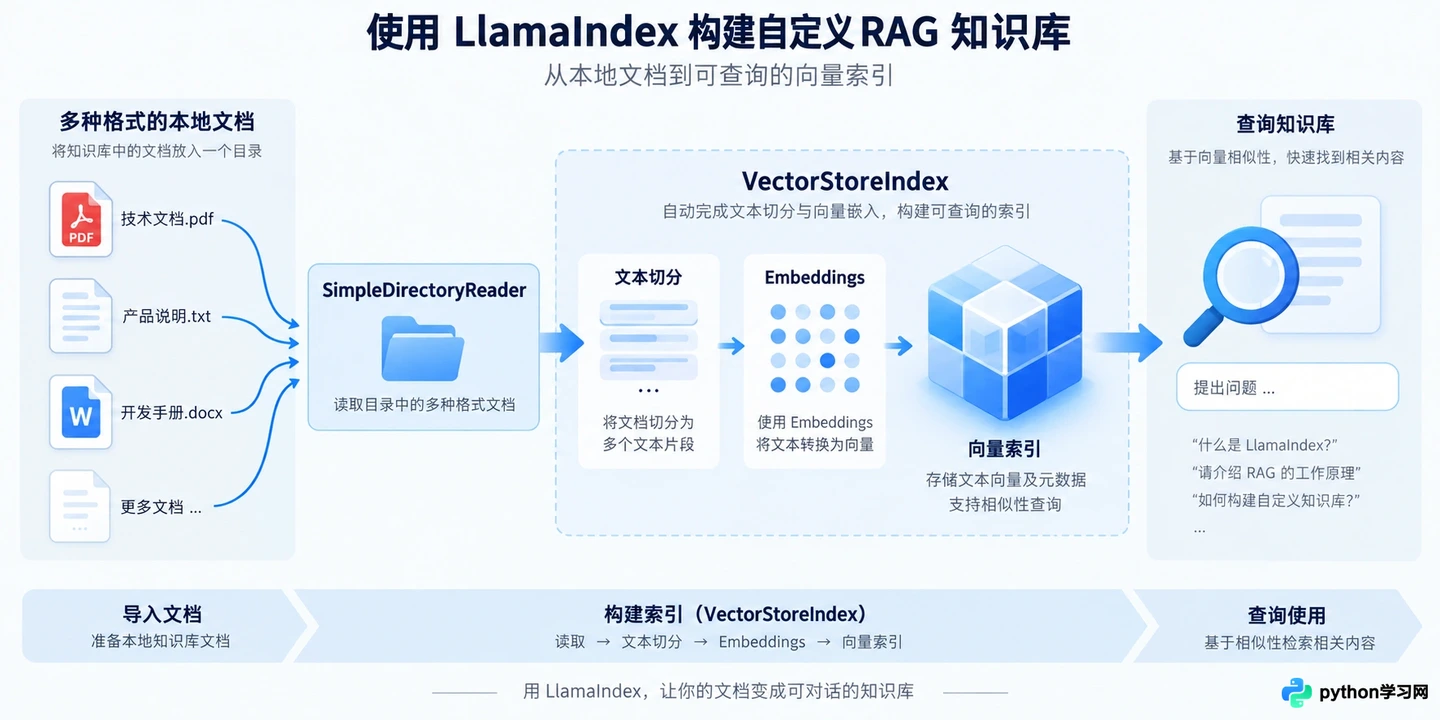
LlamaIndex自动处理文档索引与嵌入的过程
对于自定义数据,如果标准加载器搞不定(比如特殊的数据库导出格式),你可以实现一个简单的BaseReader类,或者直接将数据预处理成字符串列表,使用Document对象直接构建索引。这种方式适合数据量不大、但格式极其不规则的场景。
from llama_index.core import SimpleDirectoryReader, VectorStoreIndex
from llama_index.embeddings.openai import OpenAIEmbedding

# 1. 加载数据
documents = SimpleDirectoryReader("./my_knowledge_base").load_data()

# 2. 构建索引(自动包含分割和嵌入)
index = VectorStoreIndex.from_documents(
    documents,
    embed_model=OpenAIEmbedding()
)

# 3. 创建查询引擎
query_engine = index.as_query_engine()
response = query_engine.query("我的知识库里有提到什么关于Q3的计划?")
LlamaIndex的优势在于后续的查询优化,比如支持子节点检索或元数据过滤。如果在加载时需要剔除某些文件,可以在SimpleDirectoryReader中通过file_metadata函数进行筛选,避免脏数据进入索引。
避坑指南:分割策略决定检索质量
无论用哪个框架,最容易翻车的地方都是文本分割。很多人直接用默认参数,结果把一个完整的代码块或表格切得支离破碎,导致模型回答时断章取义。
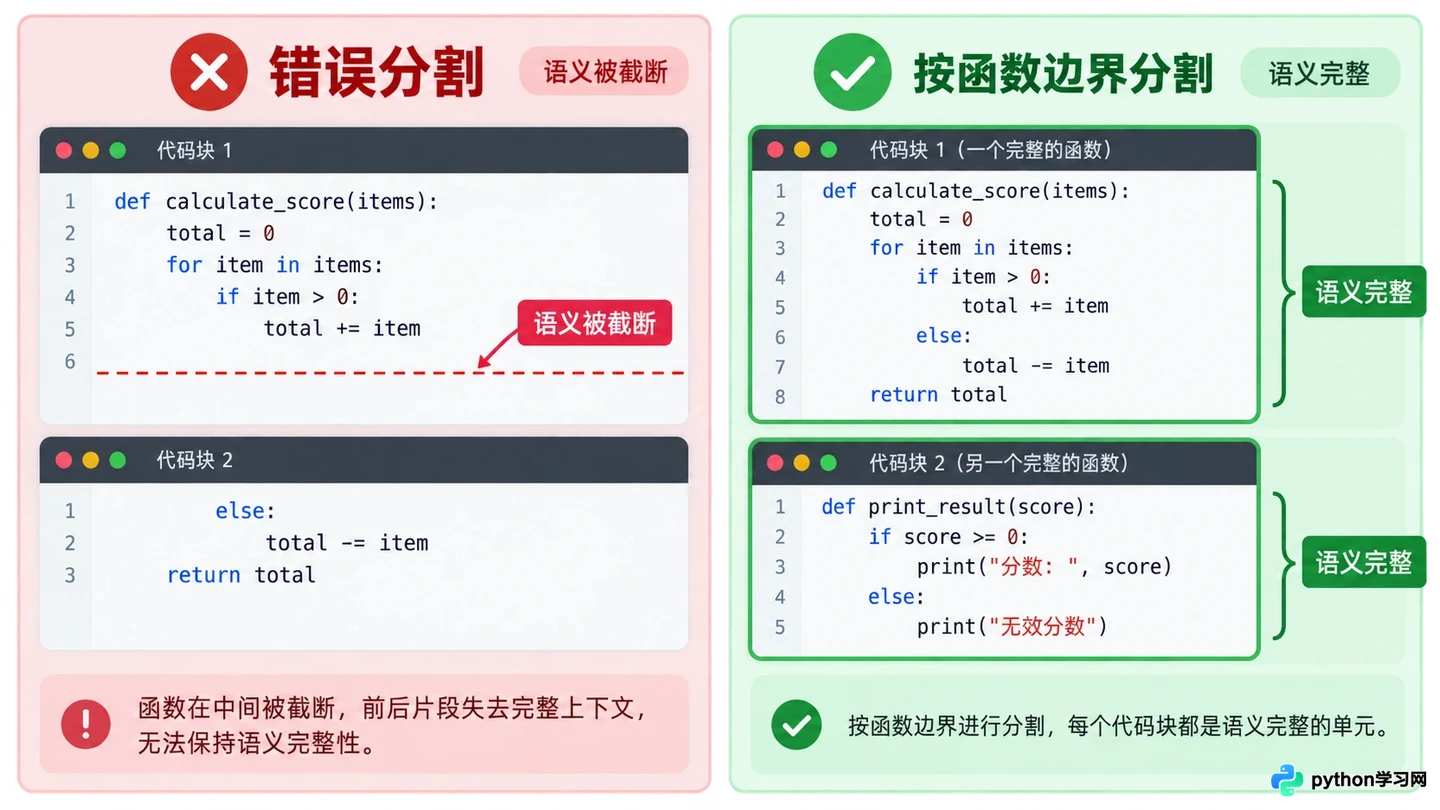
不同分割策略对语义完整性的影响对比
对于代码库,建议使用专门针对代码优化的分割器,如LangChain的Language分割器,它能识别函数和类的边界。对于包含大量表格的PDF,单纯的字符分割会丢失行列关系,这时需要考虑将表格转换为Markdown或HTML格式后再存入,或者使用支持多模态的嵌入模型。
另外,别忘了给每个文档块加上元数据(Metadata)。比如文件名、页码或上传日期。在LangChain中可以通过metadata字段传递,在LlamaIndex中则是node.metadata。这样在检索时,你可以过滤掉过期的文档,或者在回答中注明出处,增加可信度。
选型建议:看场景下菜碟
如果你的需求是快速原型验证,或者需要高度定制化的数据处理流程(比如先清洗、再翻译、最后入库),LangChain的灵活性更适合你。它的生态丰富,几乎能找到任何冷门格式的加载器。
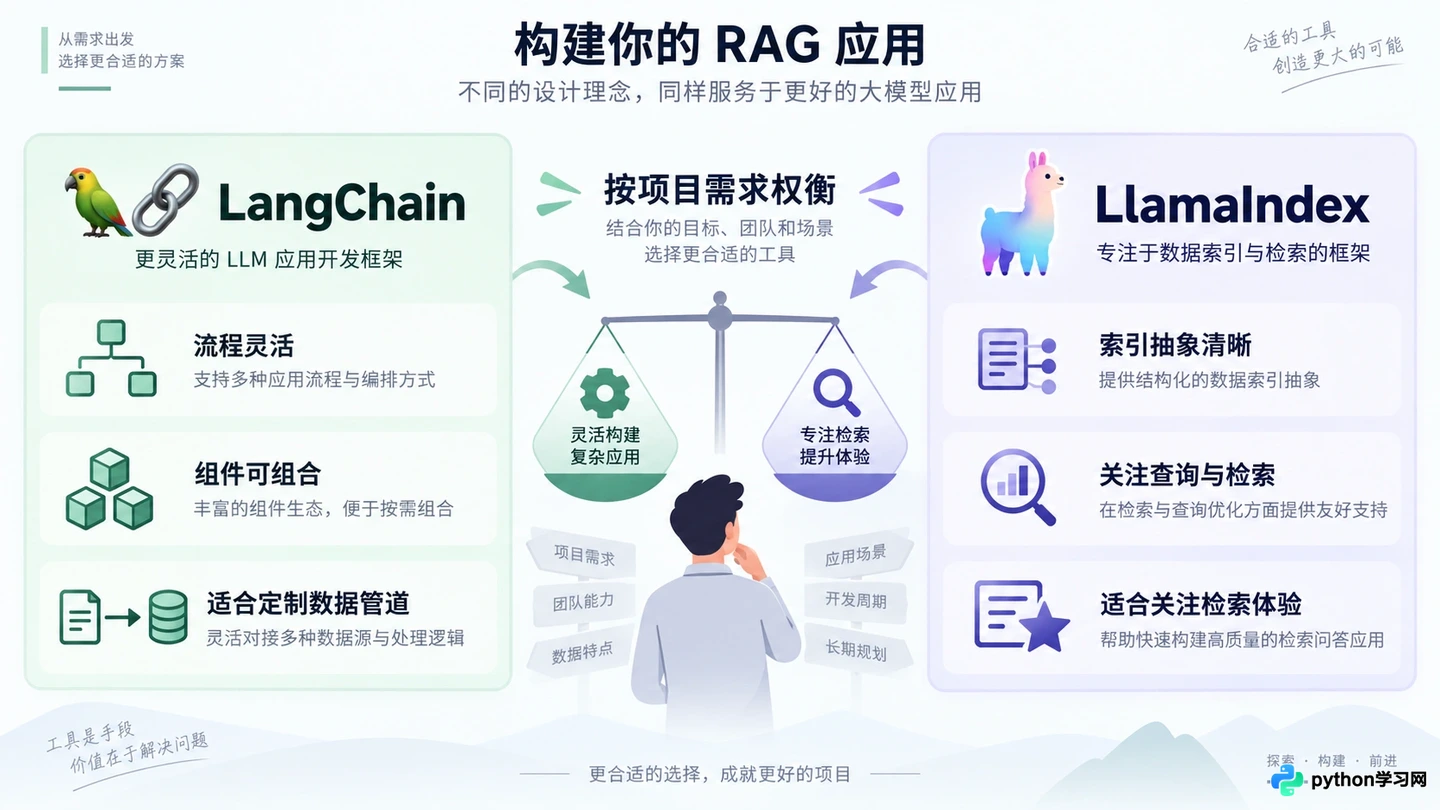
根据项目需求选择合适的RAG框架
如果你更关注查询阶段的性能,比如需要复杂的混合检索、重排序(Re-ranking)或者对结构化数据有强依赖,LlamaIndex的抽象层级更高,能帮你省去不少底层调试的时间。它的默认配置通常已经针对常见场景做了优化,上手阻力更小。
不管选谁,记得先小规模测试。拿十几份典型文档跑通全流程,看看检索回来的片段是否真的能回答你的问题,再全量导入。毕竟,垃圾进,垃圾出,RAG的效果上限取决于你知识库的质量,而不是模型的参数量。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















