


Python怎么打开文件:open函数语法与读写模式详解

open() 函数。掌握 open() 的关键在于两点:一是理解其参数体系与字符编码配置,二是准确选择针对特定业务场景的读写模式(如 r、w、a、x 及其二进制与读写扩展形式)。本文将从基础语法展开,详细拆解每一种读写模式的行为边界,并通过代码示例与结构图示,演示如何利用上下文管理器安全高效地管理文件句柄。
一、open() 函数的核心语法与参数拆解
open() 是 Python 的内置全局函数,其底层由 _io 模块驱动,负责建立操作系统底层文件描述符与 Python 运行环境之间的桥梁,最终返回一个流式的文件对象(File Object)。
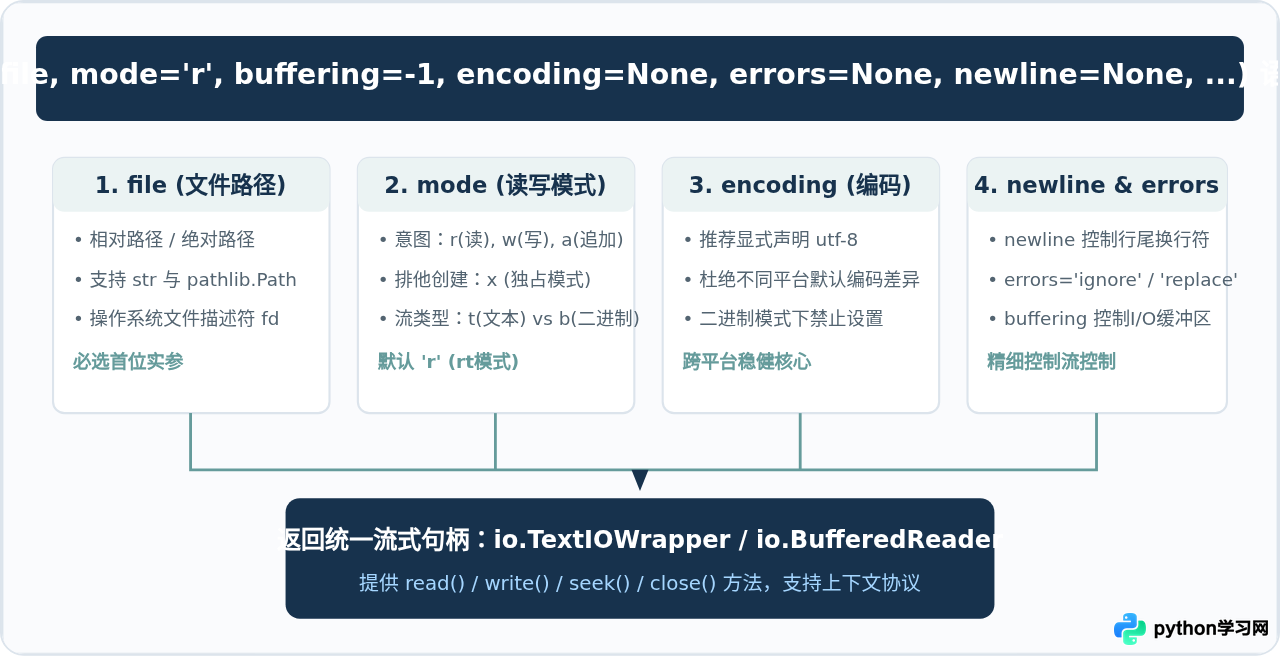
在实际开发中,open() 函数拥有较为丰富的参数列表,其完整签名如下:
open(file, mode='r', buffering=-1, encoding=None, errors=None, newline=None, closefd=True, opener=None)尽管参数较多,但在绝大多数日常工程中,核心关注的参数主要是以下四个:
- file:目标文件的路径。可以是普通字符串路径(相对路径或绝对路径),也可以是
pathlib.Path对象,或者系统原生整数文件描述符。 - mode:指定文件的打开模式,默认为只读文本模式
'r'。此参数决定了文件是用于读取、覆盖写入还是末尾追加,以及采用文本流还是字节流。 - encoding:仅在文本模式(Text Mode)下生效,指定文本解码与编码格式(如
'utf-8'或'gbk')。如果省略该参数,Python 会使用操作系统的默认本地编码(Windows 下通常是 GBK,macOS/Linux 通常是 UTF-8),这极易引发跨平台乱码问题。 - newline:控制文本模式下的换行符解析方式。默认为通用换行模式,自动将
\r\n或\r统一映射为\n;在处理 CSV 等强依赖严格行尾的数据格式时,通常显式指定为newline=''。
二、读写模式详解:r、w、a、x 及扩展组合
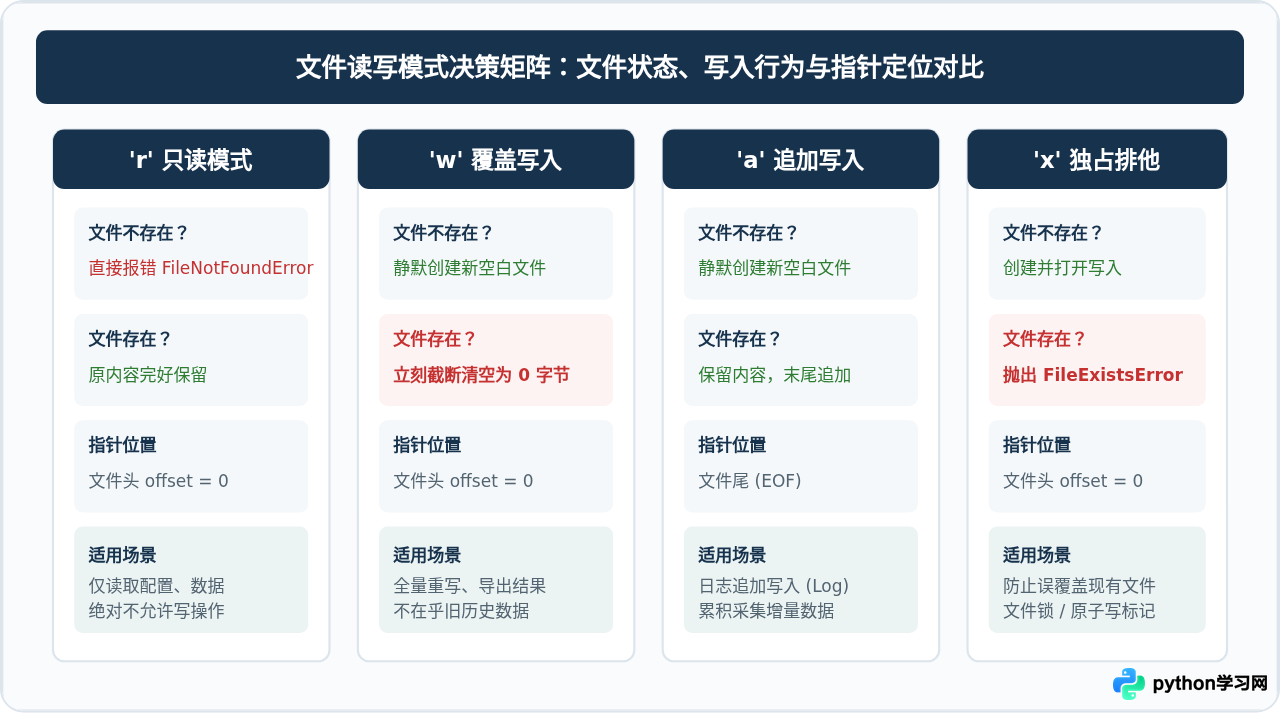
mode 是 open() 中最容易混淆的设置项。模式参数由两部分组合而成:基础访问意图(读、写、追加、排他)与数据形式(文本 t 或二进制 b)。此外,追加 + 符号可以赋予模式兼具读写的双向权限。
1. 四大基础访问模式
| 模式字符 | 操作含义 | 文件不存在时 | 文件存在时 | 文件指针初始位置 |
|---|---|---|---|---|
'r' |
只读(Read) | 抛出 FileNotFoundError |
正常打开,保留原内容 | 文件开头(0 字节位置) |
'w' |
覆盖写入(Write) | 自动创建新文件 | 立即清空原内容(Truncate 为 0) | 文件开头 |
'a' |
追加写入(Append) | 自动创建新文件 | 保留原内容,新写入排在末尾 | 文件末尾(EOF) |
'x' |
独占排他创建(Exclusive) | 正常创建新文件并写入 | 抛出 FileExistsError |
文件开头 |
'w' 模式的破坏性:
只要执行 open('data.txt', 'w'),即使你随后没有调用任何 write() 方法就关闭文件,该文件原本的内容也已经被操作系统截断清空。如果你希望保留原有内容并在末尾新增,务必使用 'a' 模式;如果不确定文件是否存在且担心误删,可使用 'x' 模式。
2. 读写更新模式(+ 扩展)
在基础模式后添加 '+' 可以开启同时读写的功能,但三种模式的底层指针逻辑截然不同:
'r+'(读写):允许读和写。不会清空文件,指针停在文件头部。若直接写入,会从当前位置逐字节覆盖后面的旧数据,而未覆盖的部分仍保留。'w+'(写读):允许读和写。但在打开瞬间即清空文件。写入数据后若想读取,必须手动使用seek(0)将指针移回开头,否则读出的将是空内容。'a+'(追加读写):允许读取和追加写入。打开时指针初始在末尾,无论如何移动指针读取,只要执行写入操作,底层都会强制将数据追加到物理末尾。
三、文本模式 vs 二进制模式
在模式参数中,t 代表文本模式(Text Mode,默认项),b 代表二进制模式(Binary Mode)。
-
文本模式(如
'r','w','rt'):
程序读取或写入的都是 Python 字符串(str)。此时 Python 必须依靠指定的encoding在底层的字节流与上层的 Unicode 字符串之间进行编解码。如果不显式指定encoding='utf-8',当代码迁移到默认 GBK 编码的 Windows 环境时,包含中文的文件很容易抛出UnicodeDecodeError。 -
二进制模式(如
'rb','wb','ab'):
程序直接操作原始字节流(bytes),不进行任何字符集转码,也不会对换行符进行通用转换。处理图片(PNG/JPEG)、音视频、PDF、压缩包或执行网络原始数据包序列化时,必须使用二进制模式。此时禁止传递encoding参数,否则会触发ValueError: binary mode doesn't take an encoding argument。
四、操作步骤:使用 with 语句的安全操作流水线
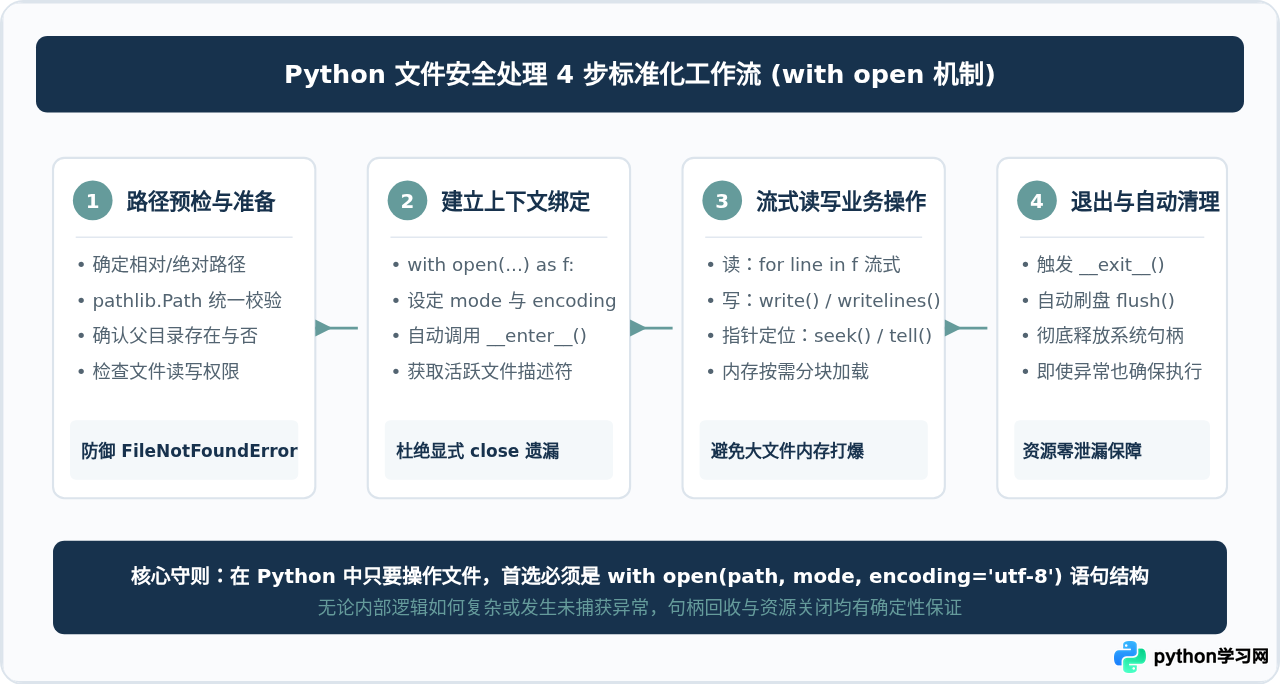
在早期的 Python 代码中,打开文件通常采用 f = open(...) 并在末尾手动 f.close()。这种做法有极高的隐患:若中间发生业务异常、提前 return 或代码意外中断,close() 将被跳过,导致底层操作系统文件句柄泄漏,进而引发资源锁死或数据写入缓存未刷盘丢失。
现代 Python 的标准实践是始终使用 with 上下文管理器(Context Manager)。with open(...) as f: 会在进入代码块时调用句柄的 __enter__(),并在离开代码块(无论是正常结束还是发生未捕获异常)时,由 Python 解释器在 finally 机制中确定性地调用 __exit__(),确保文件句柄被安全关闭并刷新缓冲区。
五、具体代码示例与核心读写方法
1. 安全读取文本文件
读取文本文件时,推荐使用 encoding='utf-8'。根据数据体量的大小,选择不同的读取策略:
# 场景 A:小文件全量读取
with open('config.json', mode='r', encoding='utf-8') as f:
    content = f.read()  # 一次性读入全部内容为字符串
    print(f"文件总字符数: {len(content)}")

# 场景 B:大文件流式逐行遍历(推荐,内存占用恒定极小)
with open('access.log', mode='r', encoding='utf-8') as f:
    for line in f:
        clean_line = line.strip()
        if 'ERROR' in clean_line:
            print(clean_line)
2. 写入与追加写入
当执行写入时,write() 并不会自动在末尾追加换行符 \n,需要由调用方主动添加:
# 覆盖写入:生成全新文件
users = ['Alice\n', 'Bob\n', 'Charlie\n']
with open('users.txt', mode='w', encoding='utf-8') as f:
    f.writelines(users)

# 追加写入:保留原内容并添加新记录
with open('users.txt', mode='a', encoding='utf-8') as f:
    f.write('David\n')
3. 二进制文件的分块复制
复制或者处理大尺寸图片、视频时,通过 'rb' 和 'wb' 配合固定字节大小(如 64KB)的缓冲区,可以在保证极低内存消耗的同时高效完成传输:
def copy_binary_file(src_path, dest_path, chunk_size=65536):
    with open(src_path, 'rb') as src, open(dest_path, 'wb') as dest:
        while True:
            chunk = src.read(chunk_size)
            if not chunk:
                break
            dest.write(chunk)
4. 文件指针控制:seek() 与 tell()
操作系统通过指针跟踪当前操作的字节偏移位置:
f.tell():返回当前文件指针所在的字节位置(注意是字节 offset,非字符索引)。f.seek(offset, whence=0):改变指针位置。whence取 0 表示从文件头计算偏移;取 1 表示从当前位置计算;取 2 表示从文件末尾计算。在文本模式下,除非seek(0)回到开头,否则通常只允许基于tell()返回的确定偏移值进行跳转。
六、高频陷阱与防坑指南
初学者在操作文件时,往往会踩入几个典型的隐藏陷阱:
-
相对路径基准问题:
代码中写open('data.txt'),寻找文件的基准路径是当前运行终端的工作目录(Current Working Directory,即os.getcwd()),而不是 Python 脚本文件所在的目录。如果从不同父级目录下运行脚本,极易触发FileNotFoundError。稳健做法是使用Path(__file__).resolve().parent / 'data.txt'定位。 -
Windows 编码默认坑:
在 Windows 系统中,如果不显式声明encoding='utf-8',默认会采用 ANSI/GBK 编码解析,遇到带 Emoji 或现代字符集的 UTF-8 文本将直接崩溃抛出UnicodeDecodeError。 -
全量 readlines() 撑爆内存:
遇到数 GB 级别的日志或数据集时,使用f.readlines()会将整个文件所有的行全部加载并生成一个庞大的列表,极易导致服务器内存溢出(OOM)。正确方式是直接通过for line in f:迭代文件对象本身。
七、总结
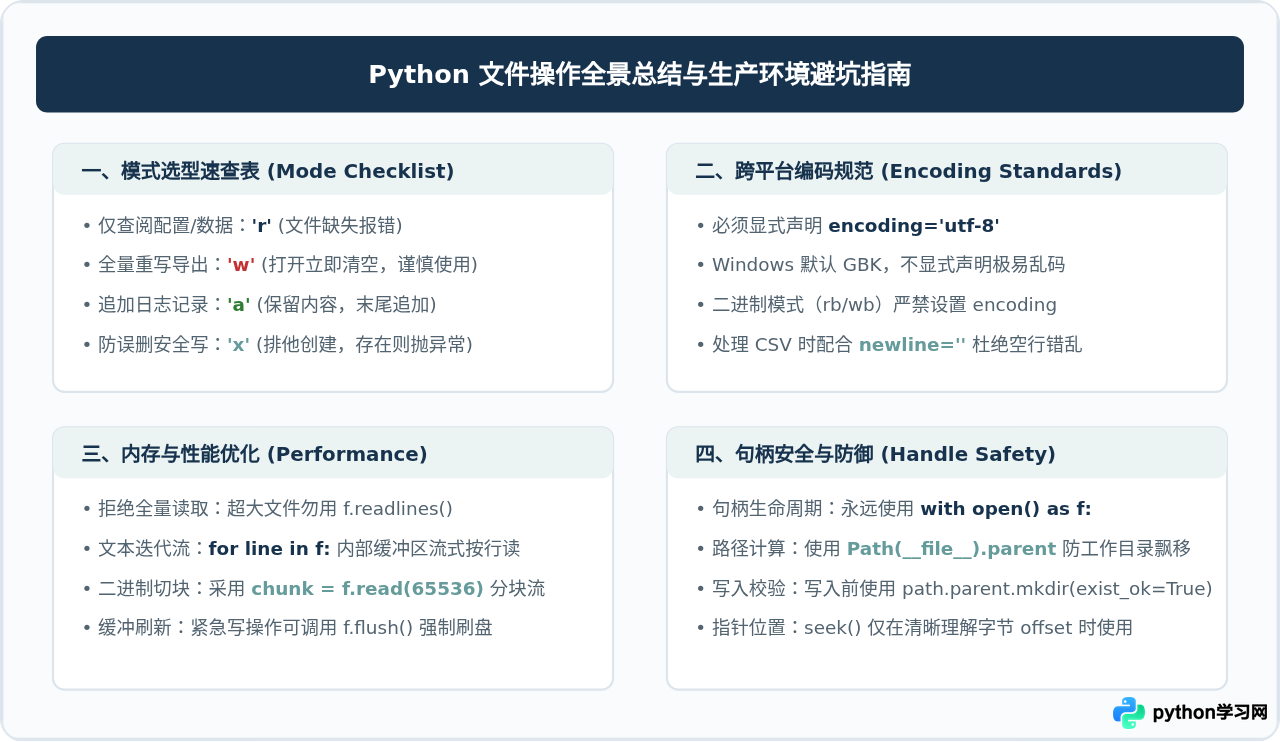
掌握 Python 的 open() 函数并不复杂,其核心在于养成良好的工程编码习惯:
- 处理常规文本文件时,固定写出
with open(file, 'r', encoding='utf-8') as f:的标准模板; - 明确写入场景,区分清空覆盖的
'w'、保留追加的'a'与防错创建的'x'; - 操作非文本文件时,明确加上
'b'并剥除encoding参数; - 面对大文件,放弃一次性全部读取,改用生成器流式迭代。
遵循这套规范,既能确保代码在 Linux、macOS 和 Windows 各平台上表现一致,又能彻底消除资源泄漏和因意外覆盖导致的数据丢失风险。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















