


Python读取文件的标准写法:为什么推荐用with open
深入讲解Python中使用with open语句读取文件的标准写法、语法细节与底层原理。通过实际代码与执行路径对比,解析上下文管理器如何保证文件描述符的安全释放,彻底解决资源泄露问题。
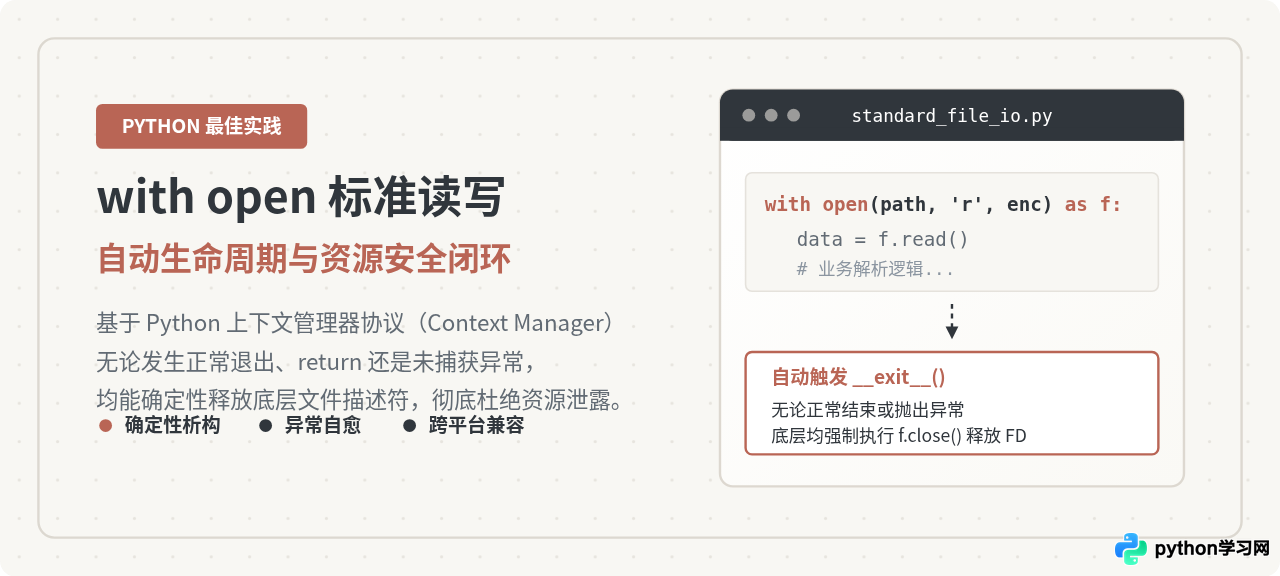
with open(filename, 'r', encoding='utf-8') as f:。之所以强烈推荐这种写法,核心原因在于它深度契合了 Python 的上下文管理器协议(Context Manager Protocol):无论文件读取过程是正常执行完毕、提前 return,还是中途遭遇严重异常而崩溃,Python 虚拟机都会在离开作用域时确定性地调用 close() 方法释放系统文件描述符,彻底消除因手动管理失误而引发的文件句柄泄露与数据破坏隐患。
一、Python 读取文件的标准代码形态
在实际工程开发中,读取文件的需求主要分为两类:一次性载入小型文本(如配置文件、简单模板)和逐行流式读取海量数据(如业务日志、大型数据清单)。这两种场景的标准写法形式均依托于 with open 结构展开。
1. 小型文本的标准读取范式
对于明确体积较小(例如小于数十兆字节)的 UTF-8 编码文本文件,可以在 with 作用域内直接调用 f.read():
# 小型文本读取标准范式
with open('config.json', mode='r', encoding='utf-8') as f:
    content = f.read()

# 在 with 代码块外部,文件已自动关闭
print(len(content))
print(f.closed)  # 输出: True
2. 大文件与常规文本的流式迭代范式
如果文件行数较多或体积未知,绝对不要使用 read() 或 readlines(),而应当直接把文件句柄对象 f 作为惰性生成器进行遍历:
# 大文件及常规日志的标准流式读取范式
with open('access.log', mode='r', encoding='utf-8') as f:
    for line_no, line in enumerate(f, start=1):
        clean_line = line.rstrip('\n')
        if 'ERROR' in clean_line:
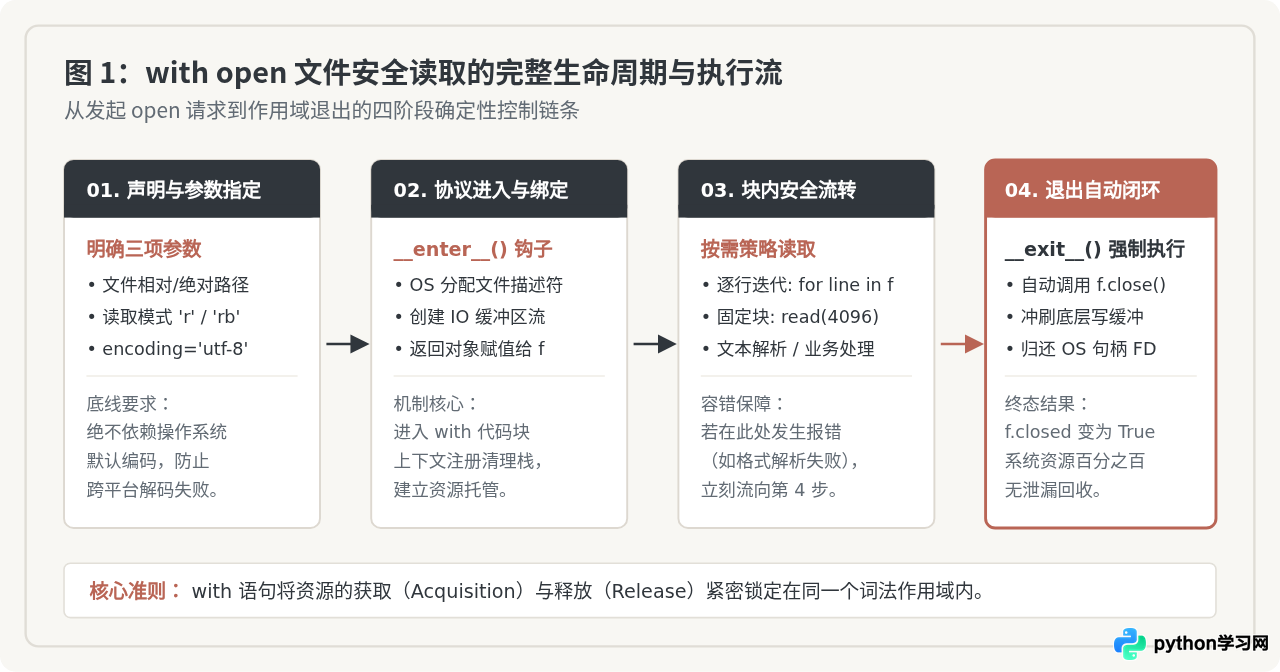
print(f"[第 {line_no} 行] {clean_line}")open() 时,务必显式声明三项参数:文件路径、访问模式(默认只读建议显式写 'r')以及编码方式 encoding='utf-8'。若省略 encoding,Python 将回退至操作系统默认编码(Windows 下多为 GBK / CP936,Linux 下为 UTF-8),这极容易导致线上跨平台部署时突发 UnicodeDecodeError。
二、为什么传统 open() 极易出事故:显式 close() 的致命死角
许多初学者最初接触文件操作时,往往采用如下写法:
# 极度脆弱的不良写法:不要在生产环境中这样写
f = open('orders.csv', 'r', encoding='utf-8')
data = f.read()
parsed = [int(x) for x in data.split(',')]  # 若数据中混入非法字符,立即抛出 ValueError
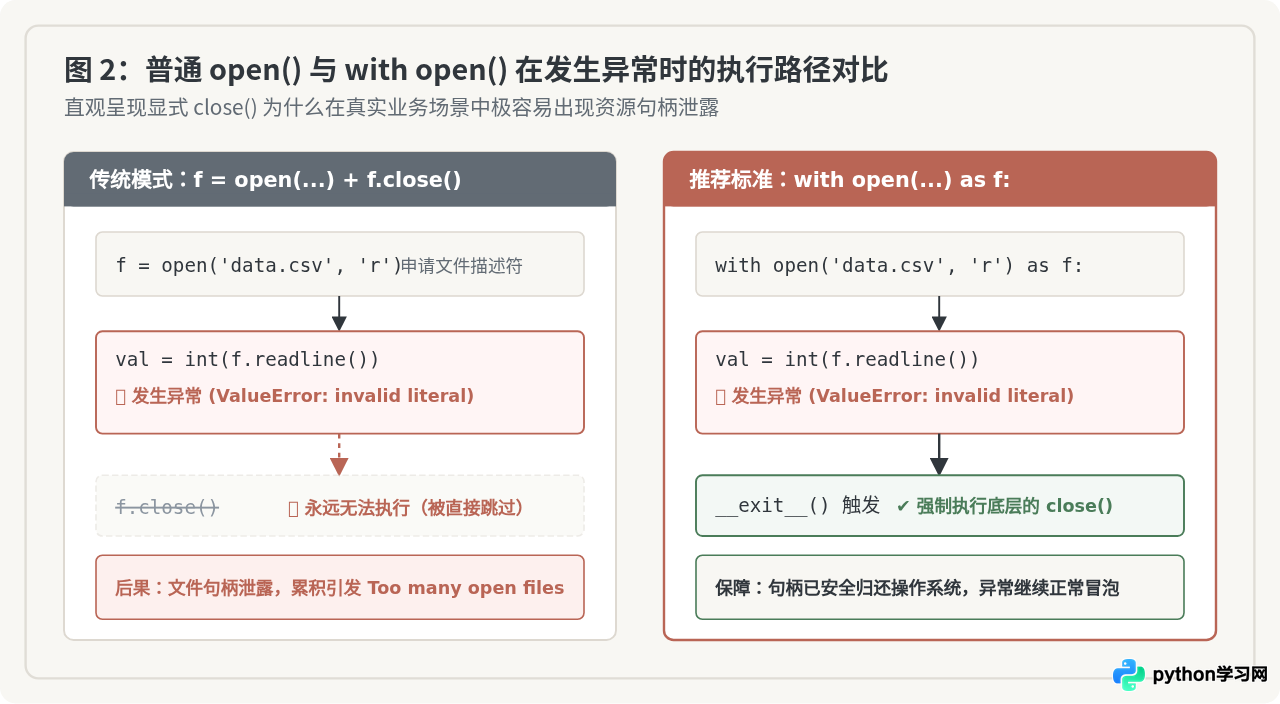
f.close()  # 发生异常时,此行永远不会被执行!
表面上看,这段代码在末尾显式调用了 f.close()。但在真实的业务逻辑中,文件打开之后往往伴随着数据反序列化、格式转换、数学运算或网络转发等复杂操作。
一旦在 open() 和 close() 之间抛出任何未捕获异常(例如数据格式异常 ValueError、索引越界 IndexError 甚至内存不足 MemoryError),整个函数的执行流会被操作系统立即中断并展开调用栈回溯。此时,排在后方的 f.close() 就会被直接跳过。
1. 文件描述符耗尽与系统崩溃
在操作系统内核层,每打开一个文件都会占用一个文件描述符(File Descriptor, FD)。操作系统对单个进程允许持有的最大文件描述符数量设置了严格的上限(在常见的 Linux 系统中,默认限制通常为 1024,可通过 ulimit -n 确认)。
如果在一个长时间运行的服务进程(如 Web API 处理器、后台轮询 Worker 或定时任务)中反复执行存在漏洞的文件读取逻辑,未被正确关闭的句柄将持续滞留于内核表中。即便 Python 具备引用计数垃圾回收机制,但在循环引用或对象生命周期较长的情况下,系统资源的回收并不及时。当打开的文件数触及上限时,系统将直接抛出致命的内核级错误:
# 当系统句柄耗尽时的致命报错
OSError: [Errno 24] Too many open files: 'data.txt'
此时进程不仅无法继续读取任何新文件,连建立新的网络套接字(Socket)、加载依赖库等一切依赖文件描述符的底层系统调用都会全部瘫痪。
2. try...finally 虽然可行,但成本高昂
在 with 语句引入之前,开发者必须通过 try...finally 结构来确保关闭动作必定发生:
# 旧式防御写法:繁复且嵌套冗长
f = open('data.txt', 'r', encoding='utf-8')
try:
    process_data(f)
finally:
    f.close()
虽然 try...finally 能够保障异常安全性,但样板代码(Boilerplate)占比过高。当需要同时协调处理输入文件与输出文件时,开发者必须编写深达四至六层的嵌套防御块,不仅阅读困难,稍有不慎还容易在 try 块外部漏掉状态检查。
三、底层原理解析:上下文管理器如何实现自动闭环
with 语句的本质是 Python 语言的一套优雅语法糖,其底层依托于上下文管理器协议(Context Manager Protocol)。任何 Python 对象只要实现了以下两个特殊魔术方法,就可以充当上下文管理器:
__enter__(self):在进入with代码块之前被调用。该方法的返回值会被赋给as关键字后面的目标变量。__exit__(self, exc_type, exc_val, exc_tb):在退出with代码块时被无条件调用。入参包含当前代码块内是否发生了异常的详细类型、实例与追踪栈。
1. 内置文件对象的上下文协议实现
Python 内置的 io.TextIOWrapper 对象天然实现了该协议。当执行 with open(...) as f: 时,Python 虚拟机内部等价于执行了如下核心逻辑:
# with 语句在 Python 解释器内部的等价语义模型
manager = open('sample.txt', 'r', encoding='utf-8')
enter_func = type(manager).__enter__
exit_func = type(manager).__exit__

f = enter_func(manager)
exc = True
try:
    try:
        data = f.read()  # 执行 with 内部的代码块
    except:
        exc = False
        if not exit_func(manager, *sys.exc_info()):
            raise  # 若 __exit__ 返回 False,正常向上抛出异常
finally:
    if exc:
        exit_func(manager, None, None, None)
2. 模拟自定义上下文管理器加深理解
为了清晰展示底层控制流程,我们可以编写一个纯 Python 类来模拟这一过程:
class ManagedFileOpener:
    def __init__(self, filename, mode, encoding='utf-8'):
        self.filename = filename
        self.mode = mode
        self.encoding = encoding
        self.file_obj = None

    def __enter__(self):
        self.file_obj = open(self.filename, self.mode, encoding=self.encoding)
        return self.file_obj  # 赋给 as 后面的变量

    def __exit__(self, exc_type, exc_val, exc_tb):
        if self.file_obj:
            self.file_obj.close()  # 无论是否报错,强制执行 close()
        # 返回 False 表示不压制内部异常,让外部调用者继续感知错误
        return False
由此可见,with 并不是隐藏了什么黑魔法,而是将异常防御的清理代码标准化、自动化地内嵌到了语言规范中,使开发者不再依赖个人的细致程度来避免资源泄露。
四、读取策略选型:四种常用方式与性能边界
在 with open 的安全保护下,读取文件数据的具体方法依然直接决定了程序的运行效率与内存消耗。以下是 Python 提供的四种主要读取手段及其适用场景:
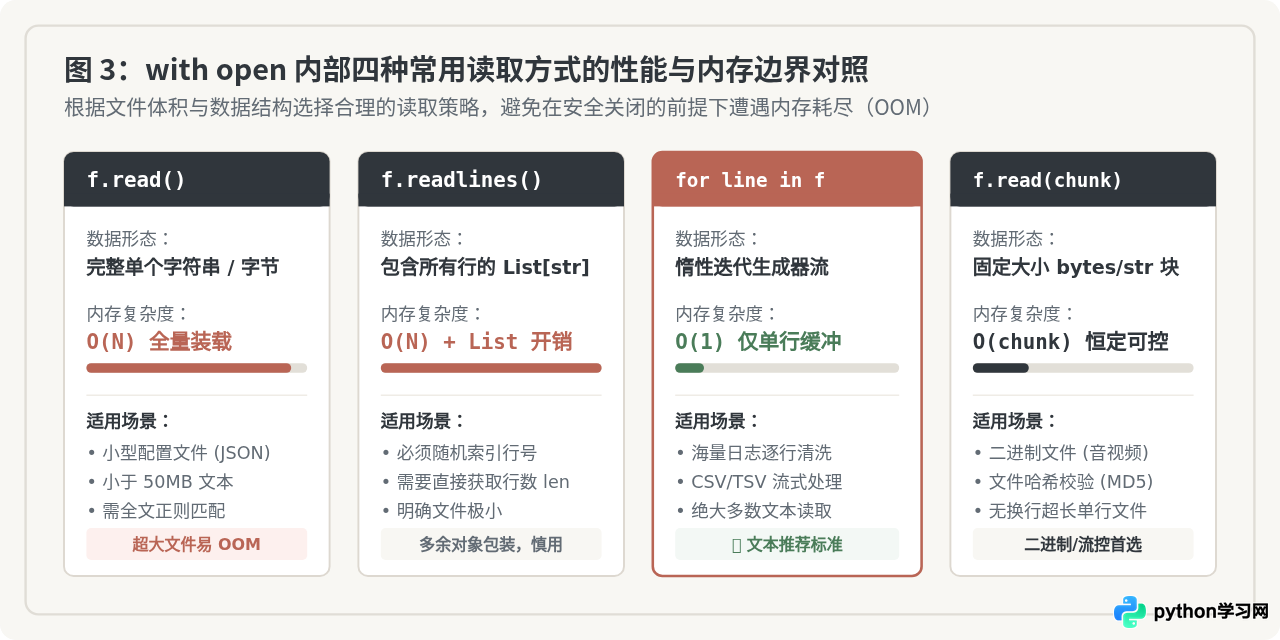
| 读取方式 | 返回类型 | 内存消耗 | 最佳适用场景 | 典型风险 |
|---|---|---|---|---|
f.read() |
str / bytes |
O(N) 全量装载 | 配置文件、小型 JSON/YAML、小模板 | 面对几十 GB 文件时瞬间引发 OOM 闪退 |
f.readlines() |
List[str] |
O(N) + 列表容器开销 | 需通过行索引随机访问的小文件 | 比 read() 额外消耗大量列表指针内存 |
for line in f |
生成器迭代(单行 str) |
O(1) 恒定开销 | 绝大多数文本文件、日志数据清洗 | 单行包含换行符,需手动 rstrip() |
f.read(chunk_size) |
分块 bytes / str |
O(chunk) 恒定可控 | 超长单行文件、二进制图像、大文件哈希校验 | 需要循环编写块结束判断逻辑 |
二进制与大文件分块读取标准写法
在处理音视频、压缩包等非文本格式,或是单行长达几百兆的异常文件时,使用 iter() 搭配辅助哨兵是兼具安全性与简洁性的标准模式:
# 二进制文件或超大文件的标准分块读取 (例如 64KB 为一分块)
CHUNK_SIZE = 65536

with open('archive.tar.gz', 'rb') as f:
    # 利用 iter(callable, sentinel) 优雅迭代,读到 b'' 时自动终止
    for chunk in iter(lambda: f.read(CHUNK_SIZE), b''):
        process_binary_chunk(chunk)
五、工程实践中的关键陷阱与防御式规范
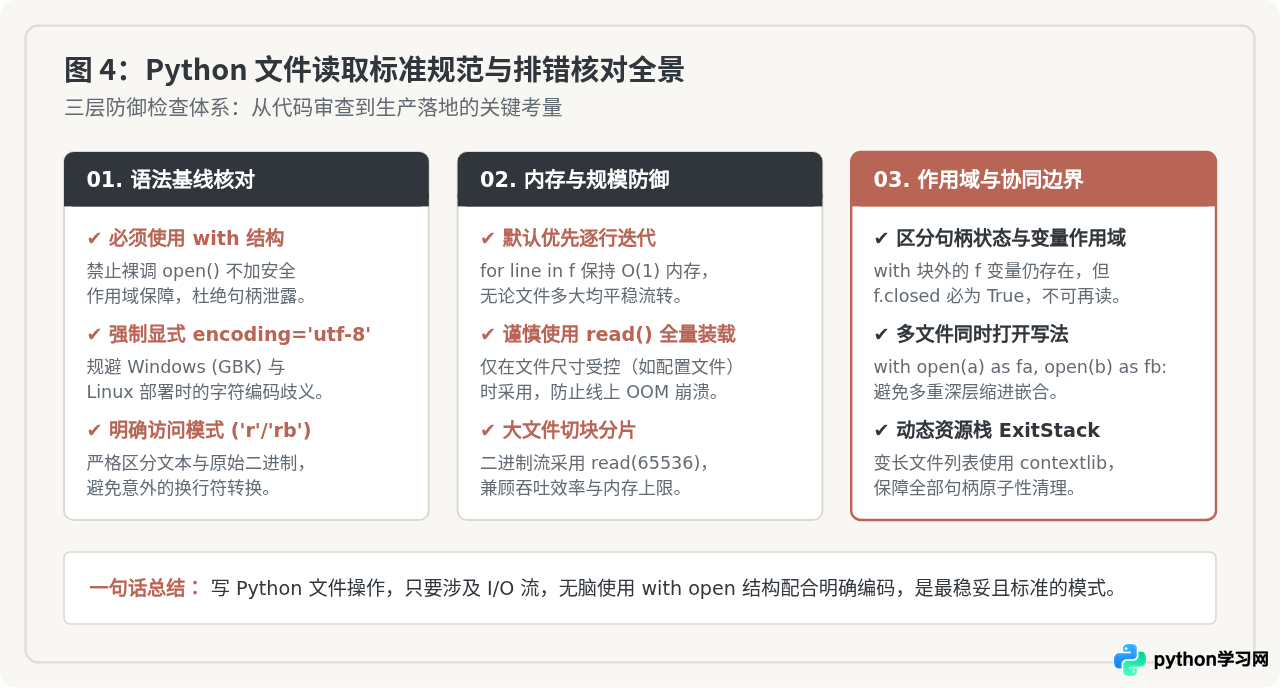
1. 陷阱一:with 块之外的文件变量依然存在,但已处于关闭状态
Python 的作用域规则与其他块级作用域语言(如 C++、Java)不同。在 Python 中,with、for、if 均不产生新的局部作用域。
with open('sample.txt', 'r', encoding='utf-8') as f:
    data = f.readline()

# 出了 with 块,变量 f 依然在命名空间中可见!
print(f.name)    # 正常输出: sample.txt
print(f.closed)  # 正常输出: True
f.read()         # 抛出 ValueError: I/O operation on closed file.
初学者常常误以为走出 with 之后变量 f 会被自动销毁。实际上被销毁的只是底层的系统文件句柄,变量名本身依旧指向已关闭的流对象。因此,绝不能在 with 作用域外部尝试对 f 继续执行 I/O 读取。
2. 陷阱二:同时操作多个文件时的标准写法
当需要从一个文件读取并写入到另一个文件时,不要层层嵌套多个 with,而可以直接使用逗号并列声明:
# 推荐写法:同一行并列管理多个上下文资源
with open('source.txt', 'r', encoding='utf-8') as src, \
     open('dest.txt', 'w', encoding='utf-8') as dst:
    for line in src:
        dst.write(line.upper())
如果待打开的文件列表是动态的(长度不固定),则应引入标准库 contextlib.ExitStack:
from contextlib import ExitStack

file_paths = ['a.txt', 'b.txt', 'c.txt']

with ExitStack() as stack:
    # 动态将多个文件纳入同一个安全清理栈中
    files = [stack.enter_context(open(p, 'r', encoding='utf-8')) for p in file_paths]
    # 全部操作完成后,ExitStack 保证按后进先出顺序统一关闭所有文件
六、总结与开发检查清单
在 Python 中,“显式优于隐式”是核心哲学之一,而 with open 恰恰是这一哲学的具象化体现。它把繁琐且极易因异常疏漏的资源清理操作交由解释器底层接管,既消除了手写 close() 的漏洞,又大幅提升了代码的简洁度与可读性。
在编写任何涉及文件操作的代码时,建议按以下三条标准自检:
- 全覆盖原则:绝对不裸写
f = open(...),所有文件 I/O 必须在with open的保护下执行。 - 编码明确原则:凡涉及文本文件读写,显式注明
encoding='utf-8',杜绝跨平台默认编码暗坑。 - 流式优先原则:面对常规文本处理,默认采用
for line in f惰性迭代,守住内存 O(1) 的性能红线。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















