


Python怎么读取txt文件的指定行内容

linecache 模块;若面对GB级别大文件,必须使用 enumerate() 配合生成器进行流式扫描并在命中后立即 break 中断;若需要读取连续的切片行段,则推荐使用 itertools.islice()。
一、底层寻址机制与选型考量
普通txt文本属于以字节序列连续存储的流式文件,每行的实际字符长度因内容而异,行与行之间仅依靠换行符(如 \n 或 \r\n)进行物理分割。这意味着计算机无法直接像数组下标寻址那样根据“第N行”直接跳转到对应的物理磁盘偏移量,必须从头逐字符扫描换行符计数,或者借助预先建立的行索引缓存。
基于这一底层约束,我们在编写Python代码时需要权衡两个核心指标:内存占用与读取效率。针对几千字节的微型文件与数吉字节的大型日志文件,读取指定行的最佳实现存在根本区别。
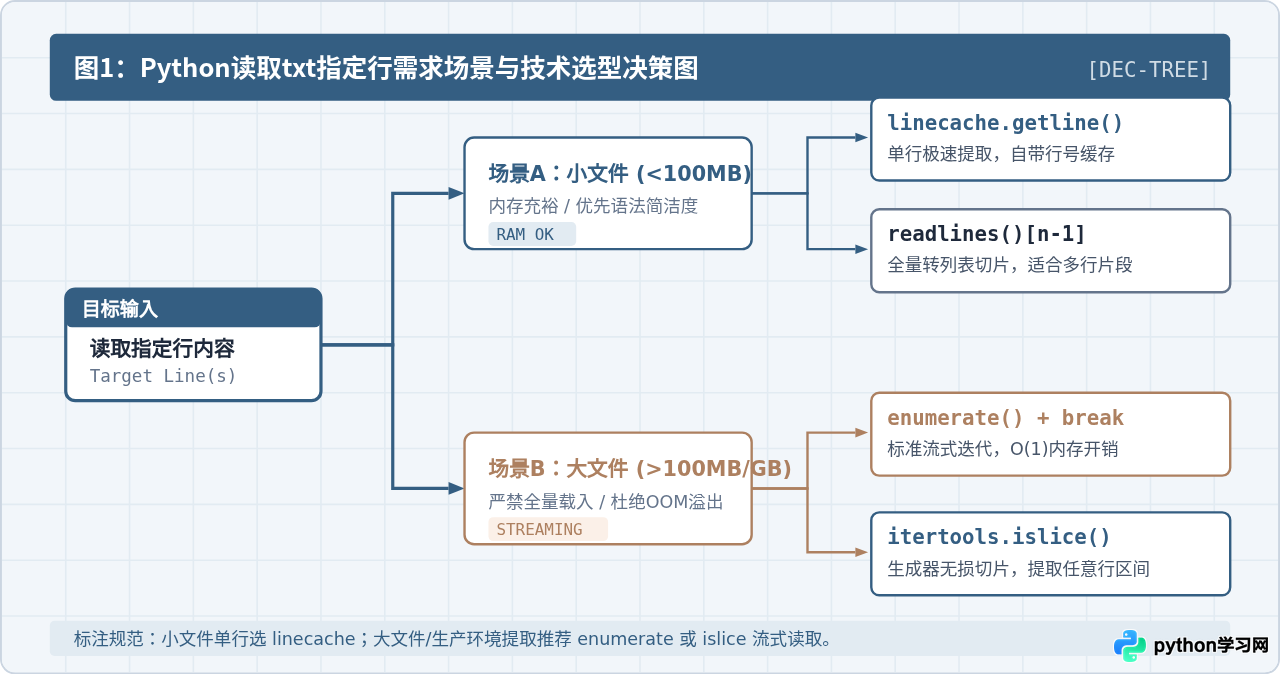
二、方法一:使用 linecache 模块(最便捷的单行读取)
Python内置的 linecache 模块专门用于从任何文件中高效读取单行内容,它是Python解释器在输出回溯追踪(Traceback)时所采用的核心工具。其最大特点是:只需一行代码,自动处理文件的打开与关闭,并自动维持内存缓存。
代码示例
import linecache

file_path = "sample.txt"
target_line_number = 5  # 读取第5行

# 直接获取第5行内容,注意:linecache的行号以1为起始基准
line_content = linecache.getline(file_path, target_line_number)

if line_content:
    print(f"读取成功: {line_content.rstrip('\r\n')}")
else:
    print("指定行不存在或为空行")
关键要点与注意事项
- 行号基数为1:与列表的0基索引不同,
linecache.getline()传入的行号从1开始,符合人类阅读文档的直觉。 - 自动容错机制:如果指定的行号超出了文件实际最大总行数,函数不会抛出
IndexError,而是直接返回空字符串''。 - 缓存陷阱与清理:
linecache在首次读取文件后会将整个文件解析并缓存在内存字典中。如果外部程序在此期间修改了该txt文件,后续调用getline()仍会返回旧内容。若需保证获取磁盘最新修改,调用前应执行linecache.checkcache(file_path)检查文件状态,或在读取完成后执行linecache.clearcache()清空缓存。
三、方法二:enumerate 配合循环遍历(大文件首选,O(1)内存)
当面对数以百万行、体积达到几百兆甚至数十吉字节的文本时,将文件全量塞入内存将造成巨大的性能压力。通过文件对象的可迭代特性,配合 enumerate(),我们可以实现逐行流式读取。在找到目标行后,使用 break 立即终止循环,确保多余的内容不会被载入内存。
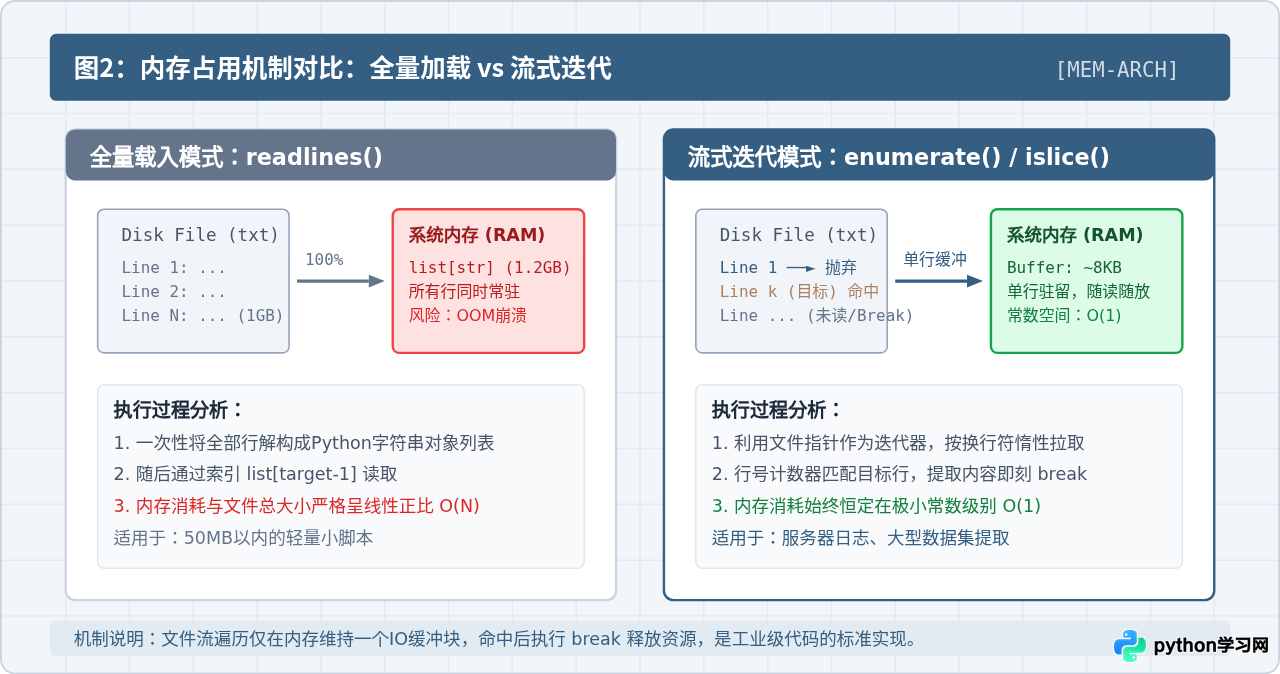
标准实现代码
def read_specific_line(file_path: str, target_lineno: int) -> str | None:
    """流式安全读取txt文件的指定行(1-based),不存在则返回 None"""
    if target_lineno < 1:
        raise ValueError("目标行号必须为正整数 (>= 1)")

    # 显式指定 utf-8 编码,避免跨操作系统默认编码(如 GBK)导致的解析错误
    with open(file_path, mode="r", encoding="utf-8") as f:
        for current_lineno, line in enumerate(f, start=1):
            if current_lineno == target_lineno:
                return line.rstrip("\r\n")  # 清除行尾换行符
            # 提前退出:如果当前行已超过目标行,无需继续向后扫描
            if current_lineno > target_lineno:
                break
    return None

# 测试用例
content = read_specific_line("data.txt", 100)
if content is not None:
    print("获取到内容:", content)
else:
print("行号超出文件总行数范围")enumerate(f, start=1) 中显式传入 start=1,可以让计数器直接对齐行号;一旦匹配成功,必须依靠 return 或 break 斩断迭代链条,阻止Python继续读完后续所有无意义的内容。
四、方法三:使用 itertools.islice 截取指定行或行区间
如果你希望代码既拥有流式读取的 O(1) 内存效率,又具备类似切片操作的优雅语法,Python标准库 itertools 中的 islice 函数是绝佳选择。
1. 提取单个指定行
from itertools import islice

file_path = "data.txt"
target_line = 42  # 欲获取第42行

with open(file_path, "r", encoding="utf-8") as f:
    # islice 遵循 0-based 规范:第42行的区间为 [41, 42)
    # next(..., None) 保证在行号越界时安全返回 None,而不触发 StopIteration
    line = next(islice(f, target_line - 1, target_line), None)

if line is not None:
    print(f"第{target_line}行内容为: {line.rstrip('\r\n')}")
else:
    print("行号超出文件总行数")
2. 提取连续行区间(例如第100行到第105行)
from itertools import islice

start_line = 100
end_line = 105

with open("data.txt", "r", encoding="utf-8") as f:
    # 截取 [99, 105) 对应的正是原文本第100行至第105行
    lines_slice = islice(f, start_line - 1, end_line)
    result = [line.rstrip("\r\n") for line in lines_slice]

print(f"提取到 {len(result)} 行内容:")
for idx, text in enumerate(result, start=start_line):
    print(f"[{idx}]: {text}")
五、操作步骤与执行流程
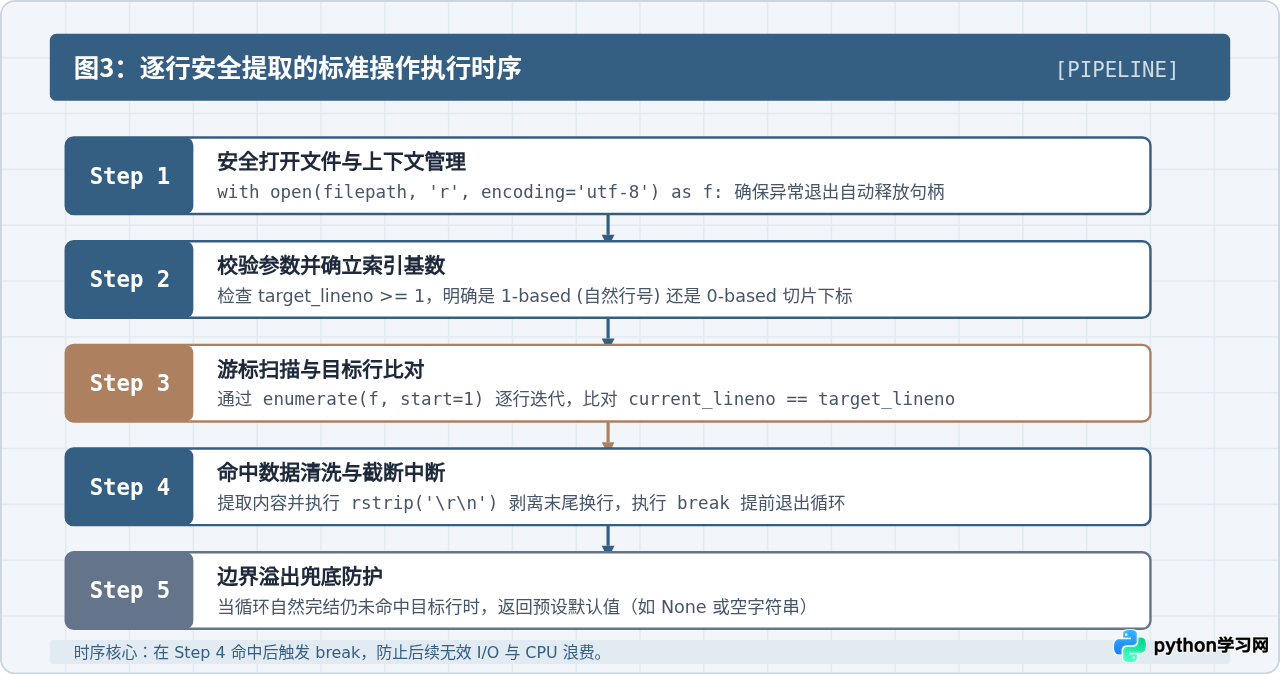
无论采用哪种具体技术,在编写生产级代码时,遵循严谨的操作流程能有效防止文件句柄泄漏、编码异常及空指针报错。整个标准操作时序可以归纳为五步。
六、方法四:readlines() 列表索引(适合小文件的直观写法)
这是初学者最容易想到的直观写法:使用 f.readlines() 将txt文件的所有行一次性读入列表,然后借助Python的列表下标直接定位。
代码示例
target_line = 3

with open("sample.txt", "r", encoding="utf-8") as f:
    all_lines = f.readlines()

# 防御性判断:确保目标行号在合法索引范围内
if 1 <= target_line <= len(all_lines):
    # 列表索引从0开始,因此第 target_line 行对应下标 target_line - 1
    content = all_lines[target_line - 1].rstrip("\r\n")
    print(f"第{target_line}行内容:", content)
else:
    print(f"行号超出范围,文件总共只有 {len(all_lines)} 行")
适用边界与缺陷
该方法仅适用于几兆字节以内的极小配置文件或测试脚本。若文件大小达到数百兆甚至几吉字节,readlines() 会将整个文本一次性加载并创建大量Python字符串对象,导致内存瞬间飙升甚至触发 MemoryError。在生产环境下,不建议将其作为常规手段。
七、常见边界问题与防御性编程
1. 区分“纯空行”与“超出总行数”
在txt文本中,一个没有任何字符的换行物理行,其读出的原始内容是 "\n"(长度为1);而当行号超出总行数时,linecache.getline() 返回的是纯空字符串 ""(长度为0)。如果直接使用 if line: 作真值判断,会把有效的内容空行误判为“文件越界不存在”。正确的做法是判断是否为 None 或直接比对字符串长度。
2. 编码格式(Encoding)陷阱
在Windows操作系统上,open() 函数在未指定编码时通常会调用本地默认的 ANSI / GBK 编码,如果待读取的txt文件包含UTF-8字符(特别是中文字符),会直接触发 UnicodeDecodeError。任何时候操作txt文本,都应显式声明 encoding="utf-8";如遇非标编码,可尝试 gb18030 兼容解析。
3. 换行符的剥离方式
Python文件对象读取出的每一行,末尾都会保留原生的换行符(Linux为 \n,Windows为 \r\n)。如果直接进行字符串比对或拼接,可能出现意外换行。建议统一使用 line.rstrip("\r\n") 仅剔除末尾换行符,而不要使用 strip(),以免误删行首或行尾原本包含的有效缩进与空格。
八、四种方案综合对比与总结
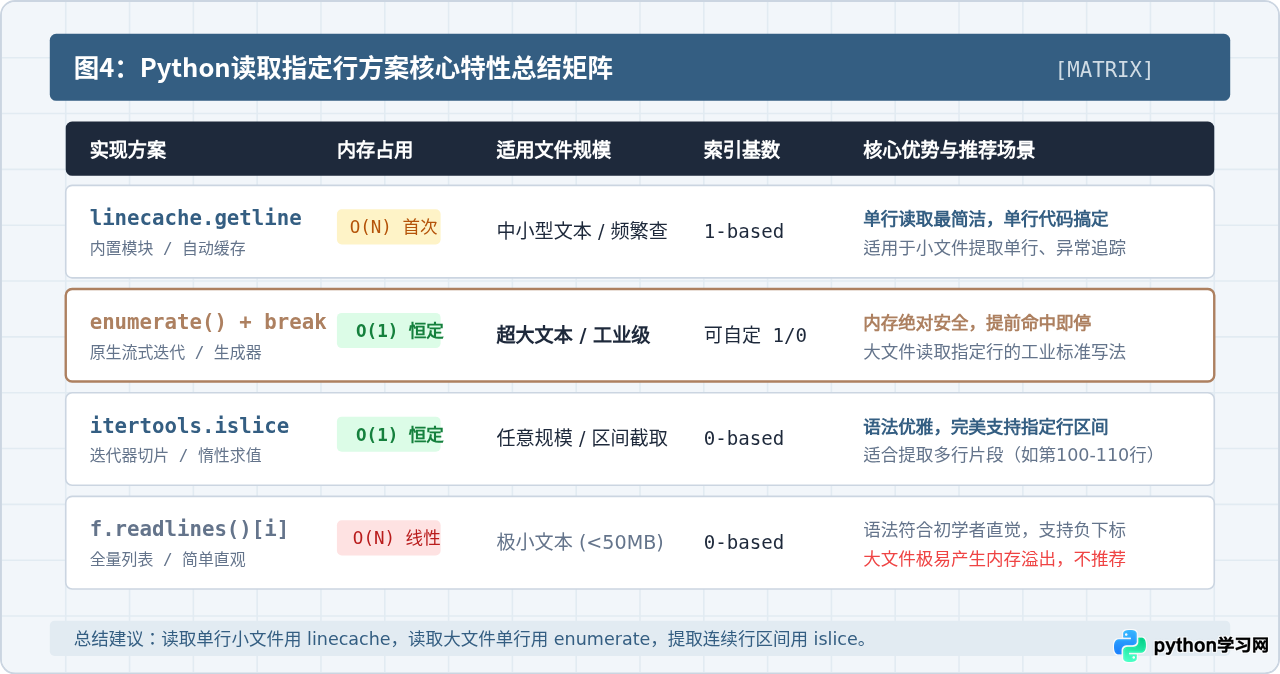
为了帮助读者根据实际工程场景快速选型,以下将四种常见方案的核心特征进行系统化对比:
最终结论
掌握Python读取txt文件指定行的关键在于理解文件迭代器与内存控制机制。在常规脚本与日常开发中,对于几十兆以内的文件直接使用 linecache.getline() 能最大化开发效率;在面对高可靠、大数据量的生产环境系统时,始终优先采用 with open(...) 搭配 enumerate() 流式扫描,在命中行内容后立刻跳出循环,以此保证系统内存的恒定与稳定。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















