


怎么使用 Python slice() 对象实现动态切片逻辑复用

在 Python 中对字符串、列表或元组进行切片时,常见的写法是直接在方括号中使用冒号表达式,例如 data[2:10:2]。当相同的切片规则需要应用到多个数据源,或者切片区间需要由配置和计算结果在运行时决定时,硬编码索引会导致逻辑分散且难以维护。Python 内置的 slice() 构造函数允许开发者将切片范围定义为一个独立的对象,使切片逻辑成为可以命名、传递、存储并在多处反复调用的“一等公民”。本文将详细说明 slice() 对象的构造原理、动态生成方式、边界计算方法以及在批量数据处理中的工程实践。
一、认识 slice() 对象与基本语法机制
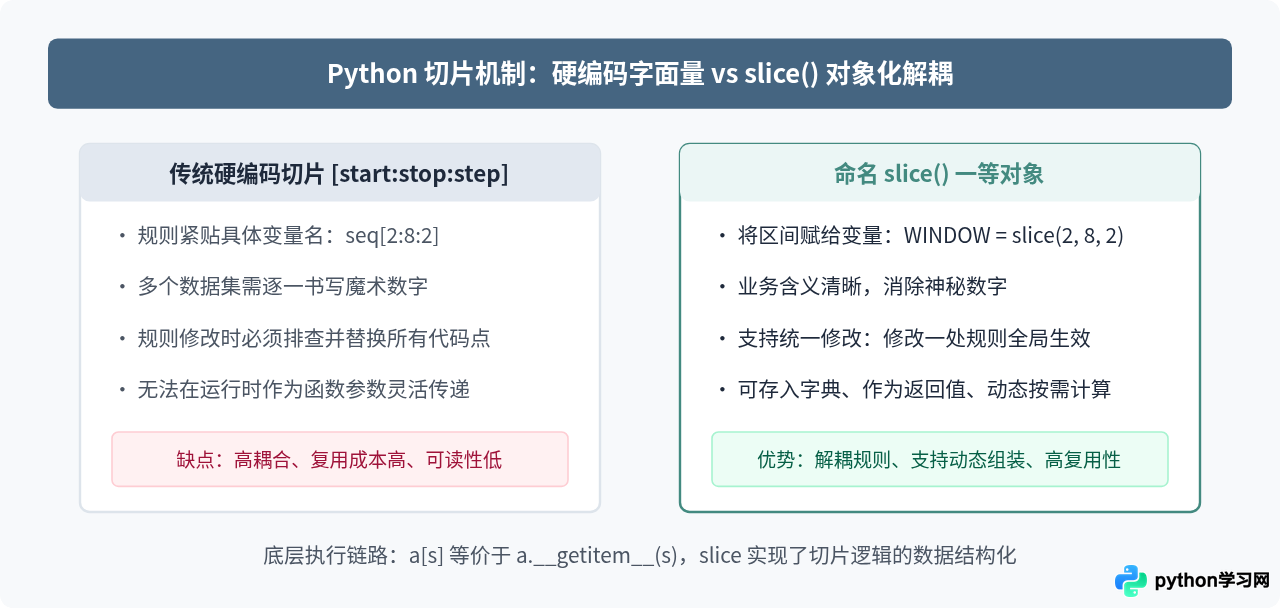
平时使用的下标切片语法 sequence[start:stop:step],在底层解释执行时实际上会被 Python 自动转换为内置的 slice 对象,并传递给序列的 __getitem__() 方法。直接调用 slice() 内置函数,就可以显式创建该对象:
# 语法形态一:仅指定结束索引(start 默认为 None,step 默认为 None)
s1 = slice(10)

# 语法形态二:指定起始与结束索引(step 默认为 None)
s2 = slice(2, 10)

# 语法形态三:完整指定起始、结束与步长
s3 = slice(2, 10, 2)

# 应用于数据序列
text = "ABCDEFGHIJKLMN"
print(text[s3]) # 示例输出: 'CEGI'与字面量切片语法相比,slice() 实例拥有三个只读属性:start、stop 和 step。它们记录了切片的原始定义参数,未显式指定的参数保留为 None。这种对象化封装将“切片规则”与“被切片的数据源”彻底解耦。
二、动态切片与逻辑复用的完整操作流程
将切片抽取为对象并用于实际系统的核心流程分为四个阶段:参数提取、对象构建、边界适配与批量切片应用。
步骤 1:明确切片逻辑并提取参数
在编写代码前,首先从外部配置、用户请求参数或协议规范中提取出起始点、终止点和步长。例如,在分页展示或数据流抽取时,入参通常为页码 page 和每页数量 page_size。
步骤 2:动态计算并实例化 slice 对象
通过工厂函数根据动态条件即时构造 slice 实例,无需将参数硬拼到列表读取语句中:
def make_pagination_slice(page_index: int, page_size: int) -> slice:
    """根据页码(从1开始)和页大小生成切片对象"""
    start = (page_index - 1) * page_size
    stop = start + page_size
    return slice(start, stop)

# 获取第 2 页切片对象
page2_slice = make_pagination_slice(page_index=2, page_size=5)
print(page2_slice)  # 示例输出: slice(5, 10, None)
步骤 3:使用 indices() 处理边界与对齐长度
在复用切片逻辑时,不同目标容器的实际长度往往各不相同。如果切片中包含负索引(例如 slice(-5, None))或终止索引超出了序列长度,slice 对象自带的 indices(length) 方法能够将相对切片参数转换为针对指定长度序列的安全三元组 (start, stop, step):
s = slice(10, 50, 2)
# 针对长度为 20 的列表进行边界计算
safe_start, safe_stop, safe_step = s.indices(20)
print(safe_start, safe_stop, safe_step)  # 示例输出: 10 20 2

# 使用计算后的安全参数可以直接驱动 range 循环
for idx in range(*s.indices(20)):
    pass  # 安全访问,绝不会发生越界异常
步骤 4:复用切片对象批量处理多序列
同一个切片对象可以直接应用在相同结构的不同数据集上,例如在数据同步管道中,同时截取表头、数据行与校验字段:
records = [
    "2026-10-21|LOGIN |USER_1001|SUCCESS",
    "2026-10-21|LOGOUT|USER_1002|SUCCESS",
    "2026-10-21|UPLOAD|USER_1001|FAIL_500"
]

# 定义复用切片
ACTION_SLICE = slice(11, 17)
USER_SLICE = slice(18, 27)

# 统一提取
actions = [row[ACTION_SLICE] for row in records]
users = [row[USER_SLICE] for row in records]

print(actions)  # 示例输出: ['LOGIN ', 'LOGOUT', 'UPLOAD']
print(users)    # 示例输出: ['USER_1001', 'USER_1002', 'USER_1001']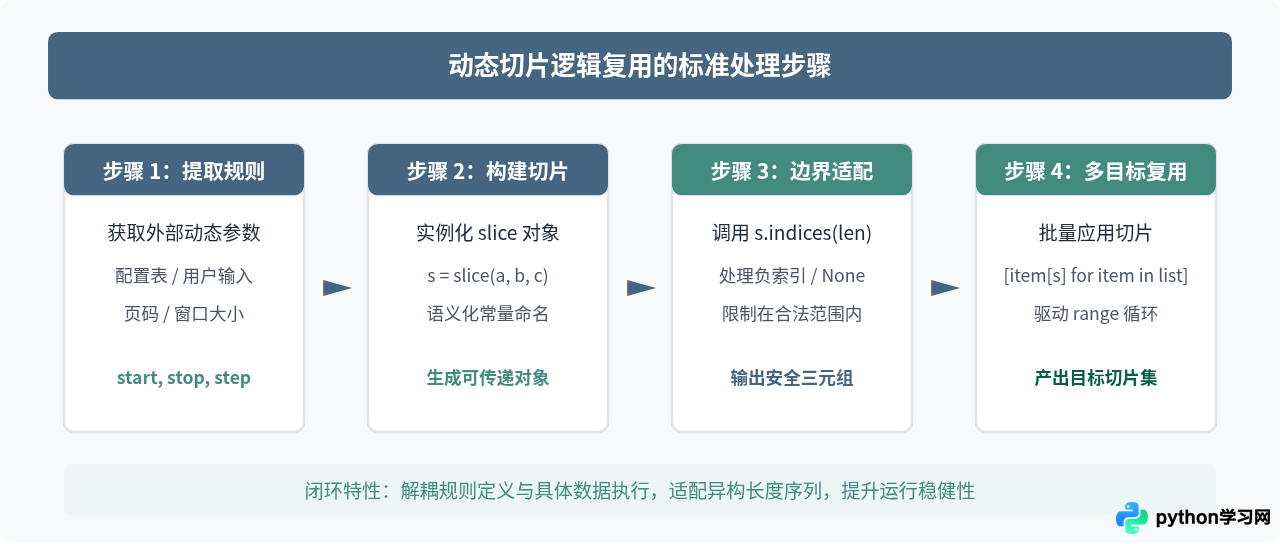
三、实战案例:定长报文解析与动态窗口复用
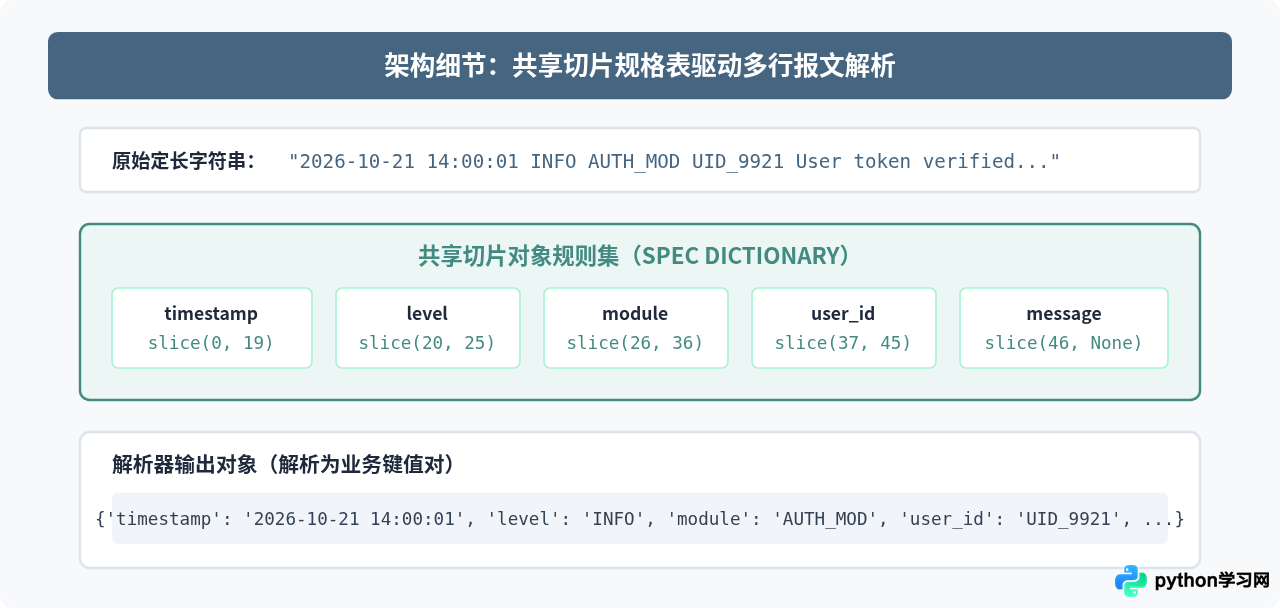
在金融通信接口、传感器原始记录或旧版系统数据导出中,定长文本格式(Fixed-width text)十分常见。每个字段的起始和结束位置严格固定。如果直接使用数字切片,代码中将充斥着意义不明的下标。借助 slice() 对象字典,能够以极其优雅的方式完成解析。
场景 1:多源定长文本批量结构化
# 1. 集中定义报文字段切片规格
LOG_SPEC = {
    "timestamp": slice(0, 19),      # 例如: '2026-10-21 14:00:00'
    "level":     slice(20, 25),     # 例如: 'INFO '
    "module":    slice(26, 36),     # 例如: 'AUTH_MOD  '
    "user_id":   slice(37, 45),     # 例如: 'UID_9921'
    "message":   slice(46, None)    # 消息内容直到行尾
}

def parse_fixed_log_line(line: str, spec: dict) -> dict:
    """使用切片字典将单行定长文本映射为结构化字典"""
    return {field: line[s].strip() for field, s in spec.items()}

# 示例数据
raw_logs = [
    "2026-10-21 14:00:01 INFO  AUTH_MOD   UID_9921 User token verified successfully",
    "2026-10-21 14:00:05 WARN  PAY_MOD    UID_1020 Payment gateway response high latency",
]

parsed_records = [parse_fixed_log_line(row, LOG_SPEC) for row in raw_logs]
print(parsed_records[0]["user_id"])  # 示例输出: 'UID_9921'
print(parsed_records[1]["module"])   # 示例输出: 'PAY_MOD'
当上游日志协议发生变动(例如 user_id 从 8 位扩展为 12 位)时,仅需更新 LOG_SPEC 字典中的 slice 对应数值,所有下游解析函数和调用链均无需变动。
场景 2:动态滑动窗口复用器
在时间序列分析中,经常需要对多组指标同时应用滑动窗口进行聚合计算。可以编写一个窗口生成器,产出动态的 slice 实例,复用到多个指标序列上:
def sliding_window_slices(total_length: int, window_size: int, step: int = 1):
    """生成滑动窗口切片对象的生成器"""
    for start in range(0, total_length - window_size + 1, step):
        yield slice(start, start + window_size)

# 模拟两个平行时间序列
cpu_usage = [45, 48, 52, 60, 58, 62, 70, 75, 72, 68]
mem_usage = [70, 71, 71, 73, 75, 78, 80, 82, 85, 83]

# 复用窗口大小为 3 的切片逻辑计算平均值
for w in sliding_window_slices(total_length=len(cpu_usage), window_size=3):
    cpu_window = cpu_usage[w]
    mem_window = mem_usage[w]
    avg_cpu = sum(cpu_window) / len(cpu_window)
    avg_mem = sum(mem_window) / len(mem_window)
    # 示例输出首个窗口: cpu_window=[45, 48, 52], mem_window=[70, 71, 71]
四、关键注意事项与避坑指南
在使用 slice() 进行切片复用时,有几个关键的技术细节必须注意:
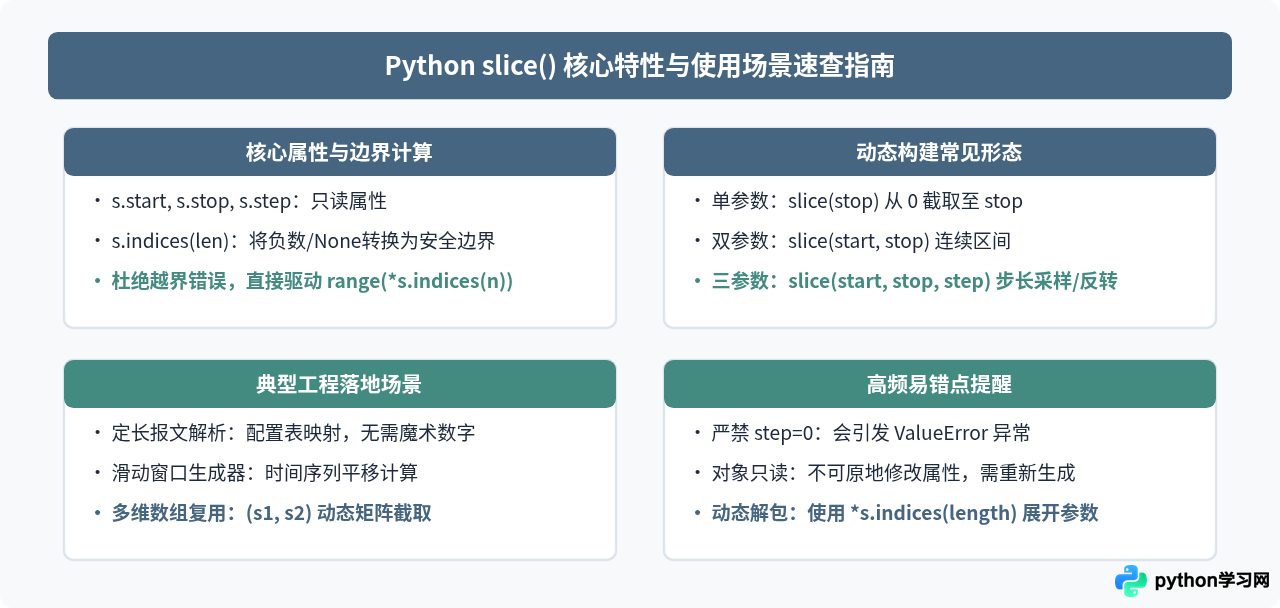
- 不可变性:
slice实例的属性是只读的。执行s.start = 5会抛出AttributeError: readonly attribute。如果需要动态调整切片位置,必须实例化一个新的slice对象。 - 步长不能为 0:在构造切片时,如果将
step设为0(如slice(1, 10, 0)),Python 会直接抛出ValueError: slice step cannot be zero。 - 多维索引传递:在 NumPy 或 Pandas 等科学计算库中,矩阵的多维切片形如
arr[0:5, 2:8]。在底层这实际上是一个包含两个 slice 对象的元组:arr[(slice(0, 5), slice(2, 8))]。因此,可以自由构造包含多个切片对象的元组以实现多维切片逻辑复用。 - 省略与 None 的等价性:在切片语法中留空(如
[:5]或[2:]),与在slice()中传入None完全等价。例如slice(None, 5)等价于[:5]。
五、总结
使用 Python 内置的 slice() 对象,本质上是将过程式的索引截取逻辑转化为声明式的数据规则。通过赋予切片有意义的命名、在运行时结合业务参数动态生成切片,并利用 indices() 方法实现跨序列长度的边界自适应,开发者能够大幅减少重复代码、消除代码库中的魔术数字,让数据截取与文本解析系统更加健壮、易读和易于维护。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















