


使用Python Playwright实现无头模式批量Web自动化测试

在开展大规模网站功能巡检、接口页面状态验证或批量UI回归测试时,传统逐一打开有头浏览器的测试方式不仅消耗大量内存与CPU,而且执行速度缓慢。使用Python结合Playwright的无头模式(Headless Mode),配合异步事件循环(asyncio)与上下文隔离机制(BrowserContext),能够在单台机器上以极低的系统开销实现数十甚至上百个测试任务的高并发并行执行,彻底解决批量测试的性能瓶颈与状态污染问题。
一、为什么选择Playwright无头模式进行批量测试
在批量Web测试场景中,测试执行的吞吐量与稳定性取决于三大核心因素:浏览器启动开销、任务之间的状态隔离以及并发调度效率。
- 开销极低的无头模式:无头模式意味着浏览器在后台运行,不渲染实际的GUI窗口。这免去了操作系统绘制图形界面的高昂开销,将系统资源集中在DOM解析、网络请求和JavaScript脚本执行上。
- 轻量级上下文隔离(BrowserContext):传统的自动化方案(如早期Selenium常规用法)为了保证测试用例之间不产生Cookie或Session污染,往往需要频繁启动和销毁浏览器进程,进程启停开销高达数秒。而Playwright支持在单个浏览器进程内部瞬间创建完全独立的
BrowserContext,各上下文拥有独立的Cookie、本地存储和缓存,创建与销毁耗时仅需数十毫秒。 - 原生异步并发支持:Playwright原生提供了
async_api,可以与Python的asyncio事件循环天然融合,轻松利用信号量(asyncio.Semaphore)精确控制并发数量,防止测试流量打垮服务器或耗尽本地文件句柄。
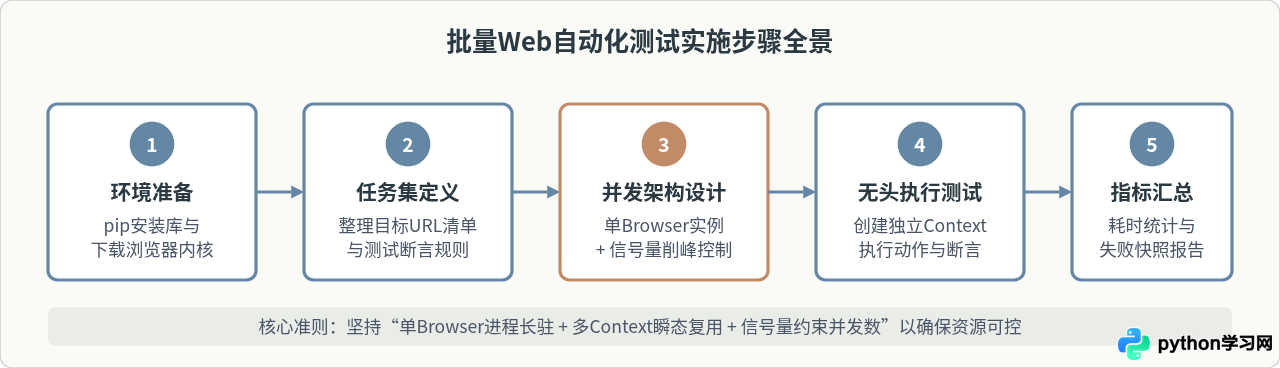
二、环境安装与基础准备
在开始编写测试脚本前,需要安装Playwright的Python依赖包,并下载其专用的无头浏览器内核(如Chromium)。
# 1. 安装 Playwright Python 库
pip install playwright

# 2. 安装无头浏览器驱动(批量测试推荐仅安装轻量快速的 chromium)
playwright install chromiumplaywright install-deps chromium 命令自动安装底层Linux依赖包。
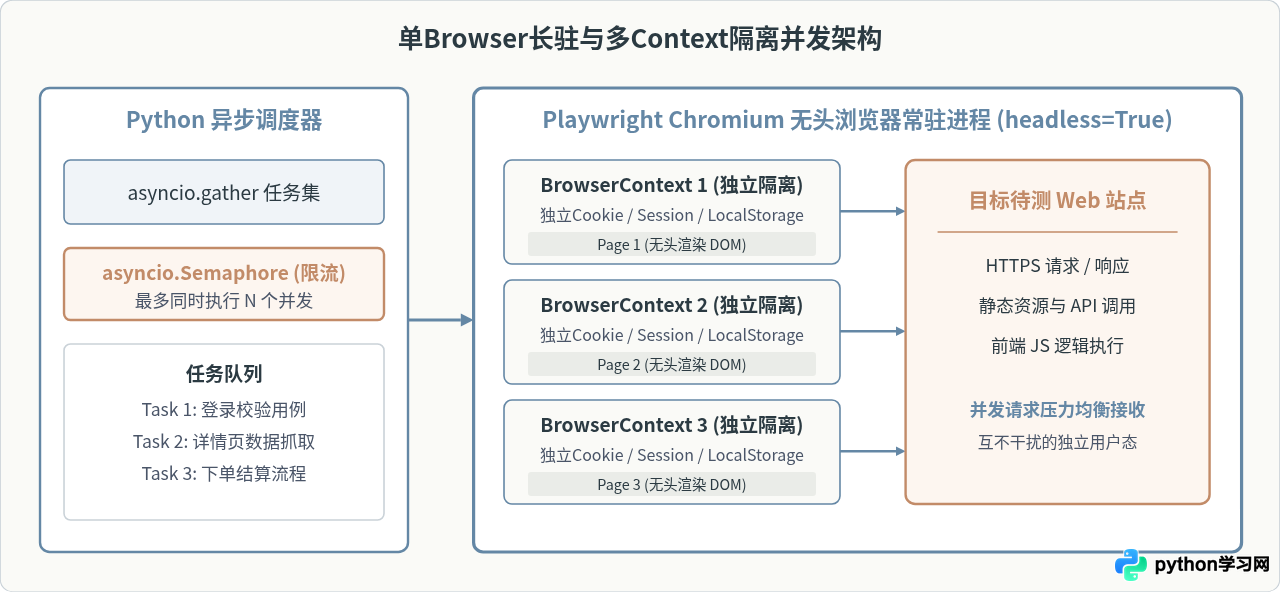
三、单浏览器多上下文并发架构模型
很多初学者在编写批量自动化测试时,容易在每个测试用例中都调用一次 p.chromium.launch()。在批量执行100个测试用例时,这意味着启动了100次浏览器进程,会造成系统频繁发生进程切换、CPU飙高,甚至内存溢出崩溃。
正确的架构方案是:全局仅启动一个无头浏览器实例(Browser),通过 browser.new_context() 为每个用例分配隔离的会话空间。
四、批量自动化测试完整代码实战
下面是一个标准的批量Web自动化测试脚本。脚本从预定义的测试用例清单读取URL和预期断言,使用 asyncio.Semaphore 设定并发槽位为5,并在每个测试任务中创建独立的无头上下文。用例包含页面加载、断言验证、响应耗时记录以及异常保护机制。
import asyncio
import time
from dataclasses import dataclass
from typing import List, Optional
from playwright.async_api import async_playwright, Browser, BrowserContext

# 1. 定义测试用例数据模型
@dataclass
class TestCase:
    id: str
    url: str
    expected_title_keyword: str

# 2. 定义测试结果模型
@dataclass
class TestResult:
    case_id: str
    url: str
    status: str       # "PASSED" 或 "FAILED"
    duration_ms: float
    error_msg: Optional[str] = None

# 3. 单个测试任务的执行函数
async def run_single_test(case: TestCase, browser: Browser, semaphore: asyncio.Semaphore) -> TestResult:
    async with semaphore:
        start_time = time.perf_counter()
        # 为当前用例创建完全独立的无头上下文
        context: BrowserContext = await browser.new_context(
            viewport={"width": 1280, "height": 800},
            user_agent="Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/120.0.0.0 Safari/537.36"
        )
        page = await context.new_page()

        try:
            # 导航并等待 DOM 加载完成,设定 15 秒超时
            await page.goto(case.url, wait_until="domcontentloaded", timeout=15000)

            # 获取页面标题并执行断言
            actual_title = await page.title()
            if case.expected_title_keyword not in actual_title:
                raise AssertionError(f"标题校验失败: 预期包含 '{case.expected_title_keyword}', 实际为 '{actual_title}'")

            duration = (time.perf_counter() - start_time) * 1000
            return TestResult(case_id=case.id, url=case.url, status="PASSED", duration_ms=round(duration, 2))

        except Exception as e:
            duration = (time.perf_counter() - start_time) * 1000
            # 测试失败时可保存现场截图,供排查回溯
            try:
                await page.screenshot(path=f"screenshot_failed_{case.id}.png")
            except Exception:
                pass
            return TestResult(
                case_id=case.id,
                url=case.url,
                status="FAILED",
                duration_ms=round(duration, 2),
                error_msg=str(e)
            )
        finally:
            # 务必显式关闭上下文,释放内存与连接句柄
            await context.close()

# 4. 批量测试调度主函数
async def main_batch_runner():
    # 构造批量测试用例集(示例提供5个用例)
    test_cases = [
        TestCase(id="TC_01", url="https://httpbin.org/get", expected_title_keyword=""),
        TestCase(id="TC_02", url="https://example.com", expected_title_keyword="Example Domain"),
        TestCase(id="TC_03", url="https://httpbin.org/html", expected_title_keyword="Herman Melville"),
        TestCase(id="TC_04", url="https://httpbin.org/status/200", expected_title_keyword=""),
        TestCase(id="TC_05", url="https://example.com", expected_title_keyword="Example Domain"),
    ]

    # 设置最大并发测试数为 3
    CONCURRENCY_LIMIT = 3
    semaphore = asyncio.Semaphore(CONCURRENCY_LIMIT)

    async with async_playwright() as p:
        # 启动单个无头 Chromium 进程
        browser = await p.chromium.launch(
            headless=True,
            args=["--no-sandbox", "--disable-dev-shm-usage"] # 容器及无头环境优化参数
        )
        print(f"=== 开始执行批量自动化测试,用例数: {len(test_cases)},并发限制: {CONCURRENCY_LIMIT} ===")

        # 并发派发所有任务
        tasks = [run_single_test(case, browser, semaphore) for case in test_cases]
        results: List[TestResult] = await asyncio.gather(*tasks)

        # 关闭全局浏览器进程
        await browser.close()

    # 5. 打印测试报告统计
    passed_count = sum(1 for r in results if r.status == "PASSED")
    failed_count = len(results) - passed_count
    total_time = sum(r.duration_ms for r in results)

    print("\n================ 测试执行报告 ================")
    for r in results:
        status_flag = "[✓ PASS]" if r.status == "PASSED" else "[✗ FAIL]"
        print(f"{status_flag} 用例 {r.case_id} | 耗时: {r.duration_ms}ms | URL: {r.url}")
        if r.error_msg:
            print(f"       错误详情: {r.error_msg}")

    print("---------------------------------------------")
    print(f"总用例数: {len(results)} | 通过: {passed_count} | 失败: {failed_count}")
    print(f"累计耗时总计: {round(total_time, 2)}ms")

if __name__ == "__main__":
    asyncio.run(main_batch_runner())
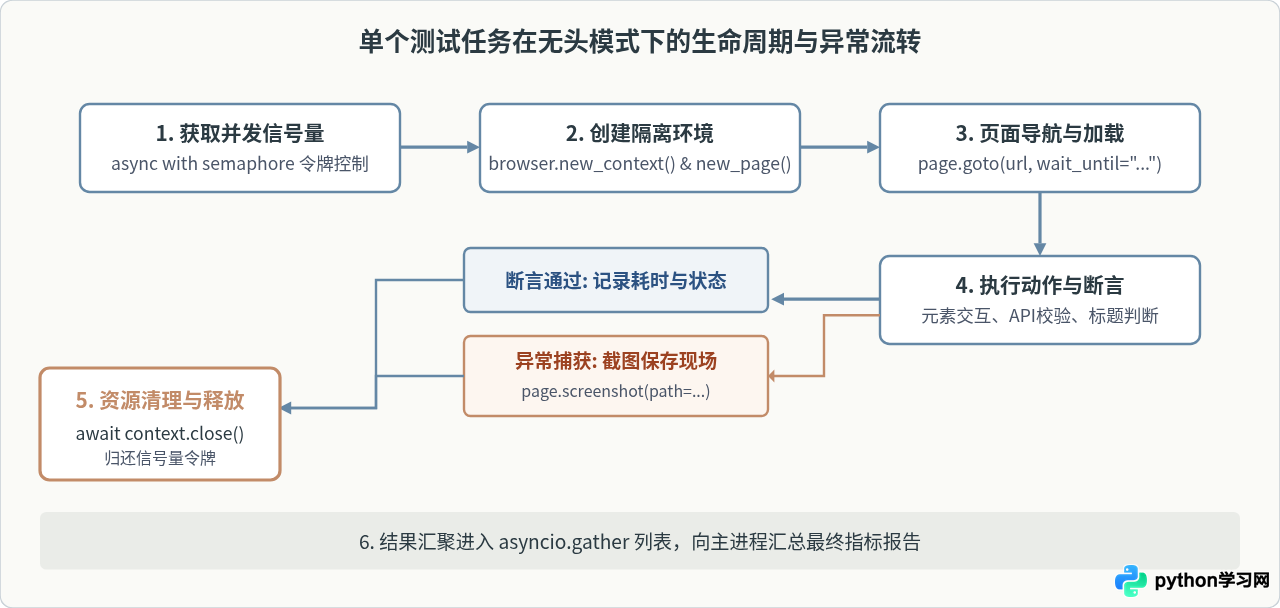
五、单个测试任务的完整生命周期
在批量高并发执行过程中,每一个测试任务都应当严格经历闭环的生命周期。任何未关闭的 Page 或 BrowserContext 都会成为悬挂句柄,随着测试用例数量的增加导致内存泄露。
六、批量无头测试的生产环境避坑指南
在实际的大规模批量测试中,网络波动、目标服务反爬、第三方脚本阻塞等问题极为常见。以下是保障批量测试稳定性的关键策略:
1. 合理配置等待策略,避免默认超时拖垮整体进度
Playwright 默认的 wait_until 策略是 "load",需要等待页面上的所有样式表、图片及外部分析打点脚本完全下载才算完成。很多网站包含慢速分析打点,这会导致测试用例长时间悬停在等待状态。批量测试推荐设置为 "domcontentloaded"(DOM解析完毕即进入测试)或配合明确的元素定位器 page.locator(...).wait_for(),同时显式指定 10~15 秒的超时时间。
2. 规避无头模式特征检测(Headless Detection)
部分站点会通过检测 navigator.webdriver 属性或默认 User-Agent 来拦截无头测试流量。可以通过在创建 Context 时伪装标准的浏览器 User-Agent,并在启动参数中增加必要参数(如设置常规分辨率、语言等),以确保被测网站正常响应。
3. 善用路由过滤(Route Abort)加速批量执行
如果当前测试仅关注页面核心逻辑或文本断言,可以通过 page.route() 拦截并丢弃诸如 .png、.jpg、.css 或 Google Analytics 等无关静态资源的请求。这样不仅能将网络带宽占用降低 70% 以上,还能使单个页面的加载速度提升 2~3 倍。
asyncio.Semaphore 设定在 12~16 左右即可达到吞吐量峰值;过高的并发会导致 CPU 上下文切换频繁,反而拉长整体耗时。
七、总结与最佳实践对照
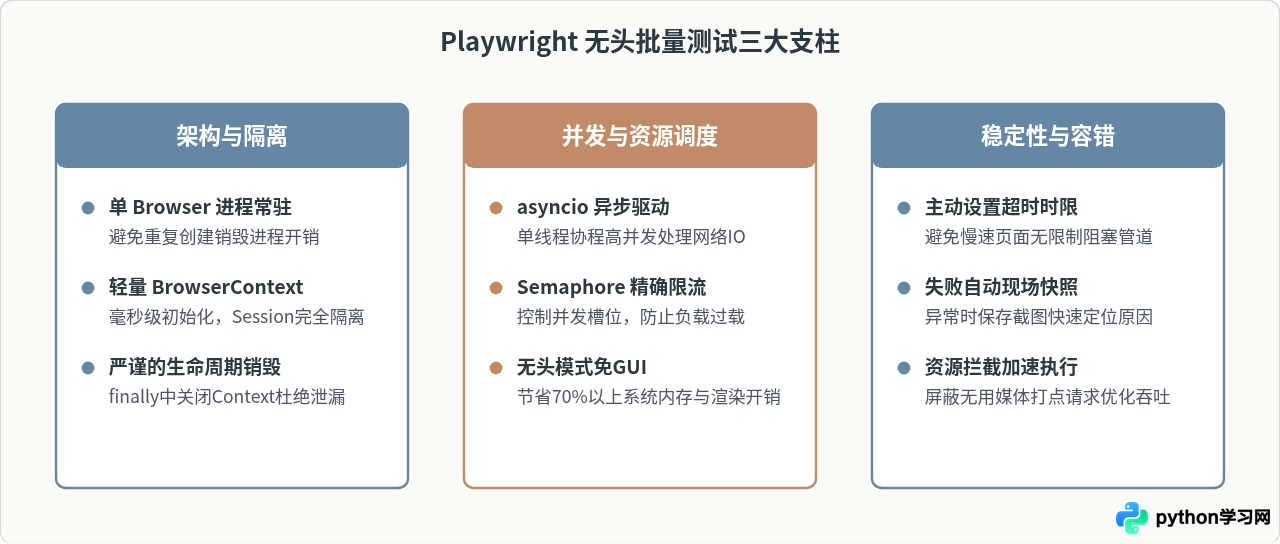
通过使用 Python 的 asyncio 协程驱动 Playwright 无头模式,并严格遵循“单一浏览器实例下多上下文隔离”的原则,可以构建出高效、稳定且资源友好的批量 Web 测试框架。无论是在日常定时巡检还是发版前的自动化验收中,这种模式都能够成倍压缩回归测试周期。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















