


Python连接SQLite数据库:sqlite3模块基础用法

Python 内置了标准数据库接口模块 sqlite3,开发者无需安装独立的数据库服务器进程,也不需要使用第三方依赖包,直接调用标准库即可在本地单文件或内存中构建可靠的关系型数据库。本文系统梳理从建立连接、游标操作、执行数据表定义与增删改查,到参数化防注入、事务提交与结果集映射的完整基础流程。
一、SQLite 的嵌入式架构与连接机制
与 MySQL、PostgreSQL 等典型客户端/服务端(C/S)架构数据库不同,SQLite 是一款“嵌入式”关系型数据库引擎。它不需要监听网络端口,也不需要以系统守护进程的形式常驻后台。当我们在 Python 程序中引入 sqlite3 模块时,SQLite 引擎的代码是直接链接并运行在当前 Python 进程内的,数据库的读写实际上是对单个磁盘文件或进程私有内存区域的直接 I/O 操作。
在 Python 中建立 SQLite 连接非常直接,主要分为两种存储模式:基于磁盘的文件数据库和基于 RAM 的临时内存数据库。
import sqlite3

# 1. 连接到本地文件数据库(若文件不存在,sqlite3 会在当前路径自动创建)
conn_file = sqlite3.connect("app_data.db")

# 2. 连接到内存数据库(进程退出后数据立即销毁,适合单元测试和临时计算)
conn_mem = sqlite3.connect(":memory:")

# 操作完成后需显式关闭连接释放文件锁与内存资源
conn_file.close()
conn_mem.close()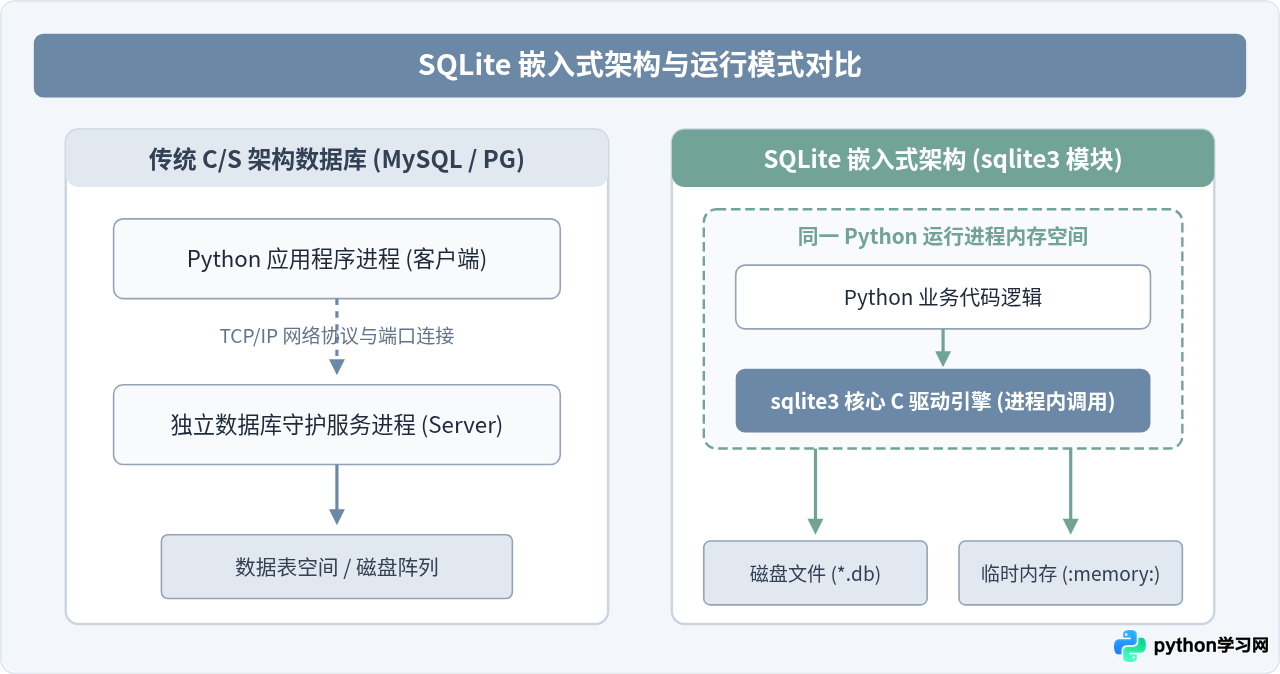
图 1:传统网络数据库与 SQLite 嵌入式架构工作机制对比
二、标准操作生命周期:从连接到游标执行
与关系型数据库交互遵循一套标准的生命周期:连接对象负责维护通信链路与事务状态,而所有的 SQL 语句执行与结果检索,均由“游标(Cursor)”对象来承担。
一个完整的操作流程包括五个核心步骤:
- 建立连接:通过
sqlite3.connect()获取数据库连接对象conn。 - 创建游标:通过
conn.cursor()创建操作句柄cursor。 - 执行 SQL 指令:调用
cursor.execute()运行 DDL(定义表)或 DML(读写数据)。 - 管理事务与获取数据:对于修改类操作调用
conn.commit()进行事务确认;对于查询类操作调用获取方法读取数据。 - 有序关闭资源:完成操作后按顺序关闭
cursor与conn。
import sqlite3

# 1. 建立连接
conn = sqlite3.connect("company.db")

# 2. 创建游标
cursor = conn.cursor()

# 3. 执行数据表创建(DDL 语句)
create_table_sql = """
CREATE TABLE IF NOT EXISTS employees (
    id INTEGER PRIMARY KEY AUTOINCREMENT,
    name TEXT NOT NULL,
    department TEXT NOT NULL,
    salary REAL DEFAULT 0.0
);
"""
cursor.execute(create_table_sql)

# 4. 提交事务(建表等 DDL 语句通常会自动隐式生效,但显式调用保持规范)
conn.commit()

# 5. 关闭游标与连接
cursor.close()
conn.close()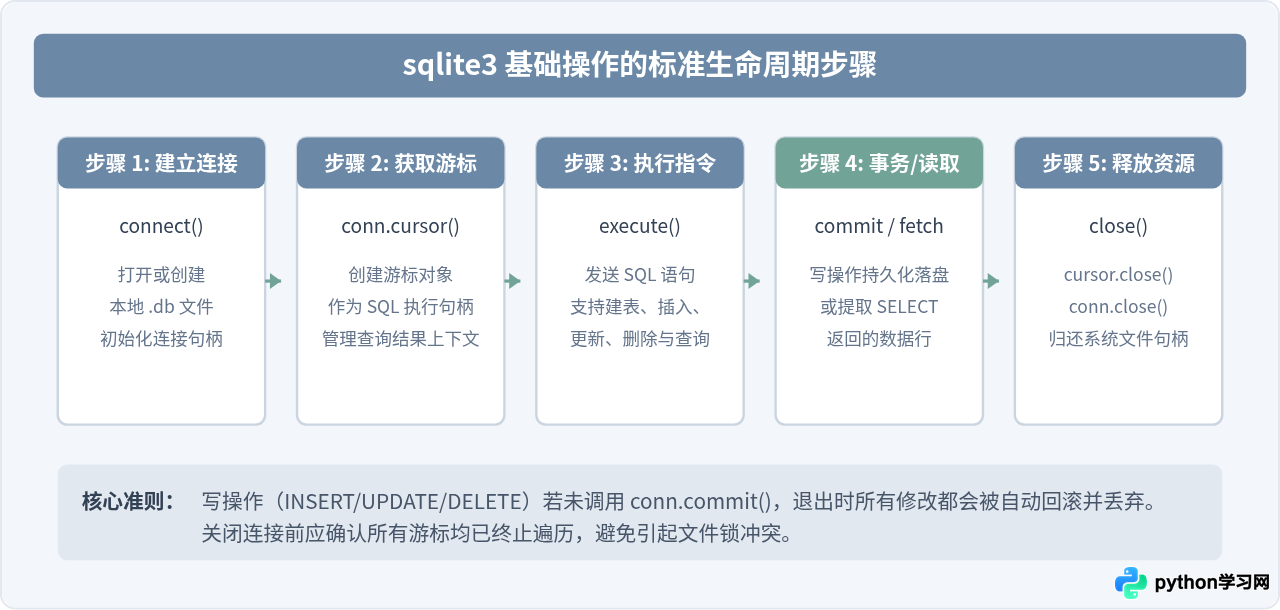
图 2:Python sqlite3 模块基础操作的生命周期与阶段任务
三、数据增删改与参数化安全防注入
向数据库写入数据时,最关键的安全准则是禁止拼接 SQL 字符串。许多初学者习惯使用 Python 的 f-string、% 或 format() 拼接 SQL 语句,例如:
# 错误示例:存在严重 SQL 注入漏洞与引号转义风险
name = "Alice"
cursor.execute(f"INSERT INTO employees (name) VALUES ('{name}')")
如果传入的变量包含单引号或恶意 SQL 代码(例如 Alice'; DROP TABLE employees; --),整个 SQL 语义会被直接篡改。正确的做法是使用占位符 ?,将参数以元组(tuple)的形式作为第二个参数传入。
1. 单条记录插入与参数占位符
import sqlite3

conn = sqlite3.connect("company.db")
cursor = conn.cursor()

# 使用问号 ? 作为参数占位符
sql = "INSERT INTO employees (name, department, salary) VALUES (?, ?, ?)"
data = ("张伟", "研发部", 12500.0)

cursor.execute(sql, data)

# 显式提交事务,确保写入落盘
conn.commit()

# 查看刚刚自增生成的主键 ID
print("新增记录 ID:", cursor.lastrowid)

cursor.close()
conn.close()
2. 批量记录插入(executemany)
如果需要一次性写入多条记录,循环调用 cursor.execute() 会产生频繁的语法解析与事务开销。sqlite3 提供了 executemany() 方法,能在单次调用中批量执行:
employees_list = [
    ("李娜", "财务部", 9800.0),
    ("王强", "市场部", 10500.0),
    ("刘洋", "研发部", 13200.0),
]

# 一次性批量写入多条数据
cursor.executemany(
    "INSERT INTO employees (name, department, salary) VALUES (?, ?, ?)",
    employees_list
)
conn.commit()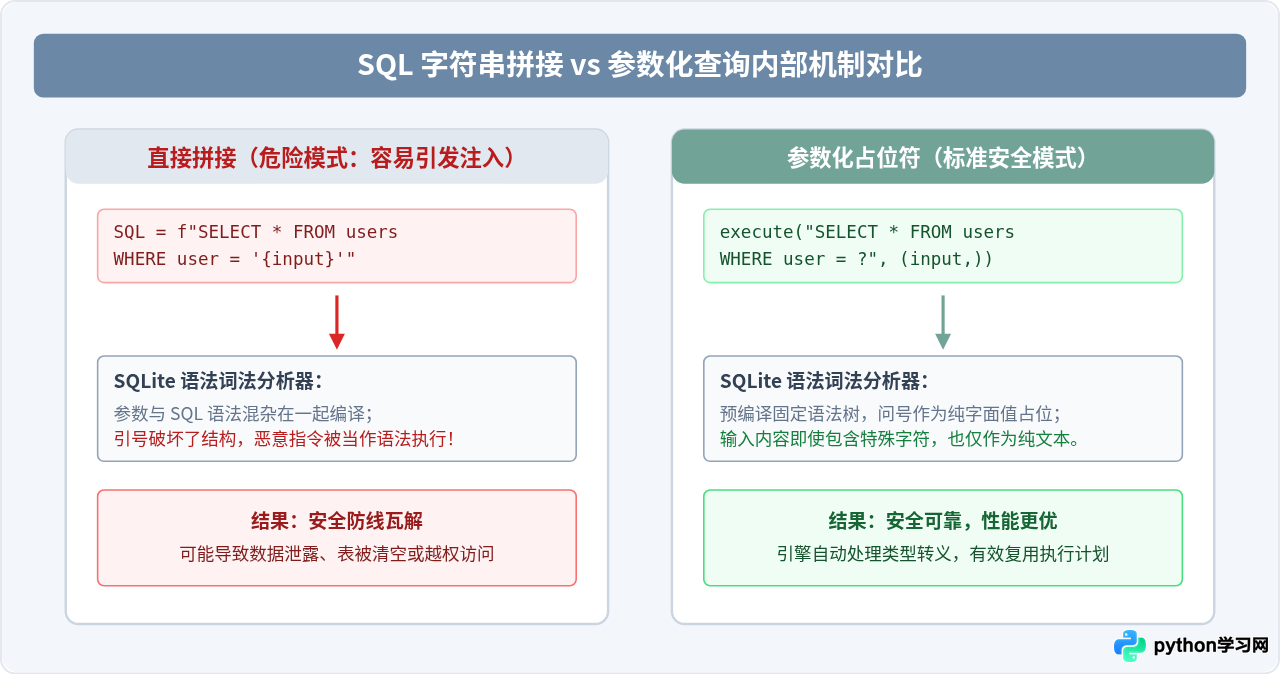
图 3:SQL 拼接漏洞与参数化编译保护机制
四、数据查询与结果获取方式
执行 SELECT 查询时,游标充当了检索结果的迭代器。sqlite3 提供了三种常用的提取方法,并支持直接对游标进行遍历。
1. 常用提取方法对比
| 获取方法 | 返回格式 | 适用场景 | 耗尽时的行为 |
|---|---|---|---|
cursor.fetchone() |
单个元组 (col1, col2) |
主键查询、聚合统计(如 COUNT)或只需单条数据 | 若无数据返回 None |
cursor.fetchall() |
包含所有结果元组的列表 | 数据量可控的小型数据集 | 若无数据返回空列表 [] |
cursor.fetchmany(size) |
指定最大条数元组的列表 | 分页读取、分批流式处理中型数据 | 若无剩余数据返回 [] |
for row in cursor: |
按行产生元组生成器 | 大型数据集逐行读取,内存占用极低 | 自然结束循环 |
import sqlite3

conn = sqlite3.connect("company.db")
cursor = conn.cursor()

# 查询研发部所有员工
cursor.execute("SELECT id, name, salary FROM employees WHERE department = ?", ("研发部",))

# 方式一:逐行遍历游标(推荐,避免大结果集撑爆内存)
print("--- 逐行读取 ---")
for row in cursor:
    print(f"工号: {row[0]}, 姓名: {row[1]}, 薪资: {row[2]}")

# 重新执行以重置游标指针
cursor.execute("SELECT COUNT(*) FROM employees")
total_count = cursor.fetchone()[0]
print("员工总数:", total_count)

cursor.close()
conn.close()
2. 提升可读性:使用 sqlite3.Row 字典式访问
默认情况下,每一行数据都以 Python 元组 (val1, val2, ...) 返回。如果数据列较多,必须记住每个字段的下标位置,代码极易出错且不易维护。通过配置连接对象的 row_factory = sqlite3.Row,可以使返回的行对象同时支持下标访问与基于列名的字典式访问:
import sqlite3

conn = sqlite3.connect("company.db")

# 设置结果行为 sqlite3.Row 映射对象
conn.row_factory = sqlite3.Row

cursor = conn.cursor()
cursor.execute("SELECT id, name, department, salary FROM employees WHERE id = ?", (1,))
row = cursor.fetchone()

if row:
    # 既可以通过列名访问,也可以通过下标访问
    print("员工姓名:", row["name"])
    print("所属部门:", row["department"])
    print("列名列表:", row.keys())

cursor.close()
conn.close()
五、事务控制、异常捕获与上下文管理
在默认模式下,sqlite3 会在执行 DML(如 INSERT、UPDATE、DELETE)之前自动开启一个事务。如果在后续操作中发生异常而未显式提交,对数据的修改将在连接关闭时全部丢失。
1. 稳健的 try-except-finally 模式
为了确保程序健壮性,通常需要捕获 sqlite3.Error 并在异常发生时主动调用 conn.rollback() 回滚未完成的修改:
import sqlite3

conn = sqlite3.connect("company.db")
cursor = conn.cursor()

try:
    cursor.execute("UPDATE employees SET salary = salary + 1000 WHERE department = ?", ("研发部",))
    # 模拟业务验证逻辑
    cursor.execute("UPDATE employees SET salary = salary - 1000 WHERE department = ?", ("市场部",))

    # 全部成功才提交
    conn.commit()
    print("薪资调整事务提交成功")
except sqlite3.Error as e:
    # 发生异常,回滚全部操作
    conn.rollback()
    print("事务执行失败,已全部回滚:", e)
finally:
    cursor.close()
    conn.close()
2. 使用 with 管理事务
连接对象 conn 自身实现了上下文管理器协议。使用 with conn: 时,如果代码块无异常退出,系统会自动执行 commit();若中途抛出异常,则自动执行 rollback()。
with conn: 只负责事务的自动提交与回滚,并不会自动关闭数据库连接。因此在退出作用域后,仍需调用 conn.close(),或者在外层嵌套标准资源管理逻辑。
import sqlite3

conn = sqlite3.connect("company.db")

try:
    # with conn 管理事务的自动提交与异常回滚
    with conn:
        conn.execute("INSERT INTO employees (name, department, salary) VALUES (?, ?, ?)", ("赵敏", "行政部", 8500.0))
        # 若在此处发生异常,上面的插入操作会自动回滚
    print("数据写入完成且已自动提交")
finally:
    conn.close()
六、总结与核心用法全景速查
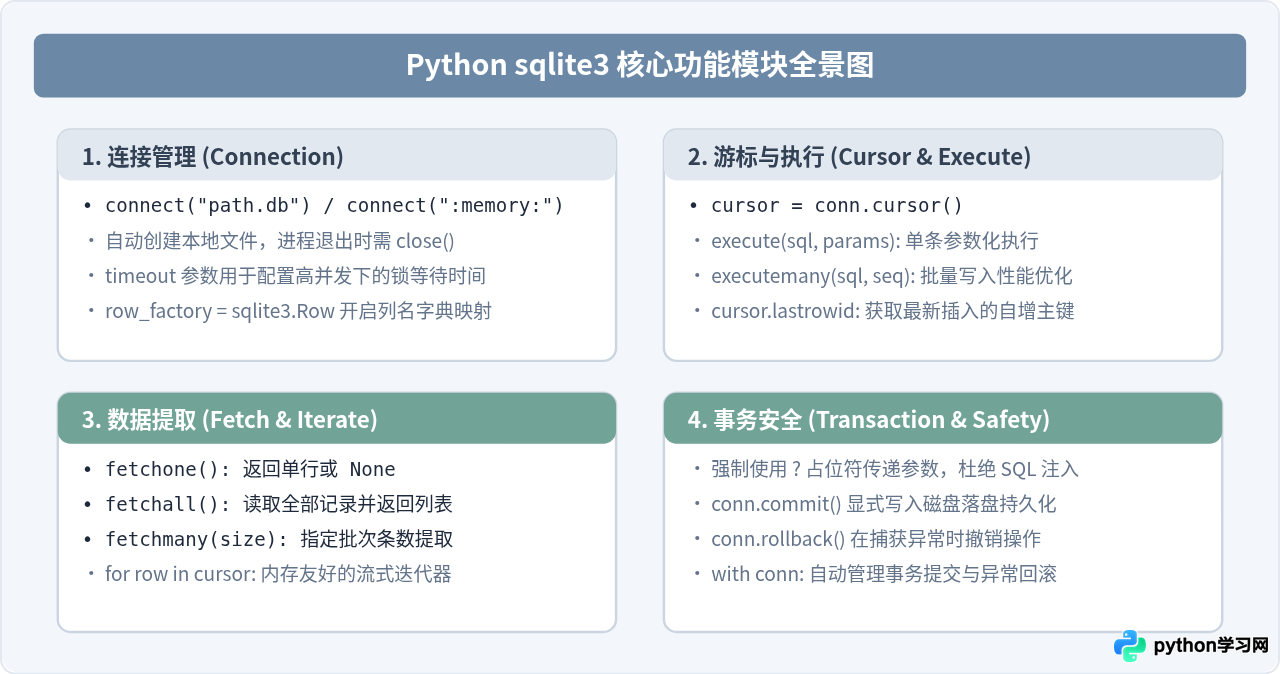
图 4:Python sqlite3 核心功能与关键 API 体系全景
掌握 sqlite3 的核心在于建立规范的编码习惯:严格使用 ? 参数占位符杜绝安全隐患,写操作后显式提交事务,并在查询多列时合理利用 sqlite3.Row 增强字段可读性。凭借免运维、轻量快速以及内置于 Python 标准库的优势,SQLite 能够非常高效地满足本地工具、缓存存储以及中小型业务的原型验证与持久化需求。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















