


Python判断字符串只含字母:isalpha、正则与ASCII遍历对比

在 Python 中检查字符串是否只包含字母,核心区别在于你所定义的“字母”究竟指纯英文字母(ASCII 的 a-z 和 A-Z),还是Unicode 标准下的全部文字字符(包括汉字、希腊字母、带重音符号的字符等)。内置的 str.isalpha() 基于 Unicode 规范,默认会将中文字符也判定为字母;如果业务场景严格要求纯英文输入,直接使用 isalpha() 会产生隐藏逻辑漏洞。本文深入对比 str.isalpha()、正则表达式与 ASCII 遍历三种实现路径,分析语义边界、空串处理陷阱及性能表现,帮助你快速做出准确选型。
一、核心认知:Unicode 字母与纯 ASCII 英文字符的分歧
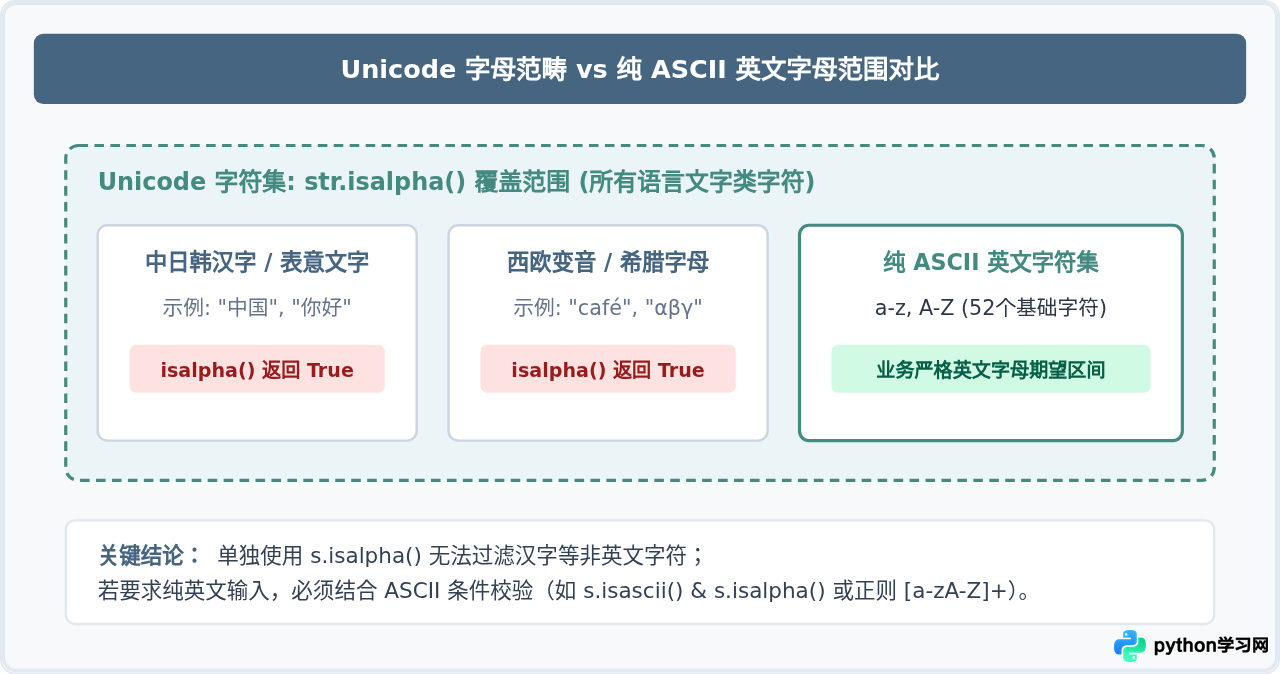
Python 3 的字符串原生为 Unicode 编码。判断“是否只含字母”时,不同技术方案在字符分类上的判定范围存在根本差异:
- Unicode 字母(Letter 范畴):包含任何具有“字母”通用类别的字符,涵盖西欧扩展字符(如
é)、斯拉夫字母、希腊字母,以及中日韩统一表意文字(汉字)。 - ASCII 字母:严格指代编码在 65 至 90(大写 A-Z)和 97 至 122(小写 a-z)之间的 52 个标准英文字符。
二、方法一:内置方法 str.isalpha() 及其 ASCII 组合
str.isalpha() 是 Python 最直观的内置方法,执行高效,但在处理非英文字符集时必须格外注意规则。
1. 原生 isalpha() 的行为表现
# 示例 1:原生 isalpha() 对不同字符的判定结果
print("Hello".isalpha())      # True: 标准纯英文字母
print("helloWorld".isalpha()) # True: 大小写混合
print("Hello123".isalpha())   # False: 包含数字
print("Hello World".isalpha())# False: 包含空格
print("".isalpha())           # False: 空字符串直接返回 False

# 注意:非英文 Unicode 字符的返回值
print("你好世界".isalpha())    # True: 汉字被判定为字母
print("café".isalpha())       # True: 带重音符号拉丁字母
print("αβγ".isalpha()) # True: 希腊字母防坑提醒:若系统需要验证“英文用户名”、“英文缩写代码”等字段,单独使用 s.isalpha() 会允许中文名字通过校验,造成非预期的数据入库。
2. 推荐实践:isascii() 与 isalpha() 双重组合
从 Python 3.7 开始,官方引入了 str.isascii() 方法。当你的诉求是“仅包含纯英文字母”时,将两者通过逻辑与组合是性能极高且代码最优雅的方式:
def is_pure_ascii_alpha(s: str) -> bool:
    # 既保证全为 ASCII 编码范围,又保证全为字母属性
    return s.isascii() and s.isalpha()

# 示例验证
print(is_pure_ascii_alpha("HelloWorld"))  # True
print(is_pure_ascii_alpha("你好"))        # False
print(is_pure_ascii_alpha("café"))        # False
print(is_pure_ascii_alpha(""))            # False
三、方法二:正则表达式 re 模块的精确匹配
当需要更复杂的格式控制(例如结合长度限制或特定边界)时,re 模块能提供无歧义的字符集声明。
1. 使用 re.fullmatch 匹配纯英文字符
import re

# 编译正则表达式,避免每次匹配重复解析
ASCII_ALPHA_PATTERN = re.compile(r'^[a-zA-Z]+$')

def is_alpha_regex(s: str) -> bool:
    # fullmatch 确保整串从首到尾完全匹配
    return bool(ASCII_ALPHA_PATTERN.fullmatch(s))

# 示例验证
print(is_alpha_regex("Python"))      # True
print(is_alpha_regex("Python3"))     # False (含数字)
print(is_alpha_regex("你好"))        # False (非 a-zA-Z)
print(is_alpha_regex(""))            # False (+ 号要求至少 1 个字符)
2. 正则表达式使用要点
- 使用 fullmatch 代替 match/search:
re.match()默认只匹配开头,如果不加结尾锚点$,遇到"Python123"也会返回匹配对象,必须使用re.fullmatch()或显式在正则两端使用^...$。 - 空字符串处理:量词
+要求至少出现 1 次字母,确保空串返回False;若误用*,空串将匹配成功返回True。 - 预编译优化:在频繁调用或高并发场景下,使用
re.compile()预先编译正则对象,能减少重复解析开销。
四、方法三:ASCII 遍历与集合查找
通过检查字符串中每个字符的 ASCII 码值或是否包含于字母表中,也可以实现判定。这种方法逻辑直观,便于自定义白名单。
1. 集合成员检查(set 与 string.ascii_letters)
import string

# 预先构建英文字母集合(大小写 a-z, A-Z)
ASCII_LETTERS_SET = set(string.ascii_letters)

def is_alpha_set(s: str) -> bool:
    # 必须显式防范空字符串,因为 all() 对空迭代对象返回 True
    return bool(s) and all(c in ASCII_LETTERS_SET for c in s)

print(is_alpha_set("DevOps"))   # True
print(is_alpha_set("Dev-Ops"))  # False
print(is_alpha_set(""))         # False
2. 字符码位比对(ord 遍历)
def is_alpha_ord(s: str) -> bool:
    if not s:
        return False
    for char in s:
        code = ord(char)
        # 大写 A-Z: 65~90, 小写 a-z: 97~122
        if not (65 <= code <= 90 or 97 <= code <= 122):
            return False
    return True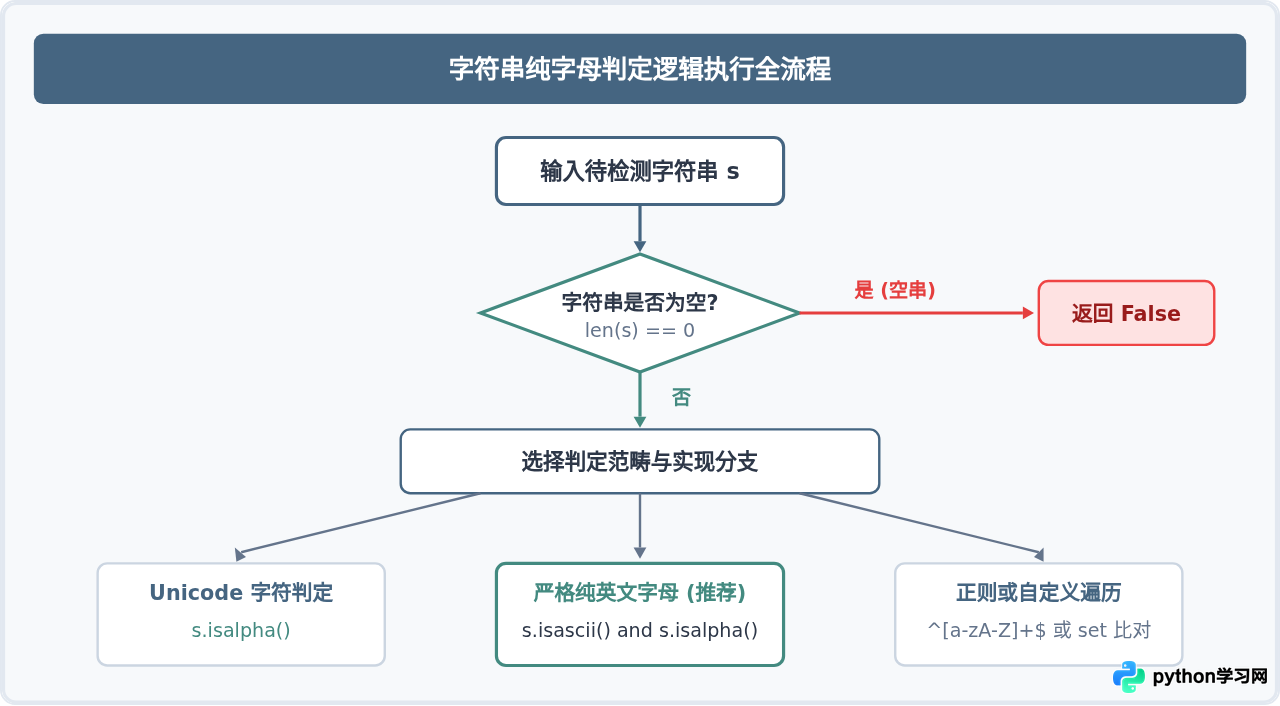
五、横向对比:语义、空串陷阱与执行效率
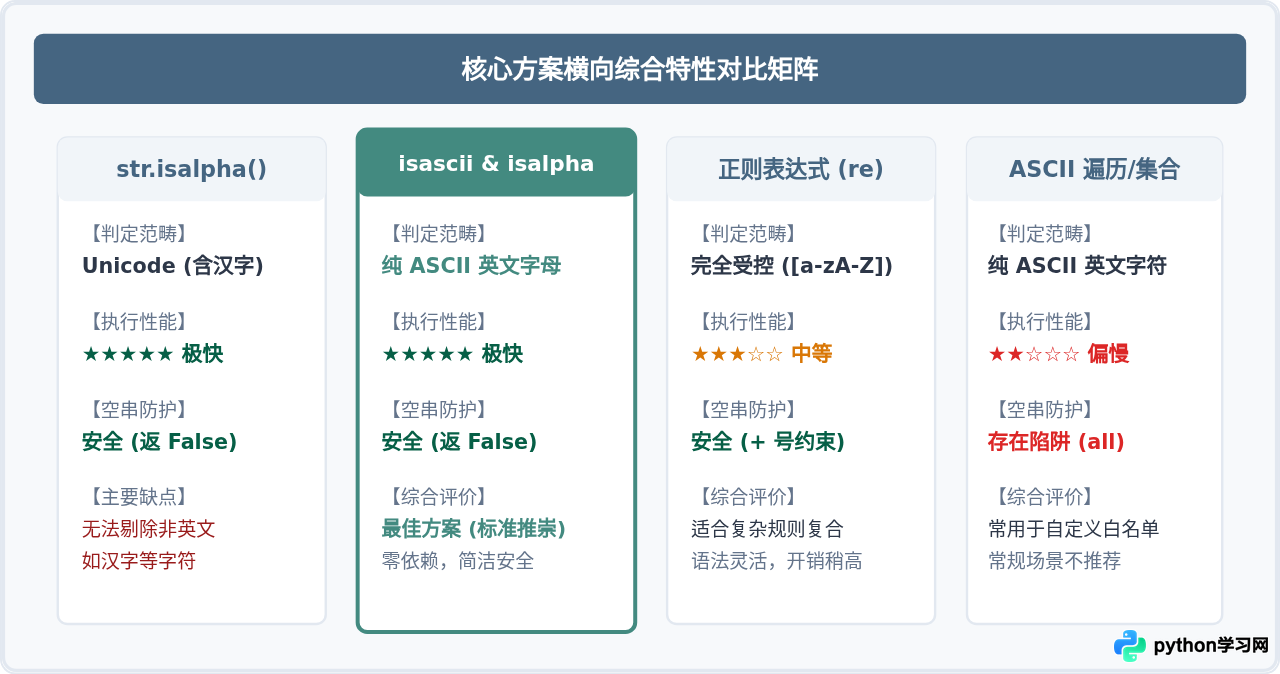
为了直观展现各方案的工程差异,我们在 Python 标准运行环境下对各实现方式进行多维度对照。
| 实现方案 | 判定范畴 | 空字符串返回值 | 外部依赖 | 单次执行相对耗时 |
|---|---|---|---|---|
s.isalpha() |
全语言 Unicode 字母(含汉字) | False |
无(内置) | 极快(C 语言底层) |
s.isascii() and s.isalpha() |
纯 ASCII 英文字母(a-z, A-Z) | False |
无(内置) | 极快(两个 C 方法连乘) |
re.fullmatch(r'^[a-zA-Z]+$', s) |
严格 ASCII(视正则写法而定) | False(使用 +) |
import re |
中等(状态机匹配开销) |
all(c in ASCII_SET for c in s) |
严格 ASCII | True(需额外防范) | string 模块 |
较慢(Python 级生成器遍历) |
ord() 循环遍历 |
严格 ASCII | 需显式处理 | 无 | 较慢(Python 循环调用函数) |
深度剖析:为什么 all() 遍历在空串上会踩坑?
在 Python 中,内置函数 all(iterable) 的定义为“当迭代器中所有元素都为真时返回 True”。如果传入的是空可迭代对象,由于没有任何一个元素为假,all([]) 将返回 True:
# 经典陷阱:
s = ""
print(all(c in string.ascii_letters for c in s))  # 意外输出 True!
# 必须显式加上非空判断:
print(bool(s) and all(c in string.ascii_letters for c in s)) # 正常输出 False相比之下,s.isalpha() 与 s.isascii() and s.isalpha() 内部早已在 C 源码中封装了长度检测,空字符串始终返回 False,无需开发者额外维护安全校验条件。
六、业务场景选型指南与工程最佳实践
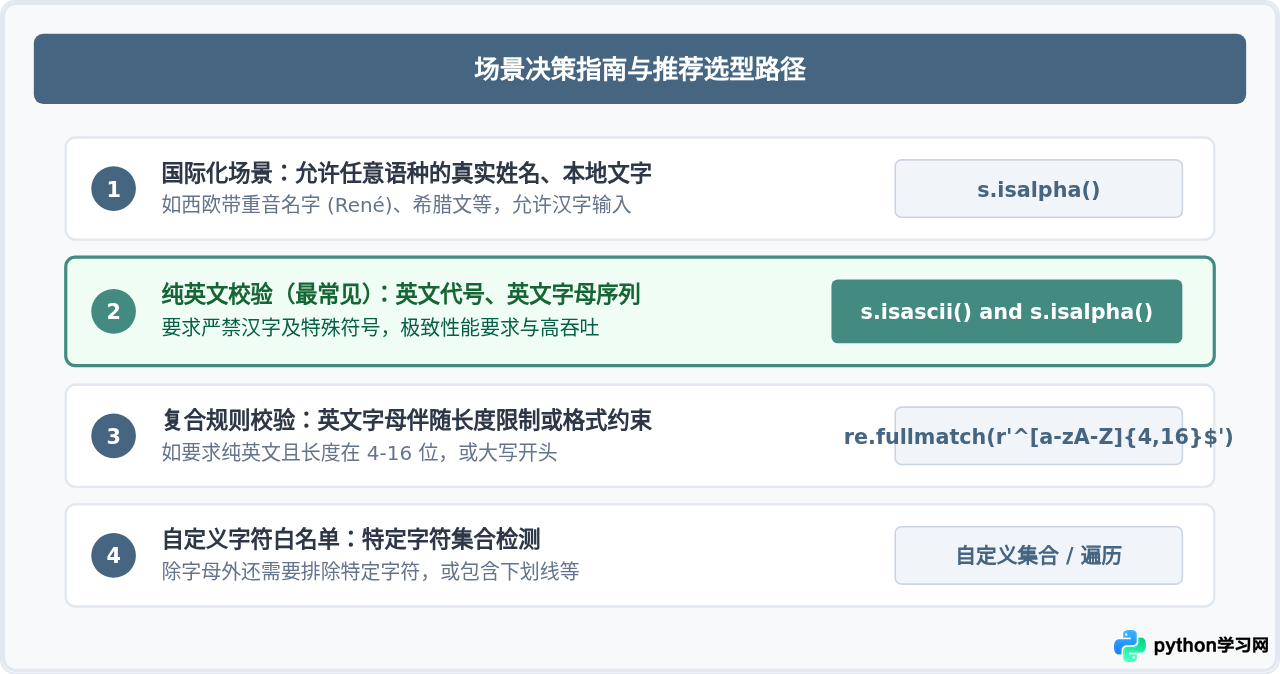
综合准确性、运行速度和维护成本,推荐根据具体的业务上下文选择对应的校验策略:
工程通用辅助函数
在日常生产代码中,建议封装明确命名的辅助工具函数,避免团队成员对 isalpha() 行为产生误解:
def validate_string_letters(value: str, *, ascii_only: bool = True) -> bool:
    """
    判断字符串是否只包含字母。

    :param value: 待检测的目标字符串
    :param ascii_only: 是否仅允许纯英文字母(默认为 True,排除中文汉字等 Unicode 字符)
    :return: 布尔值,当且仅当非空且全部为字母时返回 True
    """
    if not isinstance(value, str) or not value:
        return False

    if ascii_only:
        # C 底层双重判定,性能极优且逻辑绝对安全
        return value.isascii() and value.isalpha()

    # 允许包含全球各语种合法字母(如汉字、变音字母)
    return value.isalpha()

# 调用示例
if __name__ == "__main__":
    print(validate_string_letters("AlphaBeta"))        # True
    print(validate_string_letters("AlphaBeta", ascii_only=True))   # True
    print(validate_string_letters("中文测试", ascii_only=True))     # False
    print(validate_string_letters("中文测试", ascii_only=False))    # True
    print(validate_string_letters("", ascii_only=True))             # False
总结:在大多数需要判断“纯英文字母”的场景下,s.isascii() and s.isalpha() 是首选方案。它兼具内置 C 调用的毫秒级极速与明确的语义边界,无需加载外部模块,且天生防御空串陷阱。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















