


Python递归遍历多层嵌套字典的方法

遍历多层嵌套字典的核心解决方案是递归(Recursion):利用函数自我调用的特性,在遍历当前字典的键值对时,判断当前节点对应的值是否仍然是字典;若是,则将该子字典作为参数再次调用遍历函数;若不是,则触达了最内层的叶子节点并执行业务处理。这种“遇字典则下潜、遇值则处理、无子项则回溯”的机制,天然契合树形数据结构,能够以精简的代码处理任意深度的嵌套层级。
一、递归遍历的核心机制与基础实现
多层嵌套字典本质上是一棵非平衡多叉树。字典的键是路径分支,值可能是中间节点(嵌套字典)或终端叶子节点(字符串、数字、布尔值等基本数据类型)。处理这类结构时,常规的单层 for 循环无法预知嵌套层数,硬编码多重循环既冗长又极易出错。递归方案只需定义两个核心逻辑:
- 递归基准条件(Base Case):当当前值不再是字典类型时,递归终止,直接提取或打印叶子数据。
- 递归步骤(Recursive Step):当当前值为字典类型时,调用自身继续探索下一层级,同时可携带当前深度用于格式化展示。
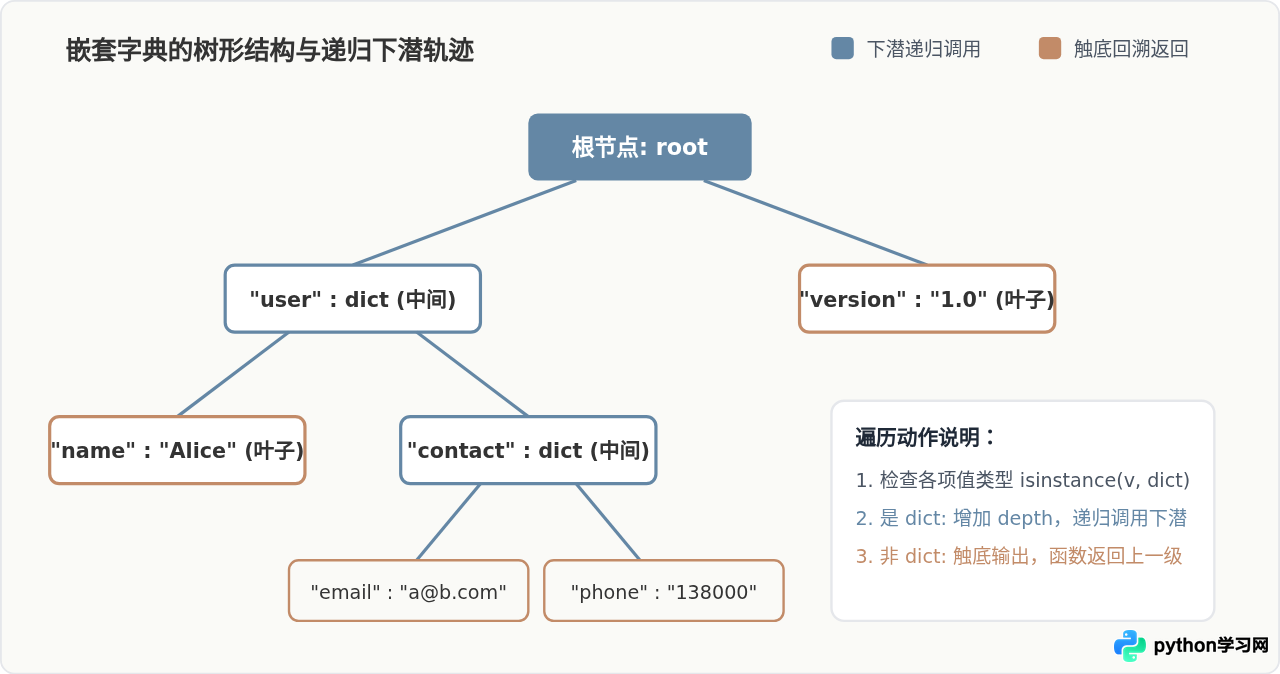
下面是一个完整的基准实现。该函数接收字典对象并维护一个 depth 参数,随着递归向下调用依次增加,并通过缩进直观体现层级深度:
def print_nested_dict(data, depth=0):
    """
    递归遍历多层字典并按层级缩进打印键与值
    :param data: 当前遍历的字典
    :param depth: 当前递归深度(用于格式化缩进)
    """
    indent = "    " * depth
    for key, value in data.items():
        if isinstance(value, dict):
            print(f"{indent}[+] {key}:")
            # 递归调用自身,传入子字典并将层级深度加1
            print_nested_dict(value, depth + 1)
        else:
            print(f"{indent}- {key}: {value}")

# 示例数据
nested_sample = {
    "app": "OrderService",
    "database": {
        "host": "10.0.0.1",
        "port": 3306,
        "credentials": {
            "user": "admin",
            "active": True
        }
    },
    "timeout": 30
}

# 执行遍历
print_nested_dict(nested_sample)
示例输出:
- app: OrderService
[+] database:
    - host: 10.0.0.1
    - port: 3306
    [+] credentials:
        - user: admin
        - active: True
- timeout: 30
二、记录层级路径:将嵌套字典扁平化(Flattening)
在日常数据清洗、配置管理以及存入关系型数据库时,往往不仅需要获取叶子节点的值,还需要完整知道该值来自哪一条父键路径。例如将 {"database": {"credentials": {"user": "admin"}}} 转换为 {"database.credentials.user": "admin"}。
实现该需求的关键在于状态传递:在递归调用时,将当前键追加到路径列表或元组中,作为参数同步传递给下一层。当触及叶子节点时,将整个路径用点号 . 或下划线拼接起来作为新键存入结果字典中。
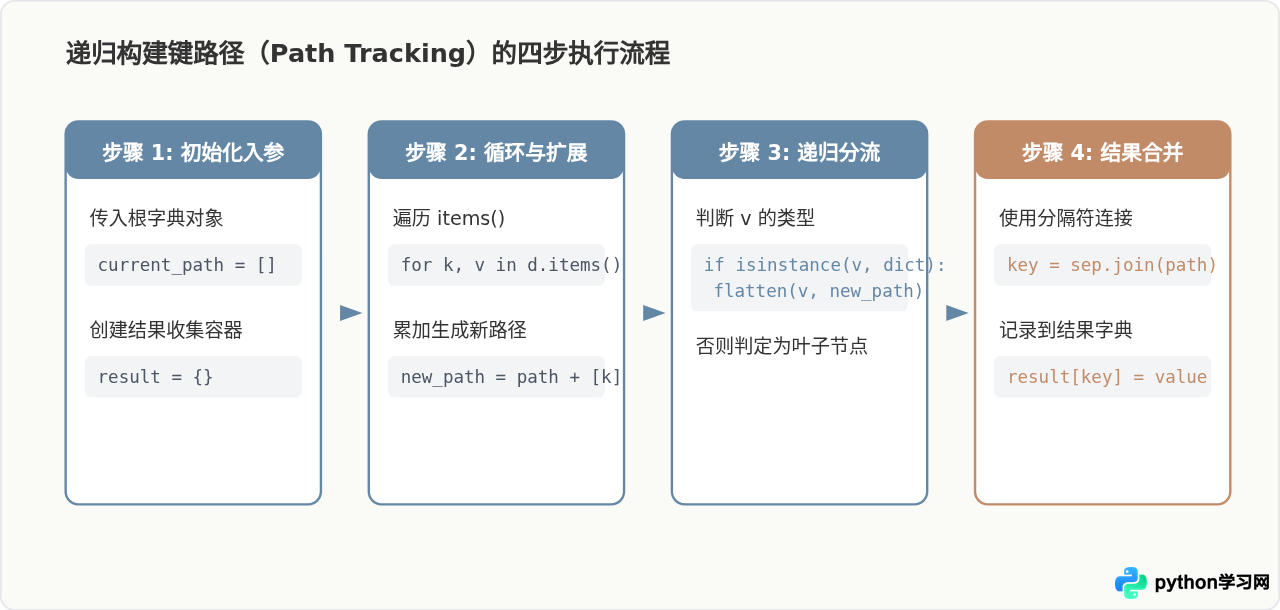
以下为完整的扁平化函数实现。此函数支持自定义路径分隔符 sep,并在内层递归中安全地共享结果字典:
def flatten_dict(nested_dict, parent_key="", sep="."):
    """
    将嵌套字典递归展平为单层字典
    :param nested_dict: 待扁平化的嵌套字典
    :param parent_key: 父级键路径前缀
    :param sep: 键路径之间的连接分隔符
    :return: 展平后的一维字典
    """
    items = []
    for k, v in nested_dict.items():
        # 拼接当前层级的完整键路径
        new_key = f"{parent_key}{sep}{k}" if parent_key else str(k)

        if isinstance(v, dict) and v:  # 遇到非空子字典,继续递归
            items.extend(flatten_dict(v, parent_key=new_key, sep=sep).items())
        else:
            # 遇到叶子值(或空字典),直接保留
            items.append((new_key, v))

    return dict(items)

# 测试数据
server_config = {
    "server": {
        "network": {
            "ip": "192.168.1.100",
            "subnet": "255.255.255.0"
        },
        "logging": {
            "level": "INFO",
            "handlers": {
                "file": "/var/log/app.log"
            }
        }
    },
    "enabled": True
}

flat_result = flatten_dict(server_config)
for path_key, val in flat_result.items():
    print(f"{path_key} => {val}")
示例输出:
server.network.ip => 192.168.1.100
server.network.subnet => 255.255.255.0
server.logging.level => INFO
server.logging.handlers.file => /var/log/app.log
enabled => True
三、应对复杂结构:多层字典与列表混合嵌套
现实中(尤其是调用各类 Web API 返回的 JSON 数据时),数据结构很少是纯粹的字典套字典,往往在字典中间夹杂着列表(List),而列表元素又是新的字典或基本类型。例如:
{"users": [{"name": "Tom", "tags": ["admin", "dev"]}, {"name": "Jerry"}]}
如果递归函数只判断 isinstance(v, dict),列表就会被整体视为叶子节点,导致列表内部的嵌套字典被遗漏。因此,鲁棒的遍历函数需要建立多类型决策分支,同时处理字典分流、列表分流以及叶子节点归并。
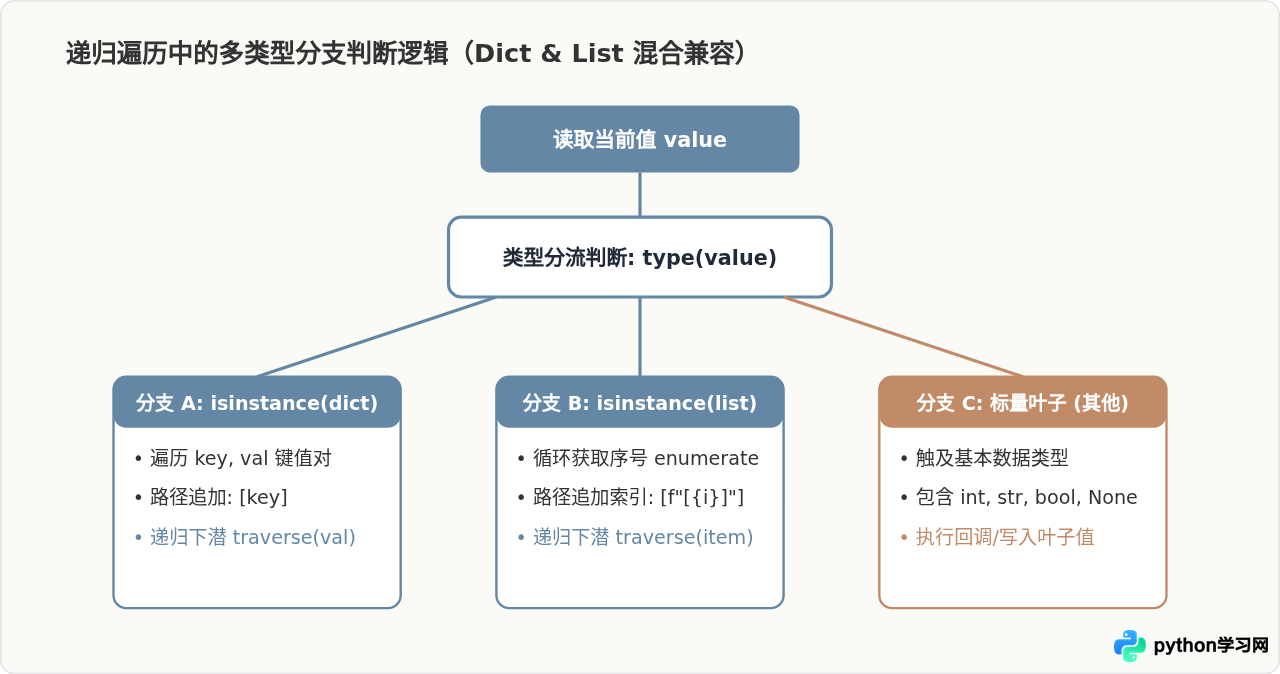
以下代码展示了一个可兼顾字典与列表的通用递归搜索与访问器。它接受一个回调函数(callback),在触达每一个叶子节点时执行用户逻辑:
def traverse_structure(node, current_path=(), callback=None):
    """
    通用递归遍历函数,支持嵌套字典与列表的混合结构
    :param node: 当前节点(可能为dict、list或基本类型)
    :param current_path: 当前访问的路径元组
    :param callback: 触达叶子节点时的处理函数 callback(path, value)
    """
    if isinstance(node, dict):
        for k, v in node.items():
            traverse_structure(v, current_path + (str(k),), callback)
    elif isinstance(node, list):
        for index, item in enumerate(node):
            traverse_structure(item, current_path + (f"[{index}]",), callback)
    else:
        # 叶子节点
        if callback:
            callback(current_path, node)

# 测试混合数据
api_response = {
    "status": "success",
    "data": {
        "cluster": "prod-east",
        "nodes": [
            {"id": "node-1", "ip": "10.0.1.1"},
            {"id": "node-2", "ip": "10.0.1.2"}
        ]
    }
}

# 收集并打印所有叶子节点的定位与取值
def print_leaf(path, val):
    path_str = "/".join(path)
    print(f"路径: {path_str:<30} 值: {val}")

traverse_structure(api_response, callback=print_leaf)
示例输出:
路径: status                         值: success
路径: data/cluster                   值: prod-east
路径: data/nodes/[0]/id              值: node-1
路径: data/nodes/[0]/ip              值: 10.0.1.1
路径: data/nodes/[1]/id              值: node-2
路径: data/nodes/[1]/ip              值: 10.0.1.2
四、防御性编程:深度控制与循环引用防范
在复杂的应用中,字典数据可能来源于不受信任的输入或存在对象相互引用的情况。如果不加防护地执行纯递归,容易遇到以下两个常见问题:
- 循环引用(Circular Reference):若字典直接或间接包含了对自身的引用,递归将陷入死循环,直到抛出
RecursionError: maximum recursion depth exceeded。 - 调用栈溢出(Stack Overflow):Python 默认的最大递归深度约为 1000 层。如果字典嵌套过深,会触发栈溢出限制。
要防止循环引用,最稳妥的方法是维护一个记录对象内存地址的集合 visited。在每次递归进入字典前,使用 id(current_dict) 检查当前对象是否已被访问;如果已存在于集合中,则停止继续下潜。同时,可以通过 max_depth 参数限制允许下潜的最大层级。
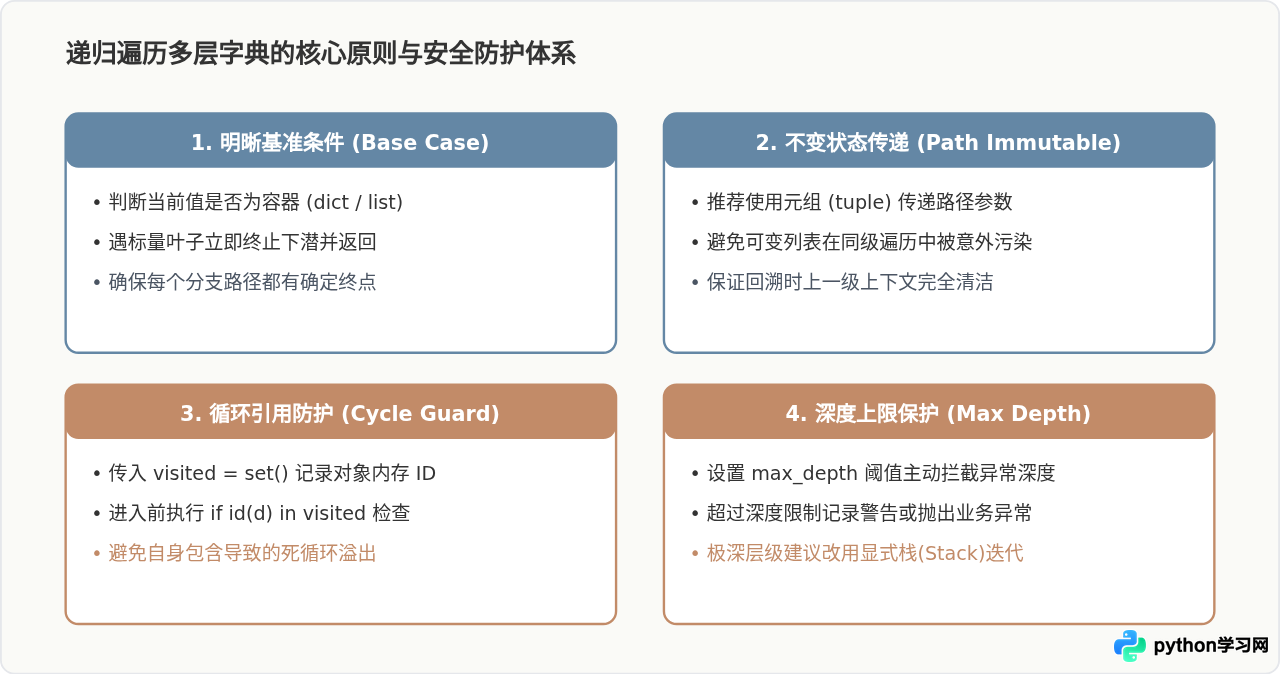
下面是加入了循环引用检测与最大深度防护的安全递归实现:
def safe_traverse_dict(d, max_depth=10, current_depth=0, visited=None):
    """
    带有循环引用防护与深度限制的安全递归遍历
    """
    if visited is None:
        visited = set()

    # 1. 深度限制防范
    if current_depth > max_depth:
        print(f"[警告] 超出最大允许递归深度 {max_depth},停止下潜。")
        return

    # 2. 检查循环引用
    dict_id = id(d)
    if dict_id in visited:
        print(f"[警告] 检测到循环引用对象 (id={dict_id}),跳过递归。")
        return
    visited.add(dict_id)

    # 3. 递归遍历项
    for k, v in d.items():
        if isinstance(v, dict):
            print(f"{'  ' * current_depth}[字典] {k}:")
            safe_traverse_dict(v, max_depth, current_depth + 1, visited)
        else:
            print(f"{'  ' * current_depth}[数据] {k}: {v}")

    # 回溯完成后可根据需求选择是否从 visited 中移除
    # 此处保持整个遍历过程记录,彻底避免菱形或循环重复探索

# 演示循环引用场景
node_a = {"name": "Node A"}
node_b = {"name": "Node B"}
node_a["sibling"] = node_b
node_b["parent"] = node_a  # 构成了 A -> B -> A 的循环引用

print("开始安全遍历具有循环引用的字典:")
safe_traverse_dict(node_a)
示例输出:
开始安全遍历具有循环引用的字典:
[数据] name: Node A
[字典] sibling:
  [数据] name: Node B
  [字典] parent:
[警告] 检测到循环引用对象 (id=...), 跳过递归。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















