


Python嵌套元组怎么提取深层数据?
深入讲解Python中提取嵌套元组深层数据的常见方法,涵盖链式多重索引、解包与match-case模式匹配、递归生成器遍历,并提供越界防护与性能选型建议。
在 Python 中提取嵌套元组的深层数据,核心取决于嵌套结构是否固定以及要提取的数据层级与位置。对于位置确定的静态结构,直接使用链式索引(如 data[0][1][2])是最高效的方式;如果结构固定且需要同时获取多个字段,序列解包与模式匹配(match-case)具备更好的可读性;而面对结构不规则或层级未知的多维元组,编写一个轻量级的递归生成器则是稳健通用的解决方案。
一、链式索引:已知层级位置的高效提取
元组(tuple)是支持随机访问的有序不可变序列。当一个元组中包含其他元组时,每个方括号 [] 负责解包一层引用。先定位最外层元素的索引,再连续通过后续下标指向子元组的具体项。
假设我们有一组表示服务器节点层级信息的嵌套元组:
# 结构:(机房ID, (机架编号, (交换机端口, 服务器名称)))
node_info = ("DC-East", ("Rack-04", (24, "app-server-01")))

# 步骤 1:获取外层第一个子元组 ("Rack-04", (24, "app-server-01"))
rack_level = node_info[1]

# 步骤 2:直接通过链式连续索引穿透到最底层数据 "app-server-01"
server_name = node_info[1][1][1]
port_id = node_info[1][1][0]

print("提取服务器名称:", server_name)
print("提取交换机端口:", port_id)

# 示例输出:
# 提取服务器名称: app-server-01
# 提取交换机端口: 24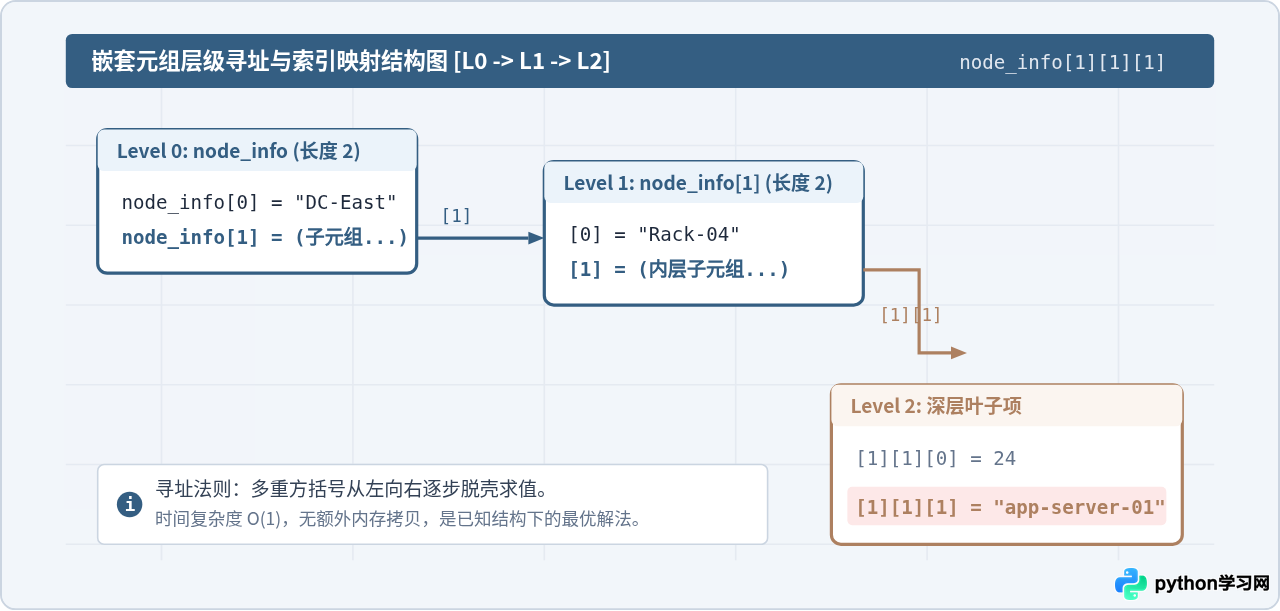
避坑要点:链式访问最常见的运行时异常是 IndexError: tuple index out of range。如果在访问深层数据前不确定某层元组是否存在足够元素,应先用 len() 校验,或封装容错读取逻辑。
二、结构解包与模式匹配:兼具整洁与直观的批量提取
当嵌套元组代表某种具有标准规格的协议包或配置项时,逐个使用 [0][1] 会让代码充满难以维护的“魔法数字”。利用 Python 的解包语法,可以直接用变量名对应内部位置。
1. 对应形状直接解包
声明与元组嵌套层次完全匹配的变量结构,Python 会在单行语句中自动完成解包:
point_record = ("A", (10.5, 20.8), ("flag_active", True))

# 变量形状与元组完全一致;使用下划线 _ 忽略不需要的浅层字段
name, (x, y), (_, is_active) = point_record

print(f"坐标值: x={x}, y={y}, 激活状态={is_active}")
# 示例输出:
# 坐标值: x=10.5, y=20.8, 激活状态=True
2. 配合星号操作符提取变长深层项
若深层元组中项数不固定,可以使用 * 星号操作符进行切片捕获:
dataset = ("Cluster-A", ("Primary", 101, 102, 103, 104))

# 提取第一层的名称、深层首项以及深层后续所有编号
cluster_id, (role, first_node, *other_nodes) = dataset

print("集群:", cluster_id)
print("主节点:", first_node)
print("从属节点列表:", other_nodes)

# 示例输出:
# 集群: Cluster-A
# 主节点: 101
# 从属节点列表: [102, 103, 104]
3. Python 3.10+ match-case 模式匹配
结构性模式匹配支持在提取深层数据的同时完成类型与形态的守卫判断:
def parse_response(payload):
    match payload:
        case ("SUCCESS", (int(code), str(msg)), (*details,)):
            return f"成功返回 - 状态码:{code}, 消息:{msg}, 明细数:{len(details)}"
        case ("ERROR", (int(err_code), str(reason))):
            return f"异常返回 - 错误码:{err_code}, 原因:{reason}"
        case _:
            return "无法识别的元组格式"

res1 = ("SUCCESS", (200, "OK"), ("task_1", "task_2"))
print(parse_response(res1))
# 示例输出:
# 成功返回 - 状态码:200, 消息:OK, 明细数:2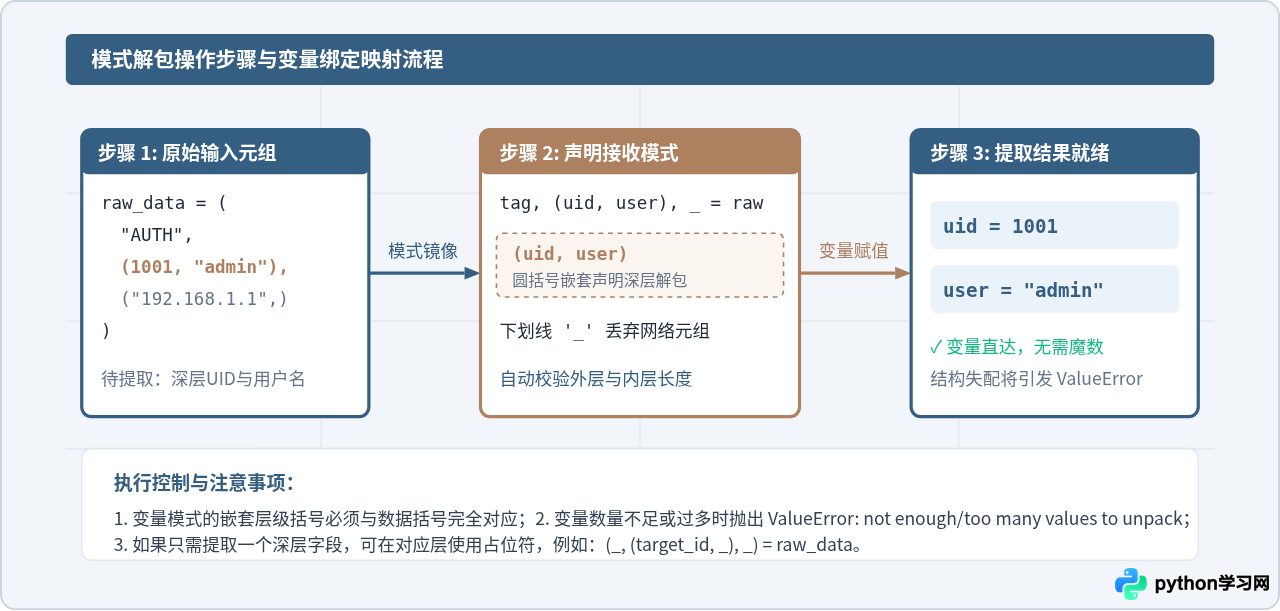
三、递归与生成器:未知深度与动态结构的通用解法
在处理树状分词、语法解析树或嵌套配置时,元组的嵌套深度往往是不规则或动态生成的(例如有些项嵌套 3 层,有些项嵌套 5 层)。此时硬编码的链式索引和模式解包都会失效,应当使用递归函数进行深度优先提取。
1. 递归展开所有深层叶子元素
通过检查当前遍历项是否为 tuple 类型,决定是继续向下深入还是产出当前值。使用 Python 的生成器函数(yield from)可以实现零冗余内存开销的流式提取:
def flatten_nested_tuples(data):
    """
    递归生成器:将任意深度的嵌套元组展开为平铺序列
    """
    for item in data:
        # 判断当前元素是否仍为元组(如果是,则递归下钻)
        if isinstance(item, tuple):
            yield from flatten_nested_tuples(item)
        else:
            yield item

# 测试不规则深度嵌套元组
complex_tree = (1, (2, (3, 4), 5), ((6, (7, (8, 9))), 10))

# 提取为扁平列表
extracted_leaves = list(flatten_nested_tuples(complex_tree))
print("全量提取的深层数据:", extracted_leaves)

# 示例输出:
# 全量提取的深层数据: [1, 2, 3, 4, 5, 6, 7, 8, 9, 10]
2. 按键路径条件提取特定深层数据
如果你有一个类似配置树的元组结构,想要依据“层级路径”(如 ("database", "connection", "port"))精准获取目标项,可以设计带路径参数的安全递归函数:
def get_by_index_path(data, path, default=None):
    """
    通过下标路径安全提取深层元组项
    :param data: 顶层元组
    :param path: 下标序列,如 [1, 0, 2]
    :param default: 越界或类型不匹配时的默认回退值
    """
    current = data
    for idx in path:
        if isinstance(current, tuple) and 0 <= idx < len(current):
            current = current[idx]
        else:
            return default
    return current

nested_config = (
    "Production",
    (
        ("PostgreSQL", 5432),
        ("Redis", 6379)
    )
)

# 目标:获取 Redis 的端口号 6379 -> 路径为 [1][1][1]
port = get_by_index_path(nested_config, [1, 1, 1])
print("提取到的目标端口:", port)

# 尝试访问不存在的路径 -> 返回默认值 None,不崩溃
bad_port = get_by_index_path(nested_config, [1, 5, 0], default="NOT_FOUND")
print("非法路径安全回退:", bad_port)

# 示例输出:
# 提取到的目标端口: 6379
# 非法路径安全回退: NOT_FOUND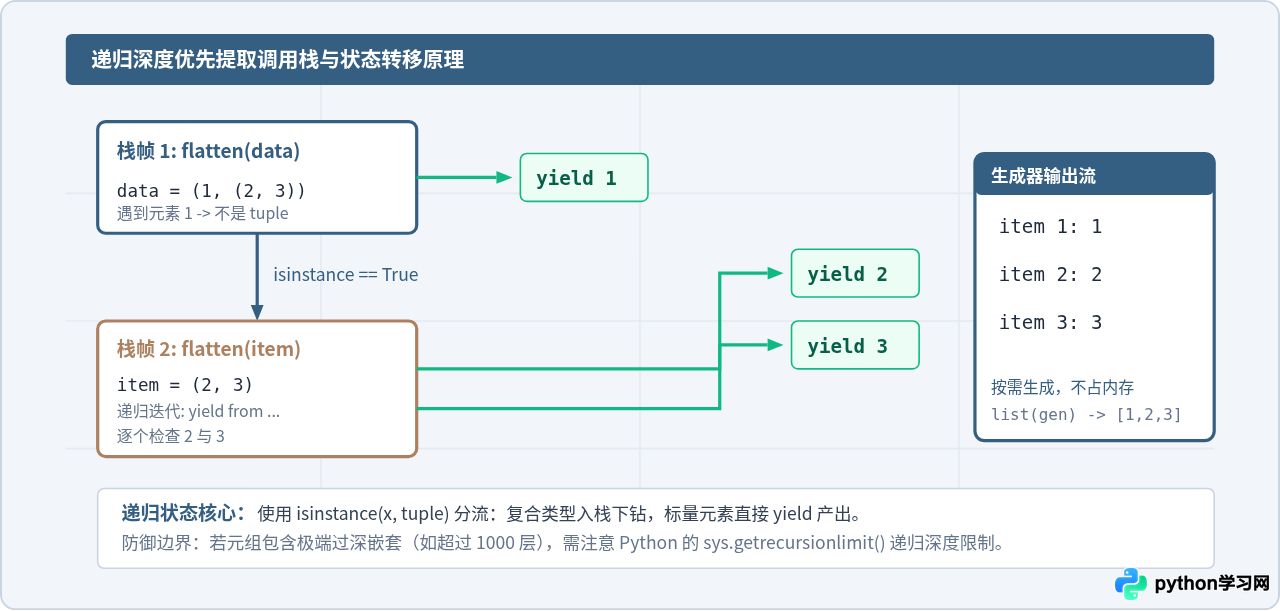
四、工程实践与性能对比
在实际工程代码中,除了编写提取逻辑,我们还需要权衡运行开销、防御潜在异常,并在数据格式允许时考虑重构为可读性更高的数据结构。
1. 异常防护与安全提取模式
提取深层元组最容易出现崩溃的原因是某一中间层不是元组(引发 TypeError: 'int' object is not subscriptable)或索引超界(引发 IndexError)。在面向不可控外部数据时,推荐使用 try...except 包装原子提取:
def safe_extract_deep(tup, *indices, default=None):
    """
    通用容错提取函数
    用法:safe_extract_deep(data, 1, 0, 2) 相当于 data[1][0][2],出错返回 None
    """
    current = tup
    try:
        for idx in indices:
            current = current[idx]
        return current
    except (IndexError, TypeError):
        return default

# 测试混合型不安全数据
sample_payload = ("API_V1", (100, None))

# 尝试获取第 1 层元组中第 1 项(None)的第 0 个子项
result = safe_extract_deep(sample_payload, 1, 1, 0, default="NOT_AVAILABLE")
print("安全防护提取结果:", result)
# 示例输出:
# 安全防护提取结果: NOT_AVAILABLE
2. 代码重构建议:具名元组(NamedTuple)
如果嵌套元组在业务生命周期内多次传递且结构固定,持续使用数字索引容易引发硬编码错误。可以通过标准库 collections.namedtuple 或 typing.NamedTuple 将元组升级为强类型具名元组:
from typing import NamedTuple

class Dimension(NamedTuple):
    width: int
    height: int

class UIWidget(NamedTuple):
    widget_id: str
    dim: Dimension

# 初始化具名嵌套元组
widget = UIWidget("btn_submit", Dimension(120, 40))

# 既保留元组的内存性能和不可变特性,又能通过深层属性名优雅访问
print("宽度:", widget.dim.width)
print("高度:", widget.dim.height)
# 仍兼容元组传统索引:
print("传统索引穿透:", widget[1][0])

# 示例输出:
# 宽度: 120
# 高度: 40
# 传统索引穿透: 120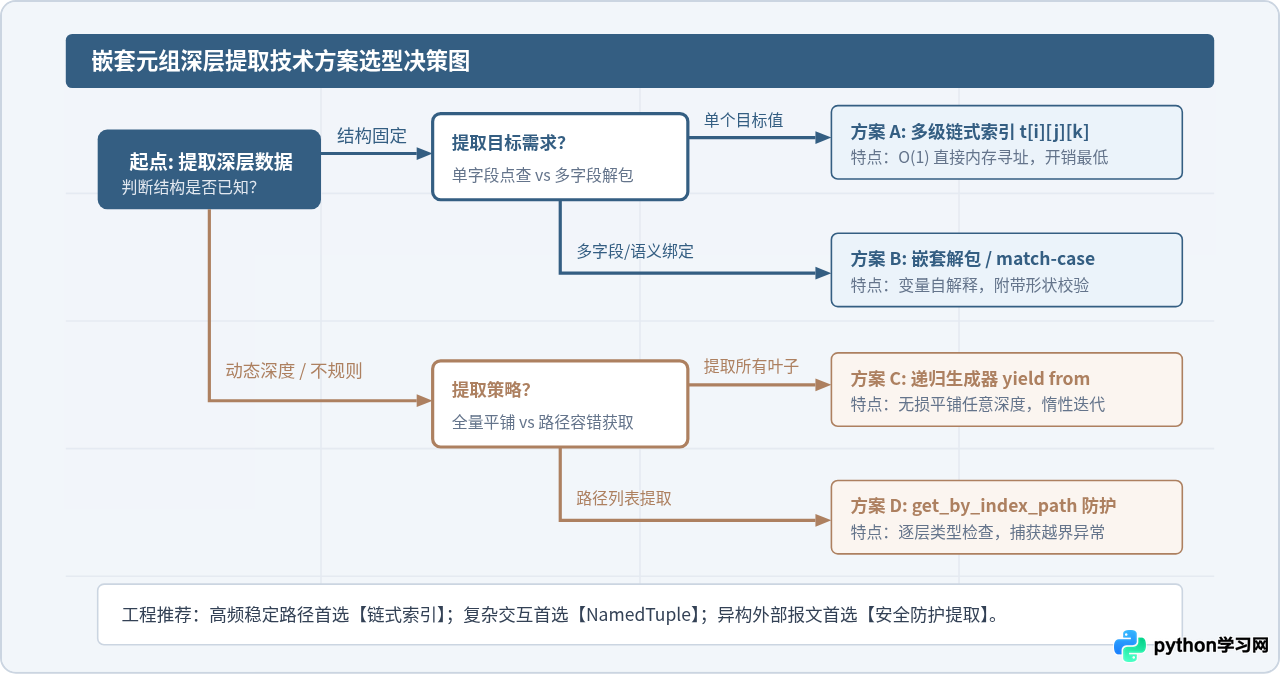
方案综合对比表
| 提取方法 | 适用场景 | 代码可读性 | 时间复杂度 | 容错能力 |
|---|---|---|---|---|
链式多重索引 t[i][j][k] |
结构已知、位置固定的单点快速提取 | 一般(包含纯数字索引) | O(k) (k为层数,近似 O(1)) | 较弱(越界即抛 IndexError) |
模式解包 (a, (b, c)) |
结构已知、需要同时取出多个深层字段 | 极高(语义明确、形态对应) | O(n) (匹配全量项) | 中等(项数不匹配抛 ValueError) |
| match-case 匹配 | 多类型报文、带有守卫条件的解构提取 | 极高(分支逻辑清晰) | O(n) | 高(天然支持 case _ 兜底) |
| 递归生成器 | 树状未知深度、不规则嵌套的叶子提取 | 良好(封装后复用方便) | O(N) (N为总节点数) | 高(自适应所有层级形态) |
| 安全路径提取函数 | 动态配置读取、外部非信任输入的深层获取 | 高(返回默认值,防止崩溃) | O(k) | 极高(自动捕获类型与越界异常) |
五、核心结论与记忆口诀
处理 Python 嵌套元组时,可以遵循以下口诀进行选择:
- 层级固定取单项:用多重方括号
data[x][y][z],开销最小,一步穿透; - 层级固定取多项:用圆括号嵌套解包
(_, (target, _)) = data,直观省心; - 层级未知或展平:用递归生成器加
isinstance(item, tuple)递归下钻; - 生产环境怕崩断:封装
try-except捕获IndexError与TypeError提供安全默认值。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















