


Python列表与NumPy数组有什么区别?性能对比分析

list 与第三方科学计算库提供的 numpy.ndarray 在表面上都可以存放一系列元素,但两者的底层架构存在本质差别:Python 列表是通用对象的指针数组,侧重灵活性与动态扩展;而 NumPy 数组是连续存放单一数据类型的内存缓冲区,依托 C 语言底层实现与 CPU 矢量化指令。本文将直接从内存布局、计算机制切入,并通过基准测试量化其在内存与性能上的差距,最后给出明确的工程选型标准。
一、核心架构差异:指针离散存储 vs 连续同质内存
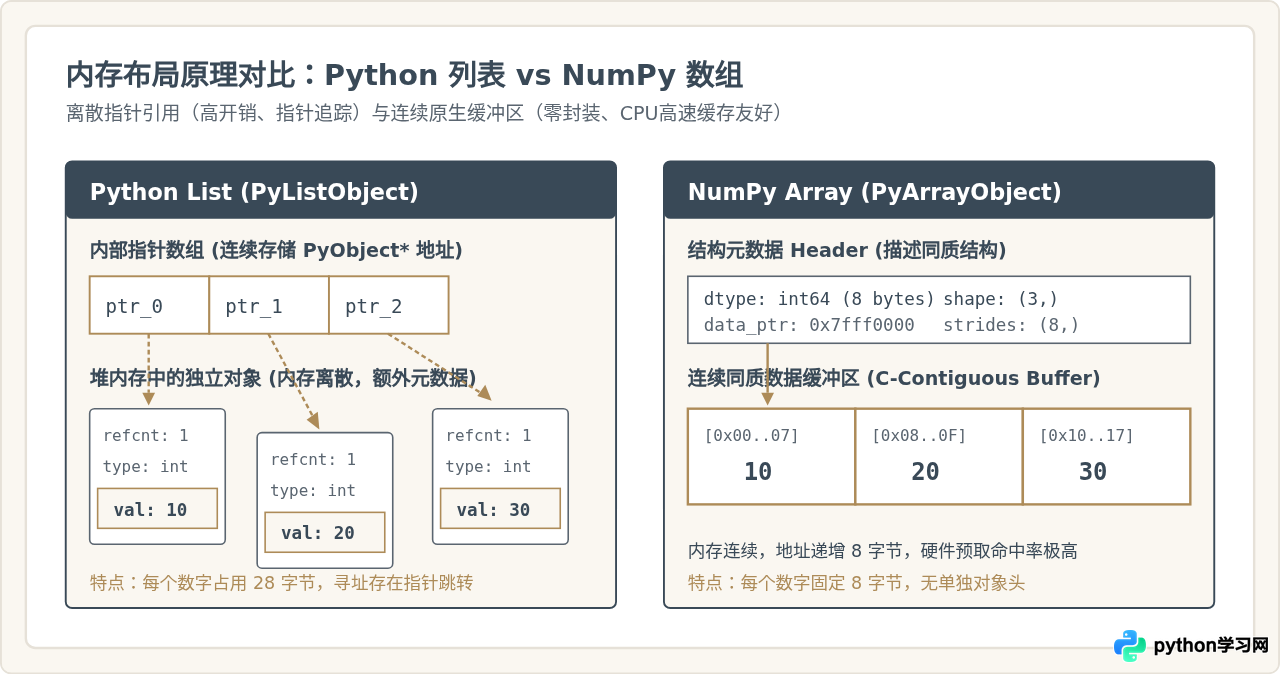
理解 Python 列表与 NumPy 数组差异的起点在于其底层的内存模型。Python 的定位是通用动态脚本语言,为了支持任意类型的数据混存,list 在 CPython 解释器中被实现为一个存放 PyObject* 指针的连续数组。
当向列表中添加整数 100 时,Python 并不会在列表空间内直接写下数值 100,而是先在堆内存中实例化一个完整的 PyLongObject(包含类型信息、引用计数和实际数值,通常占用 28 字节),然后将该对象的内存地址保存在列表数组中。因此,列表本身是一个存放指针的容器,其实际元素分散在内存的不同区域。
相比之下,NumPy 的 ndarray 核心是一个指向连续 C 原生内存块的数据指针(data buffer),配合元数据(包含数据类型 dtype、多维形状 shape、跨度 strides 等)。在声明一个包含 64 位整数的 NumPy 数组时,每个元素恰好占用 8 个字节并紧凑相连,中间不存在任何指针、引用计数或额外对象开销。
二、计算机制对比:解释器逐项类型解析 vs C 语言底层矢量化
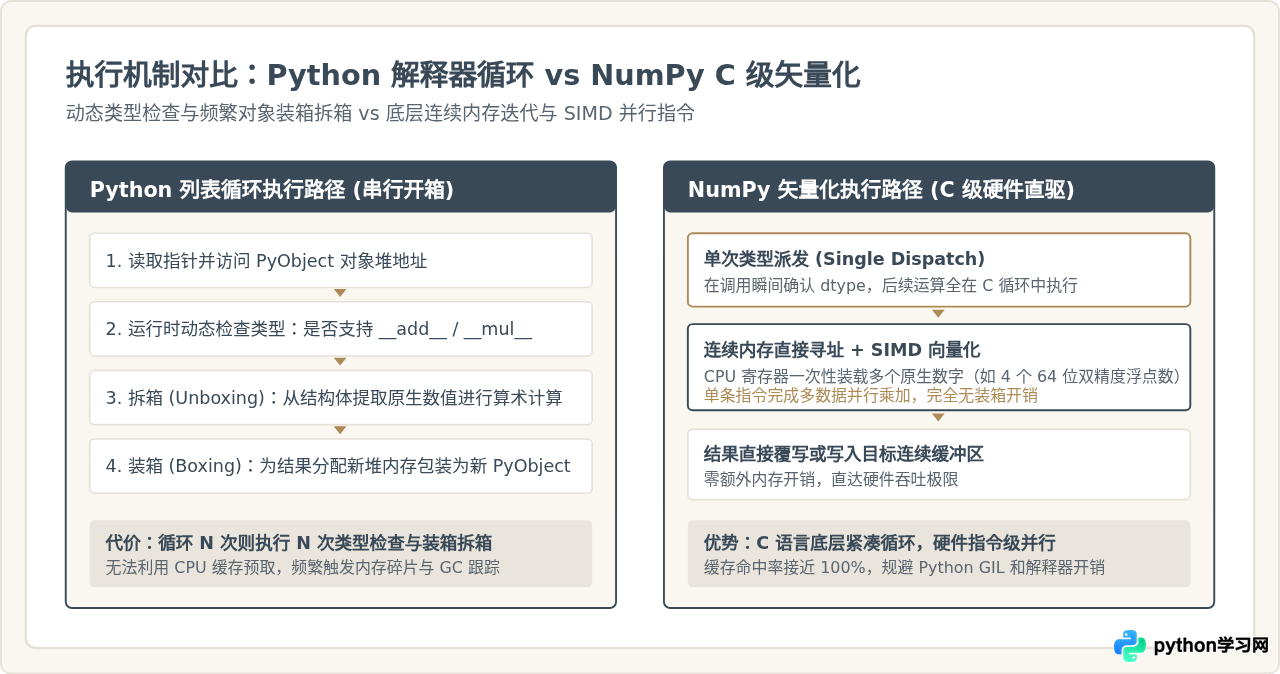
存储结构的差异直接决定了两种数据结构的运算方式。在对 Python 列表进行遍历和数学计算时(如执行 [x * 2 for x in my_list]),解释器必须在每一步进行繁琐的类型动态检查和对象开箱拆包:
- 通过指针数组读取到下一个元素的内存地址。
- 检查该对象是否具备乘法运算方法(
__mul__),判断其是否为整数、浮点数或字符串。 - 从对象的内存字段中提取原生 C 数值(开箱 Unboxing)。
- 执行相乘运算得到计算结果。
- 分配新内存,创建一个新的
PyLongObject包装运算结果(封箱 Boxing)。 - 将新对象的指针压入结果列表。
上述流程在百万次循环中就会执行数百万次类型判定与内存分配。而 NumPy 的计算机制则完全跳过了 Python 解释器。通过预先约定的数据类型(dtype),NumPy 在编译好的底层 C 代码中直接通过指针偏移量读取原生二进制数值,并借助现代 CPU 的 SIMD(单指令多数据流,如 AVX-512、NEON)指令集实现一条汇编指令并行计算多个数值。
三、基准测试与量化分析
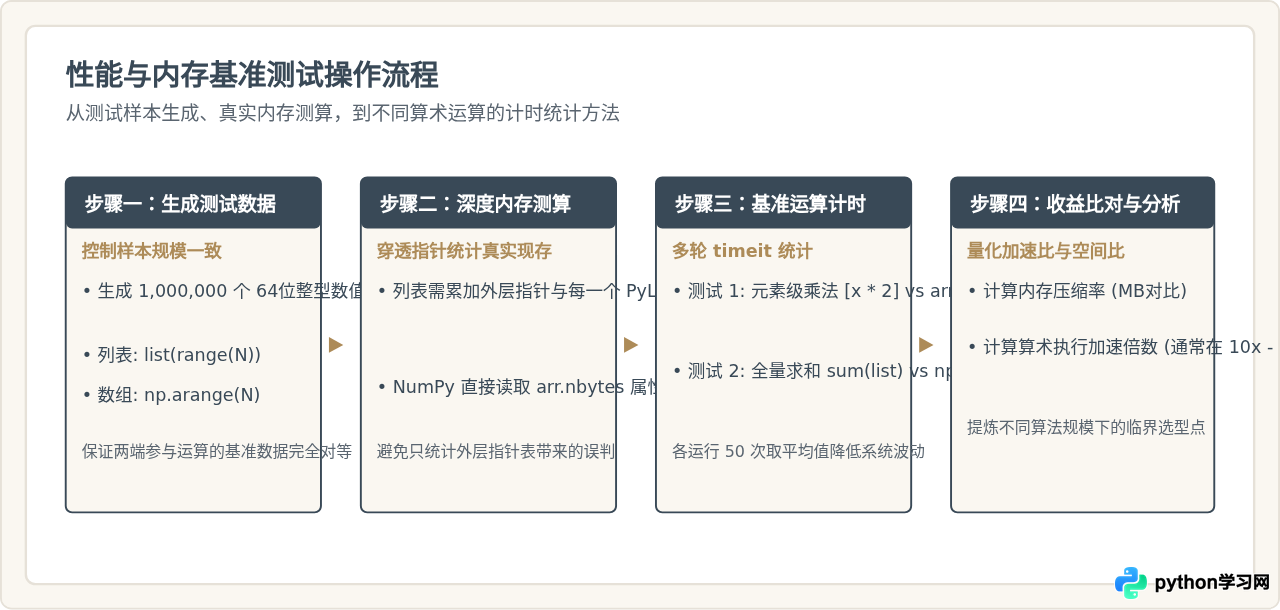
为了具体展现这种底层机制上的差异,我们可以通过编写基准测试脚本,从内存消耗和计算耗时两个维度进行严格测试。
1. 内存测试代码与实测数据
值得注意的是,很多初学者使用 sys.getsizeof(py_list) 来评估列表内存,这只会返回外层指针数组的大小(约 8 MB),而忽略了指针指向的各个整型对象。真实的内存占用必须累加每个元素的开销:
import sys
import numpy as np

N = 1_000_000

# 1. Python 列表内存统计
py_list = list(range(N))
# 指针表本身大小 + 每个独立的 PyLongObject 对象大小
total_list_mem = sys.getsizeof(py_list) + sum(sys.getsizeof(x) for x in py_list)
list_mem_mb = total_list_mem / (1024 * 1024)

# 2. NumPy 数组内存统计
np_arr = np.arange(N, dtype=np.int64)
# 纯数据缓冲区大小 + 结构体元数据
np_mem_mb = (np_arr.nbytes + sys.getsizeof(np_arr)) / (1024 * 1024)

print(f"Python 列表总占用: {list_mem_mb:.2f} MB")
print(f"NumPy 数组总占用:  {np_mem_mb:.2f} MB")
测试环境与实测输出示例(Python 3.11, 64-bit OS):
[示例输出]
Python 列表总占用: 34.34 MB
NumPy 数组总占用:  7.63 MB
在相同的 100 万个整数下,NumPy 仅占用了 7.63 MB(几乎全为 1000000 × 8 字节的原生数据),而 Python 列表由于庞大的指针与对象头开销,占用了超过 34 MB 内存,内存占用高出近 4.5 倍。
2. 运算耗时测试代码与实测数据
import timeit
import numpy as np

N = 1_000_000
setup_code = f"""
import numpy as np
py_list = list(range({N}))
np_arr = np.arange({N}, dtype=np.int64)
"""

# 测试 1: 标量逐元素相乘并生成新结构
t_list_mul = timeit.timeit("[x * 2 for x in py_list]", setup=setup_code, number=50) / 50
t_np_mul = timeit.timeit("np_arr * 2", setup=setup_code, number=50) / 50

# 测试 2: 序列全量累加求和
t_list_sum = timeit.timeit("sum(py_list)", setup=setup_code, number=50) / 50
t_np_sum = timeit.timeit("np.sum(np_arr)", setup=setup_code, number=50) / 50

print(f"乘法操作 - List推导式: {t_list_mul*1000:.2f} ms | NumPy矢量化: {t_np_mul*1000:.2f} ms (加速 {t_list_mul/t_np_mul:.1f}x)")
print(f"求和操作 - Python内置sum: {t_list_sum*1000:.2f} ms | NumPy内置sum: {t_np_sum*1000:.2f} ms (加速 {t_list_sum/t_np_sum:.1f}x)")
实测输出示例:
[示例输出]
乘法操作 - List推导式: 48.20 ms | NumPy矢量化: 0.92 ms (加速 52.4x)
求和操作 - Python内置sum: 6.85 ms | NumPy内置sum: 0.41 ms (加速 16.7x)
| 对比维度 | Python 列表 (List) | NumPy 数组 (ndarray) | 技术成因与性能表现 |
|---|---|---|---|
| 数据类型支持 | 异构(可同时包含字符串、整数、字典等) | 同质(所有元素必须为统一数据类型,如 float64) | 列表灵活性极高;NumPy 牺牲类型混存以换取极致内存规整度。 |
| 100万整数内存占用 | 约 34.3 MB | 约 7.6 MB | NumPy 内存仅为列表的 22%,紧凑存储带来极高缓存命中率。 |
| 标量运算耗时 (100万项) | 约 48.2 ms | 约 0.92 ms | NumPy 加速超过 50 倍,得益于免除解释器开箱与 SIMD 矢量化。 |
| 动态增删元素 (Append) | 极快(摊还 O(1) 复杂度,有自动扩容预留机制) | 极慢(O(N) 复杂度,底层需要重新分配并全量拷贝缓冲区) | 频繁增删元素是 Python 列表的强项,NumPy 应当预先分配固定大小。 |
| 高维与矩阵运算 | 需使用嵌套列表 [[..], [..]],语法繁琐且运算极其缓慢 |
原生支持多维 shape、切片视图、矩阵乘法与广播机制 |
NumPy 的切片默认返回视图(View)而非拷贝,操作多维数据零额外分配。 |
四、工程选型与常见陷阱
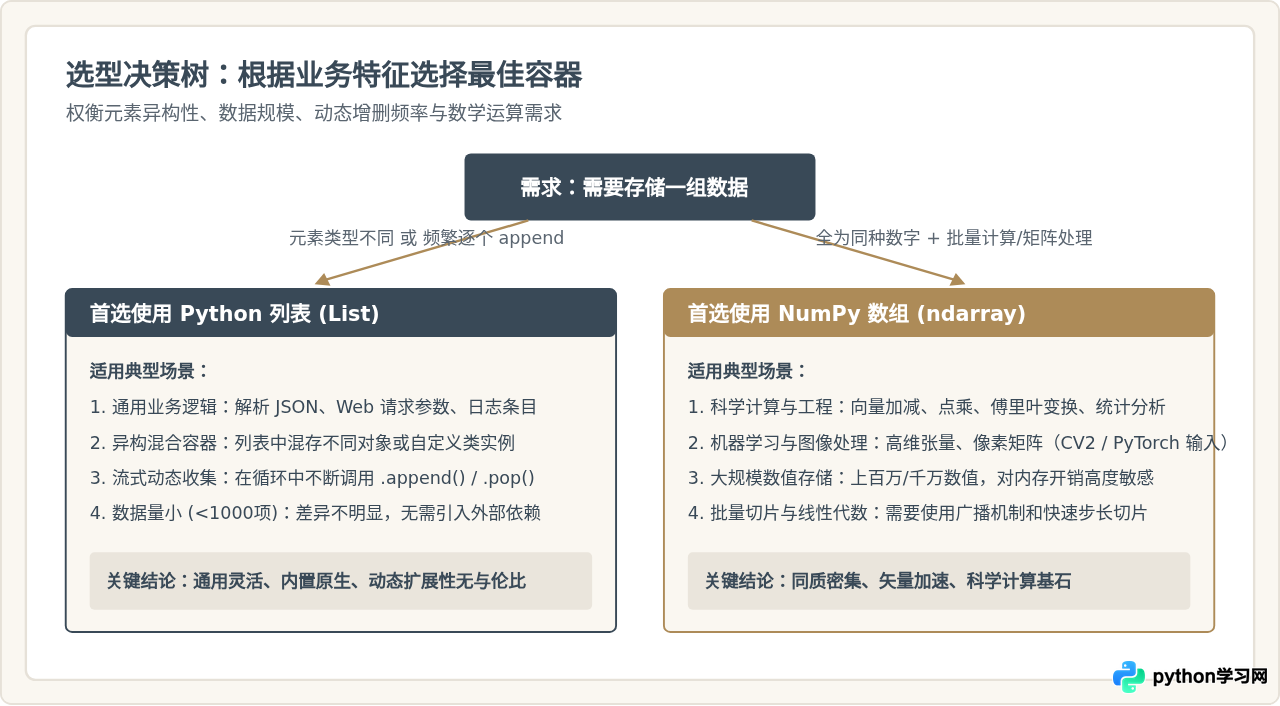
虽然 NumPy 在科学计算与数值吞吐上具备压倒性优势,但并不意味着它在所有场景下都能取代 Python 列表。选择哪种结构取决于你的核心需求:
误区一:对 NumPy 数组使用 Python 原生 for 循环进行计算。
如果在 NumPy 数组上写 for x in arr: total += x,解释器在每次迭代中不仅要执行开箱,还要额外跨越 Python 到 C 的调用边界,耗时甚至会比纯 Python 列表慢 2 到 3 倍。使用 NumPy 时必须使用矢量化表达式(如 arr.sum() 或 arr * 2)。
误区二:在循环中对 NumPy 数组频繁执行 np.append()。
Python 列表的 append() 是均摊 O(1) 的,因为底层有超额预分配机制;而 np.append() 每次被调用都会在内存中重新申请一块新数组,并将旧数据全部拷贝过去(O(N) 复杂度)。如果有百万个元素,逐个 append 会导致程序陷入严重的反复内存拷贝甚至假死。正确做法是预先声明固定大小(如 np.zeros(N))直接按索引赋值,或者先用 Python 列表动态 append,最后通过 np.array() 一次性批量转换。
五、总结
总结来说,Python 列表与 NumPy 数组的区别从来不是简单的“谁更好”,而是设计哲学与应用场景的分工:
- Python 列表是高度灵活的通用数据结构,包容任何类型,支持便捷的动态增长,是处理通用业务逻辑、异构数据和日常文本解析的不二之选。
- NumPy 数组是追求极致效率的科学计算利器,通过同质约束实现了紧凑的连续内存布局,配合 C 语言与硬件级的 SIMD 矢量化指令,在大规模数值计算、矩阵处理和机器学习流水线中展现出数量级的性能优势。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















