


大数据与AI领域为何首选Python?与Java的生态支持对比

在大数据基础设施与企业级服务中,Java 及其 JVM 生态一度是绝对的行业基石;然而在现代数据科学、机器学习以及深度学习领域,Python 却成为了事实上的绝对通用语言。这种选型偏好并不是因为 Python 解释器在语法执行速度上超越了 Java,而是源于底层内存模型的硬件亲和性、交互式科研探索的快速试错闭环,以及上层开源算法生态形成了极高壁垒的“重力场效应”。
一、底层机制:连续内存与硬件加速的天然契合
讨论执行效率时,常有人提出疑问:Java 拥有极其高效的 JIT 即时编译器和成熟的多线程并发模型,单线程纯算术性能往往数倍于纯 Python 脚本,为何在重度依赖算力的大数据张量与神经网络计算中,业界反而全面倒向了 Python?
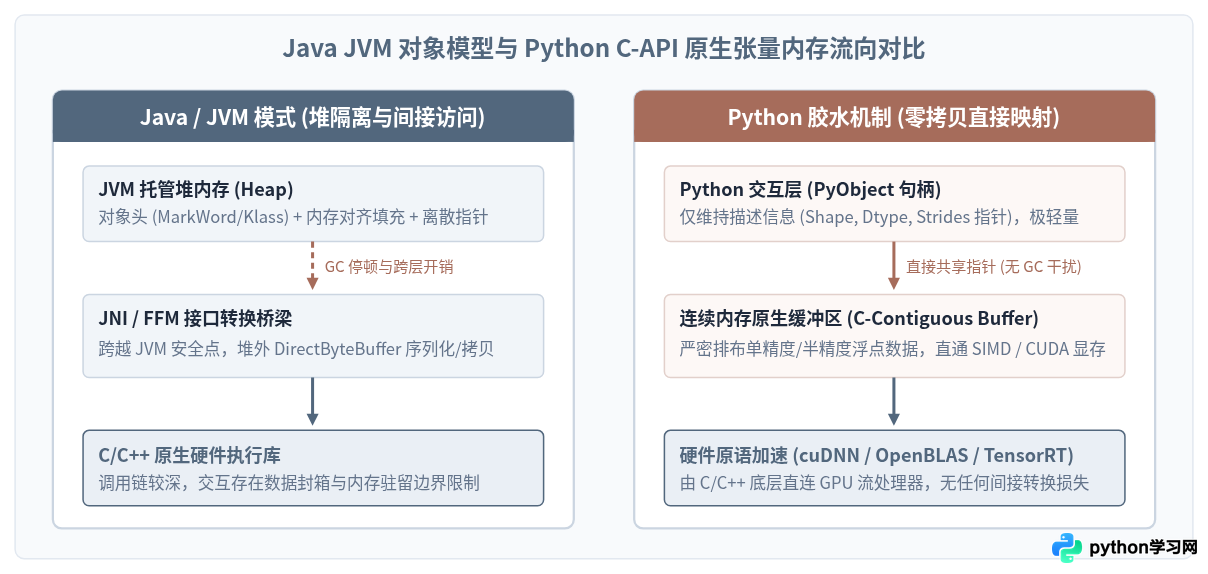
关键分歧在于内存对象的组织形式与异构硬件的调用距离。AI 与科学计算的核心是稠密矩阵与高维向量运算(如 GEMM 矩阵乘法)。这类任务对性能的核心诉求不是高级语言虚拟机中的对象调度,而是如何将海量浮点数据以极其紧凑的连续内存块组织起来,直接交给底层 CPU 向量指令集(AVX-512、NEON)或 GPU 核心(Tensor Core、CUDA 线程块)批量吞吐。
Java 的对象模型以引用和指针为基础。一个标准的 Java 数组即使存放原始浮点数,在包装为对象时也会伴随对象头(Header)、类指针及填充字节(Padding);而在多层嵌套或复杂结构中,内存寻址常常是离散跳跃的,这不仅带来内存膨胀,更会导致 CPU 缓存行(Cache Line)频繁失效。此外,当托管堆内存膨胀至数十甚至上百吉字节时,垃圾回收器(GC)的标记与整理成本会产生难以预期的停顿。
相反,Python 在 AI 领域扮演的从来不是“执行引擎”,而是高性能 C/C++ 与 CUDA 运行时的控制面板。NumPy 数组(ndarray)或 PyTorch 张量(Tensor)本质上只是一个轻量级的 Python 壳,其真实数据是一块连续分配在 C 堆区或显存中的原生二进制缓冲区(Raw Buffer)。Python 仅负责调度元数据(维度 Shape、跨度 Strides),底层的转置、切片和矩阵乘法全部通过零拷贝(Zero-Copy)方式直接交由底层经过极致优化的硬件计算库执行。
二、研发范式:探索式实验与工程编译的生产力鸿沟
人工智能和数据科学项目,其研发本质并非传统的确定性业务软件工程,而是一门高度依赖实证反馈的实验学科。研究员面对未知的原始数据,需要持续进行字段探查、缺失值插补、特征分布绘制、模型拓扑修改以及超参数试错。
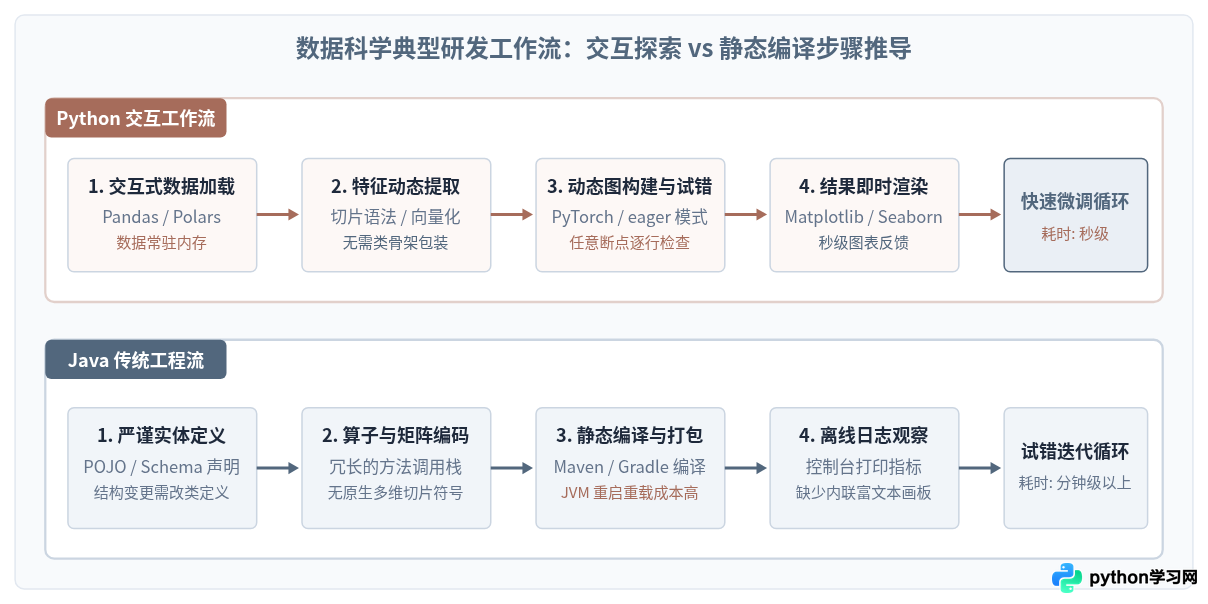
在这一研发过程中,开发者最需要的是“即时反馈”。Python 配合 Jupyter Notebook 提供了极高亲和力的 REPL 交互环境。开发者可以在内存中常驻一个 5GB 的清洗后数据集,按单元格(Cell)微调模型结构或损失函数,并在毫秒级内获得运行图表反馈,而无需每次修改都重新加载数据或重新编译。
对比之下,Java 是一门强类型、面向工程严谨性设计的静态编译语言。在构建大规模金融服务或分布式中间件时,严格的静态类型检查、模块封装与完备的单元测试能够极大减少运行时隐患。但当这种严肃的工程仪式感被代入探索性数据分析时,反而成为了阻碍创新的摩擦力:
- 数据切片与代数表达的语法负荷:在 Python 中,三维张量的提取仅需一行
batch = data[:, 0:10, ::2];而在 Java 中,若缺乏高阶操作符重载与切片内建语法,开发者往往需要嵌套数层迭代器或编写臃肿的 API 调用。 - 重构成本与编译断点:即使引入了 Java 9+ 的 JShell,面对动态变化的数据字段和矩阵结构,Java 的类型绑定与类加载机制依然要求频繁的结构声明,打断了研究者的直觉流。
三、大数据与AI架构演进:从“全栈 Java”到“两层协同”
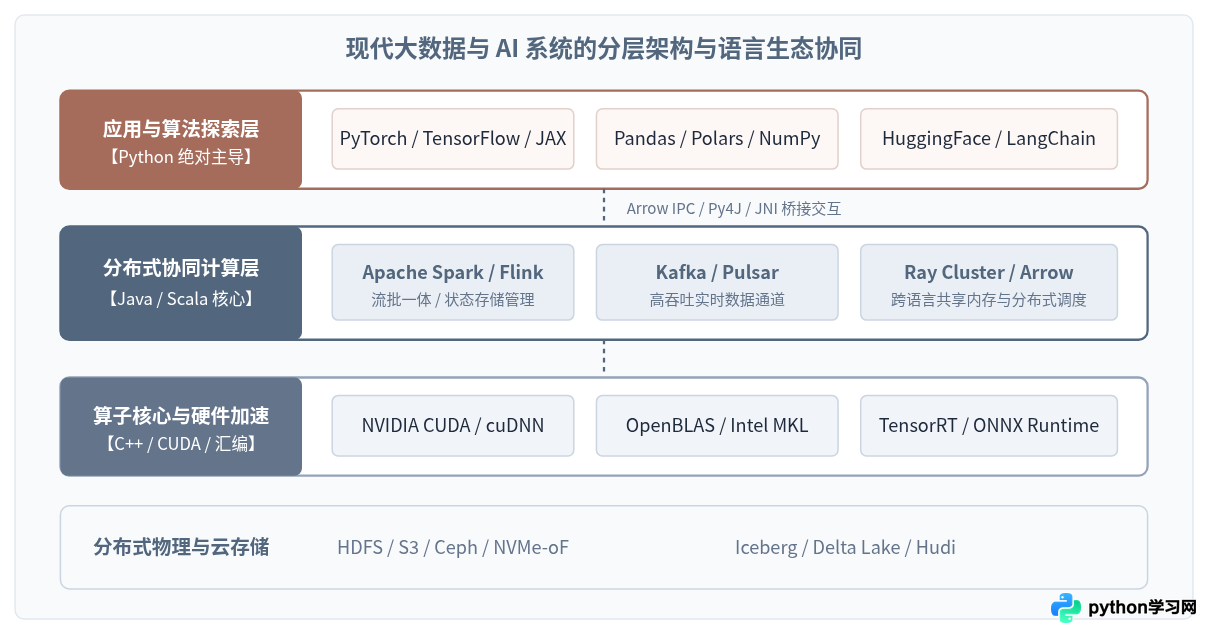
大数据领域曾被认为是 Java 与 Scala 独步天下的阵地。Hadoop HDFS、MapReduce、Apache Spark、Apache Flink、Kafka、HBase 等核心基础设施无一例外建立在 JVM 之上。这些系统之所以采用 Java/Scala,是因为它们本质上属于分布式网络通信、持久化存储调度与强一致性状态机工程。对于此类需要管理数千个节点并发、复杂线程池调度和超大规模集群协议的任务,Java 的成熟度无可挑剔。
但当大数据体系向算法落地与深度挖掘演进时,架构发生了根本性的“分层解耦”:
- 控制面与计算面的分离:以 Apache Spark 为例,尽管其核心引擎依然是 Scala/JVM,但日常接触业务的数据分析师 80% 以上使用的是 PySpark。通过 Py4J 和基于 Apache Arrow 的向量化序列化通道,用户可以使用 Python 表达数据处理算子,底层由 JVM 集群负责分布式洗牌(Shuffle)与容错调度。
- 原生列式内存与新型计算引擎的崛起:以 Ray、Polars、DuckDB 为代表的新一代数据分析引擎,底层直接采用 C++ 或 Rust 开发,完全摆脱了 JVM 堆内存与 GC 停顿的掣肘。这些引擎均将 Python 作为第一优先级的 API 语言,使 Python 在单机百万级复杂数据清洗和分布式多任务调度中同样兼具极速执行能力。
四、开源生态:算法网络效应的不可逆壁垒
Java 社区并非没有尝试过进军深度学习。早在 2014 年起,Eclipse Deeplearning4j (DL4J)、Amazon DJL (Deep Java Library) 以及 Oracle Tribuo 等项目就曾相继诞生,致力于让企业开发者在纯 JVM 环境中训练和部署模型。然而在真实工业实践中,这些项目始终处于边缘地位。
原因在于 AI 领域的强网络效应(Network Effect):
- 前沿论文与开源代码的默认绑定:NeurIPS、ICML、CVPR 等顶级 AI 会议上发表的最新架构(如 Transformer、Diffusion、LoRA、MoE),几乎 100% 由原作者在 GitHub 开源基于 PyTorch 或 JAX 实现的 Python 代码和预训练权重。如果一个团队选择 Java 开发栈,意味着每出现一个突破性算法,都必须自行使用 Java 重新实现一遍算子并调试精度。这一巨大的延迟直接切断了技术同步通道。
- 模型与应用生态的马太效应:如今的 AI 开发已经不再是从零写神经网络,而是依托 Hugging Face 模型集市、LangChain、LlamaIndex、vLLM 以及 Gradio 等工具链进行高效微调与应用组装。这些工具链全面生长在 Python 原生环境中,形成了难以逾越的工程生态护城河。
代码表达对比:一个张量线性变换的视觉差异
以下示例直观体现了在算法开发阶段,两门语言对同一数学公式表达的认知复杂度差异:
Python (PyTorch) 表达方式:
import torch
import torch.nn as nn

# 定义一个带残差连接的简单特征投影层
class ResidualBlock(nn.Module):
    def __init__(self, dim):
        super().__init__()
        self.fc = nn.Linear(dim, dim)
        self.relu = nn.ReLU()

    def forward(self, x):
        # 原生操作符重载与直观的张量加法
        return self.relu(self.fc(x)) + x

x = torch.randn(32, 128)
model = ResidualBlock(128)
output = model(x)
print(f"输出形状: {output.shape}")
Java (基于通用矩阵库或自封装 API) 常见表达方式:
// 需处理类结构声明、泛型包装、异常检查及显式内存销毁
public class ResidualBlock implements AutoCloseable {
    private final LinearOperator fc;
    private final Activation relu;

    public ResidualBlock(int dim) {
        this.fc = new LinearOperator(dim, dim);
        this.relu = new ReLUActivation();
    }

    public Tensor forward(Tensor x) {
        Tensor projected = this.fc.apply(x);
        Tensor activated = this.relu.apply(projected);
        Tensor out = TensorMath.add(activated, x); // 无法直接使用 + 操作符
        projected.close(); // 显式释放堆外显存,避免显存泄露
        activated.close();
        return out;
    }

    @Override
    public void close() {
        fc.close();
    }
}close() 释放显存,极易因疏忽引发显存溢出(OOM),破坏了托管语言原本的易用优势。
五、选型矩阵与工业落地:两者的工程分工界限
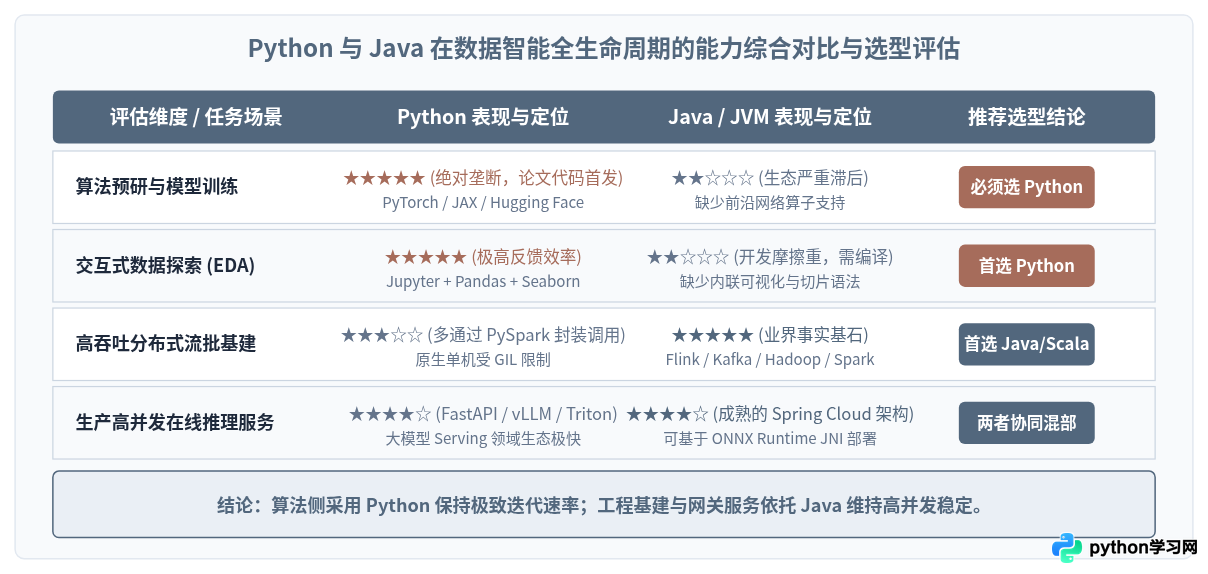
明确了底层机制与生态差距后,并不意味着需要把 Java 从数据和 AI 系统中完全剔除。理性的架构决策是扬长避短,各司其职。
在现代成熟企业的数据中台与 AI 平台建设中,业界普遍采用如下的分工落地模式:
六、总结与落地建议
大数据与 AI 领域首选 Python,并非因为 Python 是一门在所有方面都完胜的语言,而是因为它在恰当的历史契机下,找到了自身最精准的生态定位——作为高阶抽象层,向上提供最符合人类数学直觉的代码表达与实验环境,向下直接调度由 C/C++ 与 GPU 算子编写的硬核算力。
对于技术团队的落地建议:
- 不要试图用 Java 全盘重写算法层:算法研发、模型微调、特征探索应坚定选择 Python 生态,紧随学术界最新的模型权重与开源成果,避免因重写算子丧失技术先进性。
- 工程落地阶段解耦对接:通过 ONNX、TensorRT、TorchScript 等工业标准格式,将 Python 训练好的模型进行计算图冻结与序列化。在生产推理环节,既可以通过 C++ / Python 服务(如 Triton Inference Server、vLLM)暴露高性能 gRPC / HTTP 接口,也可以由 Java 企业网关直接调用进行结果组装。
- 善用混合架构红利:分布式数据预处理依赖 Java/Scala 编写的 Spark/Flink 集群,算法侧通过 PySpark 或基于 Arrow 的跨语言 IPC 管道无缝承接,形成兼具高吞吐工程稳定性与敏捷算法创新的现代化架构。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















