


Python time.sleep() 基础用法:参数含义与阻塞特性

在编写 Python 程序时,经常需要让程序暂停一段时间,例如在轮询检查接口、控制爬虫抓取频率、等待硬件就绪或执行定期任务时。标准库提供的 time.sleep() 是实现延时等待最直接的内置函数。本文将直接解析该函数的参数取值规则、系统级精度,并深入说明其同步阻塞特性的运行机制与使用注意事项。
一、函数原型与参数规格
time.sleep() 属于 Python 官方内置的 time 模块,调用前必须先使用 import time 导入。该函数用于让当前执行的线程暂停指定时间,其声明如下:
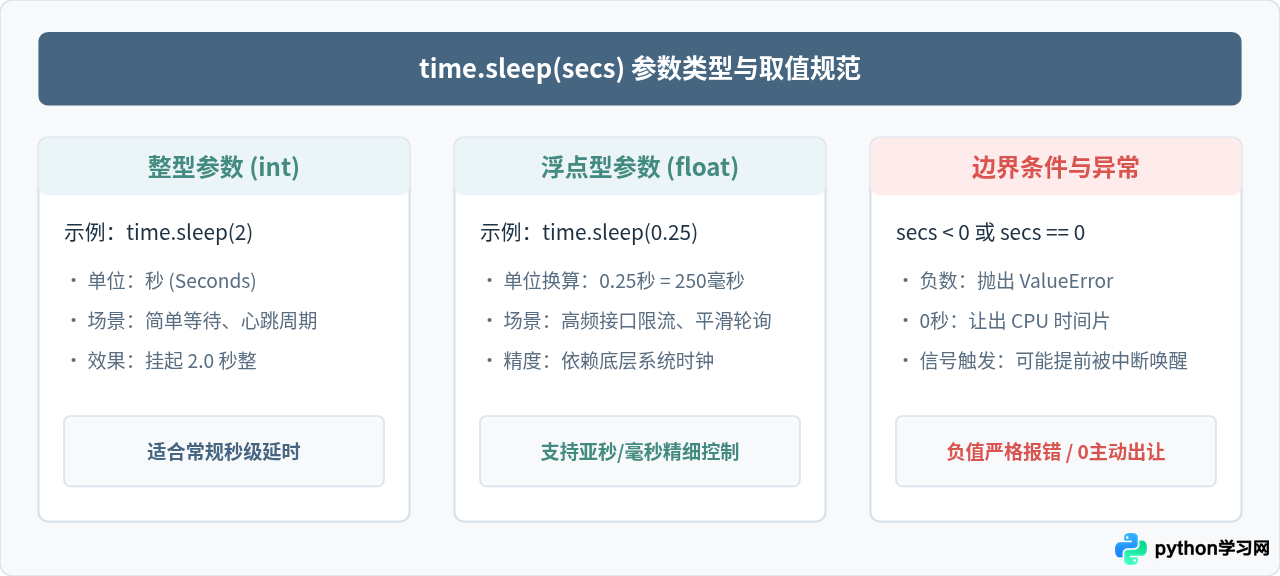
time.sleep(secs)参数 secs 代表程序暂停的秒数。虽然参数名称在直觉上容易让人联想到整数,但在 Python 中,它具备以下明确的类型规范与边界特征:
- 支持整型与浮点型:
secs可以传入整数(如time.sleep(3)暂停 3 秒),也可以传入浮点数(如time.sleep(0.5)暂停 500 毫秒、time.sleep(0.01)暂停 10 毫秒),实现亚秒级甚至毫秒级的暂停。 - 非负数约束:参数必须大于或等于 0。如果传入负数,解释器会立即抛出
ValueError: sleep length must be non-negative异常。 - 零秒特殊含义:当传入
time.sleep(0)时,程序不会真正睡眠,但它会通知底层操作系统重新进行线程调度,主动交出当前线程剩余的 CPU 时间片给其他就绪线程,随后立即返回。
二、基础操作步骤与典型使用场景
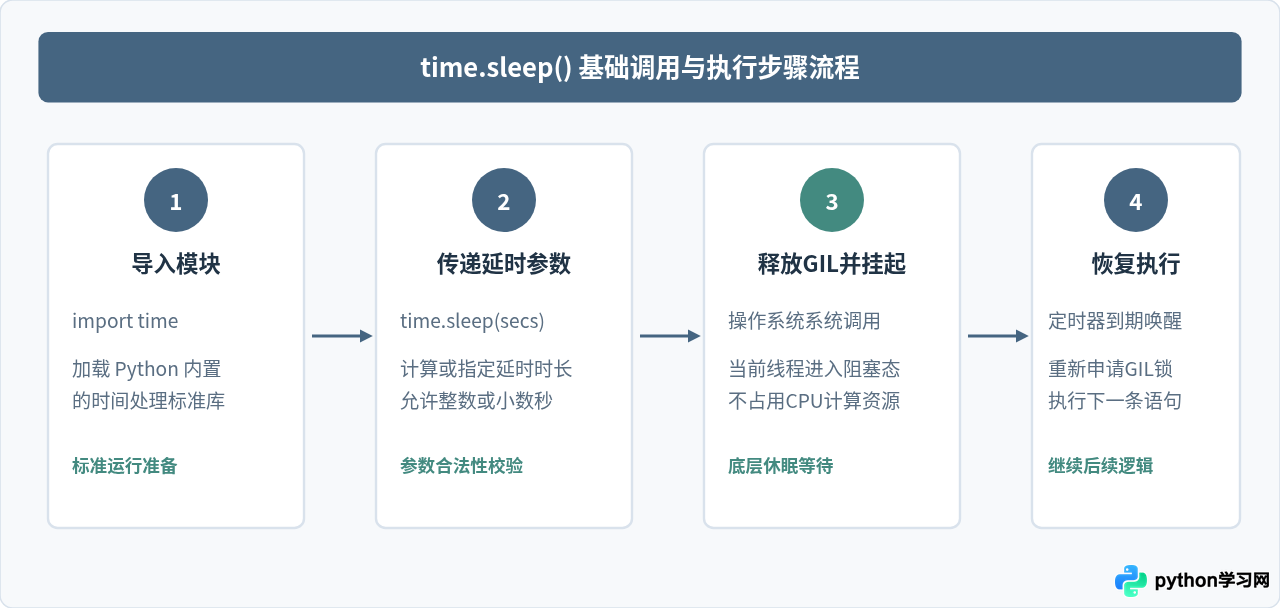
在实际编码中,使用 time.sleep() 遵循“导入、传参、挂起、继续”四步标准流程。下面通过一段完整的代码演示常见的请求轮询与失败重试逻辑:
import time

def poll_service_status(max_retries=3, interval=1.5):
    """模拟对外部服务的状态轮询,每次失败后休眠指定秒数"""
    print("开始检查外部服务可用性...")
    for attempt in range(1, max_retries + 1):
        print(f"[{time.strftime('%H:%M:%S')}] 第 {attempt} 次检测服务...")

        # 假设前两次检测未准备好,第三次成功
        service_ready = (attempt == 3)
        if service_ready:
            print("服务已就绪,退出检测循环。")
            return True

        print(f"服务暂未就绪,等待 {interval} 秒后重试...")
        time.sleep(interval)

    return False

poll_service_status()
运行上述脚本的示例输出如下:
开始检查外部服务可用性...
[14:20:00] 第 1 次检测服务...
服务暂未就绪,等待 1.5 秒后重试...
[14:20:01] 第 2 次检测服务...
服务暂未就绪,等待 1.5 秒后重试...
[14:20:03] 第 3 次检测服务...
服务已就绪,退出检测循环。
从时间戳可以看出,每一次调用 time.sleep(1.5),脚本都会准确挂起约 1.5 秒,避免了无休止的死循环对 CPU 造成 100% 占用的问题。
三、阻塞特性的本质与线程行为剖析
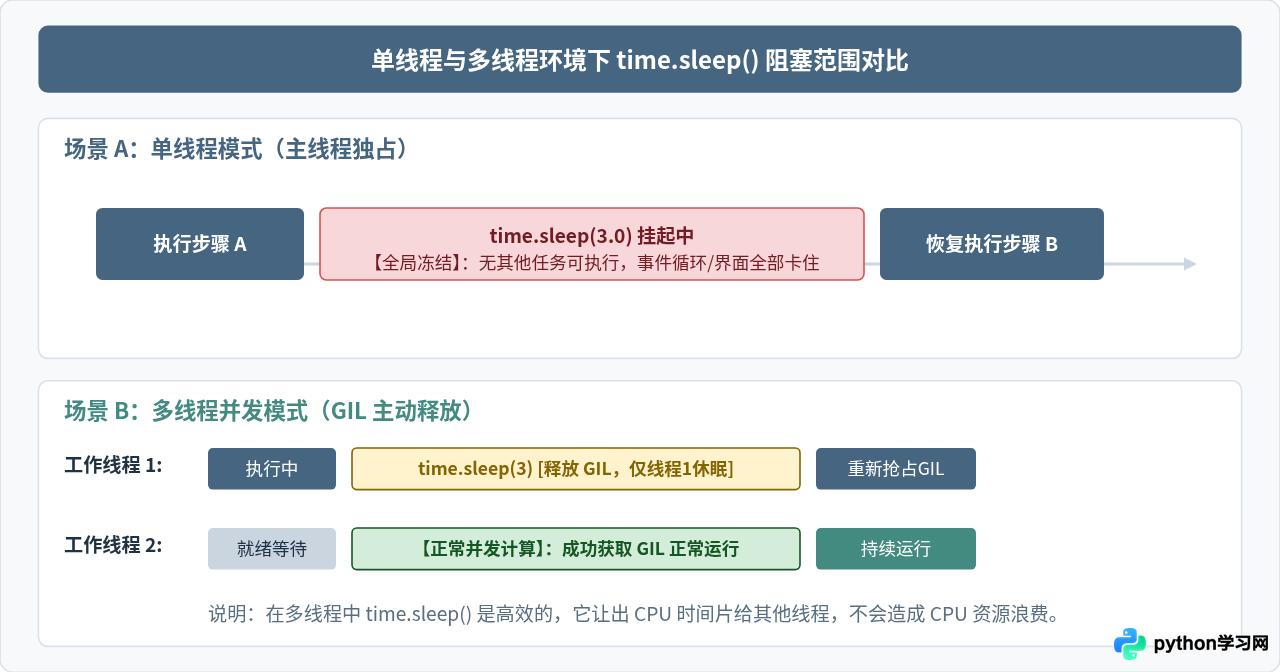
理解 time.sleep() 的关键在于其同步阻塞(Synchronous Blocking)特性。当代码执行到该函数时,当前执行流会立即停顿,直到指定的时长过去或收到系统中断信号为止。然而,在单线程与多线程环境下,阻塞的具体表现截然不同:
1. 单线程环境:整体执行冻结
在默认的单线程 Python 脚本中,整个程序只有一个执行流。调用 time.sleep(5) 意味着这 5 秒内,程序完全无法响应任何其他任务:无法处理用户输入、无法刷新界面、也无法处理新到来的网络请求。这就是为什么在 Tkinter 或 PyQt 等图形界面程序的主线程中调用 time.sleep() 会导致窗口瞬间“卡死”无响应。
2. 多线程环境:仅阻塞调用线程,GIL 会被释放
很多初学者误以为 Python 拥有全局解释器锁(GIL),调用 time.sleep() 会导致所有线程都被锁死。事实上,Python 在执行 time.sleep() 进入内核级等待之前,会主动释放当前持有的 GIL。
这意味着:time.sleep() 仅挂起发起调用的那一个子线程,其他工作线程完全可以获取 GIL 继续执行 CPU 计算或 I/O 操作。线程在睡眠期间,既不占用 CPU 时间片,也不会阻塞其他线程的并发运行。
四、精度限制与常见误区
| 对比维度 | time.sleep(secs) |
asyncio.sleep(secs) |
|---|---|---|
| 所属类型 | 同步系统调用(底层为 OS sleep / nanosleep) | 异步协程(协程级定时器) |
| 阻塞对象 | 当前操作系统级线程(OS Thread) | 当前异步协程(Coroutine),不阻塞线程 |
| 适用场景 | 普通多线程脚本、后台批处理、简单重试 | 异步网络框架(FastAPI、Tornado、aiohttp) |
| 高并发影响 | 若在单线程事件循环中调用,会直接冻结整个事件循环 | 仅挂起当前协程,其他数万个并发协程仍正常响应 |
开发者在初次使用 time.sleep() 时,容易踩入以下三个常见误区:
- 误区一:混淆毫秒与秒的单位。很多其他编程语言(如 Java 的
Thread.sleep(1000)或 JavaScript 的setTimeout(fn, 1000))参数单位均为毫秒。而 Python 的time.sleep()单位始终是秒。如果误将 1000 传入,程序将被挂起近 17 分钟。休眠 500 毫秒应写为time.sleep(0.5)。 - 误区二:在
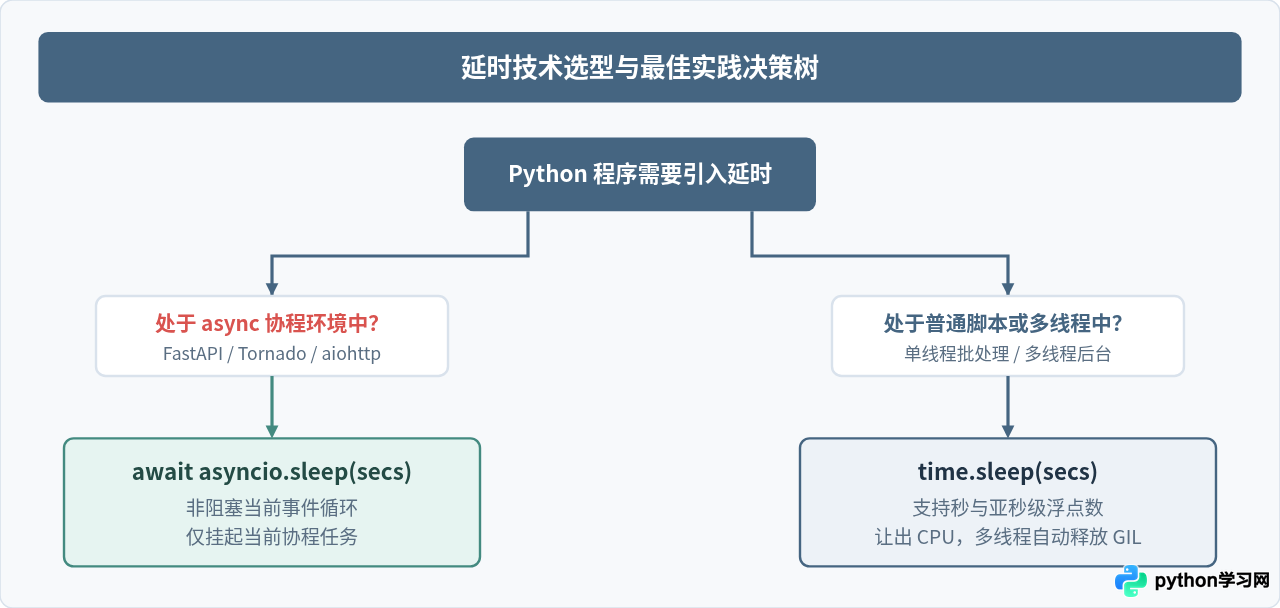
async def异步函数中使用time.sleep()。在 asyncio 架构中,所有协程共用同一个主线程事件循环。若在协程内直接调用同步的time.sleep(2),会导致整个事件循环停止转动 2 秒,期间所有网络并发请求都会被卡死。正确的做法是使用await asyncio.sleep(2)。 - 误区三:假定延时具有硬实时级别的微秒绝对精度。
time.sleep()的实际唤醒时间受操作系统进程调度与时钟中断周期的影响(例如 Windows 平台下默认系统时钟粒度通常在 10~15 毫秒左右)。因此,休眠0.001秒(1毫秒)可能实际经历 2~15 毫秒才被系统调度器唤醒。它不能作为工业级硬实时控制的精密时基。
五、核心结论与实用建议
time.sleep(secs)接收以秒为基准的非负数值,传入浮点数即可实现毫秒级延时。- 它是同步阻塞函数。在单线程环境下会挂起整个程序;但在多线程环境下,Python 会主动释放 GIL,只挂起调用线程,不影响其他线程并行工作。
- 在
asyncio协程体系中切勿使用time.sleep(),而应使用await asyncio.sleep()保持事件循环畅通。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















