


Python怎么实现浅拷贝和深拷贝?

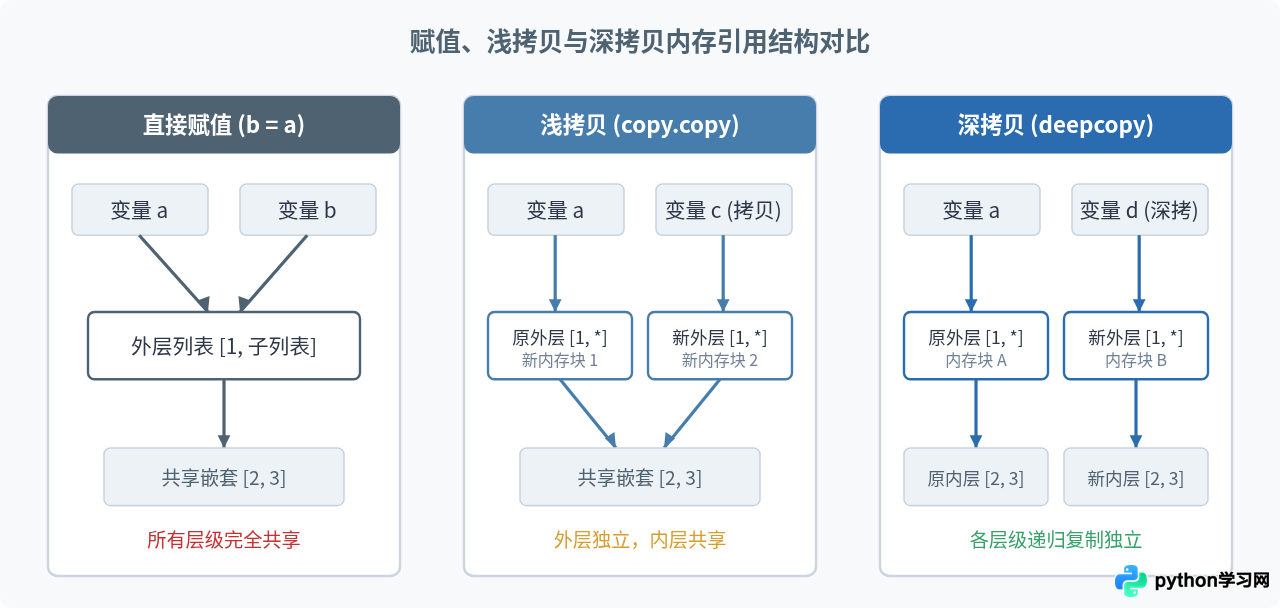
在 Python 中,直接使用等号赋值(如 b = a)并不会创建新的对象副本,而仅仅是将新变量名绑定到已有的内存对象上。要真正复制对象并脱离原始引用的影响,通常使用标准库的 copy 模块:通过 copy.copy() 实现浅拷贝,通过 copy.deepcopy() 实现深拷贝。浅拷贝只复制最外层的容器对象,其内部嵌套的子元素依然共享原有的内存引用;而深拷贝会自顶向下递归复制所有层级的嵌套对象,使得新旧两个数据结构彻底解耦、互不影响。
一、直接赋值与对象复制的本质区别
理解拷贝的前提是区分 Python 中的“变量绑定”与“对象创建”。在 Python 内部,变量名本质上是指向内存地址的引用指针。当执行简单的赋值语句时,Python 只是给目标对象贴上了一个新的标签,并未在内存中开辟新的存储空间。
# 示例:直接赋值只是共享同一个引用
original_list = [1, 2, [3, 4]]
assigned_list = original_list

# 修改新变量中的元素
assigned_list[0] = 99
assigned_list[2].append(5)

# 查看原列表与新列表
print("original_list:", original_list)
print("assigned_list:", assigned_list)
print("内存地址是否相同:", id(original_list) == id(assigned_list))
# 示例输出:
original_list: [99, 2, [3, 4, 5]]
assigned_list: [99, 2, [3, 4, 5]]
内存地址是否相同: True从输出中可以看到,无论是修改第一层的数值还是修改第二层的子列表,原列表与新变量都保持同步变化,因为它们指向完全相同的内存地址。当我们需要一个可以独立修改的副本时,就必须使用真正的拷贝技术。
二、Python实现浅拷贝的常用方法
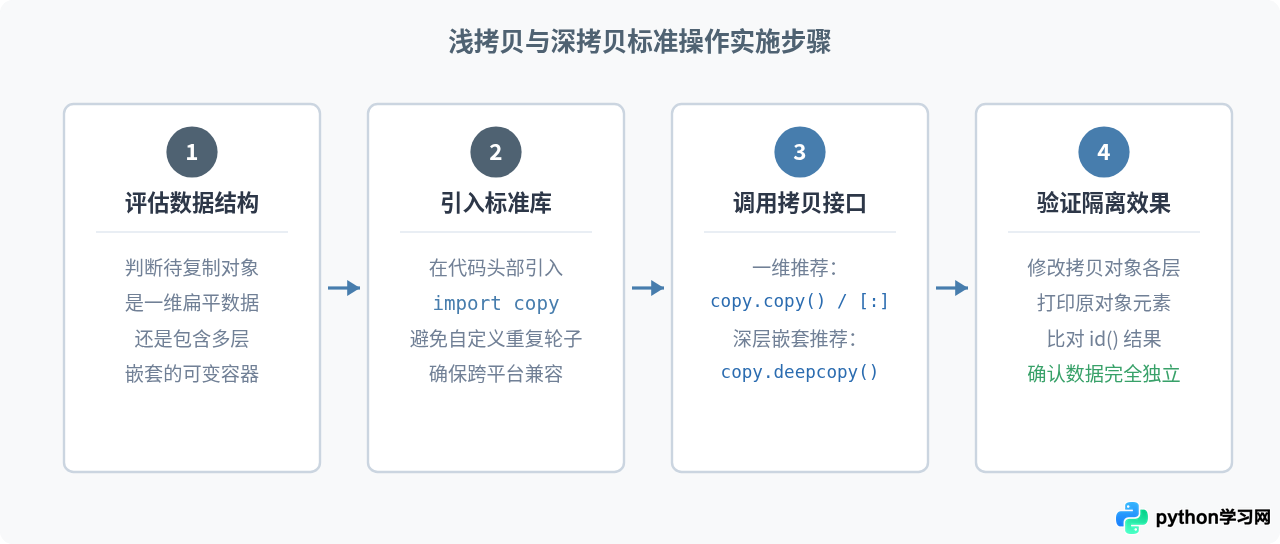
浅拷贝会构造一个新的复合对象,然后尽可能地将原始对象中各元素的“引用”插入到新对象中。实现浅拷贝有多种途径,具体根据操作的数据结构类型而定。
1. 使用 copy 模块的 copy() 函数
这是最标准、最通用的浅拷贝实现方法,适用于列表、字典、集合以及自定义类对象:
import copy

origin = [10, 20, [30, 40]]
shallow_copied = copy.copy(origin)

# 验证外层对象地址是否独立
print("外层ID相同:", id(origin) == id(shallow_copied))  # False

# 修改浅拷贝对象的第一层元素
shallow_copied[0] = 999
print("原列表第一层:", origin[0])          # 仍然是 10,互不干扰

# 修改浅拷贝对象的内层嵌套元素
shallow_copied[2].append(50)
print("原列表嵌套层:", origin[2])          # 变为 [30, 40, 50],发生了相互影响
2. 内置容器的快捷浅拷贝语法
对于常用的 Python 容器类型,语言本身提供了简捷的原生浅拷贝方式:
- 列表切片:
new_list = old_list[:]。通过全切片生成新的列表容器。 - 工厂函数转换:
new_list = list(old_list)或new_dict = dict(old_dict)。 - 字典与集合的 copy 方法:
new_dict = old_dict.copy()或new_set = old_set.copy()。
三、Python实现深拷贝的完整方法
当对象结构复杂,包含多层嵌套列表、嵌套字典或者对象属性之间存在层级关联时,必须使用 copy.deepcopy() 进行深拷贝。深拷贝会从外向内层层递归遍历,把遇到的每一个复合对象都创建出一份新的副本,并在新副本中建立与原对象相同的结构拓扑。
import copy

# 准备包含两层嵌套结构的复杂字典
user_data = {
    "name": "张三",
    "roles": ["editor", "reviewer"],
    "profile": {
        "city": "北京",
        "scores": [88, 92]
    }
}

# 执行深拷贝
deep_copied_user = copy.deepcopy(user_data)

# 修改深拷贝副本的深层嵌套数据
deep_copied_user["roles"].append("admin")
deep_copied_user["profile"]["city"] = "上海"
deep_copied_user["profile"]["scores"][0] = 100

# 检查原数据
print("原始 roles:", user_data["roles"])
print("原始 profile.city:", user_data["profile"]["city"])
print("原始 profile.scores:", user_data["profile"]["scores"])
# 示例输出:
原始 roles: ['editor', 'reviewer']
原始 profile.city: 北京
原始 profile.scores: [88, 92]可以看到,无论嵌套多深,对深拷贝对象的修改都不会波及到原始字典,新旧数据在内存中彻底解耦。
深拷贝如何防止死循环(循环引用)?
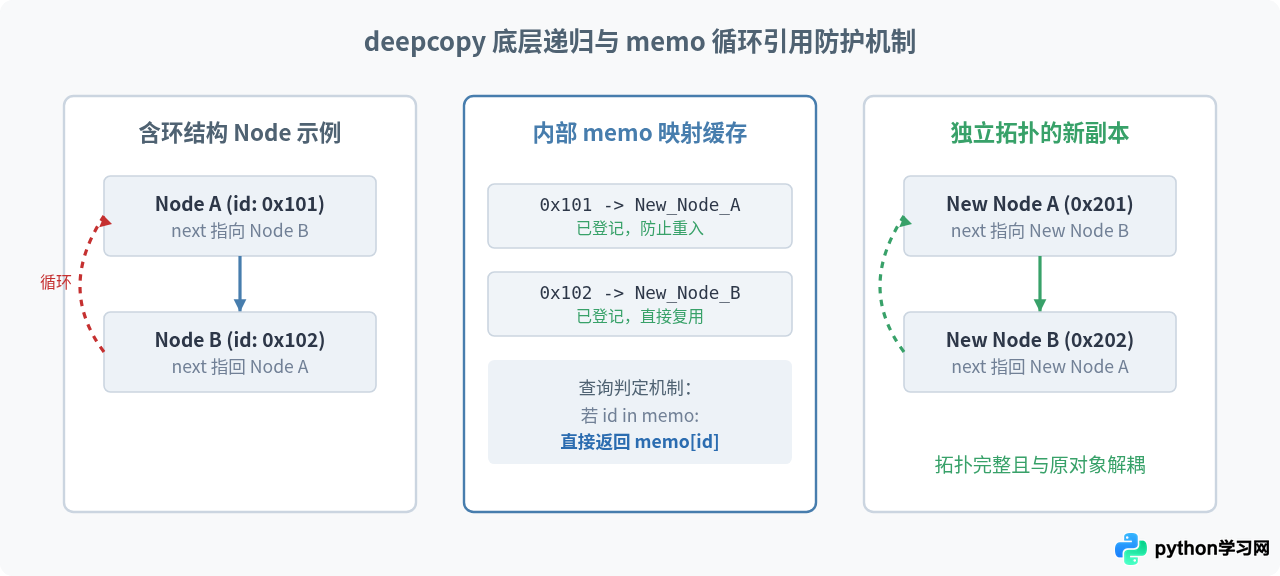
在复杂数据结构中,常常出现对象自我引用或双向引用的情况(如 node.next = node)。如果采用普通的递归复制,会导致无限递归引发 RecursionError。copy.deepcopy() 在内部维护了一个名为 memo 的字典映射:
- 当开始拷贝一个对象时,先检查其
id(obj)是否已存在于memo中。 - 如果已存在,说明该对象在此次递归链中已被复制过,直接返回之前创建的新副本。
- 如果不存在,则先在
memo中登记,再递归拷贝其内部子元素。这一机制从根本上杜绝了循环引用的死循环风险。
四、自定义类支持浅拷贝与深拷贝
在自定义类中,如果希望精确控制对象的拷贝行为(例如某些资源如网络连接不能拷贝、某些敏感字段在拷贝时重置),可以重写类的特殊魔法方法:
__copy__(self):定义调用copy.copy(obj)时的行为。__deepcopy__(self, memo):定义调用copy.deepcopy(obj, memo)时的行为,必须接收并透传memo字典。
import copy

class ConnectionSession:
    def __init__(self, username, data, token):
        self.username = username
        self.data = data      # 可变列表
        self.token = token    # 临时会话凭证

    def __copy__(self):
        # 浅拷贝自定义实现:共享 data,保留原 token
        cls = self.__class__
        new_instance = cls.__new__(cls)
        new_instance.username = self.username
        new_instance.data = self.data
        new_instance.token = self.token
        return new_instance

    def __deepcopy__(self, memo):
        # 深拷贝自定义实现:递归拷贝 data,同时重置敏感 token
        cls = self.__class__
        new_instance = cls.__new__(cls)
        memo[id(self)] = new_instance
        new_instance.username = self.username
        new_instance.data = copy.deepcopy(self.data, memo)
        new_instance.token = None  # 独立副本安全置空
        return new_instance

session = ConnectionSession("admin", ["log1", "log2"], "auth_secret_998")
cloned_session = copy.deepcopy(session)

print("克隆对象 token:", cloned_session.token)
print("原数据与克隆数据是否解耦:", session.data is not cloned_session.data)
# 示例输出:
克隆对象 token: None
原数据与克隆数据是否解耦: True五、开发中常见误区与选型总结
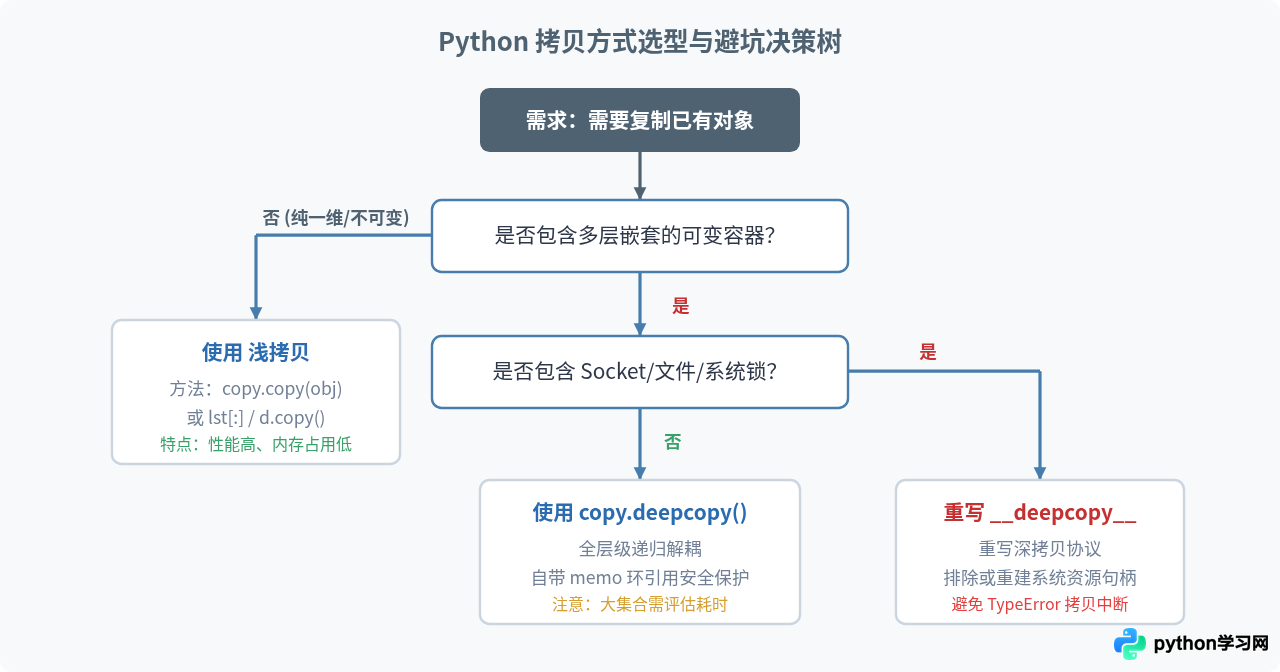
在工程实践中,选择浅拷贝还是深拷贝需要综合考量数据安全与执行效率:
- 不可变对象的单例优化:对于纯数字、字符串、以及仅含不可变元素的元组,Python 的
copy()和deepcopy()都不会真正复制数据,而是直接返回原对象。这是因为不可变对象内容不可修改,共享引用绝对安全且节约内存。 - 深拷贝的性能开销:深拷贝涉及完整的对象树遍历、反射构造及
memo查找,在面对数十万级别元素的大字典、复杂图网络或深层树状结构时,耗时与内存增长显著。若结构仅为一维,切勿无脑使用deepcopy。 - 系统资源对象无法拷贝:如果对象中包含打开的本地文件句柄、Socket 网络套接字、数据库长连接或多线程锁(Lock),
copy.deepcopy()会抛出TypeError: cannot pickle / cannot copy错误。这类资源必须在自定义的__deepcopy__中排除或重新显式初始化。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















