


Conda和pip升级Python第三方库有什么区别

在日常使用Python进行开发时,我们经常需要升级已安装的第三方库。虽然表面上执行conda update package-name与pip install --upgrade package-name都能提升库的版本,但两者的底层工作机制完全不同:Conda把Python运行环境、二进制动态链接库与第三方库作为一个整体通过SAT求解器进行全量依赖协商;而pip则将视野聚焦于Python包生态(PyPI),主要针对目标包及其直接依赖树进行升级。深入理解两者的依赖解析模型、包安装格式与受控范围,能帮我们在科学计算与常规工程开发中彻底避免环境崩溃。
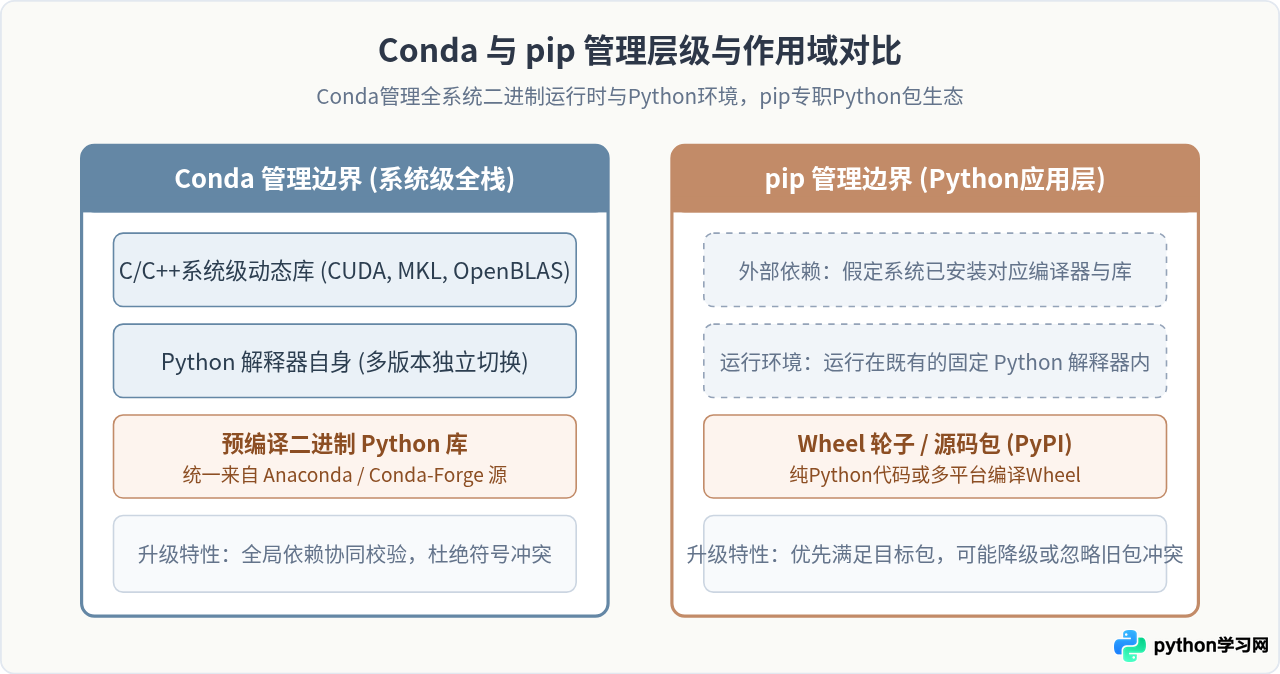
一、核心判断:管理定位与生态视角的根本差异
要说清楚升级时的区别,首先需要厘清两者的定位差异:
- pip 是 Python 官方推荐的通用包安装工具,其定位是“针对当前 Python 运行环境安装与维护 PyPI(Python Package Index)发布的包”。它把底层 C 语言运行库、操作系统版本以及 Python 解释器本身视为不可变的环境前提。
- Conda 是跨语言的通用环境与包管理器,最初针对科学计算中复杂的 C/C++、Fortran 二进制依赖而设计。在 Conda 的视角里,Python 解释器自身、底层数学库(如 Intel MKL、OpenBLAS)、CUDA 驱动工具链以及具体的 Python 包,全部都是同等地位的“Conda 包”。
因此,当用户发起“升级一个库”的指令时,Conda 与 pip 背后调动的决策逻辑与资源范围有着本质不同。
二、升级机制的核心区别剖析
1. 依赖解析范围与算法策略
升级一个库最常引发的问题是:新版本往往需要更新它的下游依赖,而这些被更新的依赖很可能正是当前环境中其他库正在使用的组件。
在 Conda 中执行升级时,内置的依赖解析器(如早期默认的 SAT 求解器或新版引入的 libmamba 高效求解器)会读取当前环境中已安装的全部包元数据。求解器的任务是找到一个满足全局所有包依赖条件的“解”。如果要升级的库要求提升 numpy 版本,而环境中现有的另一个库与新版本 numpy 发生冲突,Conda 会尝试联合升级那个库,或者明确报错拒绝更新,保证现有环境的整体连贯性。
在 pip 中,尽管新版 pip(20.3+ 引入新解析器)具备了回溯能力,但它的解析重点依然聚集在当前安装命令所引发的依赖链上。如果在升级过程中遇到冲突,pip 经常会产生“卸载已有版本、换装新版本”的激进替换,甚至可能直接忽略环境中未在命令行指定的其它孤立应用,最终导致虽然目标库升级成功,但环境中原有的其他库因依赖版本过高而出现 ImportError。
2. 底层二进制与系统库的联动能力
Python 在科学计算和机器学习领域广泛依赖底层的 C/C++ 动态链接库。例如升级 scipy 或 pytorch 时:
- Conda 升级:不仅检查 Python 接口,还会自动下载和替换与之匹配的底层二进制支持包,例如匹配特定版本的
cudatoolkit、mkl或libgomp,无需宿主机提前装有 C++ 编译套件或特定系统驱动。 - pip 升级:优先寻找 PyPI 上的预编译 Wheel 包。如果你的系统 glibc 版本或硬件平台没有完全吻合的二进制包,pip 会退回到下载源码包(
.tar.gz)并在本地临时编译。如果本地缺少gcc、make或相关的 C 头文件,升级操作将直接抛出难以理解的编译失败报错。
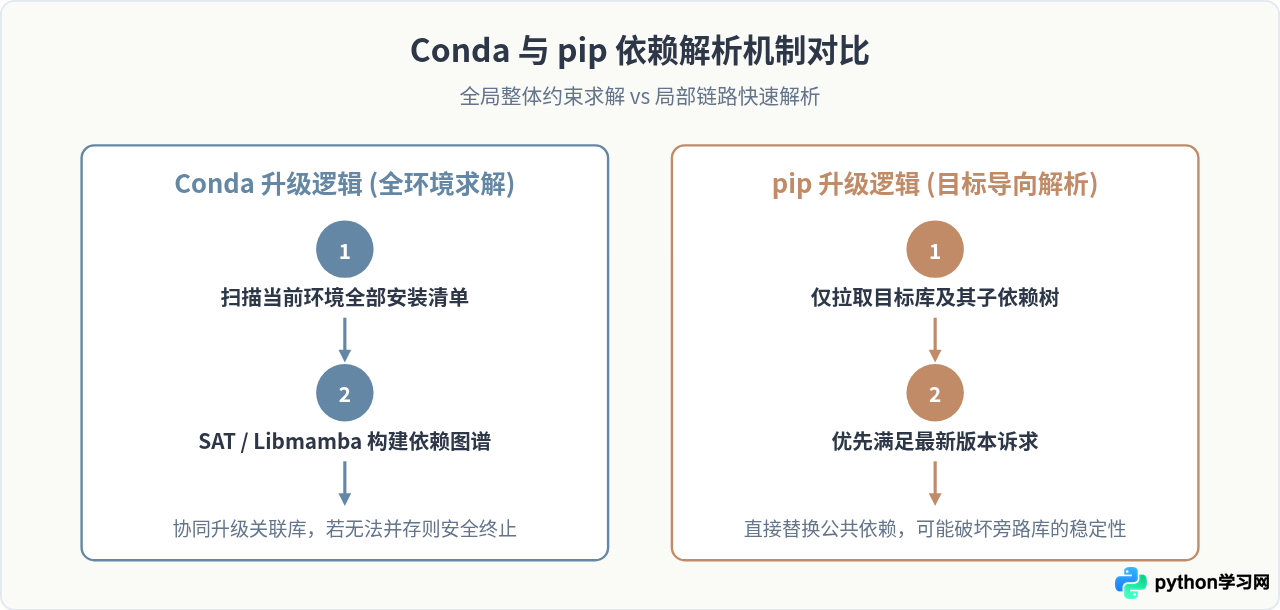
三、核心维度横向对比
| 比较维度 | Conda 升级 (conda update) |
pip 升级 (pip install -U) |
|---|---|---|
| 升级核心目标 | 在保持当前虚拟环境完整一致的前提下更新包 | 尽可能安装指定包的最新发布版本 |
| 依赖来源仓库 | Anaconda Repository、Conda-Forge 渠道 | PyPI (Python Package Index) 或私有仓库 |
| 底层支持范围 | 覆盖 C/C++ 动态链接库、CUDA、BLAS、Python自身 | 通常仅局限于 Python 包及附带预编译二进制 |
| 版本时效性 | 更新周期相对稍慢(维护者需打包与调优构建) | 极快(作者发布后几乎实时可在 PyPI 获取) |
| 升级副作用风险 | 耗时可能较长;极端情况下可能协同升级多个库 | 容易覆盖现有环境关键基础库,导致旧项目报错 |
四、实际操作步骤与验证方法
在不同场景下,我们需要选用符合预期的命令进行库升级,并对升级后的状态进行校验。
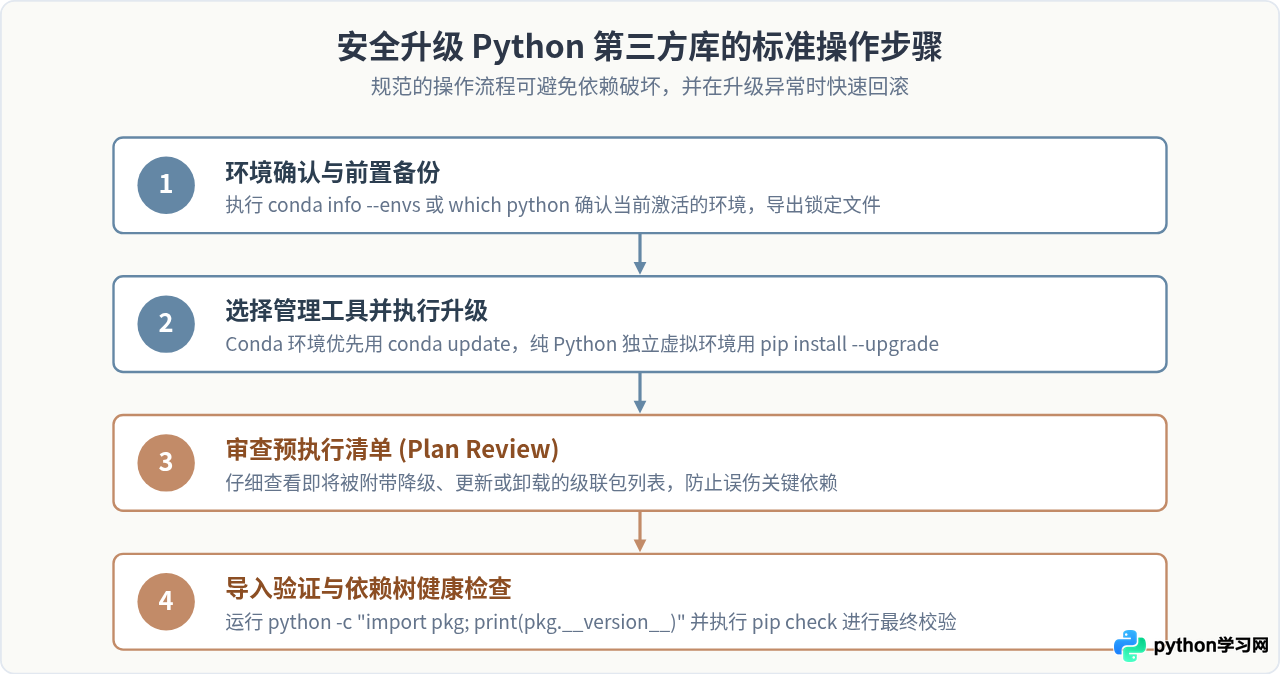
步骤一:前置准备与环境确认
在进行任何升级之前,首要任务是明确当前处于哪个环境以及该包最初是用什么工具安装的:
# 确认当前环境路径
which python

# 若为 Conda 环境,查看该包最初是由哪个渠道(Channel)安装的
conda list pandas
示例输出:
# packages in environment at /home/user/miniconda3/envs/data-analysis:
#
# Name                    Version                   Build  Channel
pandas                    1.5.3           py310h1128e8f_0    defaults
如果输出中的 Channel 列显示为 defaults、conda-forge 或具体文件名,说明它是通过 Conda 安装的;若显示为 pypi,说明它是通过 pip 安装进来的。
步骤二:使用 Conda 升级库
在以 Conda 为主的科学计算环境中,优先使用 Conda 自身指令升级:
# 检查并升级指定包
conda update pandas

# 若使用社区更丰富的 conda-forge 频道
conda update -c conda-forge pandas
Conda 在升级前会打印一个包含 The following packages will be UPDATED / DOWNGRADED 的执行计划。仔细核对列表,确认没有意外降级重要的依赖后,输入 y 确认升级。
步骤三:使用 pip 升级库
在由标准 python -m venv 创建的轻量虚拟环境,或需要立刻体验作者最新发布的特性时,使用 pip 进行升级:
# 升级指定第三方库至最新版
pip install --upgrade requests

# 或者升级至某个具体的版本区间
pip install --upgrade "requests>=2.31.0"
pip 会下载最新 Wheel 文件,并自动卸载旧版本目录中的对应代码文件。
步骤四:验证升级结果与环境健康度
升级完成后,不要只看命令行退出码为 0 就以为万事大吉,需要分别做两项确认:
# 1. 验证目标包的实际导入与版本号
python -c "import requests; print(requests.__version__)"

# 2. 检查当前虚拟环境中是否存在被破坏的依赖断层
pip check
如果 pip check 输出 No broken requirements found.,表明当前环境中所有库声明的依赖版本均处于满足状态。
在一个已安装大量 Conda 复杂科学计算库(如 NumPy、SciPy、PyTorch)的环境中,尽量不要直接使用 pip install --upgrade 去升级那些核心数学底层库。pip 在升级时意识不到 Conda 元数据(conda-meta)的存在,它可能会直接在 site-packages 下覆盖安装新文件,而保留旧的动态链接库,导致 Python 下次运行时因 C 符号表不兼容抛出难以调试的段错误(Segmentation fault)。
五、场景选型与总结决策指南
在面对具体的项目或工作流时,可遵循以下决策逻辑来选择最合适的升级策略:
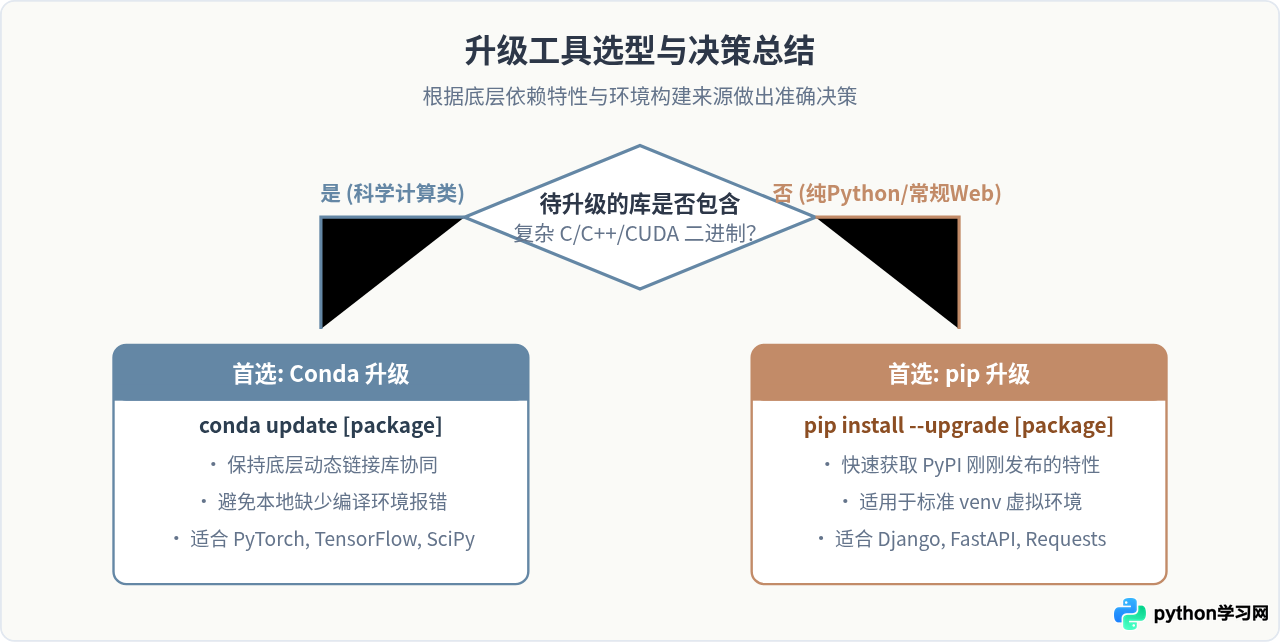
总的来说,Conda 的升级哲学是“环境第一”,它宁可推迟单个包的升级,也要全力保全整体运行时与底层二进制的稳态一致;而 pip 的升级哲学是“目标优先”,它以最高效率将指定 Python 库提升至目标版本。在实际工程中,认清当前环境的根基、遵守“用谁安装就用谁升级”的基本准则,是维护健康、可持续 Python 开发环境的关键。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















