


Python字符串排序用sorted还是list.sort?

核心结论非常明确:对单个字符串内部的字符排序必须使用 sorted(),不能直接调用 list.sort();而对字符串构成的列表进行排序时,两者皆可使用,选择取决于是否需要保留原列表以及内存开销。这是因为 Python 中的字符串属于不可变序列(immutable),本身没有提供任何就地修改的 sort() 方法。理解这两种工具的差异与适用边界,能够帮助你在实际开发中写出更加严谨、高效且符合规范的代码。
一、核心机制:为什么不能对字符串直接调用 .sort()?
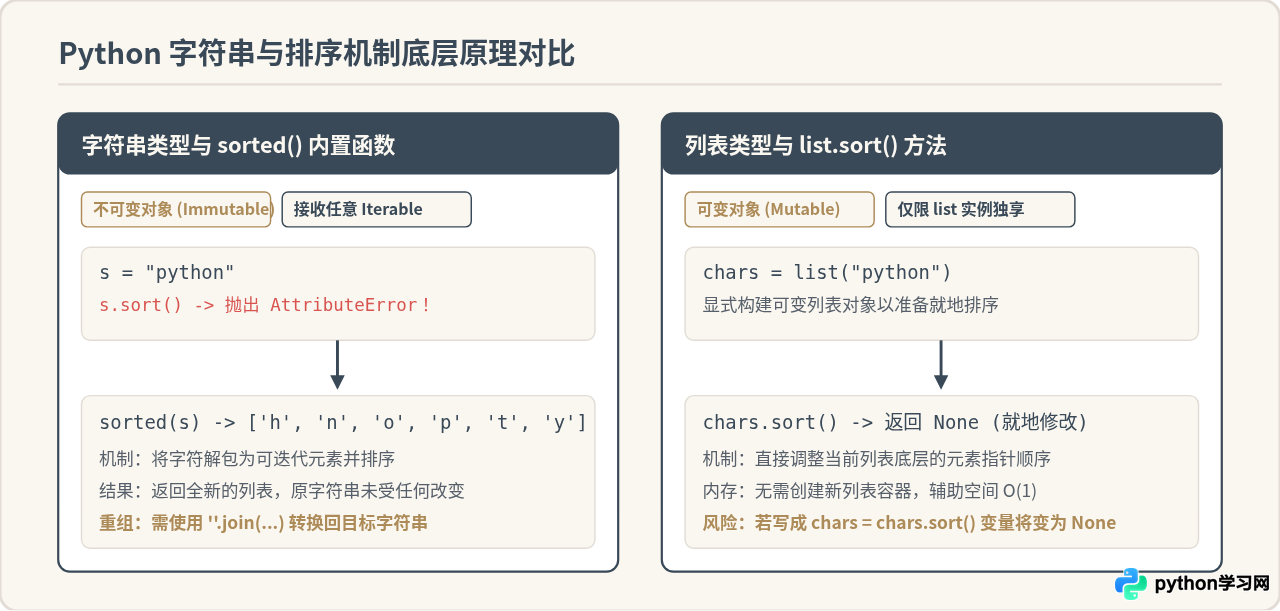
许多初学者在尝试给字符串排序时,往往会直觉性地写出 "python".sort(),结果程序立即抛出 AttributeError: 'str' object has no attribute 'sort' 异常。这并不是 Python 设计上的遗漏,而是由底层的数据类型不可变性决定的。
在 Python 的类型系统中:
- 字符串(
str)是不可变对象(Immutable): 字符串一旦在内存中创建,其内部的字符顺序和内容就无法被就地修改。任何对字符串的修改操作(例如替换、切片、排序),本质上都是在内存中创建并返回一个全新的字符串对象。 list.sort()是列表专有的就地修改方法(In-place Method): 该方法直接作用于原列表的内存地址,修改元素的物理指针顺序,并且固定返回None。既然字符串不允许就地修改,字符串类型自然不会包含sort()方法。sorted()是全局通用内置函数: 它可以接收任何可迭代对象(Iterable),包括字符串、元组、字典、集合以及列表。它的工作方式是遍历迭代器提取元素,完成排序后构建一个全新的列表(list)返回,完全不影响输入对象的原始状态。
二、场景一:对单个字符串内部的字符排序
日常编码中,“字符串排序”最常见的一种含义是将字符串内部的各个字符按升序或降序重新排列。例如将乱序字符串 "python" 转换为有序字符组成的 "hnopty"。
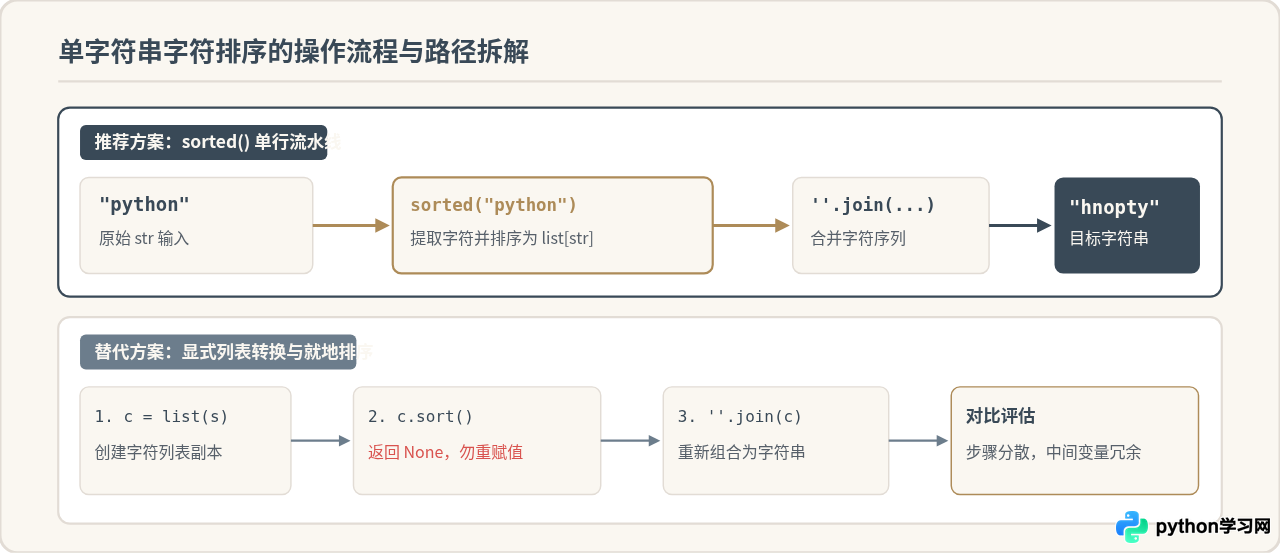
方法 1(强烈推荐):使用 sorted() 配合 str.join()
这是处理单字符串排序的标准 Pythonic 写法。由于 sorted() 接收字符串后会直接将其视为由单字符组成的迭代器,排好序后输出字符列表,最后用空字符串的 join() 方法将列表连回新字符串即可:
# 示例:使用 sorted() 对单字符串内字符排序
source_str = "python"
sorted_str = "".join(sorted(source_str))

print("原字符串:", source_str)
print("排序结果:", sorted_str)排序结果: hnopty
方法 2:显式转换为列表后使用 list.sort()
如果坚持要使用 list.sort(),你必须先使用 list() 将不可变的字符串转化为由单字符构成的列表,调用 sort() 完成内部排序,最后再执行 join():
# 示例:通过 list.sort() 完成单字符串字符排序
source_str = "python"
char_list = list(source_str)  # 步骤 1:转为列表
char_list.sort()              # 步骤 2:就地排序,无返回值
sorted_str = "".join(char_list) # 步骤 3:拼接为新字符串

print("排序结果:", sorted_str)sort() 的返回值 None)。sorted() 单行代码即可完成全流程,语义直接,是单字符串字符排序的唯一首选。
三、场景二:对字符串列表排序
第二种场景是读者手中已经拥有一个字符串列表(例如 words = ["banana", "apple", "cherry"]),需要对其进行字母升序或特定规则排序。此时,sorted() 和 list.sort() 都可以胜任,两者的技术决策点集中在内存使用与是否需要保留原始数据上。
1. sorted(list):安全、非破坏性的外部排序
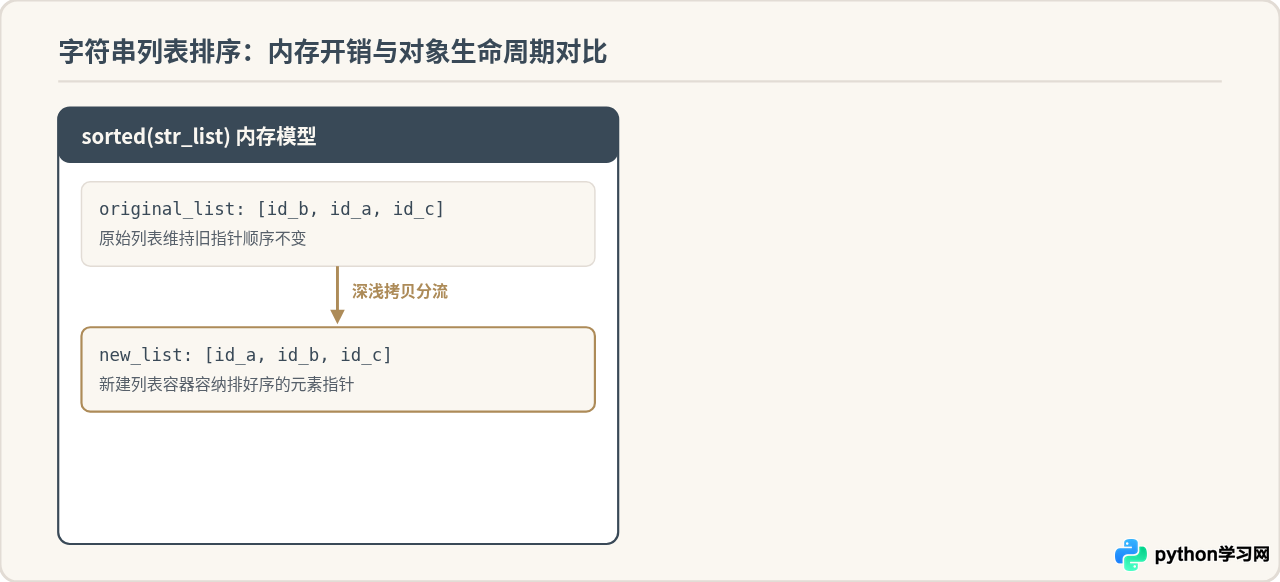
当需要保留原列表中单词的原始顺序,或者希望以函数式风格直接链式处理数据时,使用 sorted():
# 示例:使用 sorted() 对字符串列表排序
original_list = ["banana", "apple", "cherry", "date"]
sorted_list = sorted(original_list)

print("原列表:", original_list)
print("新列表:", sorted_list)新列表: ['apple', 'banana', 'cherry', 'date']
此时 original_list 完全不受影响。这在多线程共享数据、函数参数传递或需要回溯原始输入的业务逻辑中至关重要。
2. list.sort():就地重排、极致节省内存
如果字符串列表规模庞大(例如包含数十万甚至数百万个词条),且原始顺序无需保留,直接调用列表的 sort() 方法能够节省可观的内存:
# 示例:使用 list.sort() 就地排序字符串列表
words = ["banana", "apple", "cherry", "date"]
result = words.sort()

print("words 现状:", words)
print("sort()返回值:", result)sort()返回值: None
list.sort() 的返回值是 None,绝不能写成 words = words.sort()。一旦这样赋值,words 将被覆盖为 None,原来的列表对象虽然在内存中被排了序,却会因为失去变量引用而导致后续报错。
四、进阶排序技巧:key 参数与逆序
无论是 sorted() 函数还是 list.sort() 方法,都完整支持两个关键参数:key 和 reverse。这两个参数在控制字符串比较逻辑时非常强大。
1. 忽略英文字符大小写
默认情况下,Python 按照 Unicode/ASCII 码位排序。大写字母 'A' (65) 排在小写字母 'a' (97) 之前。如果不希望大小写干扰顺序,可以传入 key=str.lower:
# 默认 ASCII 排序 vs 忽略大小写排序
fruits = ["banana", "Apple", "cherry", "date"]

# 默认排序:大写在前
print("默认排序:", sorted(fruits))

# 忽略大小写
print("忽略大小写:", sorted(fruits, key=str.lower))忽略大小写: ['Apple', 'banana', 'cherry', 'date']
2. 按字符串长度排序
如果业务需求是按字符串字符长短排列,直接传入内置的 len 函数:
words = ["python", "c", "javascript", "go", "rust"]
words.sort(key=len)

print("按长度升序:", words)3. 多维度复合排序
当长度相同时按照字典序排列,可以利用元组作为排序键:
items = ["banana", "fig", "apple", "date", "plum"]
# 优先按长度排序,长度相同时按字符字母序
sorted_items = sorted(items, key=lambda s: (len(s), s))

print("复合排序结果:", sorted_items)五、选型全景对照与决策指南
为了在实际编码时快速做出准确决策,下表系统总结了两种工具的各项指标差异:
| 对比维度 | sorted(iterable) |
list.sort() |
|---|---|---|
| 本质归属 | Python 全局内置函数 | list 对象专有的内置方法 |
| 支持的数据类型 | 任何可迭代对象(str, list, tuple, dict等) |
仅支持列表(list) |
| 返回值 | 排序后的新列表 | 固定返回 None |
| 对原对象的影响 | 完全无修改,保持原状态 | 原地修改原列表内部元素顺序 |
| 对单字符串排序 | "".join(sorted(text))(一步到位) |
需先 list() 再 sort() 再 join()(繁琐) |
| 内存开销(列表) | 额外占用 $O(N)$ 空间存储新列表 | $O(1)$ 辅助空间,极其节省内存 |
| 支持 key / reverse | 完全支持 | 完全支持 |
六、总结
回到最初的问题:“Python字符串排序用sorted还是list.sort?”
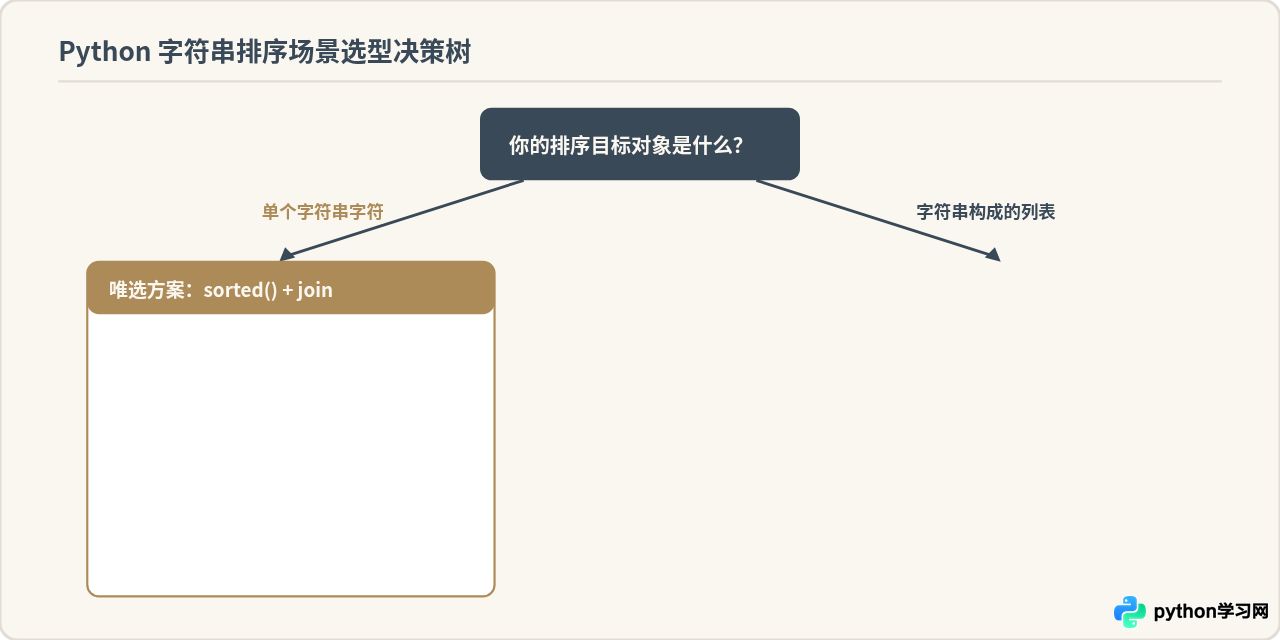
简单直接的判断准则只有两句话:
- 如果要给字符串本身的字符排队:毫不犹豫使用
"".join(sorted(str_val)),任何试图在字符串上调用.sort()的做法都会以异常告终。 - 如果要给字符串列表排队:关注原数据保留需求与内存预算。需要副本或不破坏原始输入时用
sorted(str_list),处理千万级大规模列表且不需要保留原始顺序时用str_list.sort()。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















