


Python爬虫新手入门:用Requests和BeautifulSoup抓取静态网页

抓取静态网页的核心路径可以概括为两步:先使用 Requests 库向目标服务器发送网络请求并获取返回的原始 HTML 文本,再使用 BeautifulSoup 库解析该文本并依据标签或类名提取所需信息。掌握这两个库的配合使用,就能解决绝大多数不需要在浏览器端执行 JavaScript 脚本渲染的网页数据采集任务。
一、静态网页抓取的机制与工具分工
网页通常分为静态网页与动态渲染网页两类。静态网页的特点是:服务器返回的 HTTP 响应体中直接包含了用户在页面上看到的全部文字和排版结构。打开浏览器,右键选择“查看网页源代码”,如果目标数据已经清晰地写在 HTML 标签中,这个页面就属于可以用静态抓取方法处理的目标。
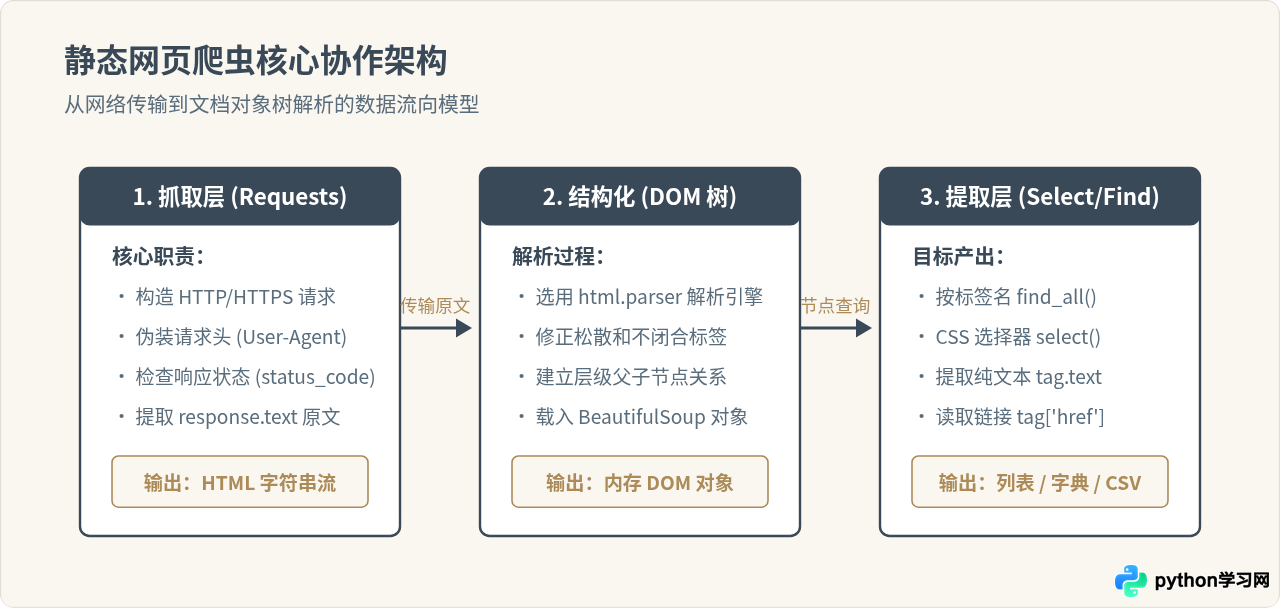
在 Python 生态中,完成这一工作通常不依赖笨重的大型爬虫框架,而是组合两个职责分明的专业库:
- Requests:专职负责网络传输。它模拟客户端浏览器向目标网址发起 GET 或 POST 请求,管理请求头(Headers)、查询参数(Params)及 Cookie,并接收服务器返回的响应状态码与文本流。
- BeautifulSoup:专职负责文档解析。原始的 HTML 只是冗长复杂的纯文本,BeautifulSoup 会将其载入内存构建成一棵树状结构(DOM 树),让开发者能够像使用放大镜一样,按标签名称、CSS 类选择器或属性快速定位并抽取目标文本。
二、环境配置与依赖安装
在开始编写代码前,需要确保系统中已安装 Python 3 环境(建议 3.8 及以上版本),并在终端或命令行界面中安装第三方库。BeautifulSoup 的发布包名称为 beautifulsoup4,安装时切勿简写为 bs4。
# 在终端或控制台中运行以下命令安装必要依赖
pip install requests beautifulsoup4
安装完成后,可以在 Python 交互环境中快速验证导入是否成功:
import requests
from bs4 import BeautifulSoup

print(requests.__name__, "加载成功")
print(BeautifulSoup.__name__, "加载成功")
若没有产生 ModuleNotFoundError 报错,则表明开发环境已就绪。
三、爬虫标准工作流四步法
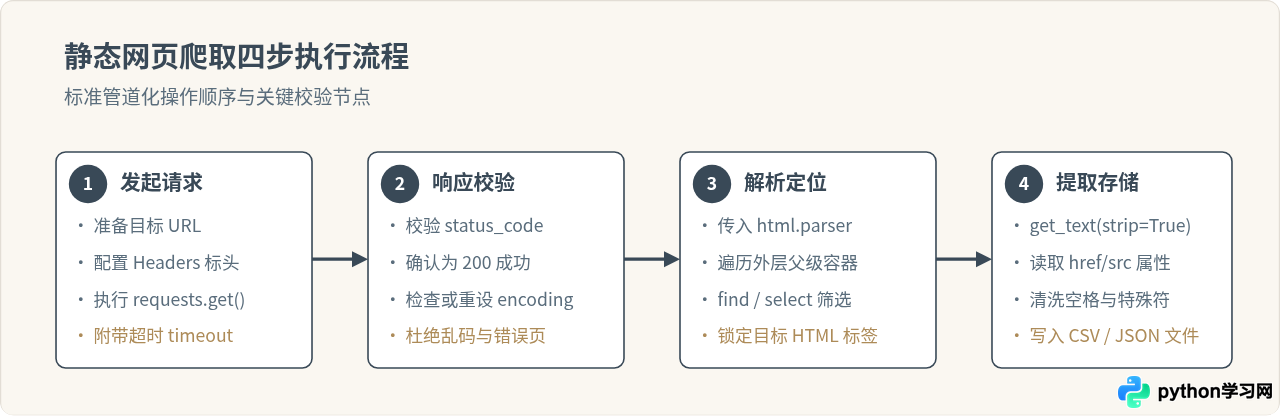
编写一个健壮的静态页面爬虫,需要严格遵守循序渐进的处理流程,而不是直接试图去抓取最终文本。标准执行流程划分为四个明确环节。
步骤一:使用 Requests 抓取内容并设置伪装
许多网站在接收到 HTTP 请求时,会检查请求头中的 User-Agent 字段。如果直接使用 Requests 且不加配置,默认发送的 User-Agent 会是类似 python-requests/2.x.x 的标识,往往会被服务器识别为脚本并返回 403 Forbidden 错误。因此,在发送请求时应主动提供标准浏览器的请求头。
import requests

target_url = "https://example.com"

# 配置标准桌面浏览器的 User-Agent 字符串
headers = {
    "User-Agent": "Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/120.0.0.0 Safari/537.36"
}

try:
    # 设置 10 秒超时,防止网络卡顿导致程序永久挂起
    response = requests.get(target_url, headers=headers, timeout=10)

    # 状态码判断:200 表示成功
    if response.status_code == 200:
        # 手动设置编码或采用 apparent_encoding 避免中文字符乱码
        response.encoding = response.apparent_encoding
        html_content = response.text
        print("成功获取网页,内容长度:", len(html_content))
    else:
        print(f"请求未成功,状态码为: {response.status_code}")
except requests.exceptions.RequestException as e:
    print("网络请求发生异常:", e)
步骤二:使用 BeautifulSoup 解析 HTML
得到 html_content 字符串后,将其交给 BeautifulSoup 初始化:
from bs4 import BeautifulSoup

# 使用 Python 内置的 html.parser 引擎解析文本
soup = BeautifulSoup(html_content, "html.parser")

# 此时 soup 是一个树状对象,可以直接访问特定标签
print("网页标题标签:", soup.title)
print("网页标题纯文本:", soup.title.string)
四、DOM 元素定位与提取核心语法对比
定位 HTML 元素是编写爬虫最消耗精力也是最关键的一步。BeautifulSoup 提供了两套平行的查找机制:一套是以 find() 与 find_all() 为代表的按属性过滤方法,另一套是以 select() 与 select_one() 为代表的 CSS 选择器语法。
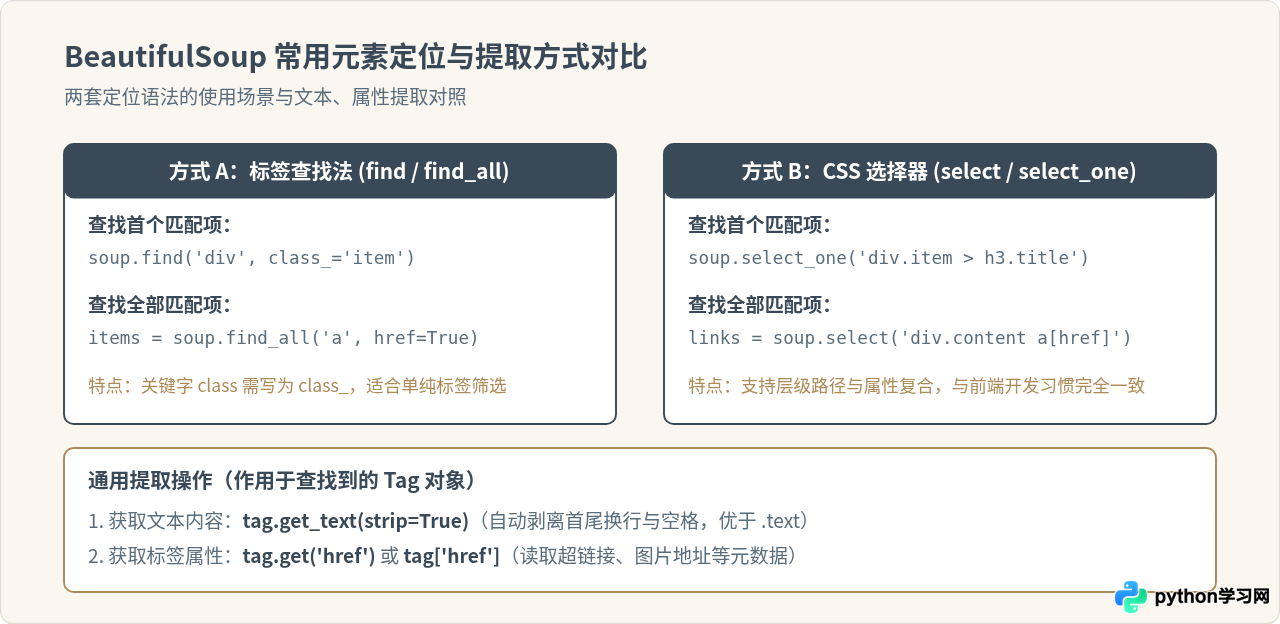
在实际工程中,建议优先掌握 select() 与 select_one()。你可以直接在现代浏览器的开发者工具(F12)中,右键点击目标元素并选择“复制 -> 复制选择器”,再粘贴到代码中微调,能极大降低编写复杂嵌套路径的门槛。
五、完整代码示例:抓取静态图书列表
下面是一个完整的可执行实战代码。以常见的图书展示结构为例,演示如何一次性提取书籍名称、价格、在库状态及详情页链接,并导出为标准的 CSV 文件。
import csv
import time
import requests
from bs4 import BeautifulSoup

def fetch_books_page(page_url):
    """抓取单页数据并返回解析后的书籍列表"""
    headers = {
        "User-Agent": "Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/120.0.0.0 Safari/537.36"
    }

    try:
        response = requests.get(page_url, headers=headers, timeout=10)
        if response.status_code != 200:
            print(f"请求失败,HTTP 状态码: {response.status_code}")
            return []
    except requests.exceptions.RequestException as err:
        print(f"网络异常: {err}")
        return []

    soup = BeautifulSoup(response.text, "html.parser")
    book_list = []

    # 1. 定位所有图书外层容器
    cards = soup.select("article.product_pod")

    for card in cards:
        # 2. 定位书名与链接
        title_tag = card.select_one("h3 > a")
        book_title = title_tag.get("title") if title_tag else "未知书名"
        book_url = title_tag.get("href") if title_tag else ""

        # 3. 定位价格标签并提取文本
        price_tag = card.select_one("p.price_color")
        book_price = price_tag.get_text(strip=True) if price_tag else "0.00"

        # 4. 定位库存状态
        avail_tag = card.select_one("p.instock.availability")
        availability = avail_tag.get_text(strip=True) if avail_tag else "无信息"

        book_list.append({
            "title": book_title,
            "price": book_price,
            "availability": availability,
            "url": book_url
        })

    return book_list

def save_to_csv(data_list, filename="books.csv"):
    """将数据持久化保存至 CSV 文件"""
    if not data_list:
        print("没有可供保存的数据")
        return

    fieldnames = ["title", "price", "availability", "url"]
    with open(filename, mode="w", encoding="utf-8-sig", newline="") as f:
        writer = csv.DictWriter(f, fieldnames=fieldnames)
        writer.writeheader()
        writer.writerows(data_list)
    print(f"数据已成功写入 {filename},共计 {len(data_list)} 条记录")

if __name__ == "__main__":
    test_url = "http://books.toscrape.com/"
    print("开始抓取网页数据...")
    books = fetch_books_page(test_url)

    # 打印前两条数据供核对
    for item in books[:2]:
        print("示例条目:", item)

save_to_csv(books)encoding="utf-8-sig" 可以防止 Windows 系统的 Excel 软件在直接双击打开文件时产生中文乱码。
六、常见问题诊断与避坑总结
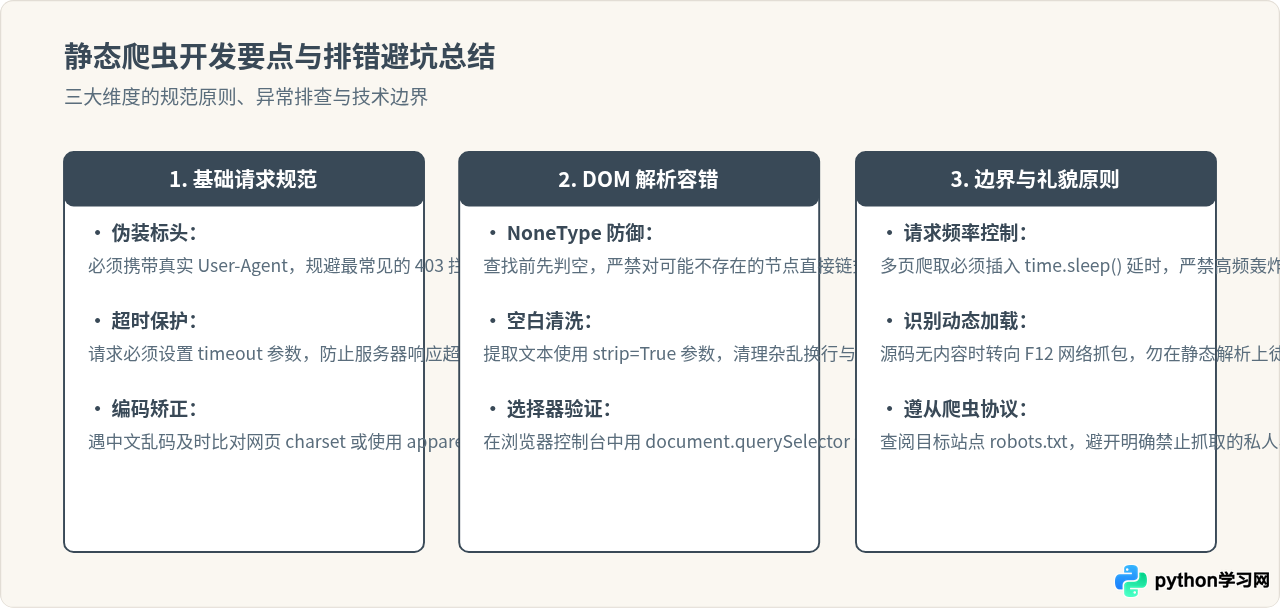
初学者在实践过程中经常会遇到“代码能运行但没有数据”或“突然报错崩溃”的情况。以下是静态爬虫开发中最容易遇到的三类典型问题及针对性排查逻辑:
- AttributeError: 'NoneType' object has no attribute 'get_text':当使用
find()或select_one()未能在页面中找到匹配标签时,方法会返回None。紧接着对None调用.get_text()或使用字典取值就会抛出该异常。解决方案是使用条件判断(例如tag.get_text() if tag else '')或tag.get('attr')安全取值。 - 网页源代码能看到内容,但爬虫打印却为空:首先检查
response.text中是否包含该字段。如果响应体中没有目标文本,说明该网页的数据是通过前端 JavaScript 异步向后端接口请求数据后填充的(Ajax 请求)。此时仅用 Requests 抓取页面 HTML 是不够的,需要通过浏览器 F12 的 Network 栏分析对应的 JSON 接口,或者使用自动化测试工具。 - 爬取多页时突然被拒绝连接(HTTP 429 或 Connection reset):短时间内发送过多连续请求会给对方服务器造成负担,容易被识别并封禁 IP。在处理多页爬取时,务必在每次循环中加入
time.sleep(1)至time.sleep(3)的停顿,模拟真实人类的访问节奏。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















