


怎么在Dify工作流中实现复杂逻辑判断与循环处理

许多初次接触 Dify 工作流的开发者,往往习惯于“直线型”思维:输入提示词,调用大模型,输出结果。这种线性结构在处理简单问答或单步生成任务时游刃有余,但一旦面对真实世界中错综复杂的业务场景——比如需要根据用户意图分流、对长列表进行逐项分析,或者将庞大逻辑拆解为独立模块时,简单的线性链条便显得捉襟见肘。
真正的自动化智能,不在于模型有多强大,而在于能否让模型在正确的时机、以正确的路径、处理正确的数据。**在 Dify 中,打破线性束缚的关键,在于熟练掌握条件分支、迭代器与子工作流这三大高级编排工具。**它们不是孤立的节点,而是构建动态、鲁棒 AI 应用的基石。本文将剥离枯燥的参数说明,从实际业务痛点出发,探讨如何利用这些工具实现复杂的逻辑判断与循环处理。
动态路由:用条件分支替代硬编码判断
在传统的脚本开发中,我们常用 if-else 语句来处理不同情况。在 Dify 工作流中,“条件分支”节点承担了这一角色,但它不仅仅是布尔值的真假判断,更是业务逻辑的分流器。
想象一个客服机器人场景:用户输入可能是咨询产品、投诉问题或寻求技术支持。如果将所有请求都扔给同一个 LLM 节点,不仅提示词会变得极其冗长复杂,还容易因上下文干扰导致回答不精准。此时,条件分支的价值就显现出来了。
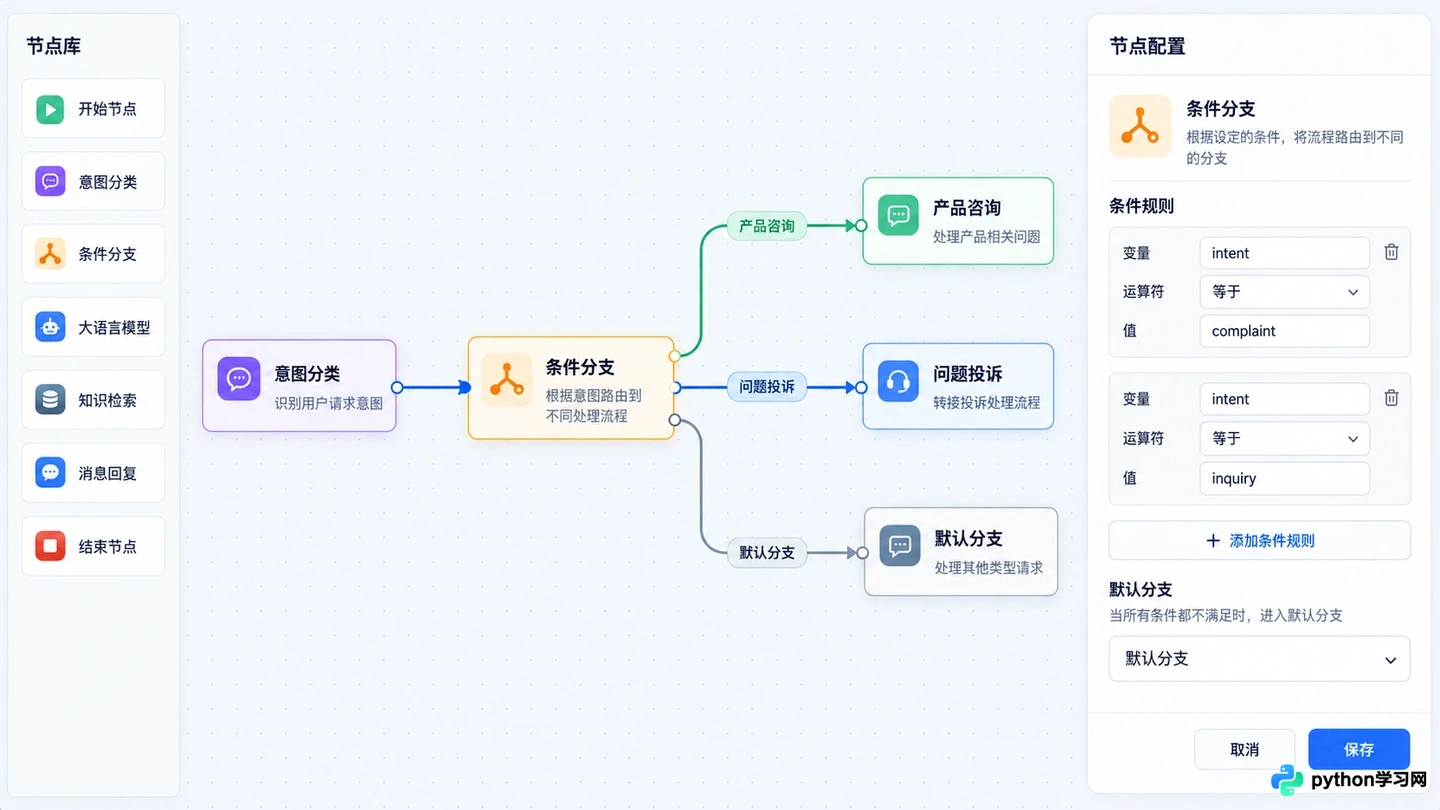
条件分支节点允许基于上游变量设置多路路由
配置条件分支时,核心在于定义清晰的“比较组”。你可以基于上游节点的输出变量(如意图分类的结果)设置多个分支路径。例如,当 intent 等于 "complaint" 时,流向投诉处理子流程;当 intent 等于 "inquiry" 时,流向产品介绍流程。关键在于,条件分支允许你为每个路径设置独立的后续节点组合,这意味着不同分支可以拥有完全不同的处理逻辑和资源消耗策略。
需要注意的是,条件分支的判断依据必须是确定的变量。如果依赖 LLM 的输出作为判断条件,务必在前置节点中使用结构化输出(如 JSON 模式)或专门的分类模型,以确保判断字段的稳定性。否则,模糊的自然语言描述可能导致分支匹配失败,最终落入“默认分支”,使精细化路由失效。
批量处理:迭代器如何化解数据规模难题
当业务涉及列表数据时,新手常犯的错误是试图在一个 LLM 节点中处理所有数据。例如,要求模型“总结这 50 条用户评论”。这不仅容易超出上下文窗口限制,还会导致模型注意力分散,总结质量大幅下降。
Dify 的“迭代器”节点正是为解决此类问题而生。它允许你将一个数组类型的变量拆解,对其中的每一项执行相同的操作序列,最后再将结果聚合。
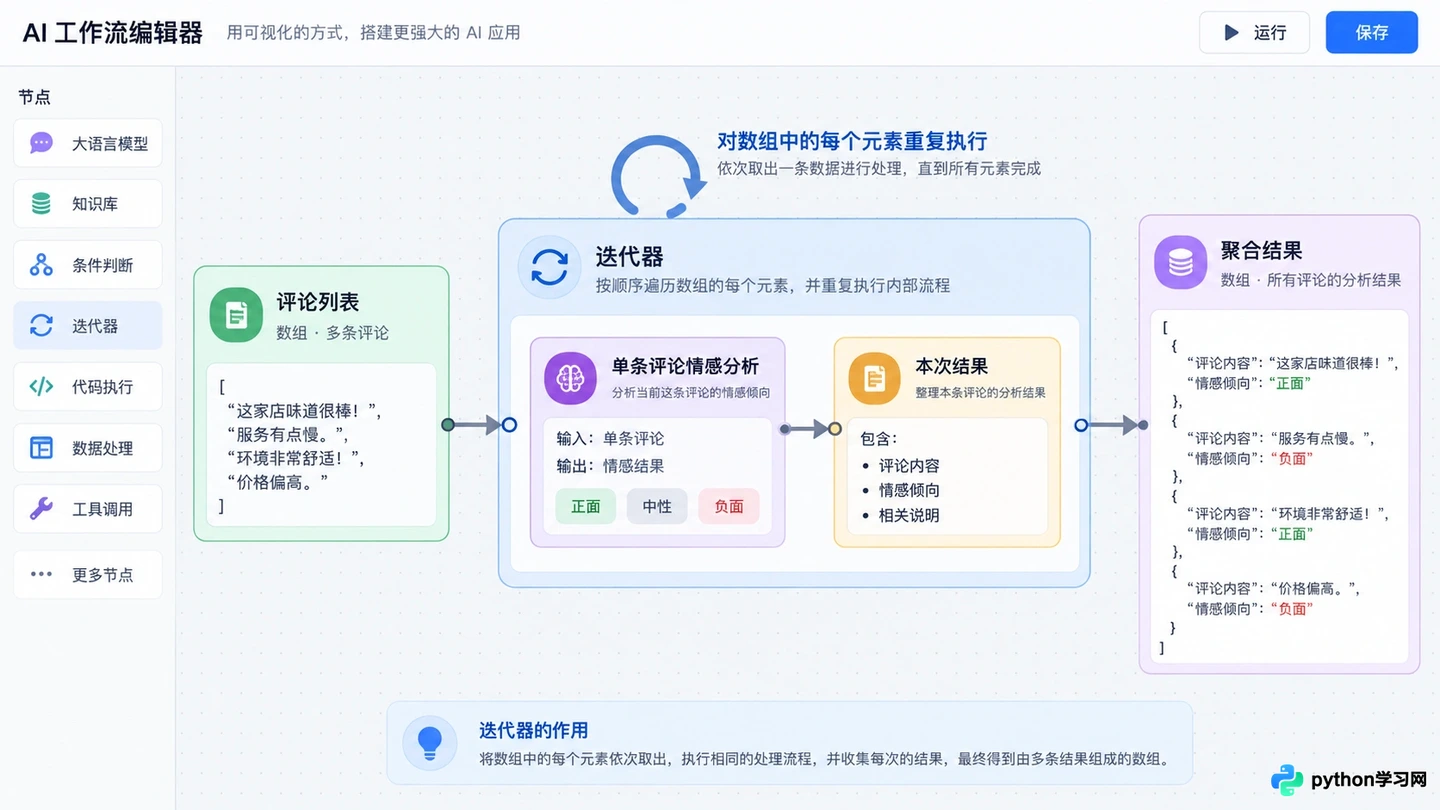
迭代器内部包含针对单项数据的处理逻辑
在实际操作中,迭代器内部是一个微型的子工作流。你可以将“单条评论情感分析”的逻辑放入迭代器内部。无论外部传入的是 10 条还是 100 条评论,迭代器都会自动逐项处理,并保证每条数据都经过相同的标准化流程。这种“化整为零”的策略,不仅规避了 Token 限制,还显著提升了单次处理的准确性和响应速度。
使用迭代器时,需特别注意输出变量的结构。迭代器结束后的输出通常是一个新的数组,包含每次迭代的结果。如果后续节点需要整体视角(如“基于所有评论生成总体报告”),则需在迭代器之后连接一个 LLM 节点,将聚合后的数组作为输入。此外,对于耗时较长的迭代任务,建议监控执行时间,必要时结合异步处理机制,避免前端等待超时。
模块化复用:子工作流带来的架构清晰性
随着工作流逻辑日益复杂,单个画布上密密麻麻的节点会让维护变成噩梦。重复的逻辑块、跨分支的相同处理步骤,都在呼唤模块化解决方案。Dify 的“子工作流”功能,允许你将一段通用的逻辑封装成独立的可调用单元。
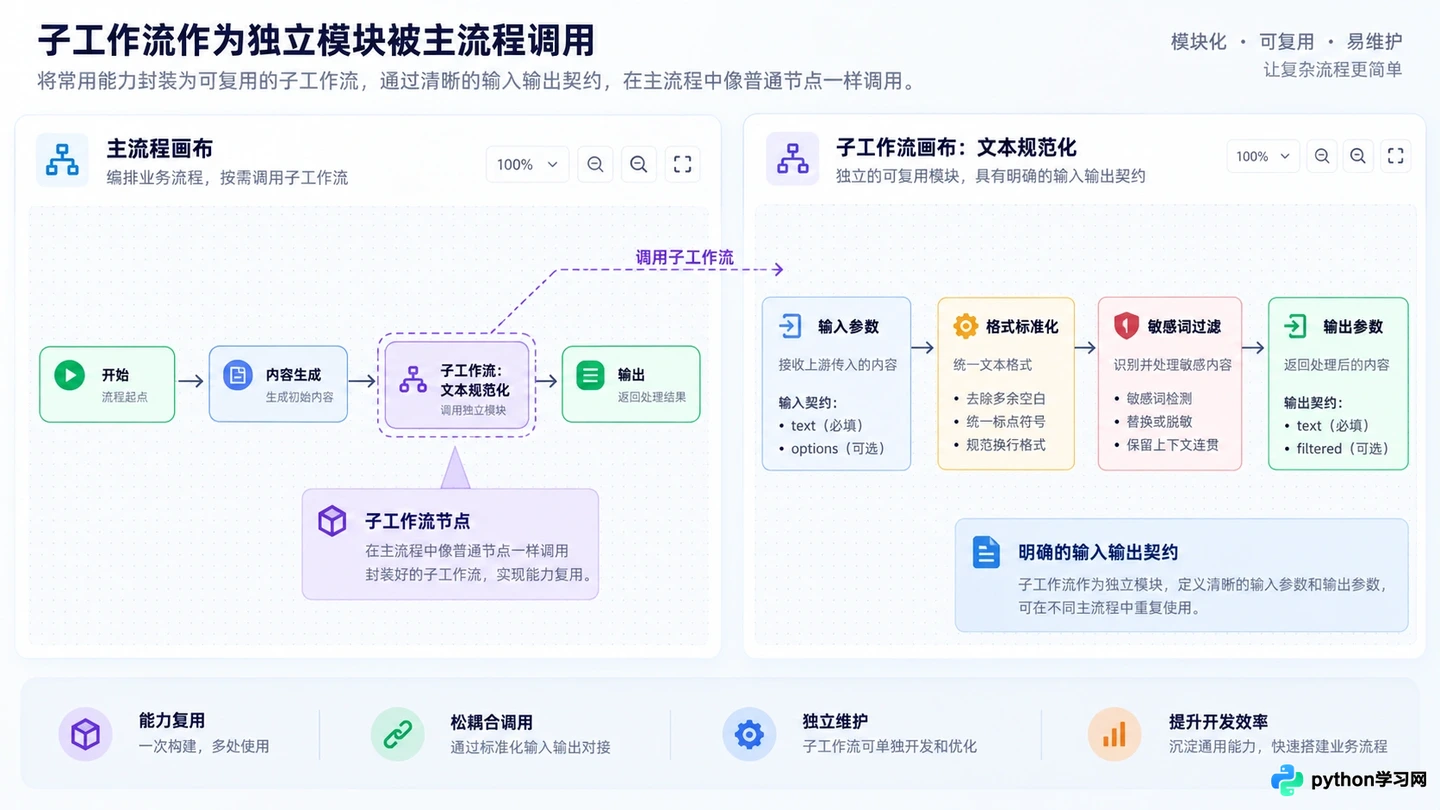
子工作流作为独立模块被主流程调用
例如,在一个内容生成平台中,“敏感词过滤”和“格式标准化”可能在文章生成、评论审核、标题优化等多个环节被反复使用。如果每次都在主工作流中重新搭建这套逻辑,不仅效率低下,且一旦过滤规则更新,需修改多处地方,极易遗漏。
通过创建独立的子工作流,你可以将这些通用逻辑封装起来,并在主工作流中通过“子工作流”节点进行调用。这种做法带来了两个显著优势:一是逻辑解耦,主工作流只关注核心业务流程,细节实现隐藏在子工作流中;二是维护便捷,修改子工作流即可全局生效。
在调用子工作流时,需明确定义输入参数和输出参数。这类似于函数编程中的接口定义,确保了模块间的契约清晰。值得注意的是,子工作流并非万能,过度拆分可能导致调用链路过深,增加调试难度。建议仅对高频复用、逻辑独立且相对稳定的模块进行封装。
边界与权衡:何时该停止复杂化
虽然条件分支、迭代器和子工作流赋予了 Dify 强大的编排能力,但并不意味着所有逻辑都应堆砌在工作流中。技术选型的本质是权衡。
如果逻辑涉及复杂的数学运算、大规模数据清洗或与外部数据库的深度交互,强行在工作流中实现可能不如编写一段自定义代码节点(Code Node)甚至调用外部 API 来得高效。工作流的优势在于可视化编排和 LLM 能力的整合,而非替代传统后端开发。
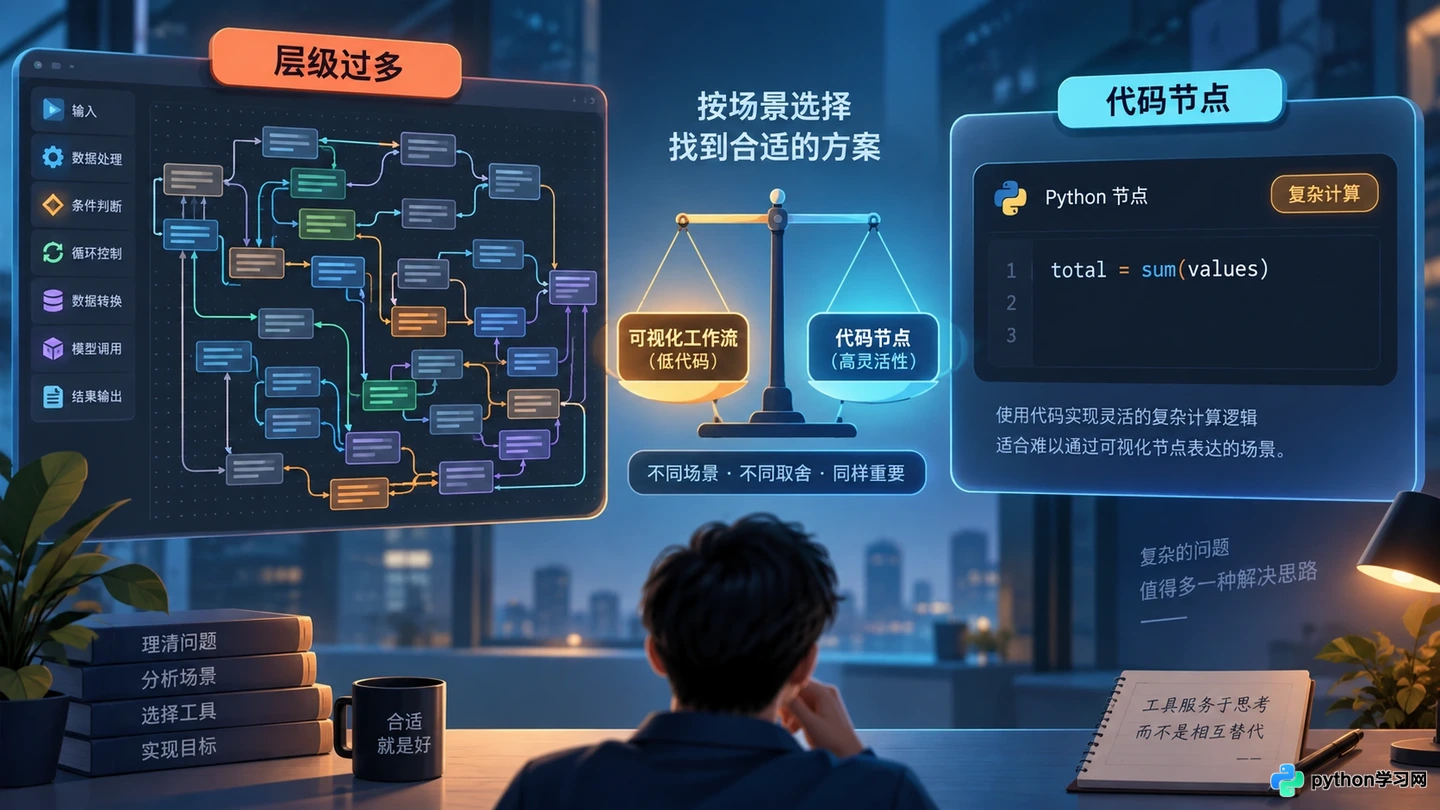
在复杂计算场景下,代码节点可能比纯工作流更高效
此外,过于复杂的嵌套和分支会增加调试成本。在设计初期,建议先绘制逻辑草图,识别出核心的线性路径,再逐步引入分支和循环。保持工作流的“可读性”与“功能性”同样重要。如果一个工作流需要滚动多次才能看完,或许就是时候考虑拆分子工作流了。
回到开头的取舍:我们追求的不是最复杂的工作流,而是最能准确反映业务逻辑、且易于维护的自动化方案。条件分支让决策更精准,迭代器让处理更规模化,子工作流让架构更清晰。掌握这三者,你便能在 Dify 中从容应对绝大多数复杂业务场景,将 AI 能力真正融入生产环境的脉络之中。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















