


Python遍历字典是什么意思:获取键、值与键值对的基础概念

一、核心认知:字典映射结构与遍历的三种形态
在深入具体代码之前,需要先建立对 Python 字典数据形态的清晰认知。列表(List)在内存中是有序排列的元素序列,通过从 0 开始的整数索引定位;而字典(Dictionary)属于映射类型(Mapping Type),其内部由成对的“键”(Key)与“值”(Value)绑定构成。
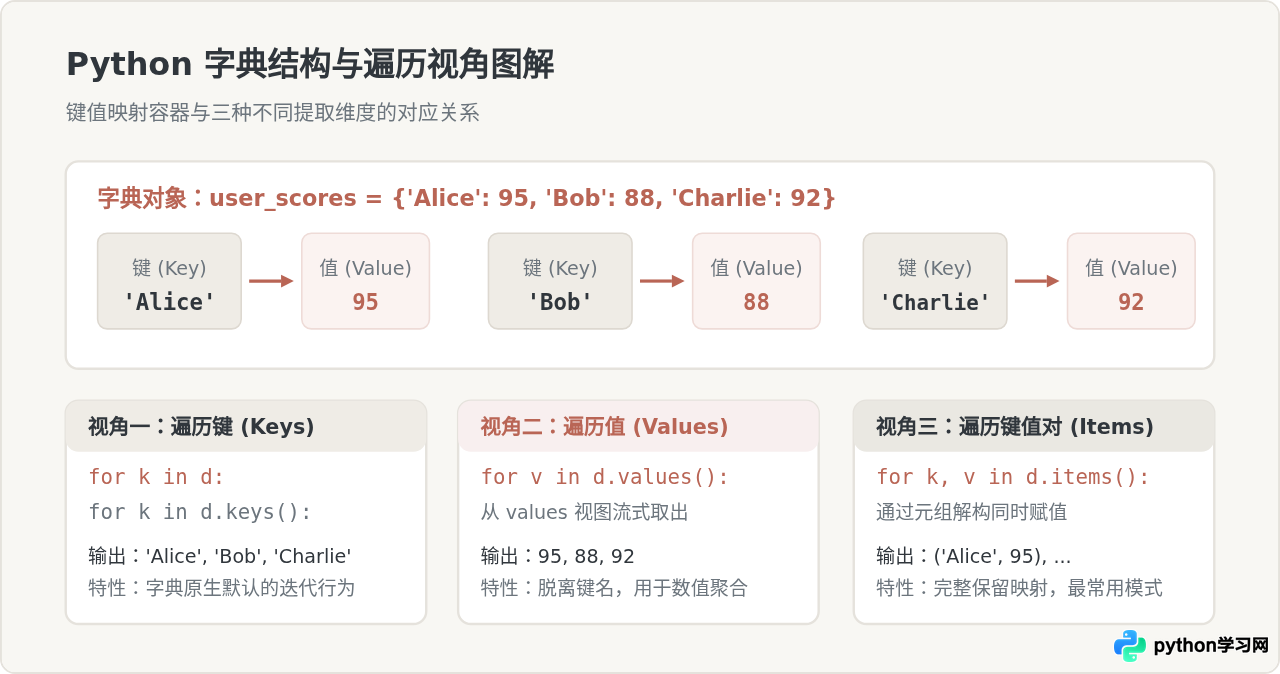
“遍历”(Iteration)一词源自数学与计算机科学的操作术语,意为沿着某条路径逐一查看集合中的每个成员。因为字典每个单元由两个紧密关联的部分构成,所以在面对“遍历字典”这个需求时,Python 提供了三种截然不同但互相补充的访问维度:
- 仅获取键(Keys):只关注字典中有哪些命名标签或索引标识,忽略对应存储的具体数值。
- 仅获取值(Values):只提取字典中存放的实际数据集合,脱离具体键名的约束,常用于聚合统计。
- 同时获取键与值(Items):保持映射关系不丢失,在每一次循环中同时拿到当前的键及其匹配的值。
二、获取键:默认迭代机制与显式 keys() 调用
当直接将字典变量放在 for ... in 循环语句后面时,Python 的底层设计默认只迭代所有的“键”。这是初学者最容易产生误解的地方:很多人以为循环拿到的会是完整元素或数值,但实际上仅拿到键。
1. 默认遍历语法与显式语法
在语法表达上,直接写 for key in dictionary: 与显式写 for key in dictionary.keys(): 在执行效果上是完全等价的:
# 示例:通过默认行为遍历字典的键
user_status = {
    "admin": "活跃",
    "guest": "只读",
    "operator": "离线"
}

print("--- 默认遍历(推荐写法)---")
for role in user_status:
    print(f"用户角色键名: {role}")

print("\n--- 显式调用 .keys() ---")
for role in user_status.keys():
print(f"用户角色键名: {role}")用户角色键名: admin
用户角色键名: guest
用户角色键名: operator
--- 显式调用 .keys() ---
用户角色键名: admin
用户角色键名: guest
用户角色键名: operator
2. 为什么设计为默认返回键?
Python 将字典设计为默认遍历键,主要基于两个工程考量:
- 键是唯一索引标识:在字典中,键具有唯一性且不可变(哈希特性),拿到键就意味着掌握了定位该数据行的句柄。如果需要值,可以通过
d[key]查询;而反过来拿值却无法直接反查唯一的键。 - 符合容器成员检测习惯:在 Python 中,表达式
"admin" in user_status检验的也是某个键是否存在于字典中。默认迭代键使in运算符在迭代和成员检测逻辑上保持了高度一致性。
三、获取值:使用 values() 提取数据集合
当业务场景只关注字典中存储的具体数据、而不在乎数据属于谁时,使用 dict.values() 方法是最直接有效的方式。
1. 为什么需要单独遍历值?
在许多统计与计算场景中,键只是辅助索引。例如:计算商品总价、统计全班学生的平均分、查找最高数值等。在这些场景中,如果依然遍历键,并在循环体内通过 d[key] 来取值,就会增加一次哈希查找开销,代码也会显得累赘。
2. 语法范例与输出
# 示例:通过 .values() 遍历数据并进行数值统计
monthly_sales = {
    "一月": 12000,
    "二月": 15000,
    "三月": 18000,
    "四月": 14000
}

total_sales = 0
print("--- 逐项输出销售额 ---")
for amount in monthly_sales.values():
    print(f"金额: ¥{amount}")
    total_sales += amount

print(f"\n季度销售总额: ¥{total_sales}")
print(f"平均月销售额: ¥{total_sales / len(monthly_sales)}")金额: ¥12000
金额: ¥15000
金额: ¥18000
金额: ¥14000
季度销售总额: ¥59000
平均月销售额: ¥14750.0
字典的键必须唯一且不可变,但值可以是任意类型且完全允许重复。使用 .values() 遍历时,如果有多个不同的键存储了相同的数字或字符串,该重复内容会在遍历过程中原样依次出现,不会被自动去重。
四、获取键值对:使用 items() 与元组解构
在绝大多数日常开发中,我们往往既需要读取配置项的名字,又需要处理配置项的值;或者既需要打印用户名,又需要展示其对应的账户信息。此时,dict.items() 是最标准、最符合 Pythonic 哲学的解法。
1. 元组解构(Tuple Unpacking)机制
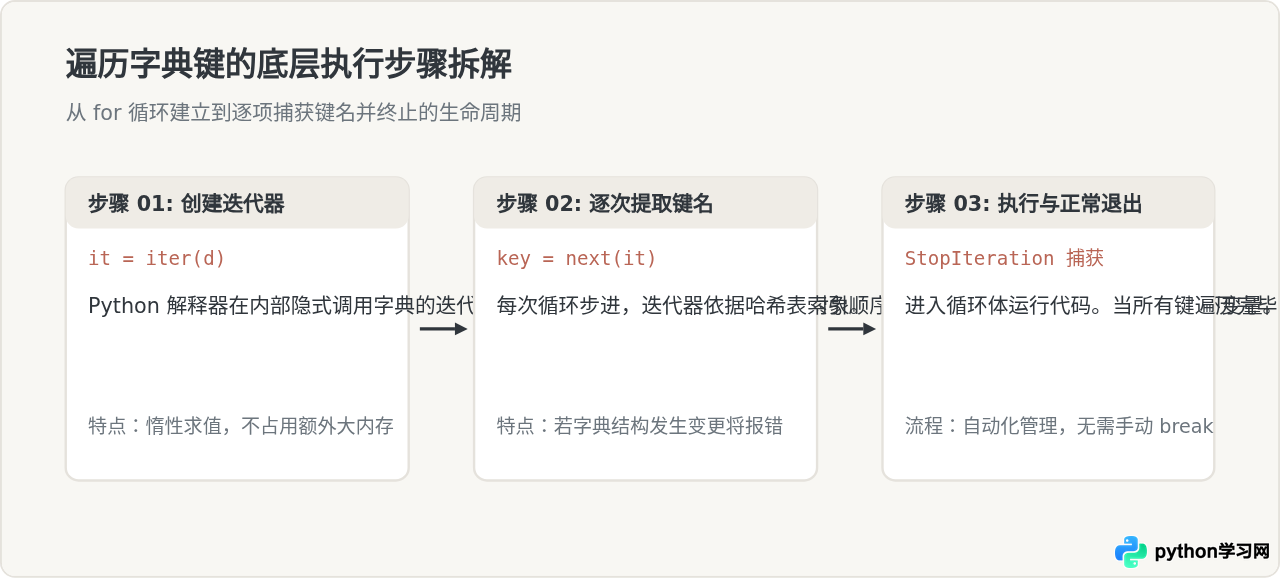
dict.items() 在被遍历时,每一轮循环都会返回一个由两个元素组成的元组(Tuple):(key, value)。Python 允许在 for 语句头部声明两个变量接收该元组,解释器会自动完成拆包赋值:
# 示例:使用 items() 同时获取键名和键值
server_configs = {
    "host": "192.168.1.100",
    "port": 8080,
    "protocol": "HTTPS",
    "timeout": 30
}

print("--- 服务器配置清单 ---")
for config_name, config_val in server_configs.items():
print(f"配置项 [{config_name:^10}] -> 设置值: {config_val}")配置项 [ host ] -> 设置值: 192.168.1.100
配置项 [ port ] -> 设置值: 8080
配置项 [ protocol ] -> 设置值: HTTPS
配置项 [ timeout ] -> 设置值: 30
2. 反面模式:避免通过 for key in d 然后 d[key] 取值
初学者常常习惯编写如下形式的代码:
# 不推荐的低效写法
for k in server_configs:
    v = server_configs[k]  # 冗余:多了一次哈希计算与键查找过程
    print(k, v)
这种写法虽然结果相同,但每一轮循环都迫使解释器在底层重新计算 k 的哈希值并在哈希表桶中查找索引。而 items() 在遍历到底层哈希表单元格时,单元格本身就同时存放着键与值的指针引用,直接打包返回元组,效率更高且语意明确。
五、关键机制与常见陷阱
掌握了三种遍历方式的语法后,还需要了解 Python 字典在底层运作时的几个关键特征与边界规则,防止在实际工程中引发难以排查的 Bug。
1. 陷阱:在遍历过程中直接修改字典长度
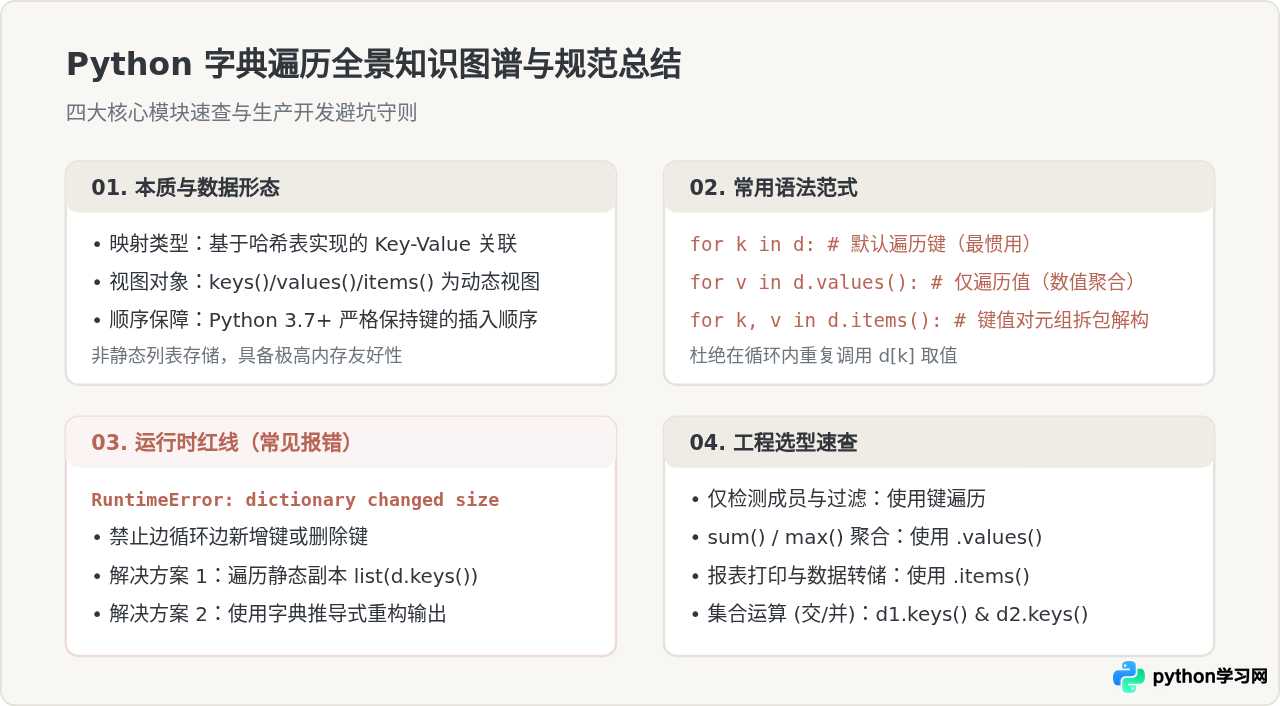
这是在开发中最常遇到的运行时异常之一。如果在 for 循环体内部直接对正在被遍历的字典执行新增键值(d[new_key] = val)或删除键值(del d[key] / pop())操作,Python 会立即抛出:
RuntimeError: dictionary changed size during iteration原因解释:Python 字典内部通过哈希表组织数据。迭代器在遍历过程中会维护一个状态游标。如果在迭代进行中增加或删除了元素,哈希表的尺寸与内部桶分布可能发生重排(Rehash),导致迭代器无法确定下一个元素的位置,因此解释器强制中断并报错。
正确解法有两种:
- 解法 A(转换为静态列表):使用
list(d.keys())制作当前键的浅拷贝快照,然后遍历快照列表,在循环体中对原字典进行删除操作。 - 解法 B(字典推导式过滤):不修改旧字典,直接使用推导式生成符合条件的新字典(现代函数式编程推荐做法)。
# 场景:清理掉所有分数低于 60 的不合格记录
scores = {"Tom": 85, "Jerry": 52, "Spike": 90, "Tyke": 45}

# 规范解法 A:使用静态列表快照安全删除
print("--- 解法 A:通过静态列表遍历安全删除 ---")
for student in list(scores.keys()):
    if scores[student] < 60:
        del scores[student]
print("清理后字典:", scores)

# 规范解法 B:使用字典推导式重构
raw_data = {"Tom": 85, "Jerry": 52, "Spike": 90, "Tyke": 45}
cleaned_data = {k: v for k, v in raw_data.items() if v >= 60}
print("推导式生成新字典:", cleaned_data)清理后字典: {'Tom': 85, 'Spike': 90}
推导式生成新字典: {'Tom': 85, 'Spike': 90}
2. 字典的有序性演进(Python 3.7+ 语言规范)
早期版本的 Python(3.5 及之前)中,字典是无序的,遍历出来的键名顺序取决于底层的哈希散列分布,不能保证固定的先后次序。从 Python 3.6 开始(作为 CPython 实现细节),并自 Python 3.7 起正式作为官方语言标准,Python 字典被明确保证:遍历时严格按照键值对最初被插入的先后顺序输出。
3. 字典视图对象(View Objects)的概念
在 Python 3 中,调用 d.keys()、d.values() 和 d.items() 返回的不是静态的 Python 列表(List),而是特殊的视图对象(dict_keys、dict_values、dict_items)。
视图对象具有“动态联动”特性:它们不会像列表那样额外复制一遍内存,并且如果原字典的内容被更新,该视图所反映的内容会即时自动同步更新。同时,dict_keys 还支持如交集(&)、并集(|)等类似集合(Set)的操作运算。
六、知识总结
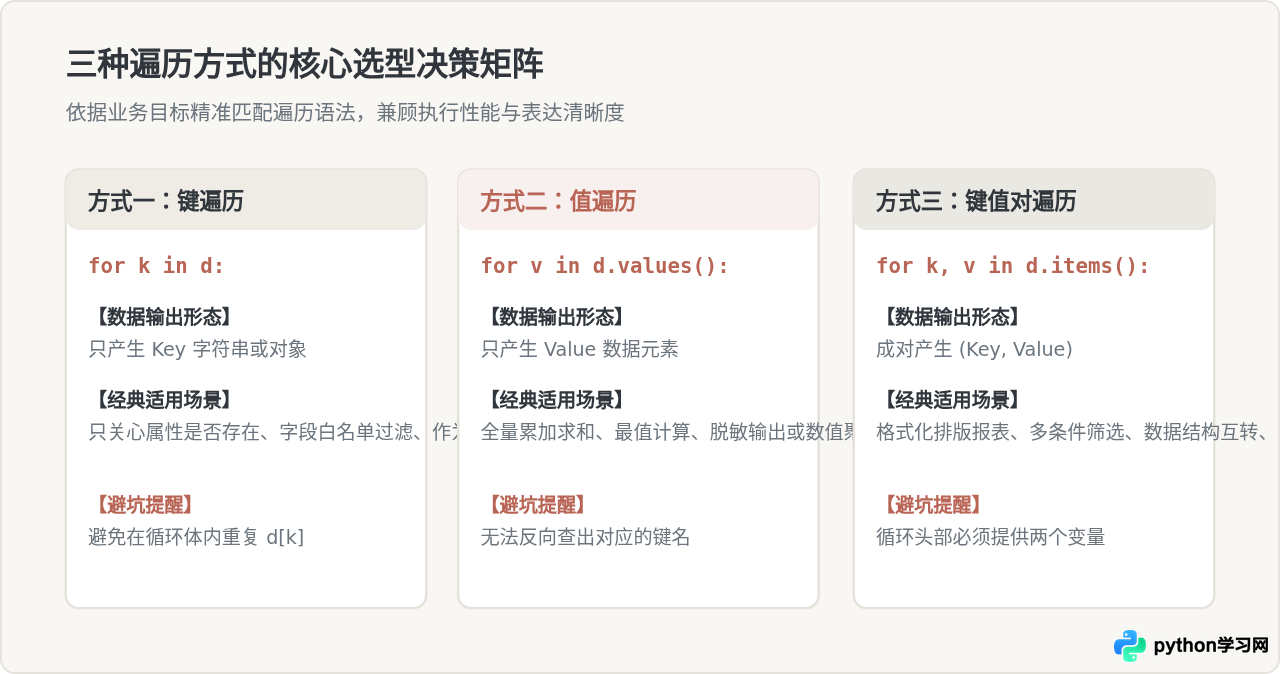
回到文章开头的核心问题,“Python遍历字典”本质上就是通过循环结构,以受控的方式依次处理字典内部存储的数据条目。总结其核心选择依据如下表所示:
| 遍历目标 | 标准语法 | 每次循环获取的对象 | 推荐使用场景 |
|---|---|---|---|
| 获取键 (Key) | for k in d: |
单个键对象(如字符串、整数等) | 检查键是否存在、字段名称过滤、提取索引列表 |
| 获取值 (Value) | for v in d.values(): |
单个值对象(数字、列表、对象等) | 聚合统计(求和、求平均、取最值)、无需反查键名的数据计算 |
| 获取键值对 (Item) | for k, v in d.items(): |
解构后的二元组 (Key, Value) |
格式化打印排版、基于键值多条件的综合筛选、字典转存与结构转换 |
在实际编写代码时,只需根据业务是否需要键、是否需要值,或者两者都需要,选用对应的语法形态;同时牢记禁止在遍历过程中动态更改字典长度这一基本法则,就能写出结构清晰、运行健壮且性能优异的 Python 程序。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















