


Python怎么用推导式筛选并遍历特定字典键值

.items() 方法:通过 {k: v for k, v in d.items() if 条件} 过滤生成目标字典,或直接借助生成器表达式 ((k, v) for k, v in d.items() if 条件) 进行低内存开销的惰性遍历。本文将系统拆解推导式的构建逻辑、多种业务场景过滤实现及最佳性能实践。
一、字典推导式的核心语法与工作机制
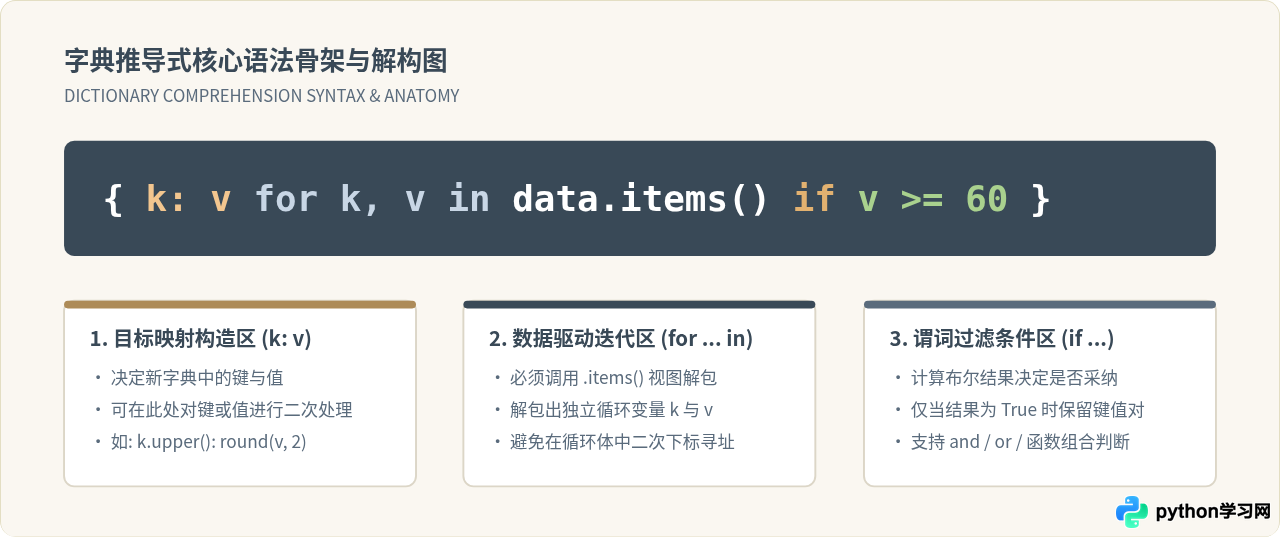
Python 的字典推导式(Dictionary Comprehension)是基于迭代协议快速过滤和重构键值对的声明式语法。其结构与列表推导式相似,但外部使用大括号 {},内部产物则是以冒号分隔的 key: value 映射对。
要在推导式中同时获取并检查键与值,必须调用原字典的 .items() 视图方法。该方法产出由 (key, value) 元组构成的动态视图,通过元组解包直接为循环变量赋值。末尾的 if 子句充当过滤器,只有返回值为 True 的键值对才会被送入左侧表达式参与构件。
二、筛选并遍历特定字典键值的操作步骤
在实际开发中,根据筛选需求的不同,我们通常面临根据“值筛选”、“键名筛选”或“联合多条件筛选”三种具体场景。下面分别给出完整且可独立运行的代码示例。
1. 按字典的值(Value)筛选特定条目
例如,筛选学生成绩表中分数达到 80 分以上的记录,并遍历打印优秀名单:
# 示例:根据分数过滤及格学员并遍历
scores = {
    "Alice": 85,
    "Bob": 58,
    "Charlie": 92,
    "Diana": 74,
    "Evan": 88
}

# 1. 字典推导式筛选:仅保留分数 >= 80 的记录
high_scores = {k: v for k, v in scores.items() if v >= 80}

# 2. 遍历筛选后的结果
for name, score in high_scores.items():
    print(f"学员: {name}, 得分: {score}")

# 示例输出:
# 学员: Alice, 得分: 85
# 学员: Charlie, 得分: 92
# 学员: Evan, 得分: 88
2. 按字典的键(Key)筛选特定前缀或命名特征
在解析配置项或环境变量时,经常需要筛选出特定业务前缀的键:
# 示例:筛选所有以 "DB_" 开头的数据库配置项
config = {
    "APP_ENV": "production",
    "DB_HOST": "127.0.0.1",
    "DB_PORT": 5432,
    "DB_NAME": "analytics",
    "CACHE_TTL": 3600
}

# 筛选键名以 DB_ 开头的键值对,并在此过程中转换为小写键名
db_configs = {k.lower(): v for k, v in config.items() if k.startswith("DB_")}

for key, val in db_configs.items():
    print(f"数据库配置 -> {key}: {val}")

# 示例输出:
# 数据库配置 -> db_host: 127.0.0.1
# 数据库配置 -> db_port: 5432
# 数据库配置 -> db_name: analytics
3. 键与值的多条件联合筛选
推导式中的 if 子句可以自由连接 and、or 及成员操作符 in:
# 示例:多维度过滤员工信息
employees = {
    "emp_101": {"dept": "Tech", "status": "active", "salary": 12000},
    "emp_102": {"dept": "Sales", "status": "active", "salary": 8500},
    "emp_103": {"dept": "Tech", "status": "suspended", "salary": 11000},
    "emp_104": {"dept": "Tech", "status": "active", "salary": 9500}
}

# 筛选条件:属于 Tech 部门、状态为 active 且薪资大于 10000 的员工
qualified_staff = {
    emp_id: info
    for emp_id, info in employees.items()
    if info["dept"] == "Tech" and info["status"] == "active" and info["salary"] > 10000
}

for eid, detail in qualified_staff.items():
    print(f"工号: {eid} | 部门: {detail['dept']} | 薪资: {detail['salary']}")

# 示例输出:
# 工号: emp_101 | 部门: Tech | 薪资: 12000
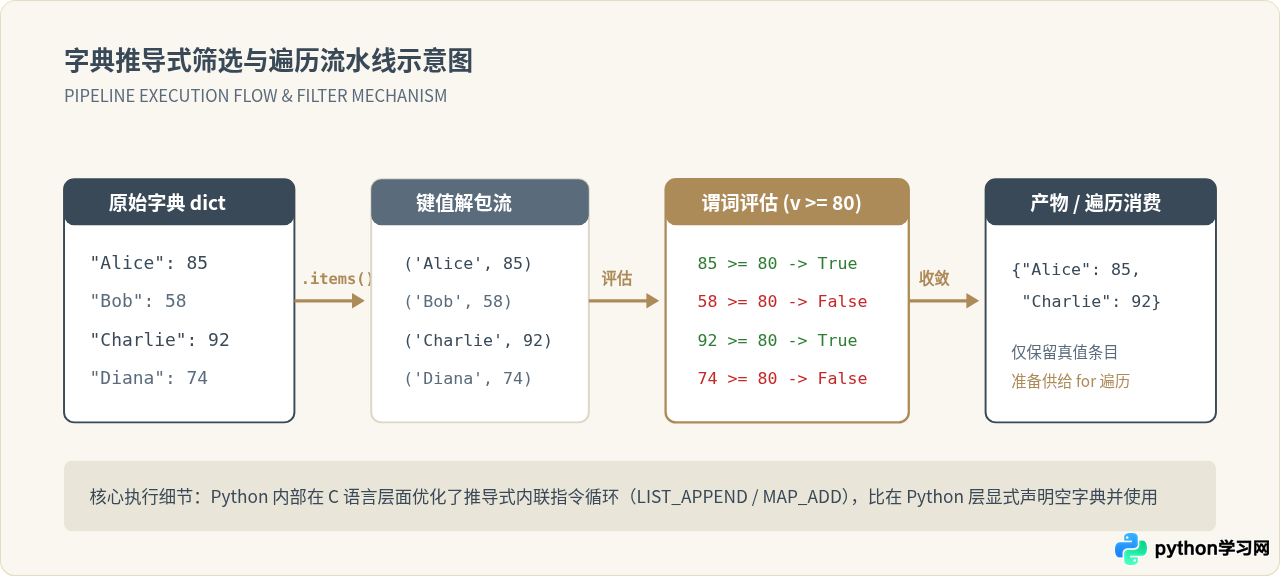
三、数据过滤流程与底层执行时序
推导式在执行时经历了“解包产生元组流”、“布尔谓词过滤”、“哈希槽分配与赋值”三个紧密步骤。理解数据流向有助于读者把握其与传统 for 循环的异同。
四、字典推导式 vs 生成器表达式:进阶内存选型
许多初学者会习惯性地先写一个字典推导式,紧接着遍历它:
# 常见写法:先构造完整新字典,再进行遍历
for k, v in {k: v for k, v in data.items() if v > 100}.items():
do_something(k, v)如果原始字典包含上百万条数据,上述写法会在内存中瞬间分配一个全新的过滤字典,带来不必要的内存峰值。若我们的唯一目的是“遍历特定条目”,而不需要在后续继续引用过滤后的完整字典,生成器表达式(Generator Expression)是更优的选择。
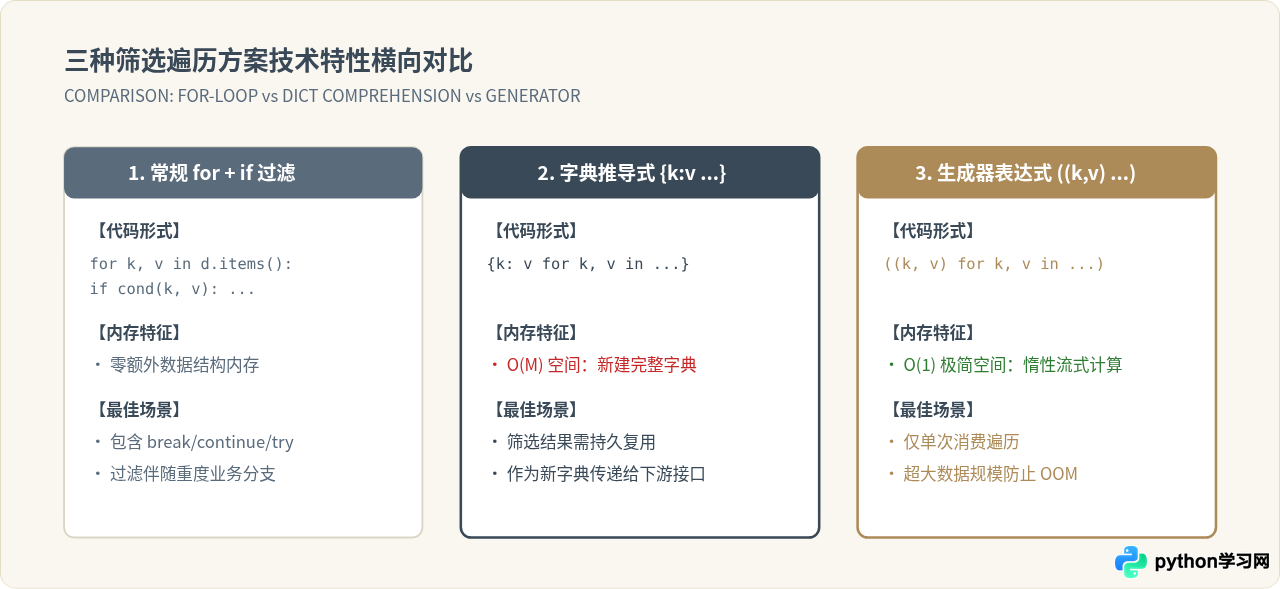
生成器表达式将大括号替换为圆括号,在迭代时逐个产出匹配项:
# 内存友好的生成器过滤遍历
raw_data = {"item_" + str(i): i for i in range(100000)}

# 生成器不会一次性把所有符合条件的对象压入内存
filtered_stream = ((k, v) for k, v in raw_data.items() if v % 1000 == 0)

for k, v in filtered_stream:
    # 逐条流式处理
    print(f"流式捕获目标: {k} => {v}")
五、实战常见误区与防踩坑指南
在 Python 中,如果直接在 for k, v in d.items(): 循环体内部执行 del d[k] 或 d.pop(k),会立即抛出 RuntimeError: dictionary changed size during iteration 异常。字典推导式天然构建并产出新对象,完全规避了并发修改迭代器状态的风险。
编写字典推导式时,还应注意以下高频细节:
- 遗漏
.items()方法: 直接使用for k in data只会迭代字典的键,无法在if中直接使用值变量v,若在循环内再次使用data[k]寻址,会多出一次哈希查找开销。 - 可读性边界: 当筛选逻辑超过 2 个逻辑分支或嵌套了多层三元表达式时,强行塞进一行推导式会导致可读性急剧恶化,此时应拆解为常规
for循环或独立过滤函数。 - 键覆盖隐患: 若在推导式的左侧对键做了转换(例如
k.lower(): v),要确保原字典中不存在大小写不同但内容相同的键(如"Name"与"name"),否则后处理的项会直接覆盖先前的条目。
六、综合选型决策指南
在面对不同业务规模与使用需求时,可以参考以下决策路径选择最恰当的实现方案:
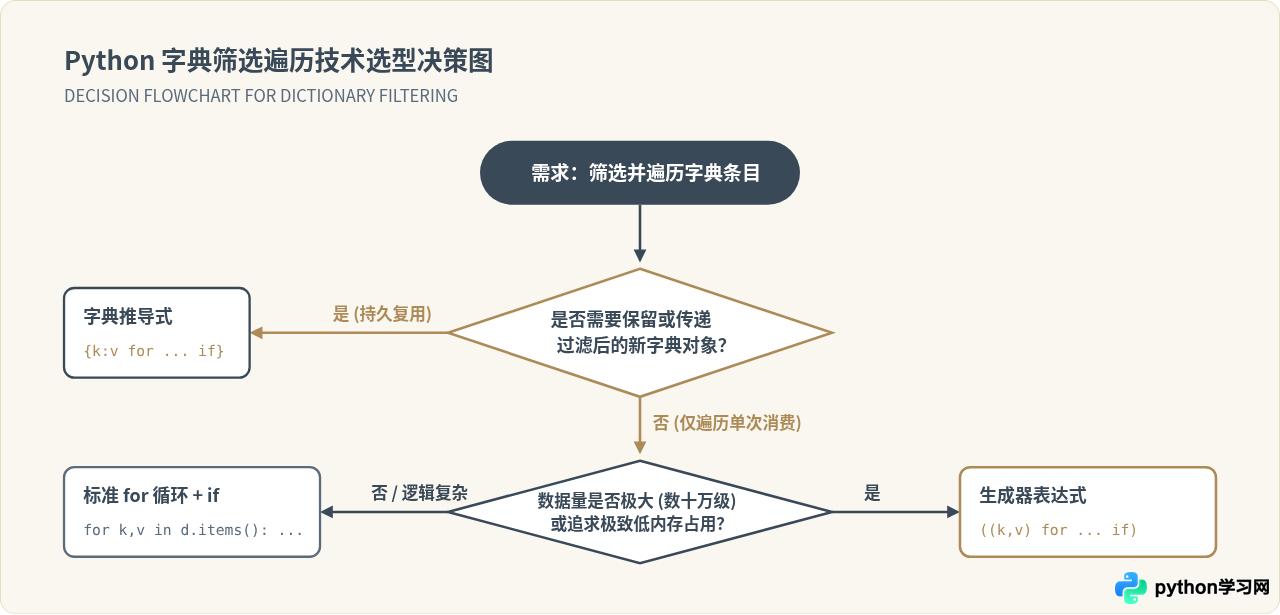
总结而言,Python 字典推导式以简洁的声明式风格替代了繁冗的机械循环代码。在面对中小规模字典且需要持有筛选结果时,优先采用 {k: v for k, v in d.items() if ...};而在追求极低内存占用的单纯遍历场景下,生成器表达式则是更稳健优雅的选择。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















