


Coze工作流怎么编排?复杂逻辑节点设计教程

很多初次接触 Coze(扣子)的用户,往往停留在“拖拽一个 LLM 节点,连接输入输出”的舒适区。这种线性思维在处理简单问答时绰绰有余,但一旦面对需要判断用户意图、遍历数据列表或处理多步依赖的真实业务场景,简单的直线连接就会显得捉襟见肘。
工作流的本质不是画线,而是定义数据的流动路径和控制逻辑。真正的编排能力,体现在你如何处理“如果不满足条件该怎么办”以及“如何重复处理一批数据”。本文将跳出基础教程,聚焦于条件分支、循环迭代和异常处理这三个构建复杂逻辑的核心支柱,带你理解 Coze 工作流的设计哲学。
条件分支:让机器人学会“看情况办事”
在真实业务中,用户的输入从来不是单一的。比如一个客服场景,用户可能咨询退款、查询物流或投诉产品。如果所有请求都扔给同一个大模型提示词,不仅响应速度慢,还容易因为上下文干扰导致回答不精准。
这时候,“选择器”节点(Selector)或“条件分支”逻辑就成为了必需品。它的作用类似于编程中的 if-else 语句,根据上游节点的输出变量值,决定下一步走向哪个分支。
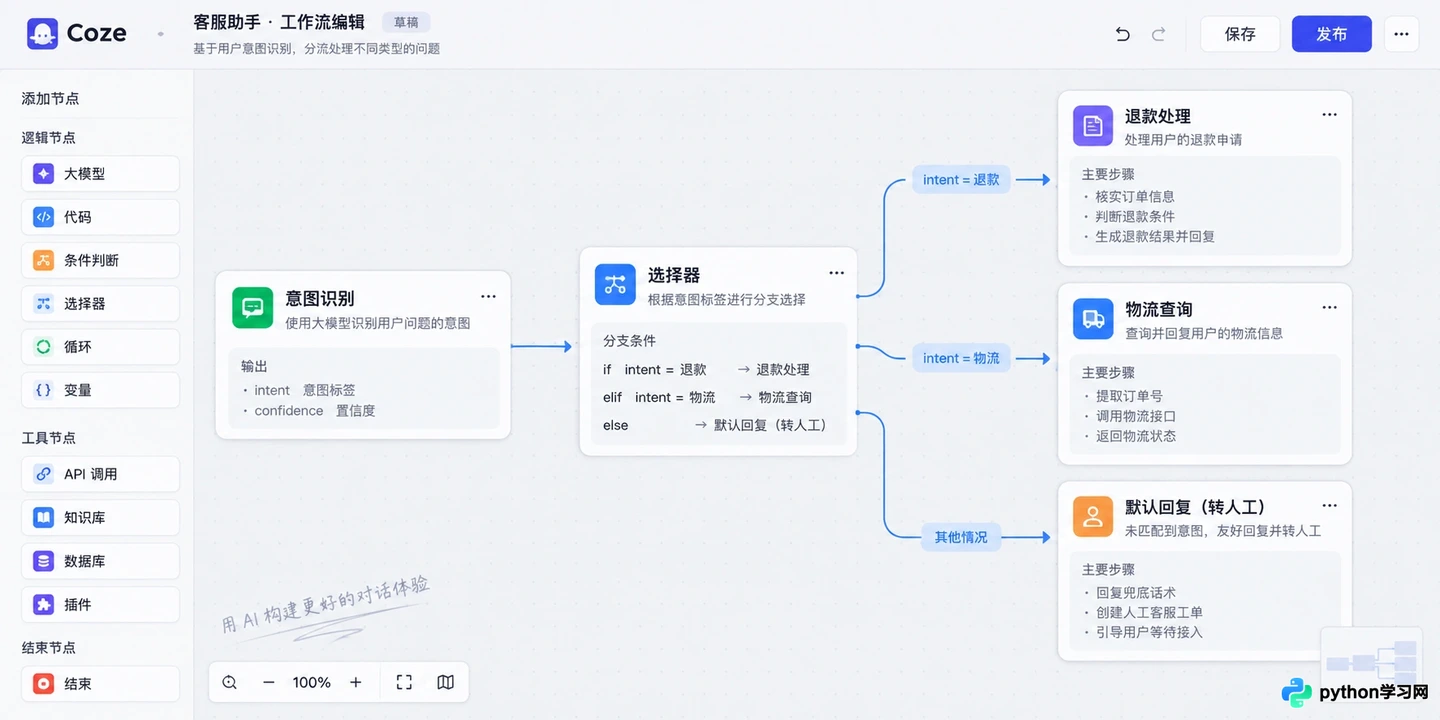
基于意图识别的选择器节点配置界面
在设计条件分支时,关键在于明确判断依据。通常我们会利用前一个 LLM 节点或代码节点输出的结构化数据。例如,先让一个轻量级模型判断用户意图是“退款”还是“查询”,输出一个字段 intent_type。接着,在选择器节点中设置规则:当 intent_type 等于 “refund” 时,流向退款处理子流程;当等于 “logistics” 时,流向物流查询接口。
需要注意的是,分支覆盖必须完整。 如果用户输入了无法识别的意图,流程不能直接断掉。务必设置一个“默认分支”(Default),将其导向人工客服或通用回复节点,确保用户体验的闭环。这种设计不仅提高了特定场景的处理精度,还避免了大模型在非相关任务上的算力浪费。
循环迭代:批量处理数据的自动化引擎
如果说条件分支解决了“方向”问题,那么循环迭代(Iterator)则解决了“规模”问题。在很多场景中,我们需要处理的不是一条数据,而是一个列表。比如,从数据库中读取了 10 条待办事项,需要逐一总结并发送邮件;或者抓取了多个新闻链接,需要逐个提取正文。
Coze 的迭代节点允许你将一个数组类型的变量作为输入,对数组中的每一项执行相同的子工作流。这听起来简单,但在实际编排中,新手常犯的错误是忽略“并行”与“串行”的区别以及资源限制。
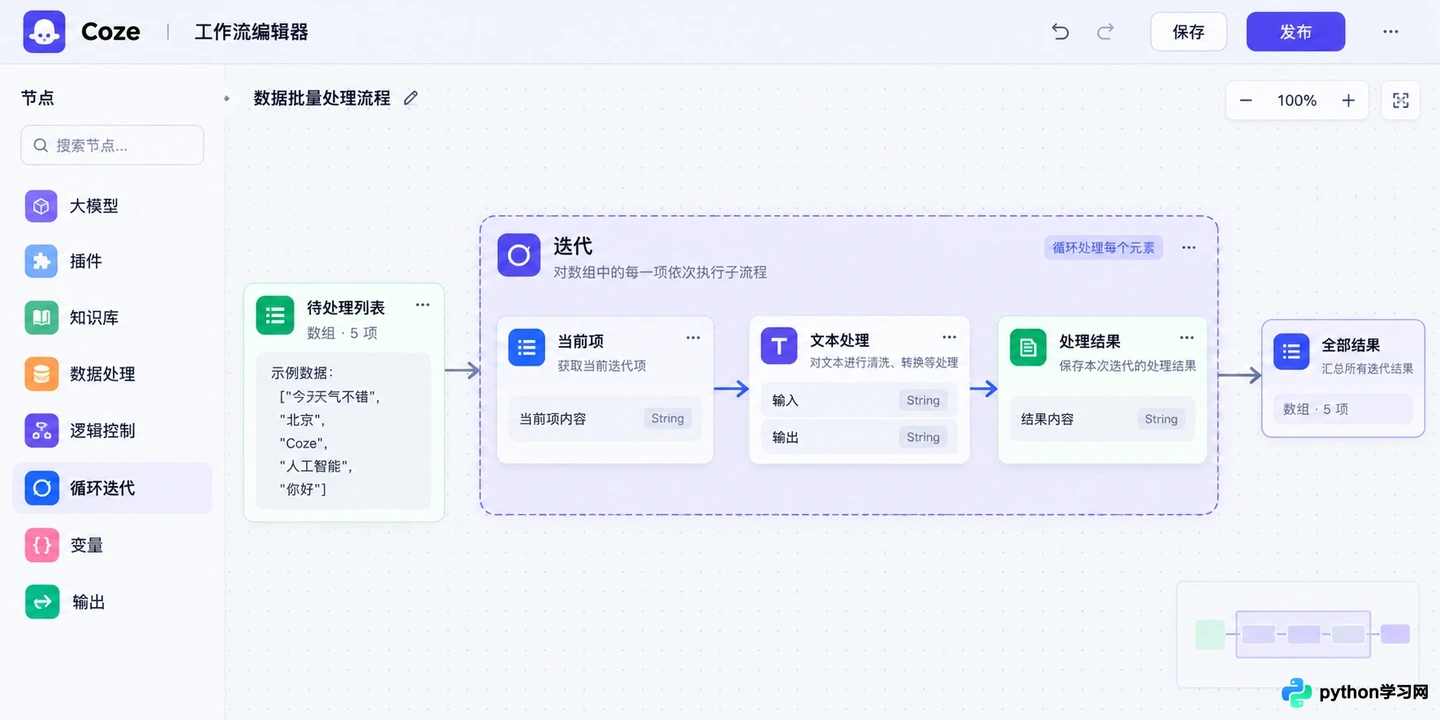
迭代节点内部的子工作流设计
在配置迭代节点时,你需要明确输入变量是一个标准的 JSON 数组。进入迭代内部后,系统会自动创建一个临时变量(如 item),代表当前正在处理的那一条数据。你可以在内部连接 LLM 节点、代码节点或 API 插件,对 item 进行处理。
这里有一个重要的性能权衡: 如果每次迭代都调用高延迟的外部 API,且数组长度较大,整个工作流的耗时将成倍增加。在这种场景下,可以考虑在迭代内部使用批处理接口,或者在迭代结束后统一进行数据聚合。此外,务必注意平台的并发限制,过深的嵌套循环可能导致超时错误。对于简单的文本处理,尽量在代码节点中使用原生语言特性完成循环,而非滥用工作流层面的迭代节点,这样能获得更低的延迟和更高的稳定性。
变量传递与状态管理:打通节点的任督二脉
复杂工作流最大的痛点往往不是逻辑本身,而是数据在不同节点间的“丢失”或“错位”。Coze 的工作流是基于有向无环图(DAG)的,这意味着数据只能从上游流向下游,不能反向回溯。因此,良好的变量命名和传递策略至关重要。
很多开发者喜欢直接用默认的 output 或 result,当节点超过五个时,调试将成为噩梦。建议采用“语义化命名”原则。例如,从数据库查出的用户信息命名为 user_profile,经过清洗后的文本命名为 cleaned_text。这样在后续节点引用变量时,你能一眼看出数据来源和处理状态。
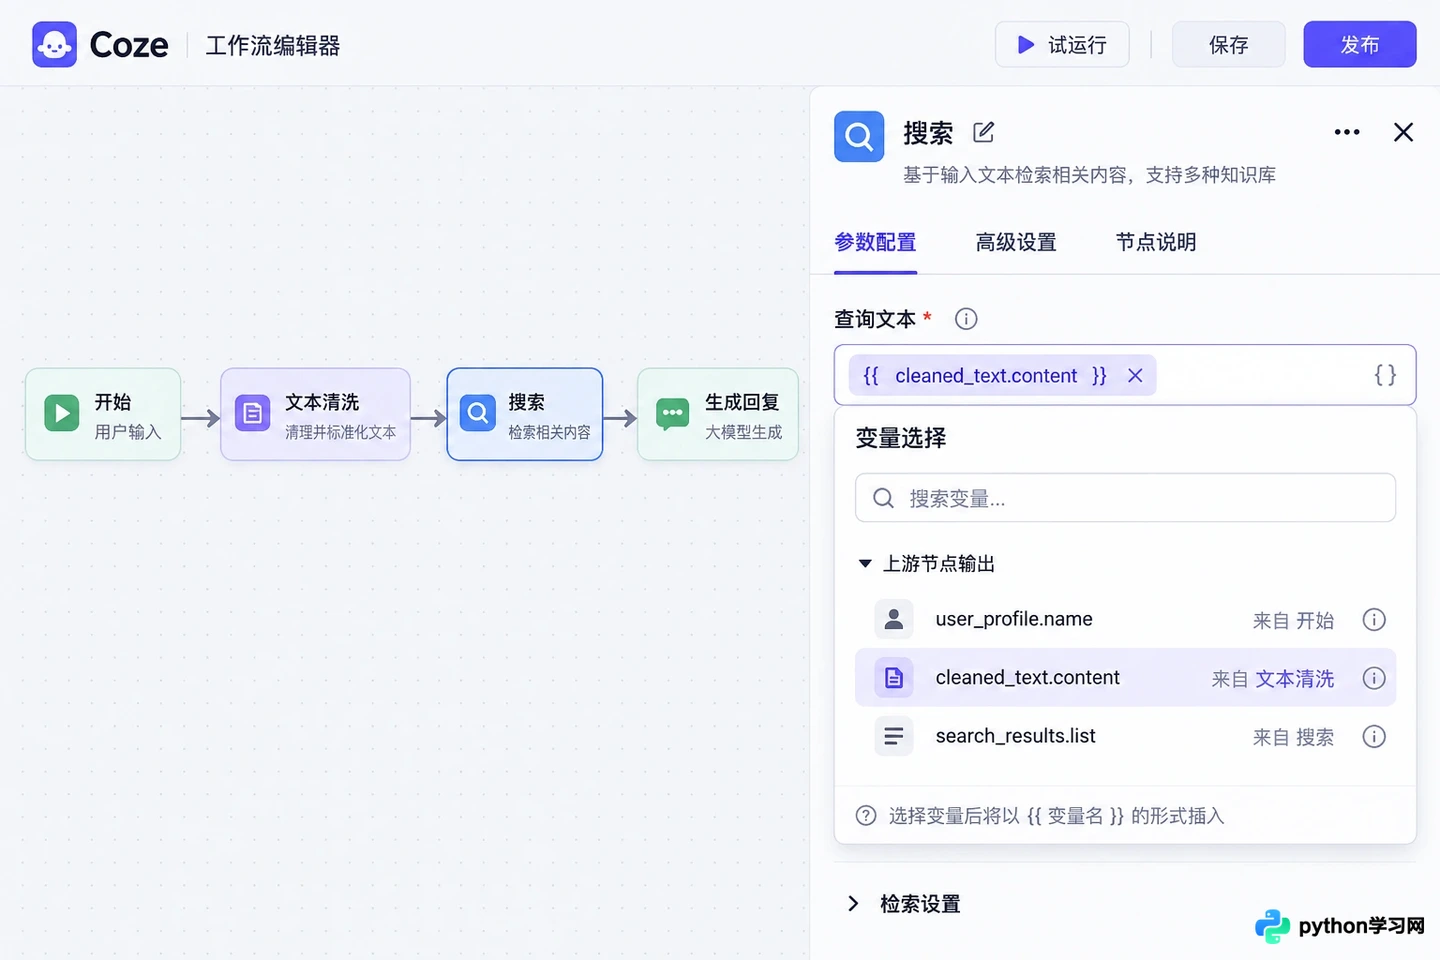
清晰命名的变量在节点间传递
在处理长链路逻辑时,经常会遇到“中间结果需要在最后一步使用”的情况。由于 DAG 的限制,你不能直接从第一个节点连线到最后一个节点而不经过中间节点。此时,可以利用“参数聚合”或在最终输出节点前,通过代码节点将所需的多个上游变量重新组装成一个对象。不要试图在一个节点里完成所有事情,保持每个节点的单一职责,通过清晰的变量流转来维持逻辑的可维护性。
异常捕获与兜底策略:构建健壮的自动化系统
无论逻辑设计得多么完美,外部依赖总会出错。API 可能超时,大模型可能返回格式错误的 JSON,用户可能输入非法字符。一个没有异常处理的工作流是脆弱的,一次失败就可能导致整个流程中断,给用户返回晦涩的系统错误代码。
Coze 提供了错误处理机制,允许你在关键节点设置“失败分支”。当节点执行报错时,流程不会直接终止,而是转向你预设的补救路径。
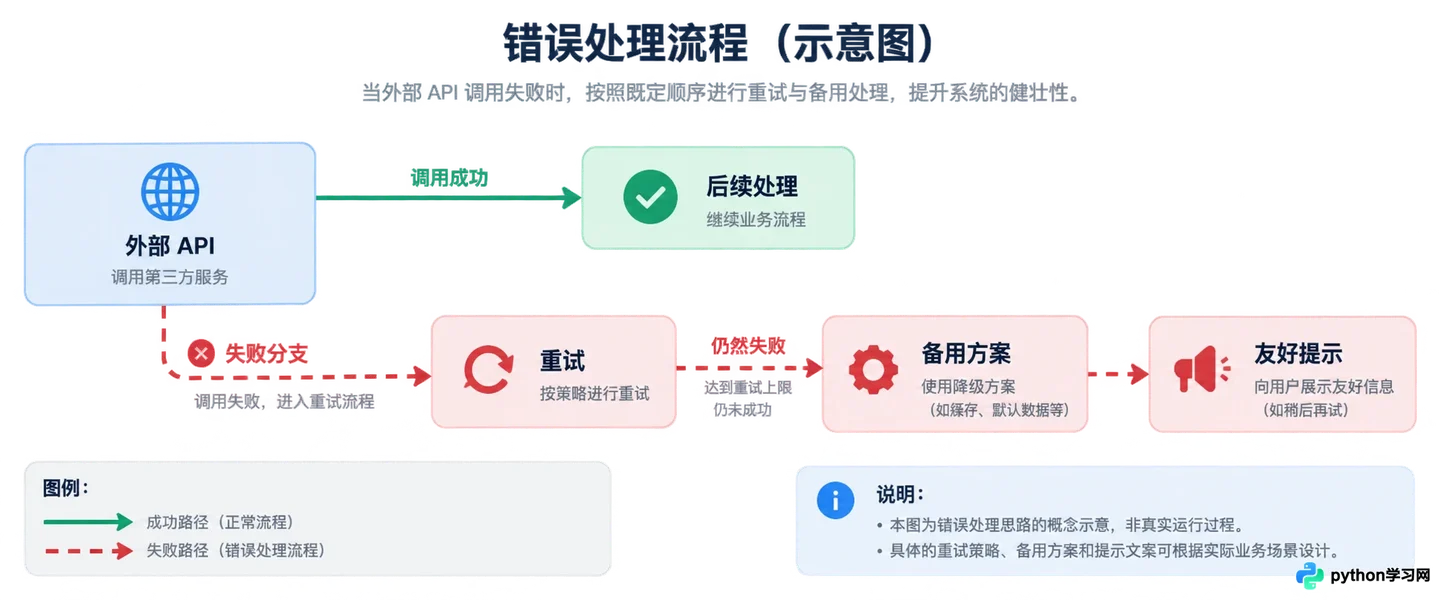
设置节点失败后的兜底路径
常见的兜底策略包括:重试机制(对于网络波动导致的临时失败)、降级服务(当高级模型不可用时切换到基础模型或规则引擎)、以及友好提示(当无法处理时告知用户具体原因并引导重新输入)。例如,在调用外部搜索插件时,如果返回空结果或超时,可以连接到一个备用知识库检索节点,而不是直接报错。
记住,优秀的自动化不是从不犯错,而是优雅地处理错误。 在设计复杂逻辑时,花 20% 的时间思考“如果这一步失败了怎么办”,能节省 80% 后期排查线上故障的时间。
回到开头的取舍,编排复杂工作流确实比简单对话机器人更耗费心力。它要求你具备类似程序员的逻辑思维,去拆解业务、定义边界、处理异常。但对于那些重复性高、逻辑明确且对准确性有要求的业务场景,这种投入是值得的。它不再是一个只会聊天的玩具,而是一个能真正替人干活的数字员工。如果你发现自己在反复复制粘贴同样的操作步骤,或者在多个系统间手动搬运数据,那么现在就是开始钻研 Coze 复杂工作流编排的最佳时机。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















