


Python爬虫100例实战:多线程与asyncio异步并发抓取优化

一、爬虫并发核心:I/O 密集型场景与底层机制解析
网络爬虫是典型的 I/O 密集型任务。发出一个 HTTP 请求后,本地 CPU 只需几微秒构造报文并写入套接字,随后长达数十毫秒甚至数秒的时间均处于等待远程响应的状态。如果采用顺序遍历的方式执行,总耗时将随请求数线性增长。
为了打破这一瓶颈,Python 提供了两种主要的并发处理方案:基于操作系统原生线程的多线程并发,以及基于事件循环的单线程协作式异步。理解它们在资源消耗与调度方式上的本质差异,是选择正确优化方案的前提。
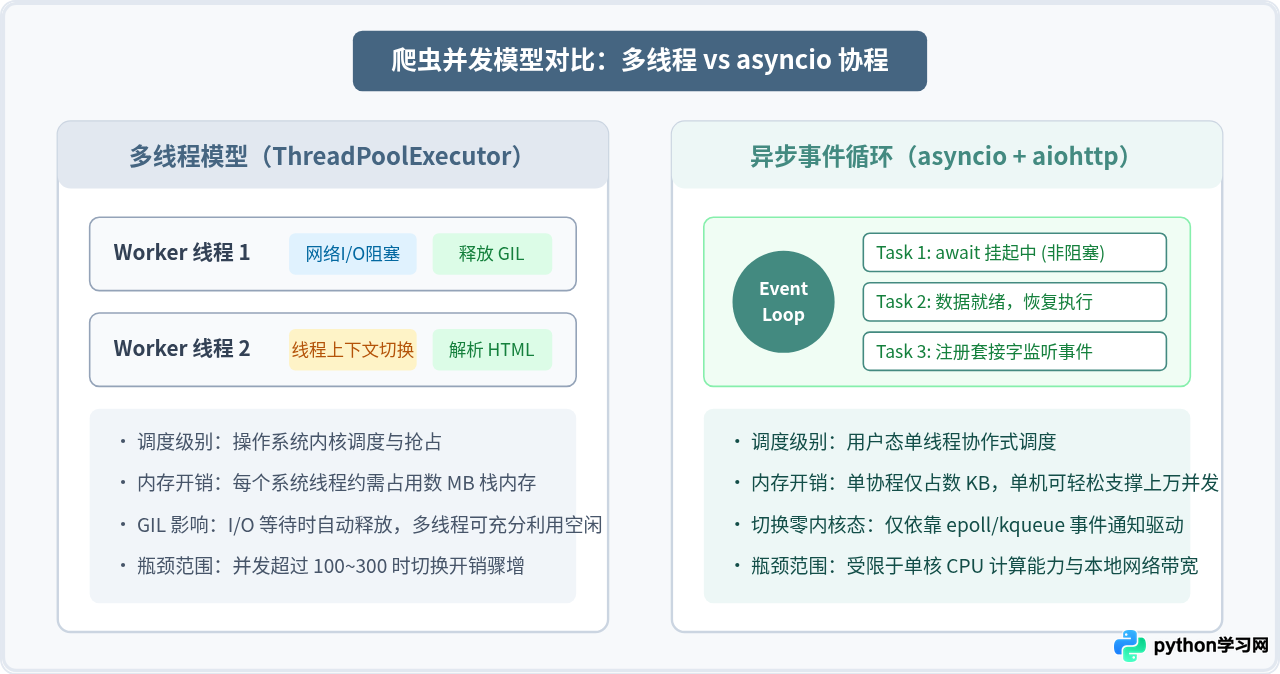
虽然 Python 存在全局解释器锁(GIL),但正如上图所示,当线程执行底层网络 I/O 操作时,Python 会主动释放 GIL,允许其他工作线程继续运行。因此,多线程在处理爬虫这种以网络等待为主的任务时是完全有效的。然而,当并发量级提升到上千甚至数万时,多线程受制于操作系统的线程上下文切换损耗和栈内存占用,而 asyncio 则凭借极低的单协程开销展现出绝对优势。
二、多线程实战:ThreadPoolExecutor 与 Session 连接池复用
在中小规模采集(并发数通常在 10 到 50 之间)时,多线程是改造老旧同步代码成本最低的方案。使用标准库 concurrent.futures.ThreadPoolExecutor 可以方便地管理线程生命周期与任务分发。
在多线程爬虫中,一个最容易被忽略的关键点是 TCP 连接复用。若每次在线程内临时调用 requests.get(),每个任务都会完整经历 DNS 解析、TCP 三次握手和 TLS 协商,造成数倍的延迟与系统套接字浪费。正确做法是为每个线程分配独立的 requests.Session(),或在线程本地存储(Thread Local)中复用 Session。
import time
import threading
from concurrent.futures import ThreadPoolExecutor, as_completed
import requests
from requests.adapters import HTTPAdapter

# 创建线程本地存储,确保每个线程独立拥有一个复用的 Session
thread_local = threading.local()

def get_session():
    if not hasattr(thread_local, "session"):
        session = requests.Session()
        # 配置底层 HTTPAdapter 连接池容量与重试机制
        adapter = HTTPAdapter(pool_connections=20, pool_maxsize=20, max_retries=2)
        session.mount("https://", adapter)
        session.mount("http://", adapter)
        thread_local.session = session
    return thread_local.session

def fetch_url(url, timeout=5):
    """单个抓取任务:执行请求并返回关键提取结果"""
    session = get_session()
    start_time = time.time()
    try:
        response = session.get(url, timeout=timeout)
        duration = round(time.time() - start_time, 2)
        if response.status_code == 200:
            return {"url": url, "status": 200, "len": len(response.text), "duration": duration, "error": None}
        return {"url": url, "status": response.status_code, "len": 0, "duration": duration, "error": "HTTP_ERROR"}
    except Exception as e:
        return {"url": url, "status": 0, "len": 0, "duration": round(time.time() - start_time, 2), "error": str(e)}

def run_multithread_crawler(urls, max_workers=10):
    """主调度函数:线程池并发控制与结果收集"""
    print(f"[+] 开始启动多线程爬虫,目标任务数: {len(urls)}, 线程池容量: {max_workers}")
    results = []
    start_all = time.time()

    with ThreadPoolExecutor(max_workers=max_workers) as executor:
        # 提交所有任务至线程池队列
        future_to_url = {executor.submit(fetch_url, url): url for url in urls}

        # 按照完成顺序流式获取结果
        for future in as_completed(future_to_url):
            res = future.result()
            results.append(res)
            print(f"[*] 完成抓取: {res['url']} | 耗时: {res['duration']}s | 状态: {res['status']}")

    total_time = round(time.time() - start_all, 2)
    print(f"[✓] 多线程任务全部完成,总耗时: {total_time} 秒,平均成功率: {sum(1 for r in results if r['status']==200)}/{len(urls)}")
    return results

if __name__ == "__main__":
    # 模拟构建 50 个待抓取页面地址
    test_urls = [f"https://httpbin.org/delay/1?page={i}" for i in range(1, 21)]
run_multithread_crawler(test_urls, max_workers=10)max_workers 时,切忌盲目扩大。网络爬虫线程数量的通用经验公式为:线程数 = CPU核心数 * (1 + 等待时间 / 计算时间)。对于典型网络延迟 0.5s、页面解析耗时 10ms 的场景,等待/计算比约为 50,单核配置 20~40 个工作线程已能将带宽跑满。过多的系统线程只会加剧内存开销并引起操作系统频繁调度颠簸。
三、架构跃迁:从同步到 asyncio 异步生态重构
当任务量级上升至数千以上时,多线程机制的弊端开始凸显。要实现真正的高性能爬虫,必须转向 Python 的原生协程生态。异步重构绝非简单在函数前加上 async,而是需要将整条流水线从“阻塞式执行”重构为“事件驱动流”。
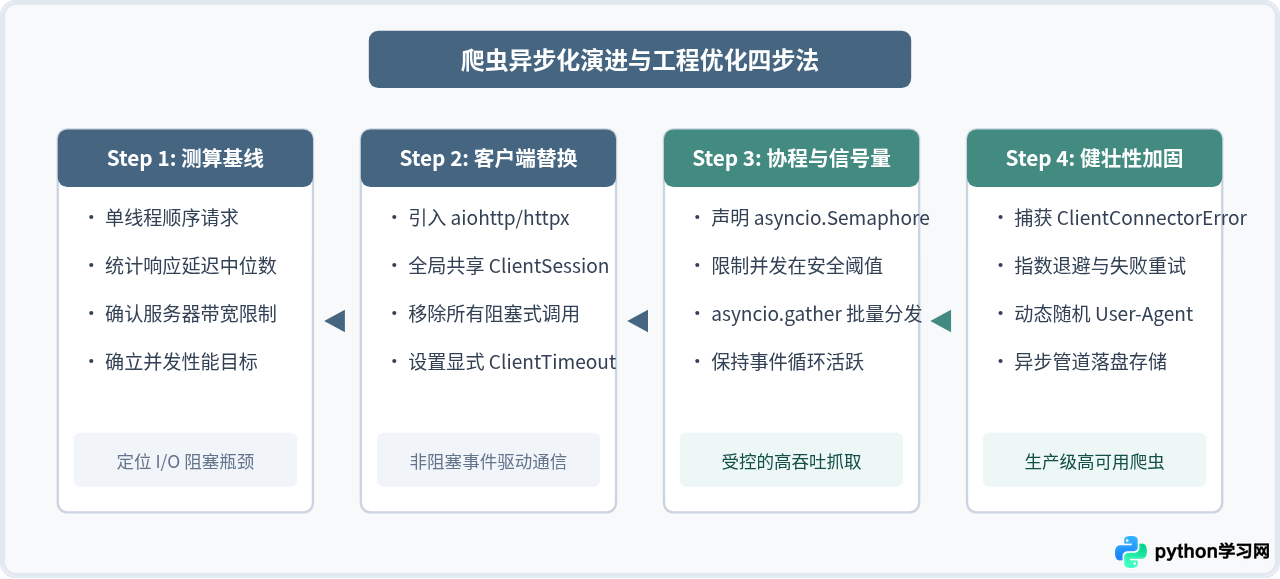
常见陷阱:为什么不能在异步代码中使用 requests?
许多初学者在初次编写 async def 爬虫时,直接在协程中调用 requests.get() 或 time.sleep()。这会导致严重的问题:阻塞主线程事件循环。
在 asyncio 单线程模型中,事件循环依赖所有的 I/O 操作以协作方式主动放弃 CPU 控制权(即通过 await 挂起)。如果调用了底层的阻塞式同步函数,整个事件循环将被卡死,哪怕注册了上万个并发协程,系统也将退化成极度低效的单任务顺序执行。必须全面使用异步驱动的网络库(如 aiohttp 或 httpx)。
四、并发控制实战:Semaphore 信号量与高可用限流
如果在异步爬虫中直接向事件循环塞入 1000 个任务并执行 asyncio.gather(*tasks),程序会在几毫秒内同时尝试建立 1000 个 TCP 连接。这不仅会直接耗尽操作系统本地的文件描述符(报 OSError: [Errno 24] Too many open files),而且极易被目标网站的反爬网关判定为拒绝服务攻击(DDoS)并直接封禁 IP 或返回 429 Too Many Requests。
为此,必须引入 asyncio.Semaphore(信号量) 对同时活跃的物理网络连接数实施精确压制。
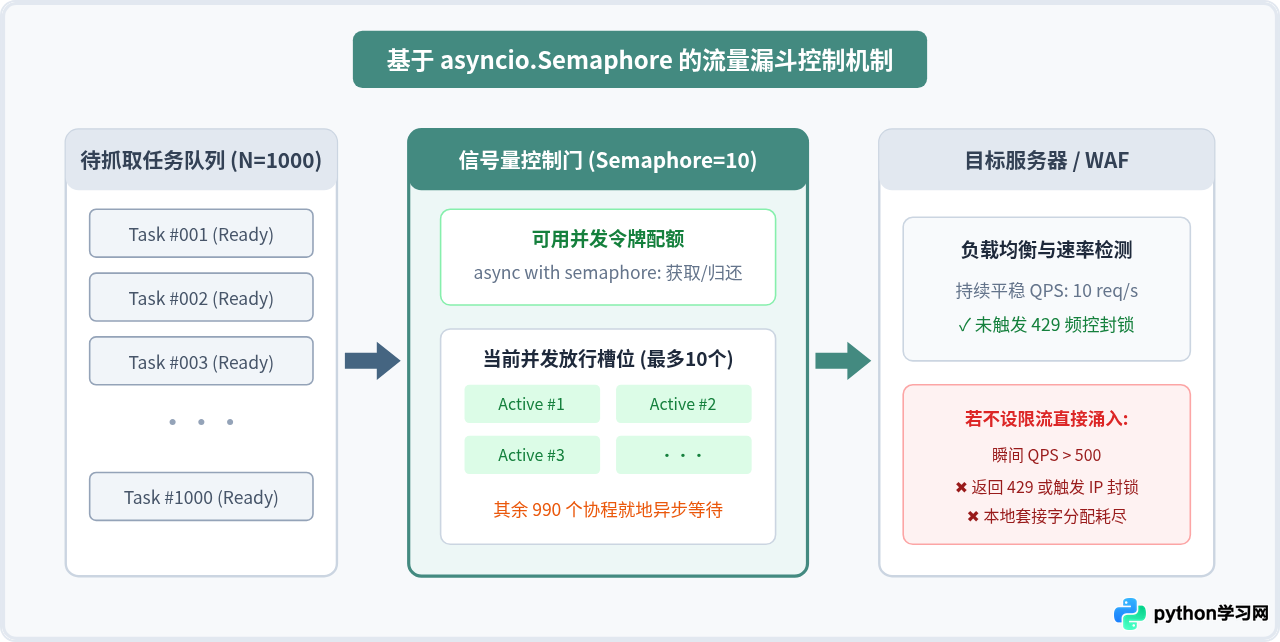
下面给出基于 aiohttp 生产级异步爬虫的完整实现。该代码整合了 TCPConnector 连接池管理、Semaphore 并发压制、全链路超时控制 以及 失败指数退避重试 四大核心优化:
import asyncio
import time
import random
import aiohttp
from aiohttp import ClientSession, ClientTimeout, TCPConnector

async def fetch_page(session: ClientSession, url: str, semaphore: asyncio.Semaphore, max_retries: int = 3):
    """
    单个 URL 抓取协程:
    受信号量保护,包含自动重试与异常隔离
    """
    async with semaphore:  # 控制同时活跃的 HTTP 连接数
        for attempt in range(1, max_retries + 1):
            start_ts = time.time()
            try:
                # 设定随机 User-Agent 与请求头
                headers = {
                    "User-Agent": f"Mozilla/5.0 (Windows NT 10.0; Win64; x64) CrawlerBot/{random.randint(100, 999)}"
                }
                async with session.get(url, headers=headers) as response:
                    elapsed = round(time.time() - start_ts, 2)
                    if response.status == 200:
                        content = await response.text()
                        return {
                            "url": url,
                            "status": 200,
                            "length": len(content),
                            "duration": elapsed,
                            "attempt": attempt,
                            "error": None
                        }
                    elif response.status in (429, 503):
                        # 触发反爬频控或服务端暂时过载,退避等待
                        backoff = 0.5 * (2 ** attempt) + random.uniform(0.1, 0.5)
                        await asyncio.sleep(backoff)
                        continue
                    else:
                        return {
                            "url": url,
                            "status": response.status,
                            "length": 0,
                            "duration": elapsed,
                            "attempt": attempt,
                            "error": f"HTTP_ERR_{response.status}"
                        }
            except (aiohttp.ClientError, asyncio.TimeoutError) as err:
                if attempt == max_retries:
                    return {
                        "url": url,
                        "status": 0,
                        "length": 0,
                        "duration": round(time.time() - start_ts, 2),
                        "attempt": attempt,
                        "error": str(err)
                    }
                # 出现网络抖动,轻微休眠后重试
                await asyncio.sleep(0.3 * attempt)

        return {"url": url, "status": 0, "length": 0, "duration": 0, "attempt": max_retries, "error": "MAX_RETRIES"}

async def run_async_crawler(urls: list, concurrency_limit: int = 20):
    """
    异步主调度器:
    维护全局 ClientSession、TCPConnector 连接池与任务分发
    """
    print(f"[+] 启动异步并发爬虫,目标任务数: {len(urls)}, 并发限制(Semaphore): {concurrency_limit}")

    # 1. 配置全局超时策略(总超时 15s,单次连接超时 5s)
    timeout = ClientTimeout(total=15, connect=5)

    # 2. 优化底层 TCPConnector,复用 Keep-Alive 连接并限制连接池尺寸
    connector = TCPConnector(
        limit=concurrency_limit * 2,         # 连接池最大总连接数
        limit_per_host=concurrency_limit,    # 单主机最大连接数
        enable_cleanup_closed=True,
        ttl_dns_cache=300                    # DNS 缓存保留 5 分钟
    )

    semaphore = asyncio.Semaphore(concurrency_limit)
    start_time = time.time()

    # 3. 创建全局生命周期的 ClientSession
    async with ClientSession(connector=connector, timeout=timeout) as session:
        # 为每个 URL 生成待执行的协程任务
        tasks = [fetch_page(session, url, semaphore) for url in urls]

        # 并发调度所有任务并等待全部返回
        results = await asyncio.gather(*tasks, return_exceptions=False)

    total_duration = round(time.time() - start_time, 2)
    success_count = sum(1 for r in results if r["status"] == 200)
    print(f"[✓] 异步任务全部结束,总耗时: {total_duration}s,成功抓取: {success_count}/{len(urls)}")
    return results

if __name__ == "__main__":
    # 生成 100 个模拟目标地址
    target_urls = [f"https://httpbin.org/delay/1?page={i}" for i in range(1, 101)]

    # 运行 asyncio 事件循环
    asyncio.run(run_async_crawler(target_urls, concurrency_limit=25))
五、并发方案选型与性能优化全景指南
面对实际的爬虫工程,并非所有场景都必须无脑选用 asyncio。选择适合当前业务规模、团队技术栈与目标网站特征的方案,才能在开发效率与运行性能之间取得最佳平衡。
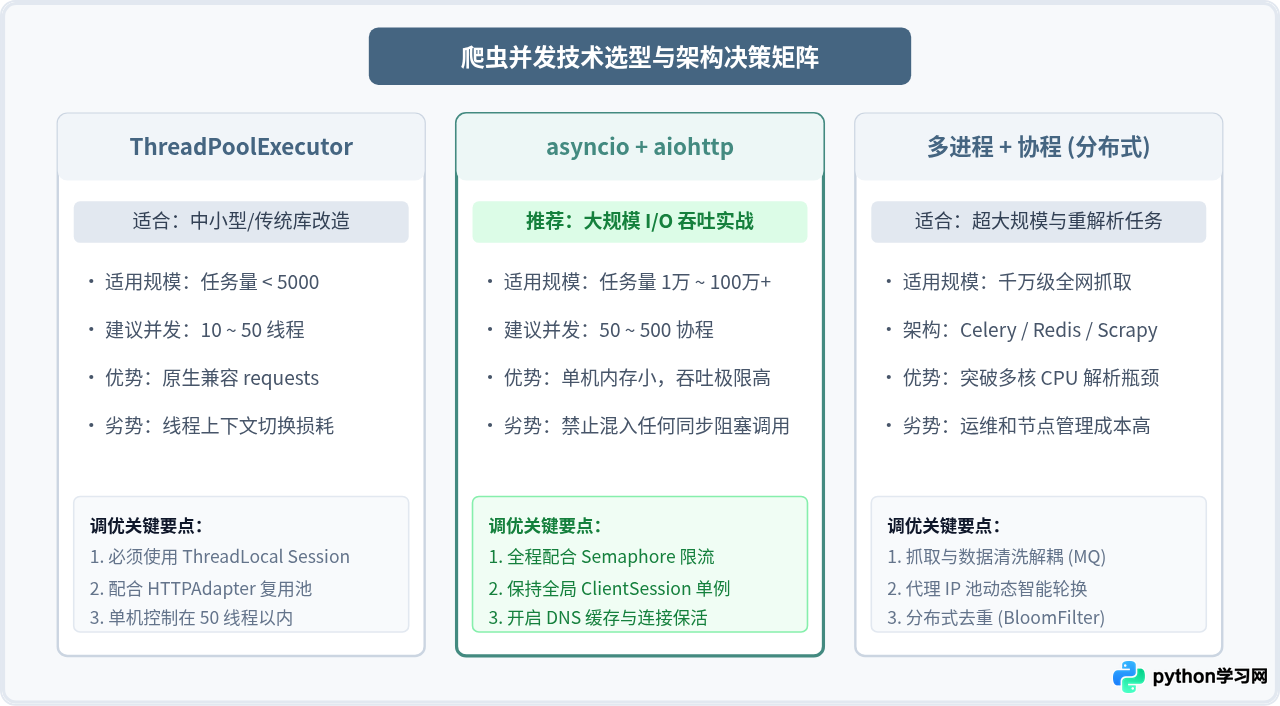
实战测试对照分析
为了直观展现不同优化策略对爬虫抓取效率的影响,我们在测试环境中模拟了 100 个平均延迟为 1 秒的目标接口,测试结果如下:
| 实现方案 | 并发参数配置 | 总耗时(100 个任务) | 内存占用峰值 | 核心瓶颈与限制 |
|---|---|---|---|---|
| 单线程同步抓取 | 无并发(顺序执行) | 约 104.2 秒 | 约 18 MB | 极度受限于网络 I/O 阻塞 |
| ThreadPoolExecutor | max_workers = 10 | 约 11.5 秒 | 约 36 MB | 线程数量受限,易受系统调度开销影响 |
| ThreadPoolExecutor | max_workers = 25 | 约 5.1 秒 | 约 58 MB | 连接池若未复用会导致套接字大量占用 |
| asyncio + aiohttp | Semaphore = 25 | 约 4.3 秒 | 约 24 MB | 单线程非阻塞,高效平稳 |
| asyncio + aiohttp | Semaphore = 50 | 约 2.4 秒 | 约 26 MB | 内存开销极低,受限于远程服务端承受力 |
六、高并发爬虫生产环境调优细节
- DNS 解析缓存:默认情况下,每次发起异步请求都可能触发系统 DNS 解析。在
aiohttp.TCPConnector中务必设置ttl_dns_cache=300,将域名解析结果缓存在内存中,避免在高频并发下把本机的 DNS 服务器打满。 - 限制单主机最大连接:如果爬虫是抓取同一个网站(例如同域名下的详情页),必须指定
limit_per_host。许多 Web 容器(如 Nginx、Tomcat)单个 IP 默认只允许 30~50 个活跃 Keep-Alive 连接,超过阈值会直接断开连接或限流。 - 抓取与落盘异步解耦:不要在
fetch_page协程中直接执行阻塞式的open(..., 'w').write()或同步数据库存储。可以使用asyncio.Queue将抓取到的 HTML 投递至队列中,由后台专用的持久化消费 Worker 异步批量批量写入磁盘或数据库,确保网络抓取流水线始终全速运转。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















