


提升Python爬虫效率:使用asyncio和aiohttp实现异步并发抓取
深入讲解如何使用Python的asyncio标准库与aiohttp库构建高效的异步并发网络爬虫,包含连接池复用、并发度控制、超时异常处理及常见避坑指南。
在网络爬虫任务中,数据抓取的大部分时间消耗在等待远程服务器响应和网络数据传输上,属于典型的网络 I/O 密集型场景。传统的单线程同步请求在发起 HTTP 请求后必须停下等待响应,导致 CPU 算力大量空转;而直接开启海量线程又会带来操作系统上下文切换与高内存开销。解决这一效率瓶颈的标准方案,是利用 Python 官方提供的 asyncio 异步事件循环体系与第三方的 aiohttp 异步 HTTP 客户端,在单线程内实现高效的非阻塞并发抓取。
一、为什么常规爬虫会变慢:I/O 阻塞与并发本质
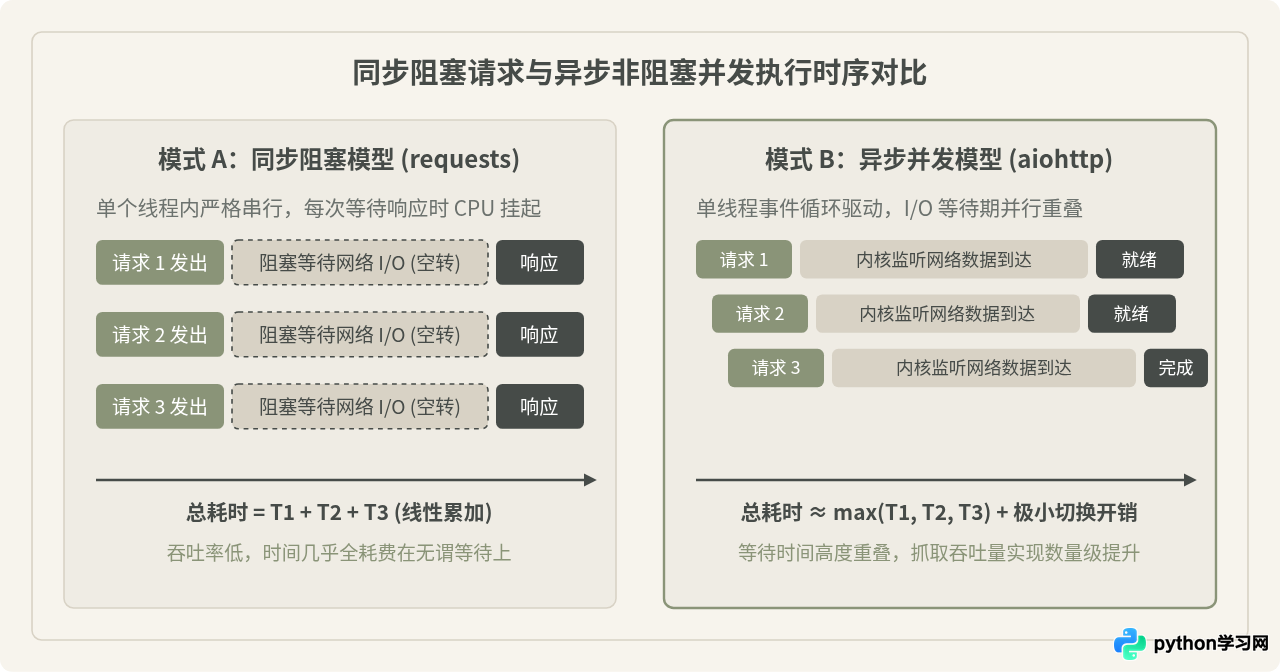
使用经典的 requests 库编写爬虫时,每一次执行 requests.get() 都会阻塞当前线程,直到目标服务器返回完整的 HTTP 报文。当我们需要抓取上千个网页时,如果单个请求平均耗时 0.5 秒,1000 个请求串行累加就需要超过 500 秒。虽然多线程可以改善这一情况,但 Python 的全局解释器锁(GIL)以及操作系统线程带来的栈内存占用(通常每个线程消耗几兆字节),决定了线程池规模无法无限扩展,一般数十个线程就会接近瓶颈。
异步 I/O 采用了完全不同的调度模型。在 asyncio 的事件循环(Event Loop)中,整个程序仅由单个线程承载,当某个网络请求发出后,底层由操作系统内核(如 Linux 的 epoll 或 macOS 的 kqueue)接管等待就绪通知。此时 Python 解释器不会处于休眠等待状态,而是立即切换去执行其他已就绪的任务。这种协作式的协程切换开销极小,单个进程内可以轻松维持数千个并发网络连接。
二、核心机制与协作流程
在 Python 中实现高效的异步抓取,需要 asyncio 与 aiohttp 两者紧密配合:
- asyncio(标准库):负责提供事件循环系统、定义协程(
async def)、挂起等待操作(await)、汇集任务集(asyncio.gather)以及提供限流机制(asyncio.Semaphore)。 - aiohttp(第三方异步网络库):负责构建非阻塞的套接字连接(Socket)、HTTP 请求打包、DNS 异步解析、连接池复用(
TCPConnector)及响应流式解析。
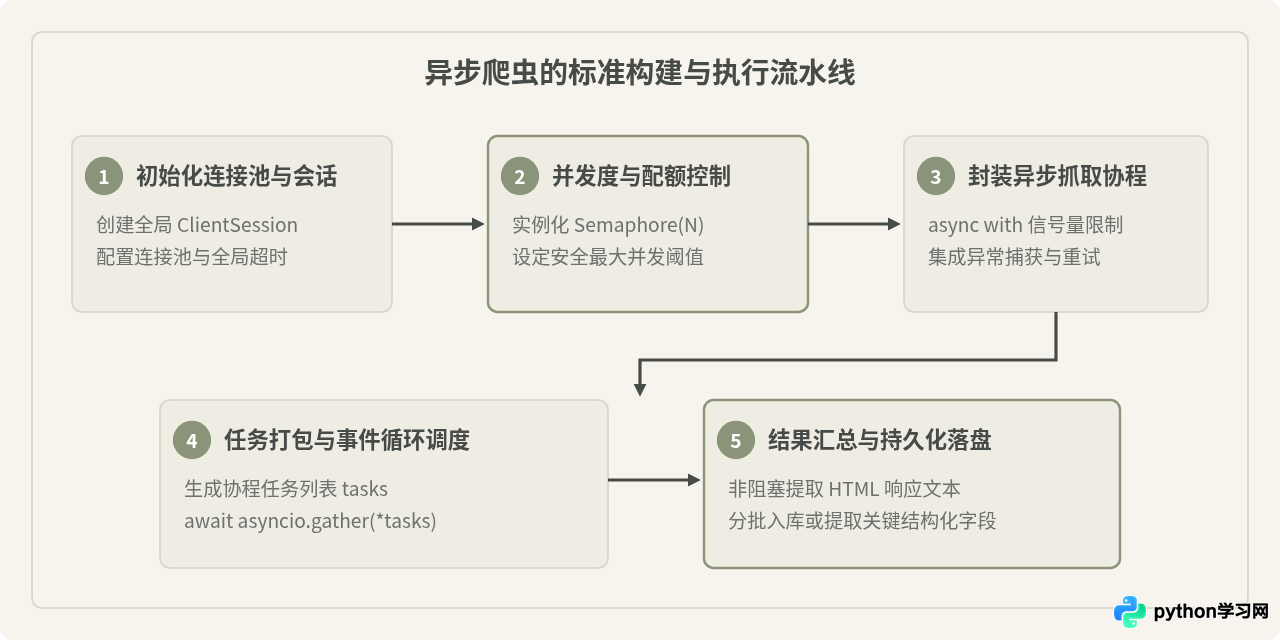
规范的异步爬虫构建过程遵循固定的生命周期:首先在顶层协程中建立共享的 ClientSession,然后借助 asyncio.Semaphore 设定并发上限,接着为每一个 URL 派生异步抓取任务,最后交由 asyncio.gather 驱动全部任务并在单线程中收集解析结果。
三、核心实战:从单请求到并发抓取
在开始编写代码前,需确保已在环境中安装 aiohttp(运行 pip install aiohttp 即可)。编写异步爬虫的关键准则是:**永远不要在同一个抓取任务中为每个 URL 重新创建 ClientSession**。ClientSession 内部维护了高效的 TCP 连接池与 DNS 缓存,必须在全局作用域内共享并统一通过异步上下文管理器进行关闭。
1. 单个异步请求基础语法
import asyncio
import aiohttp

async def fetch_page(url: str):
    # 正确做法:使用 aiohttp.ClientSession 发起非阻塞请求
    timeout = aiohttp.ClientTimeout(total=10)
    async with aiohttp.ClientSession(timeout=timeout) as session:
        async with session.get(url) as response:
            print(f"HTTP 状态码: {response.status}")
            # 注意:读取响应体是异步操作,必须使用 await
            html = await response.text()
            return len(html)

if __name__ == "__main__":
    result_len = asyncio.run(fetch_page("https://httpbin.org/get"))
    print(f"抓取完成,网页内容长度: {result_len}")
四、关键控制:使用 asyncio.Semaphore 限制并发
许多初学者在使用异步爬虫时会陷入一个误区:“既然异步效率高,我直接用 asyncio.gather 把 5000 个任务一次性发射出去岂不是最快?”
在没有限流的情况下瞬间向目标服务器打出海量连接,往往会导致严重问题:一方面会迅速触发目标站点的反爬风控机制(如 HTTP 429 Too Many Requests 或封禁 IP);另一方面,操作系统的文件描述符配额(ulimit)会被迅速耗尽,抛出 OSError: [Errno 24] Too many open files 异常。
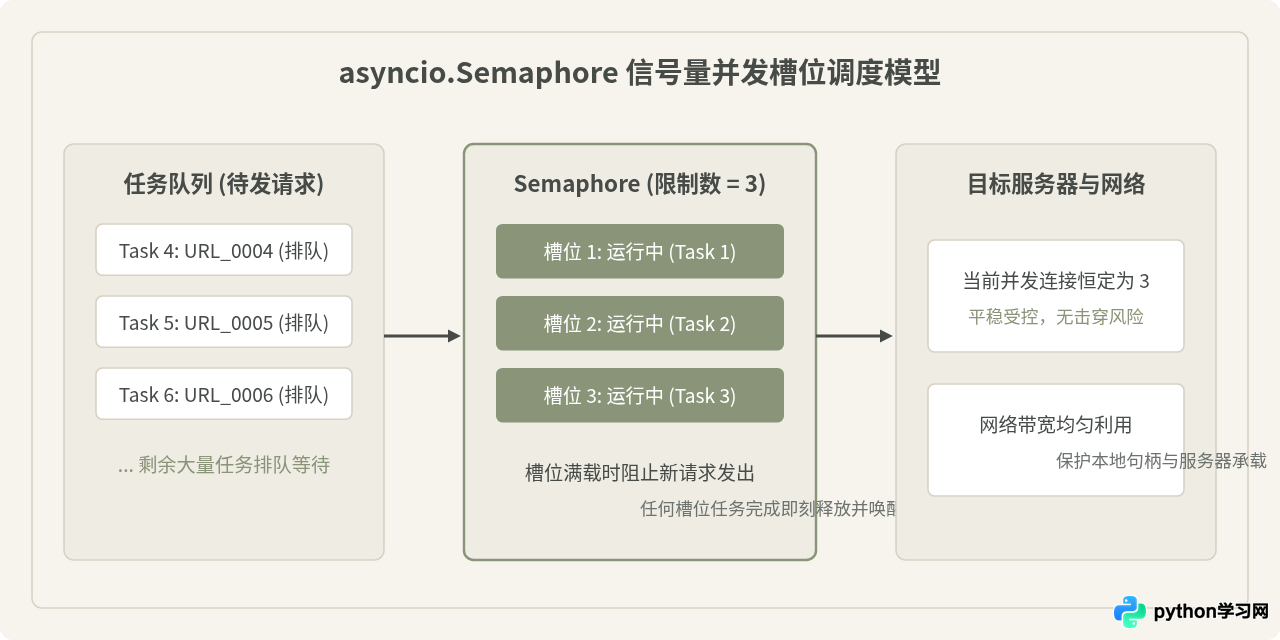
在 asyncio 中,最简便有效的控频工具是 asyncio.Semaphore(信号量)。它就像一个指定容量的通行门,当并发协程数量达到设定的上限时,后续协程会自动排队等待,只有正在执行的协程释放槽位后,新请求才能发出。
2. 工业级并发爬虫标准完整示例
下面是一个具备连接复用、并发控制、超时保护与异常捕获的完整实用脚本:
import asyncio
import aiohttp
from typing import List, Dict, Any

# 核心配置参数
CONCURRENCY_LIMIT = 10     # 最大并发协程数
REQUEST_TIMEOUT = 15       # 单请求超时时长 (秒)
TARGET_URLS = [
    f"https://httpbin.org/delay/{i % 3}" for i in range(30)
]

async def safe_fetch(
    session: aiohttp.ClientSession,
    url: str,
    semaphore: asyncio.Semaphore
) -> Dict[str, Any]:
    """通过信号量包装的受控抓取函数"""
    async with semaphore:
        try:
            async with session.get(url) as response:
                if response.status == 200:
                    text = await response.text()
                    return {"url": url, "status": 200, "bytes": len(text), "error": None}
                else:
                    return {"url": url, "status": response.status, "bytes": 0, "error": f"HTTP {response.status}"}
        except asyncio.TimeoutError:
            return {"url": url, "status": 0, "bytes": 0, "error": "请求超时"}
        except aiohttp.ClientError as err:
            return {"url": url, "status": 0, "bytes": 0, "error": f"网络通信异常: {err}"}
        except Exception as err:
            return {"url": url, "status": 0, "bytes": 0, "error": f"未知异常: {err}"}

async def run_crawler(urls: List[str]) -> List[Dict[str, Any]]:
    # 配置底层连接器与超时约束
    connector = aiohttp.TCPConnector(limit=CONCURRENCY_LIMIT * 2, enable_cleanup_closed=True)
    timeout = aiohttp.ClientTimeout(total=REQUEST_TIMEOUT)
    semaphore = asyncio.Semaphore(CONCURRENCY_LIMIT)

    async with aiohttp.ClientSession(connector=connector, timeout=timeout) as session:
        # 创建全部并发任务
        tasks = [safe_fetch(session, url, semaphore) for url in urls]
        # 使用 asyncio.gather 并行调度
        results = await asyncio.gather(*tasks, return_exceptions=False)
        return results

if __name__ == "__main__":
    print(f"开始抓取 {len(TARGET_URLS)} 个目标,并发限制: {CONCURRENCY_LIMIT}...")
    import time
    start_time = time.perf_counter()

    crawl_results = asyncio.run(run_crawler(TARGET_URLS))

    elapsed = time.perf_counter() - start_time
    success_count = sum(1 for item in crawl_results if item["status"] == 200)
    print(f"任务结束!成功: {success_count}/{len(crawl_results)},总耗时: {elapsed:.2f} 秒")
代码要点说明:
asyncio.Semaphore(CONCURRENCY_LIMIT)确保任意时刻处于传输中的连接数不会超过设定的上限。aiohttp.ClientTimeout(total=REQUEST_TIMEOUT)防止遇到慢速网络或僵死服务器导致某个协程永久停滞。- 在每个任务内部使用
try...except捕获aiohttp.ClientError和asyncio.TimeoutError,防止单个链接的失败中断整批任务的执行。
五、常见认知误区与避坑指南
在实际工程中,很多人虽然使用了 asyncio 语法,却由于细节处理不当导致性能归零或程序崩溃。以下是必须理清的核心细节:
1. 误区:在协程中调用同步阻塞库(如 requests、time.sleep)
原因剖析:asyncio 是单线程事件循环机制。如果在协程函数内部调用了 requests.get() 或 time.sleep(2),当前线程将直接被内核挂起,整个进程内的所有其他协程全部暂停推进。这会导致并发彻底退化为低效的单线程串行。
正确做法:必须始终使用全套异步库:用 await aiohttp.ClientSession.get() 替代 requests.get(),用 await asyncio.sleep() 替代 time.sleep()。如果必须调用无法异步化的第三方库,可使用 asyncio.to_thread() 将其委托给外部线程池。
2. 误区:盲目追求成千上万的高并发数
原因剖析:并发并不是数字越大越好。单机并发数主要受制于三项物理限制:本地带宽与网络上行瓶颈、操作系统文件描述符(fd)限制、以及目标服务器的负载均衡能力。过高的并发往往会触发 Cloudflare 或 WAF 等安全拦截策略,导致大量请求直接收到 403 阻断或 CAPTCHA 验证。
合理设置:一般普通爬虫任务将并发数控制在 10 ~ 30 之间,配合短暂的休眠抖动,既能将抓取耗时压缩到原来的数十分之一,又能保持长期的网络稳定性和隐蔽性。
六、总结
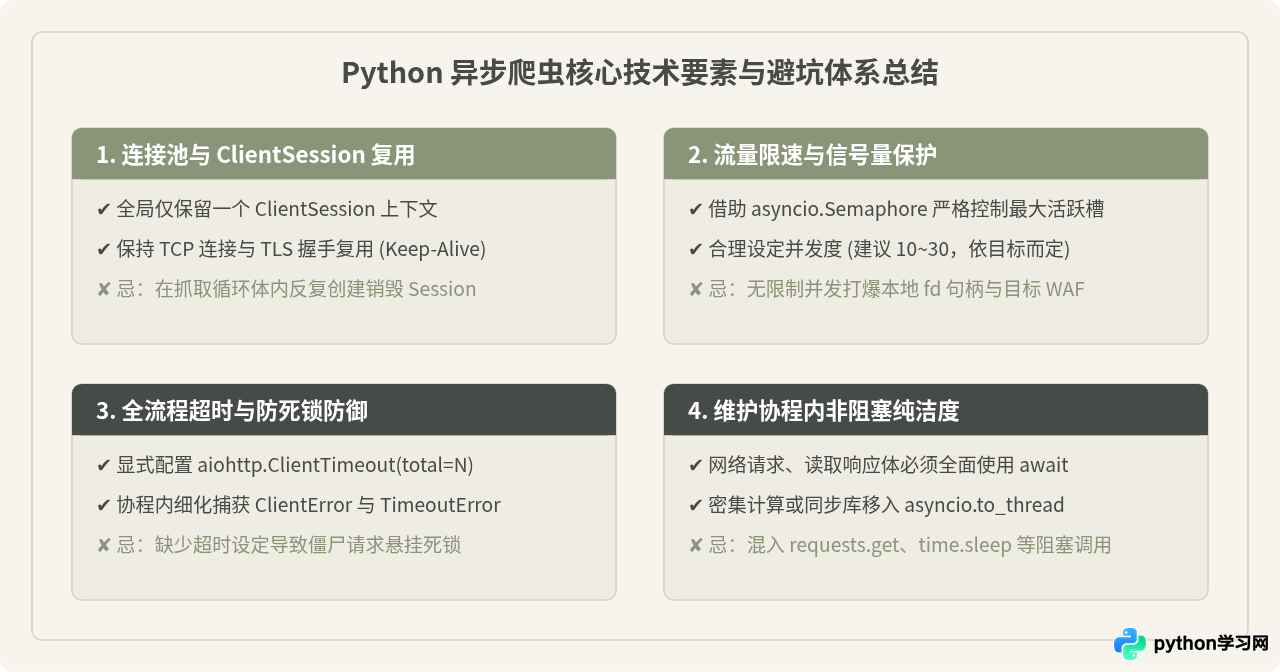
通过将 Python 标准库的 asyncio 与专为异步设计的 aiohttp 搭配使用,爬虫程序能够在单进程单线程环境下摆脱传统同步调用的阻塞限制。借助事件循环对空闲等待时间的极致重叠,网络吞吐效率能够获得数倍乃至数十倍的稳健提升。在实际开发中,谨记连接池全局复用、信号量严格限流、严禁混用阻塞库以及完善的超时重试机制,即可构建出兼具高并发与工业级稳定性的现代网络爬虫系统。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















