


Dify常见报错排查:解决部署失败、模型连接超时及索引异常

在私有化部署开源 LLM 应用开发平台 Dify 的过程中,最让人焦虑的时刻往往不是代码写不出来,而是服务跑不起来,或者跑起来后随时“断气”。很多团队在从 SaaS 版转向自托管时,容易低估基础设施的复杂性:以为拉取镜像就能用,结果卡在数据库连接;以为配好 API Key 就能对话,结果频繁遭遇超时;以为上传文档就能检索,结果索引一直pending。这些报错并非随机发生,它们通常指向环境依赖、网络策略或数据处理逻辑中的特定断层。排查的核心不在于盲目重试,而在于读懂容器日志背后的系统语言。
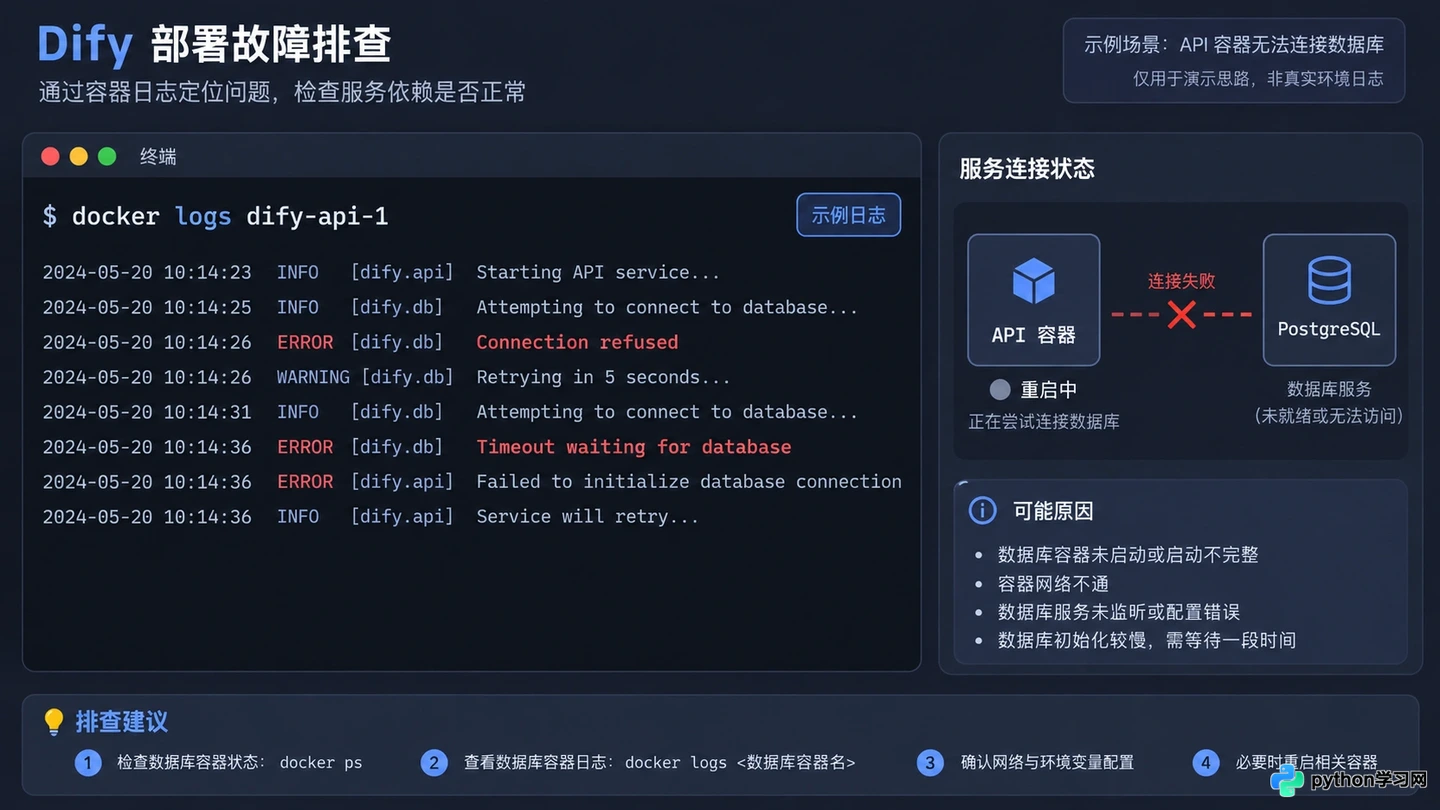
Dify API 容器因数据库连接失败而持续重启的日志截图
容器启动僵局:依赖服务的握手失败
当你执行 docker-compose up -d 后,如果核心服务 api 或 worker 持续重启(Restarting),这通常不是 Dify 本身的代码缺陷,而是底层依赖服务未能就绪。Dify 强依赖 PostgreSQL、Redis 和 Weaviate(或 Qdrant/Milvus)等中间件。最常见的场景是:数据库容器已启动,但 Dify 的 API 容器尝试连接时被拒绝。
这种情况下,首要动作不是重启 Dify,而是检查依赖服务的健康状态。进入 PostgreSQL 容器内部,确认监听端口和数据卷挂载权限是否正常。很多时候,问题出在 .env 配置文件中的 DB_HOST 指向错误,或者在 Docker 网络模式下,服务间无法通过容器名解析 IP。观察 docker logs dify-api-1 的输出,如果看到 “Connection refused” 或 “Timeout waiting for database”,请优先核对环境变量中的数据库地址与端口是否与 docker-compose.yml 中定义的服务名一致。
另一个隐蔽的陷阱是初始化管理员账号。如果首次启动后无法登录,且日志提示初始化脚本未执行,可能是因为之前的失败启动留下了脏数据。此时需要清理数据库卷并重新初始化,但务必先备份重要数据。在这种场景下,确保 INIT_PASSWORD 等关键环境变量在首次启动前已正确设置,能避免后续反复重置的麻烦。
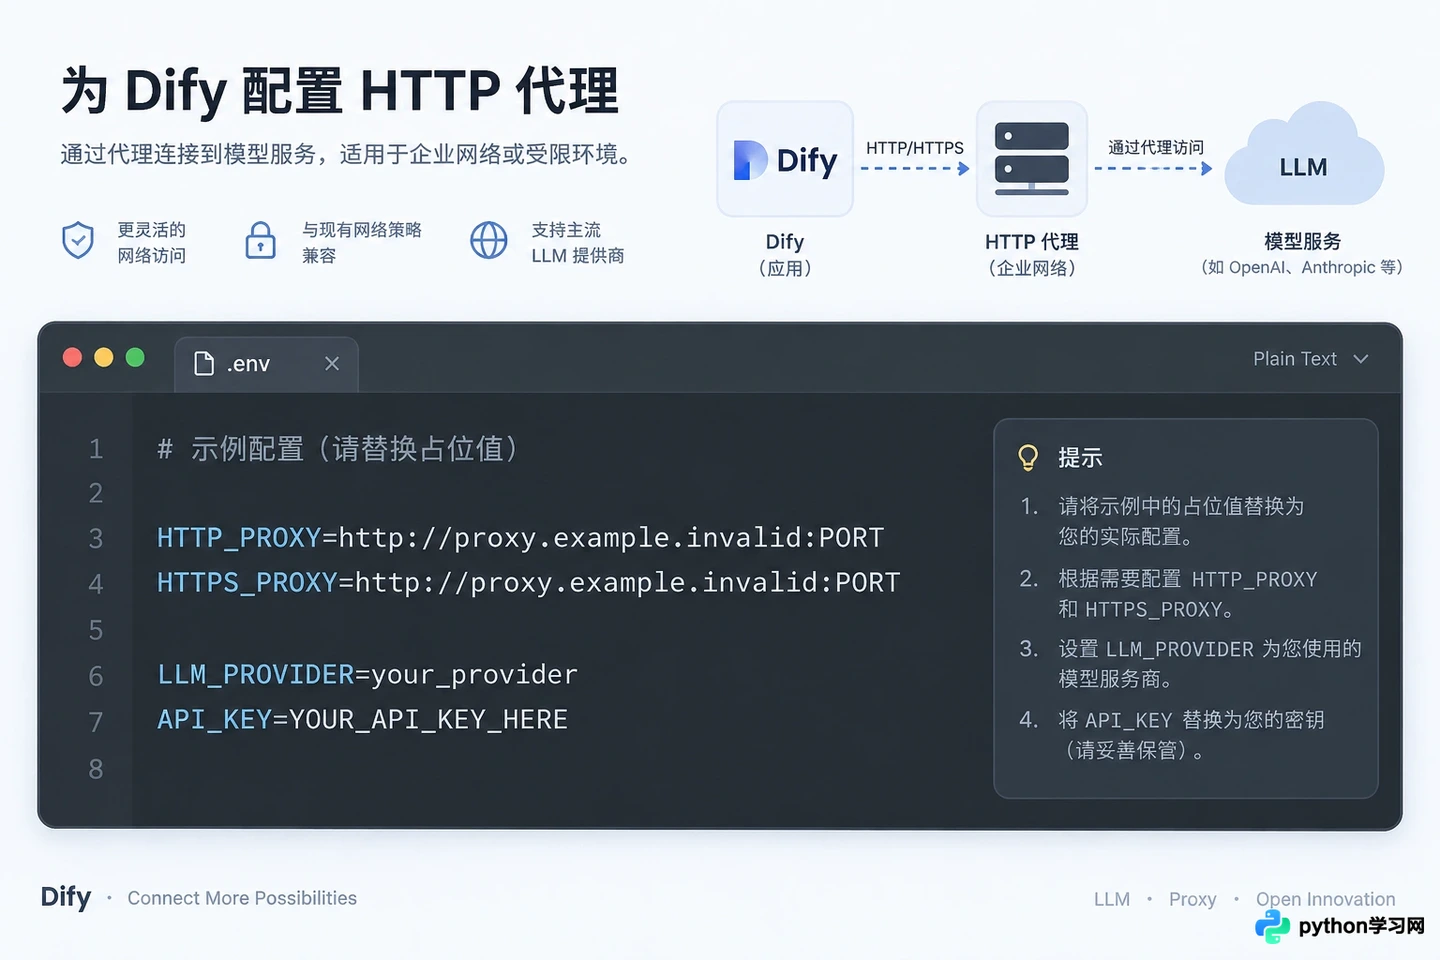
在 .env 文件中配置 HTTP 代理以解决模型连接超时
模型连接超时:网络策略与网关的博弈
应用部署成功,但在聊天界面发送消息后,前端长时间显示“思考中”最终报错“Request timed out”,这是私有化部署中最频发的体验断层。这通常意味着 Dify 后端无法在规定时间内收到 LLM 提供商的响应。原因大致分为两类:公网访问受限和本地代理配置缺失。
如果你使用的是 OpenAI、Anthropic 等海外模型服务商,而服务器位于国内,直连必然失败。此时需要在 .env 文件中配置 HTTP_PROXY 和 HTTPS_PROXY。关键在于,这个代理地址必须是容器网络内可访问的地址,例如宿主机的网关 IP,而非 127.0.0.1,因为容器内的 localhost 指向的是容器自身。配置完成后,必须重启 api 和 worker 容器使环境变量生效。
若是使用本地部署的 Ollama 或 Xinference 模型,超时则可能源于资源竞争或端点配置错误。检查 Dify 后台的模型提供商设置,确认 Base URL 是否指向了正确的局域网 IP 和端口。此外,本地大模型推理速度较慢,若生成的 Token 数量较多,可能超过 Dify 默认的请求超时阈值。在这种场景下,适当增加 Nginx 或反向代理层的 proxy_read_timeout 参数,可以为长文本生成争取更多时间,避免因网络层过早切断连接而导致的假性失败。
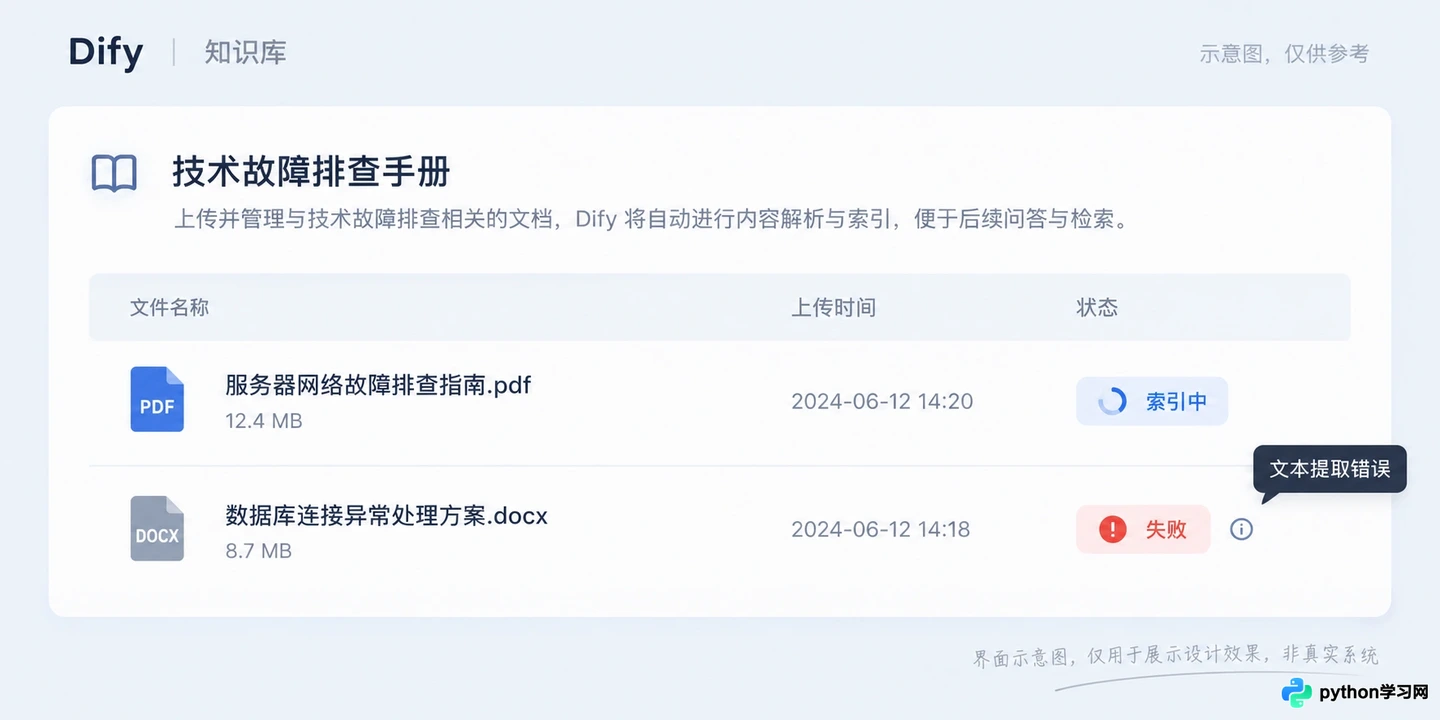
知识库文档索引状态显示为错误或正在处理中
索引构建异常:数据清洗与向量库的兼容性
知识库是 Dify 的核心功能之一,但“索引创建失败”或“分段处理错误”常让非技术背景的用户束手无策。当上传 PDF 或 Word 文档后,状态长期停留在“索引中”或直接变为“错误”,问题通常出在文件解析环节或向量数据库的连接上。
首先排查文件格式与大小。虽然 Dify 支持多种格式,但扫描版 PDF 或包含复杂表格的文档可能需要 OCR 支持,若未配置相应的 OCR 服务(如 Tesseract),解析可能会超时或失败。查看 worker 容器的日志,如果看到 “OCR processing failed” 或 “Text extraction error”,说明需要优化源文件质量或启用外部 OCR 服务。
其次,向量数据库的性能瓶颈也不容忽视。如果并发上传大量文档,Weaviate 或 Qdrant 可能因内存不足或写入队列堆积而拒绝服务。此时应监控向量库容器的资源使用情况,必要时调整其内存限制。另外,分段规则(Chunking)设置过于细碎也会导致索引任务激增,建议先使用默认的分段策略进行测试,排除因自定义规则导致的逻辑错误。在这种场景下,简化输入数据、分批上传,是验证系统稳定性的有效手段。
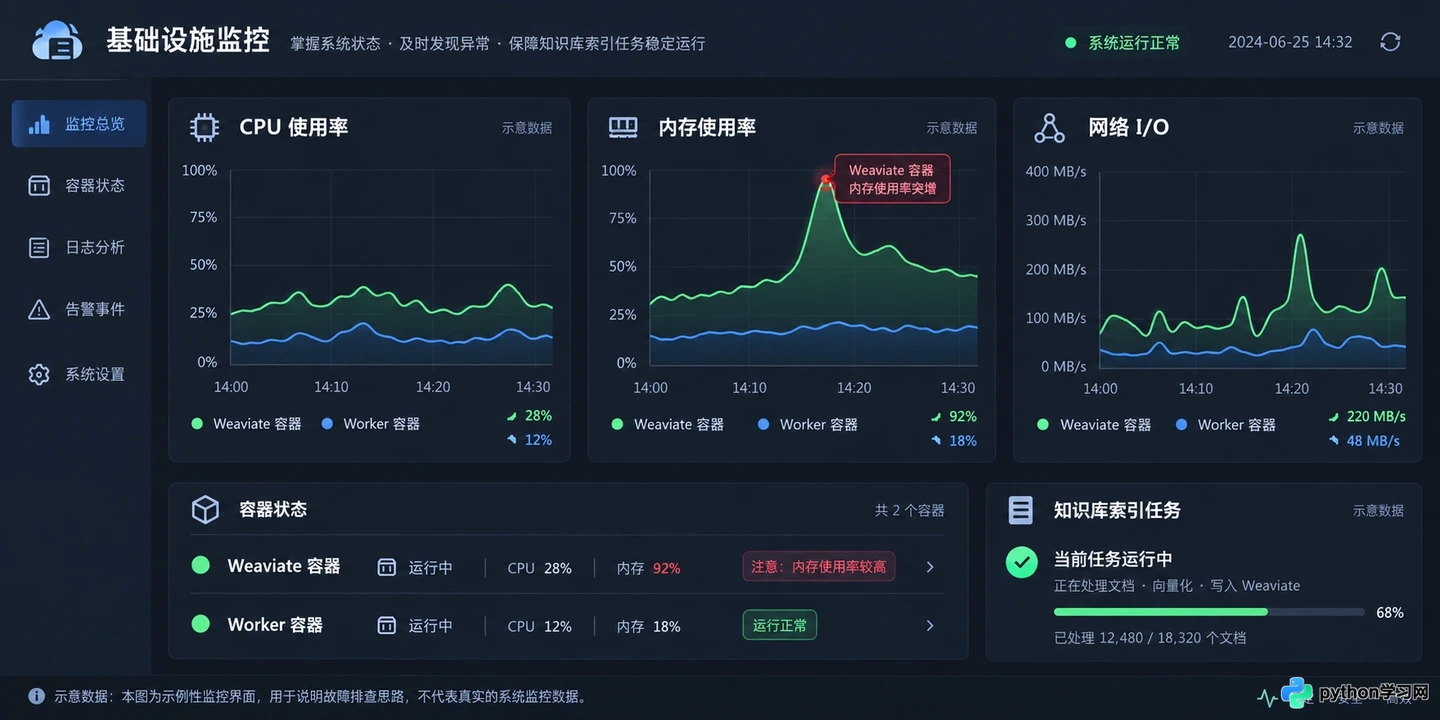
监控向量数据库和 Worker 容器的资源使用情况
回归稳定:从被动救火到主动监控
解决上述报错只是第一步,真正的挑战在于如何防止它们再次发生。Dify 的私有化部署不是一个“一次设置,永久运行”的黑盒,而是一个需要持续维护的系统。建立基础的日志监控机制,定期清理过期的对话记录和索引碎片,比事后排查更为重要。
对于团队而言,明确分工至关重要:运维人员负责保障 Docker 网络、存储卷和中间件的稳定性,开发人员则专注于模型参数调优和应用逻辑设计。当遇到报错时,不要急于重装系统,而是养成查看特定容器日志的习惯。大多数情况下,答案就藏在那些红色的错误堆栈里。
私有化部署的价值在于数据主权和定制化能力,但这同时也要求使用者具备相应的技术兜底能力。理解这些常见报错背后的系统逻辑,不仅能帮你快速恢复服务,更能让你在使用 Dify 构建 AI 应用时,拥有更从容的掌控感。毕竟,稳定的基础设施,才是创意落地的最佳土壤。
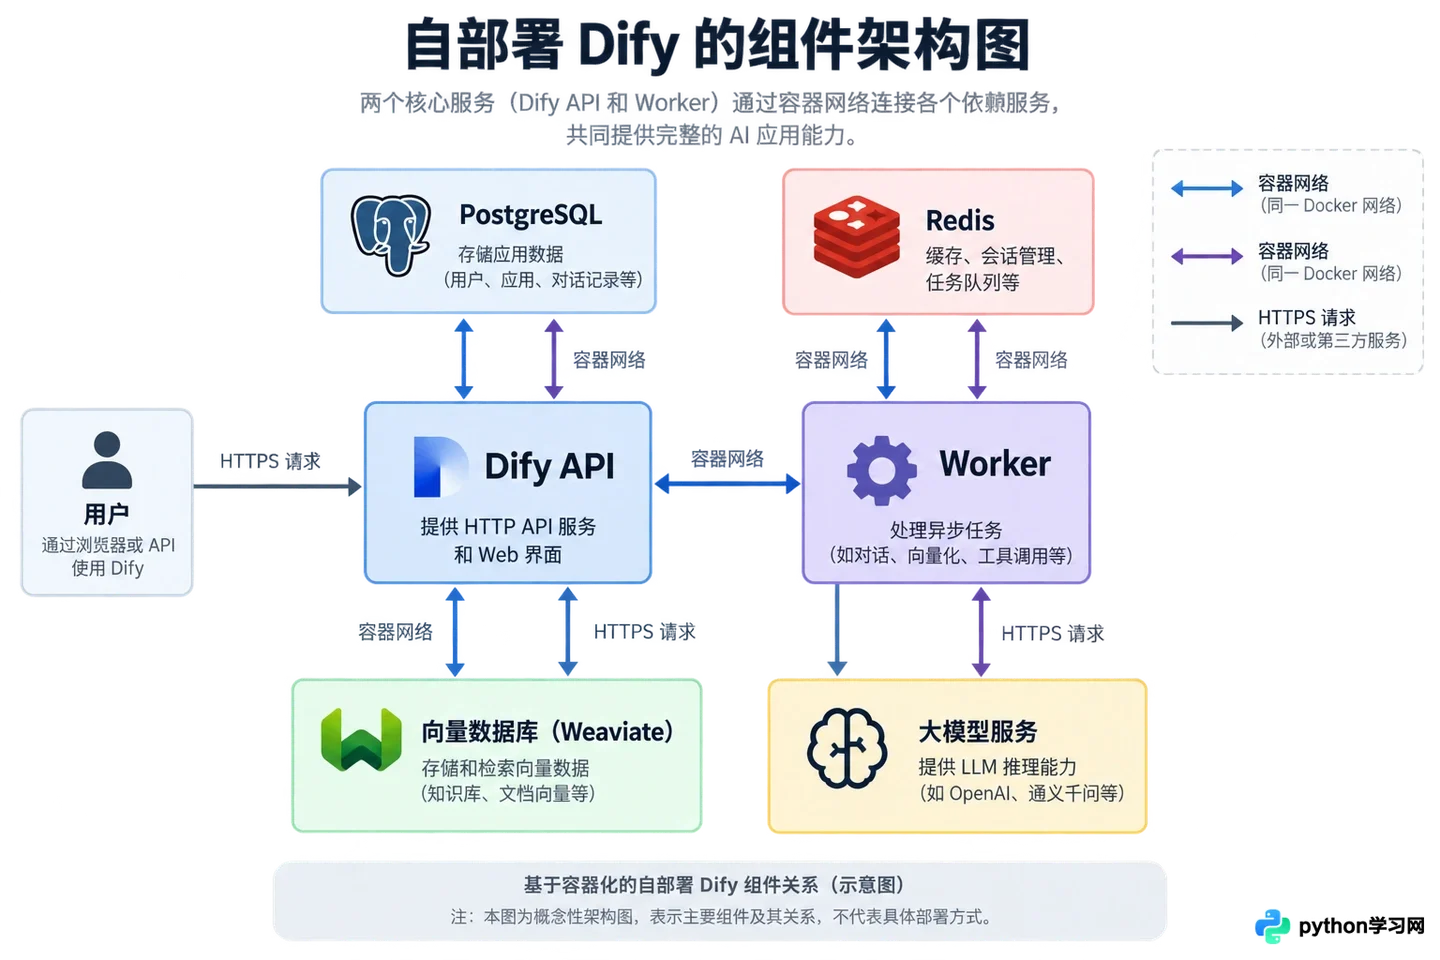
Dify 私有化部署各组件间的交互关系
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















