


Python自定义数据结构 vs 内置类型:何时需要手写类实现

dict、list、set、tuple)经过C底层深度优化,兼具开发效率与卓越性能;但在业务规则变多、字段耦合紧密、需要强制数据合法性或维护状态流转时,继续滥用裸字典与嵌套容器会带来隐式拼写错误、维护成本激增和逻辑严重外溢。手写类的核心价值并非单纯罗列数据,而是以极低的封装成本建立不可变性约束、领域行为封装与明确的调用契约。
一、内置类型的工程优势与其天然边界
在大多数日常脚本与轻量任务中,Python内置类型是第一选择。内置字典基于紧凑型哈希表实现,列表由连续指针数组驱动,它们在内存连续性、底层C代码执行速度以及现成的内置API支持上几乎无可挑剔。
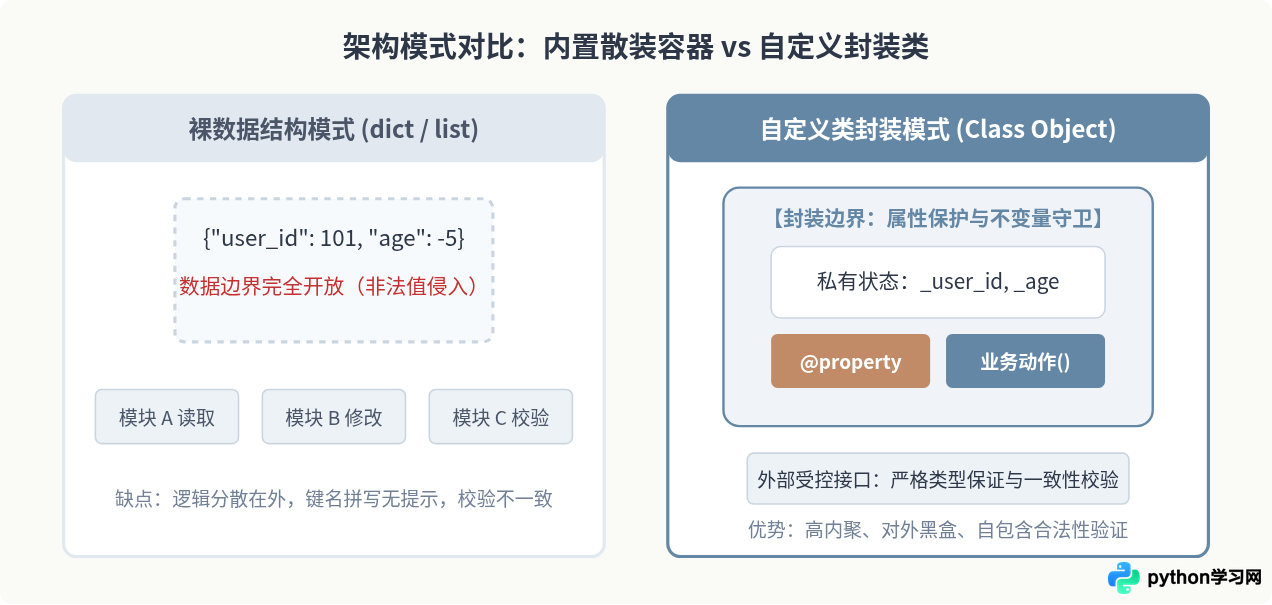
然而,随着项目规模扩大和业务复杂度提升,单纯使用原生容器会出现明显的工程反模式:
- 无显式契约约束:使用
dict存储数据时,键名的正确性完全依赖开发者记忆或字符串常量。拼写错误(如将status误写为statue)在静态扫描或函数传递中极难被提前发现,往往要等到运行时甚至特定分支被触发才暴露。 - 数据验证与清洗逻辑外溢:字典和元组是开放数据结构,任何外部函数都可以向其追加不合法的值(例如将负数赋给库存、将非法的状态字符串写入订单),校验逻辑不得不散落在各个调用方。
- 行为与状态割裂:数据存放在数据结构中,而改变数据的业务函数分散在各个模块中。如果需要对某个状态进行派生计算,调用方往往需要手动提取各个字段再进行计算,代码重复率高且易遗漏。
二、何时必须转向手写类:四个关键判定信号
并不是所有包含两个以上字段的结构都需要手写一个完整的类。判断是否需要从内置类型升级为自定义类,可以观察以下四个典型信号:
1. 数据伴随强业务不变量(Invariants)
如果某个字段的取值受到严格限制(例如:金额必须大于0、折扣必须在0到1之间、结束时间必须晚于开始时间),或者多个字段之间存在互斥依赖。在字典中,没有任何机制能阻止外部代码直接修改字典内容导致非法状态;而手写类可以通过属性描述符(Property)在设值时统一拦截并抛出语义清晰的异常。
2. 状态与行为高频捆绑
当你在代码库中频繁看到形如 calculate_discount(order_dict)、validate_order(order_dict)、mark_as_shipped(order_dict) 这类以同一个字典作为首个参数的独立函数时,这就是典型的“特性依恋(Feature Envy)”。此时应将函数内化为类的方法,直接操作自身内部状态。
3. 数据作为公共契约在多层模块间流动
如果某个数据仅在单个函数内部临时使用,字典或元组完全足够。但如果该数据结构需要跨越控制器层、服务层、持久层等多个边界,手写类或类型完备的类能提供清晰的IDE自动补全、类型提示(Type Hinting)和重构支持,避免重构字段名时只能全局字符串搜索。
4. 需要模拟或扩展特定的Python协议(Dunder Methods)
如果你的数据集合具有特定数学概念或访问语义(例如像队列一样弹出元素、支持 len()、支持 item in obj 成员判断、支持切片取值或算术重载 +、*),只有手写类并实现相应的双下划线特殊方法(Dunder Methods)才能让对象自然地融入Python惯用语法体系中。
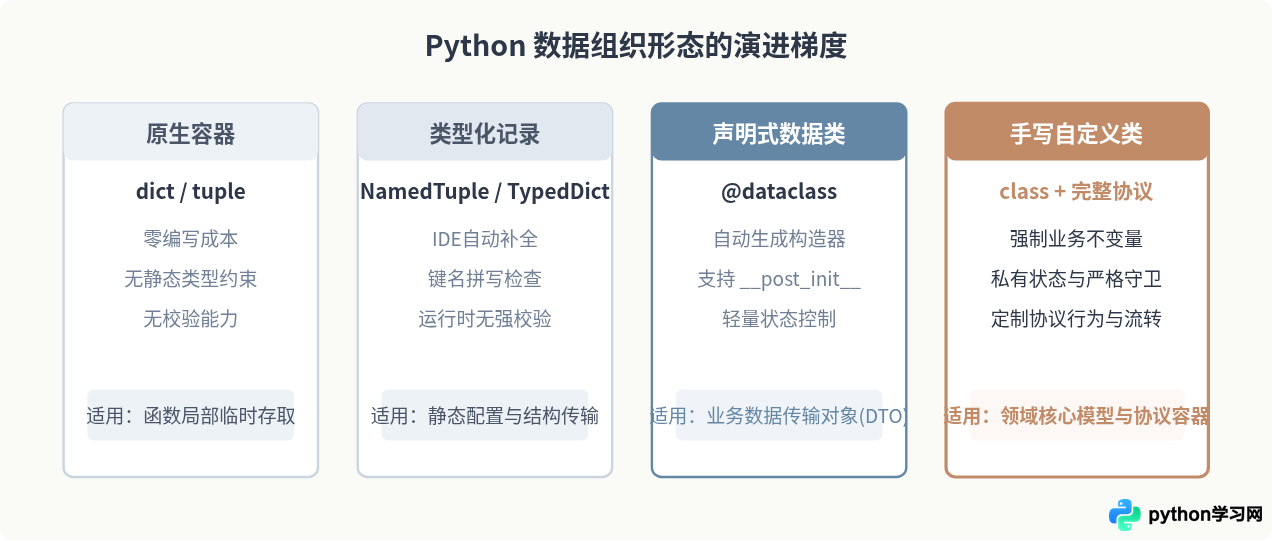
三、实操示范:重构裸字典为自防护领域对象
为了更直观地理解何时以及如何手写类,我们来看一个典型的“购物车项目”场景。
1. 重构前:字典模式下的隐患代码
使用字典时,逻辑往往以外部独立函数的方式存在,调用方容易绕过规则制造脏数据:
# 散装字典模式:无防御、无类型提示
def calculate_subtotal(item_dict):
    # 拼写错误或缺失单价直接导致 KeyError 或算错
    return item_dict["quantity"] * item_dict["unit_price"]

# 外部代码可以随意创建不合法的状态
item = {"title": "机械键盘", "quantity": -2, "unit_price": 499.0}
print(calculate_subtotal(item))  # 输出 -998.0,非法数据悄然穿透系统
2. 重构后:自防护的手写类实现
通过手写类封装属性、引入 @property 保护机制并内化计算逻辑:
class CartItem:
    """具备完整业务不变量与自计算能力的购物车条目"""

    def __init__(self, title: str, quantity: int, unit_price: float):
        self.title = str(title).strip()
        if not self.title:
            raise ValueError("商品名称不能为空")

        self.unit_price = float(unit_price)
        self.quantity = quantity  # 调用 property setter 进行校验

    @property
    def quantity(self) -> int:
        return self._quantity

    @quantity.setter
    def quantity(self, value: int):
        val = int(value)
        if val <= 0:
            raise ValueError(f"商品数量必须为正整数,当前输入: {value}")
        self._quantity = val

    @property
    def total_price(self) -> float:
        """派生计算属性:自动保证与单价及数量同步"""
        return round(self._quantity * self.unit_price, 2)

    def apply_discount(self, rate: float):
        """领域行为:修改状态必须遵循受控流程"""
        if not (0.0 < rate <= 1.0):
            raise ValueError("折扣率必须在 (0, 1] 区间内")
        self.unit_price = round(self.unit_price * rate, 2)

    def __repr__(self) -> str:
        return f"CartItem(title={self.title!r}, qty={self._quantity}, price={self.unit_price})"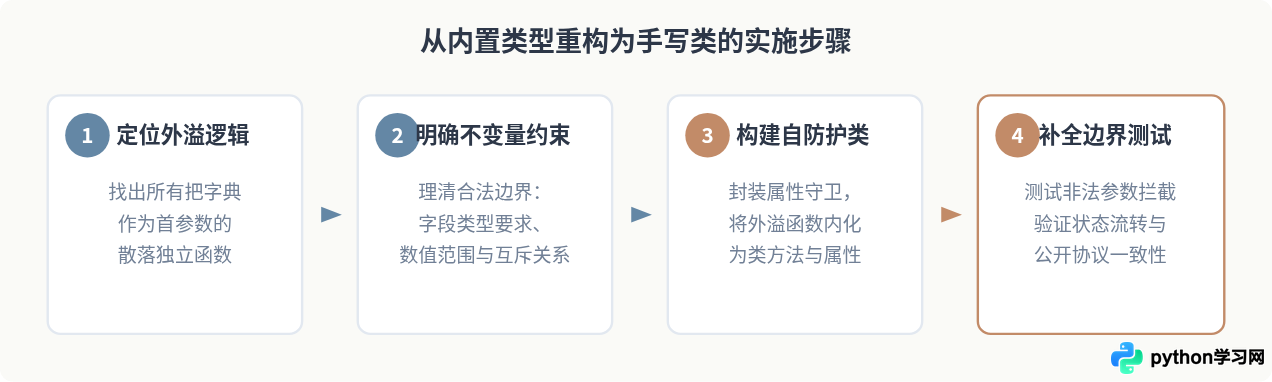
四、性能与内存成本:手写类的代价与优化手段
选择手写类并不是没有代价的。在做出决策前,必须清醒地认识到两者的底层机制差异:
| 评估维度 | Python 内置类型 (dict / tuple) | 普通手写自定义类 | 带 __slots__ 优化的类 |
|---|---|---|---|
| 实例化与访问性能 | 极快(C层原生实现) | 较快(需通过描述符和属性查找) | 快(直接指针偏移定位) |
| 单对象内存占用 | 较小(tuple最省,dict有哈希表开销) | 较大(默认每个实例维护一个 __dict__) |
极小(消除 __dict__,可节省 40%~60% 内存) |
| 约束能力 | 弱(无内建校验) | 强(全生命周期受控) | 强(同时限制动态添加额外属性) |
| 维护重构成本 | 高(重命名键名风险高) | 低(IDE与静态分析全覆盖) | 低 |
如果系统需要同时在内存中常驻百万级别的简单对象(例如网络节点图、时序数据点),普通类的 __dict__ 开销会显著消耗内存。此时应声明 __slots__,以固定的属性槽位代替动态字典,在保留对象封装优势的同时兼顾极致的内存占用。
五、选型总结与决策指南
在架构设计中,既不应“万物皆字典”编写难于维护的面条代码,也不应“逢数据必建大类”导致过度工程。以下决策流程可以帮助团队快速确立边界:
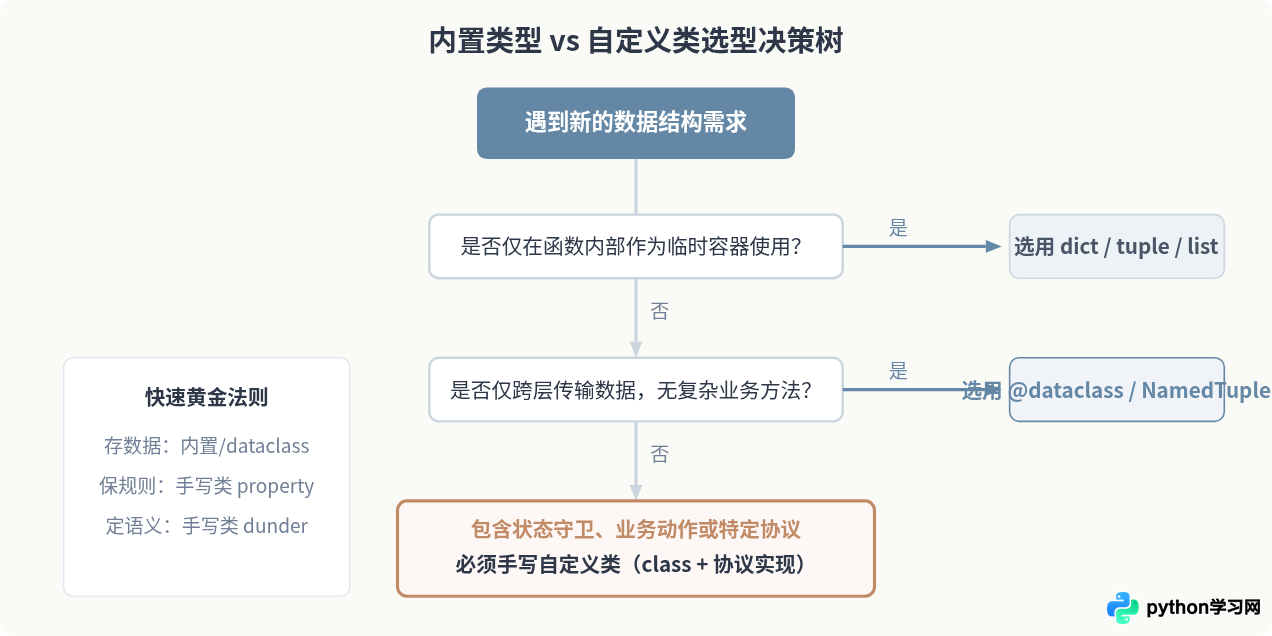
总结而言,内置类型负责效率,自定义类负责秩序。当数据结构超越了“仅仅容纳数据”的角色,开始承担业务不变量、流转规则或协议交互时,及时手写类进行封装,是用少量的先期代码投入换取系统长期稳固性的最佳工程实践。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















