


Python自定义对象和datetime类型怎么序列化为JSON

json.dumps() 序列化 datetime 时间或自定义类实例时,会抛出 TypeError: Object of type ... is not JSON serializable 异常。解决这个问题的核心途径有两个:一是通过 json.dumps() 的 default 参数传入适配转换函数;二是通过继承 json.JSONEncoder 定制全局编码器。本文将通过原理剖析、分步实现与完整代码,彻底解决这两类常见对象的序列化需求。
一、为什么会报错:json 模块的类型边界与拦截机制
JSON(JavaScript Object Notation)是一种纯文本数据交换规范,其数据类型系统仅支持有限的基础标量与复合结构:数值(Number)、字符串(String)、布尔值(Boolean)、空值(null)、数组(Array)以及键值对象(Object)。
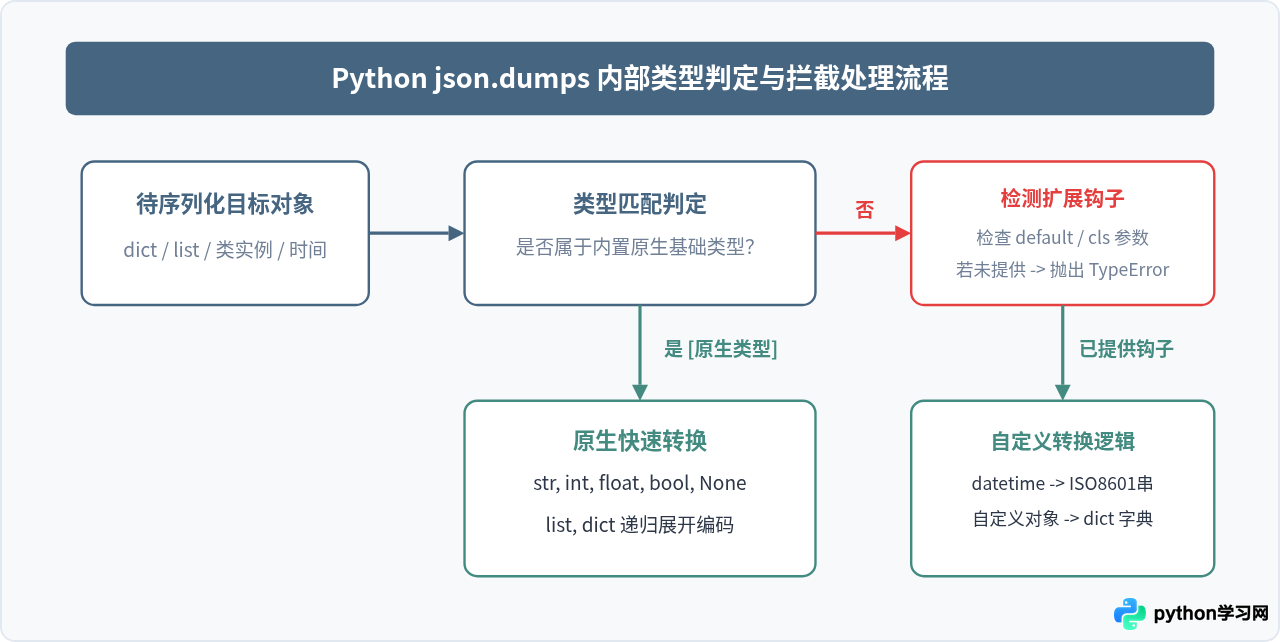
Python 标准库中的 json 模块遵循这一标准,内置的编码表只涵盖了基础内置类型:
dict对应 JSON Objectlist,tuple对应 JSON Arraystr对应 JSON Stringint,float对应 JSON NumberTrue,False对应 JSON true / falseNone对应 JSON null
当 Python 遇到标准映射表中不存在的类型(例如 datetime.datetime 或用户通过 class 定义的实例)时,编码器无法自行决定该将其转换为字符串、字典还是数字,因此直接中止并触发 TypeError。
二、datetime 类型序列化的具体方法
对于时间对象(包括 datetime.datetime、datetime.date 等),通常有统一的标准格式,最常用的规范是 ISO-8601 字符串格式(例如 2026-10-22T02:13:20)或 Unix 时间戳。
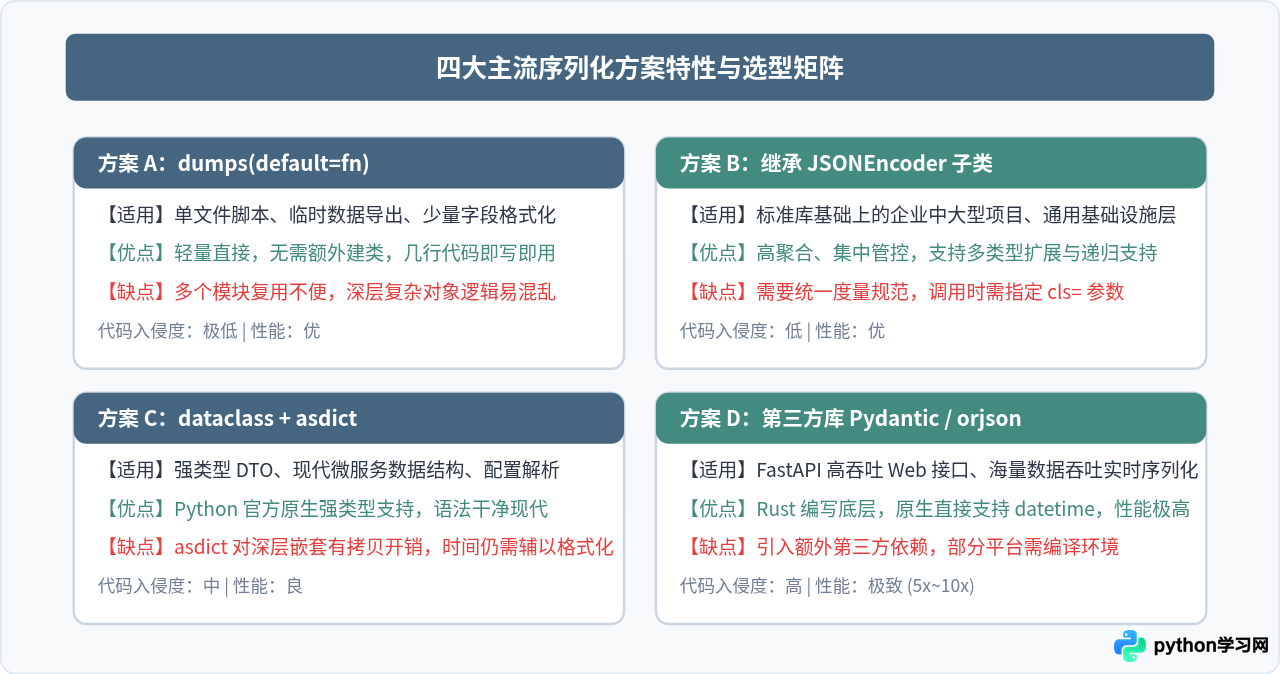
方法 1:使用 default 参数传入快速转换函数
json.dumps() 提供了一个专用的 default 可调用对象参数。当编码器遇到不能识别的对象时,会将该对象传入 default 指定的函数中。我们可以在函数内部对 datetime 调用 .isoformat():
import json
from datetime import datetime, date

def json_date_serializer(obj):
    if isinstance(obj, (datetime, date)):
        return obj.isoformat()
    raise TypeError(f"Object of type {type(obj).__name__} is not JSON serializable")

data = {
    "task_id": 1024,
    "created_at": datetime(2026, 10, 22, 14, 30, 0),
    "deadline": date(2026, 10, 30)
}

result = json.dumps(data, default=json_date_serializer, ensure_ascii=False, indent=2)
print(result)
示例输出:
{
  "task_id": 1024,
  "created_at": "2026-10-22T14:30:00",
  "deadline": "2026-10-30"
}default=str,虽然代码简短且不会报错,但它会将所有未识别对象都强转为字符串(包括没有明确字符串表现形式的类),容易隐藏潜在数据类型错误。因此显式检查 isinstance(obj, (datetime, date)) 更加健壮安全。
三、自定义对象(类实例)序列化为 JSON 的四种策略
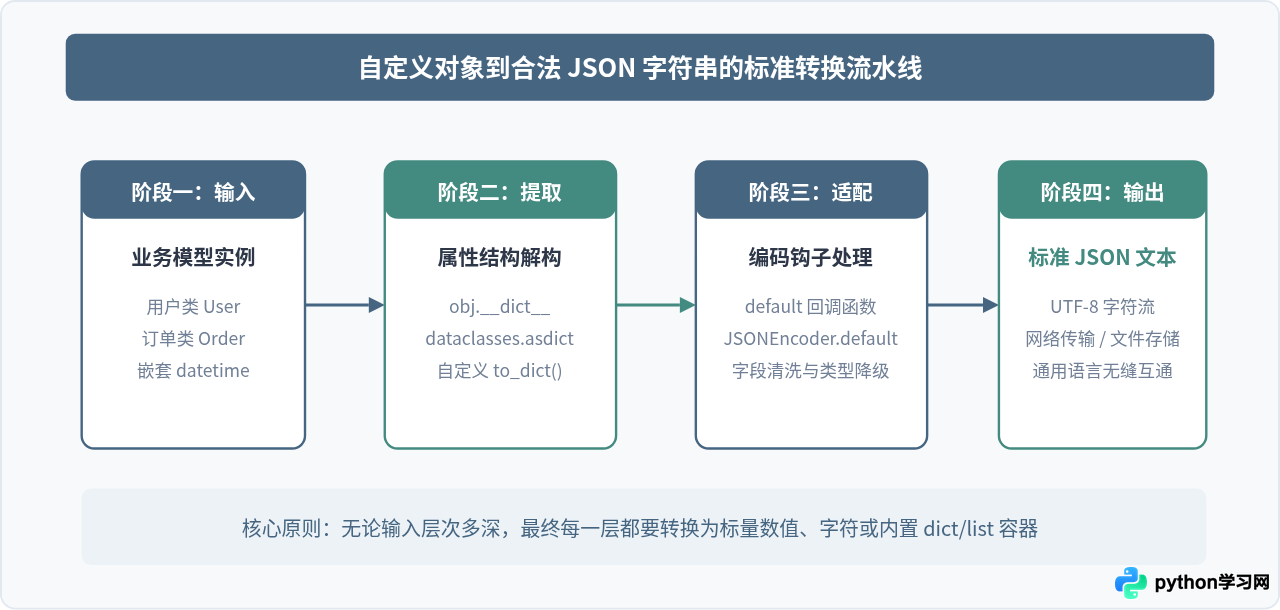
用户自定义的 Python 类实例包含成员属性、方法和状态。由于 JSON 字典与 Python 的 dict 语义完全对应,序列化自定义对象的核心就是将类实例映射为一个由基础数据类型构成的字典。
策略 1:读取实例的 __dict__ 或内置 vars()
Python 类实例的常规属性存储在内部的 __dict__ 字典中。如果对象的字段全都是基础可序列化类型,直接返回 obj.__dict__ 是最快速的做法:
import json

class UserProfile:
    def __init__(self, username, level):
        self.username = username
        self.level = level

user = UserProfile("alex", 5)

# 使用 lambda 或命名函数提取 __dict__
json_str = json.dumps(user, default=lambda o: o.__dict__, ensure_ascii=False)
print(json_str)
# 示例输出: {"username": "alex", "level": 5}
局限性:如果类中定义了带有下划线的私有属性(如 self._internal_cache)、使用了 __slots__,或者属性中含有 datetime,直接使用 __dict__ 会泄露私有数据或依然报错。
策略 2:在类中显式实现 to_dict() 方法(最推荐的业务做法)
在实际项目和领域驱动设计(DDD)中,最稳妥、控制力最强的方式是由类自身掌握序列化输出规则,通过显式定义 to_dict() 方法进行清洗:
import json
from datetime import datetime

class Product:
    def __init__(self, sku, name, price, release_date):
        self.sku = sku
        self.name = name
        self.price = price
        self.release_date = release_date
        self._cache = "内部临时缓存"  # 不需要暴露到 JSON 的私有属性

    def to_dict(self):
        return {
            "sku": self.sku,
            "name": self.name,
            "price": float(self.price),
            "release_date": self.release_date.isoformat() if self.release_date else None
        }

product = Product("P-9901", "机械键盘", 299.0, datetime(2026, 6, 18, 10, 0))

# 序列化钩子识别到有 to_dict 属性即调用
json_str = json.dumps(
    product,
    default=lambda o: o.to_dict() if hasattr(o, "to_dict") else str(o),
    ensure_ascii=False,
    indent=2
)
print(json_str)
策略 3:使用现代 Python dataclasses
在 Python 3.7 及以上版本中,官方推荐使用 @dataclass 声明数据传输对象(DTO)。标准库提供了 dataclasses.asdict() 函数,能够自动递归将数据类转换成纯原生字典:
import json
from dataclasses import dataclass, asdict
from datetime import datetime

@dataclass
class Article:
    title: str
    views: int
    published_at: datetime

article = Article(
    title="Python自定义对象和datetime类型怎么序列化为JSON",
    views=1280,
    published_at=datetime(2026, 10, 22, 2, 0)
)

def dataclass_serializer(obj):
    if isinstance(obj, datetime):
        return obj.isoformat()
    raise TypeError(f"Type {type(obj)} not serializable")

# 先转成基础字典,再对其中的 datetime 触发 default 钩子
json_str = json.dumps(asdict(article), default=dataclass_serializer, ensure_ascii=False, indent=2)
print(json_str)
四、工程化最佳实践:编写通用 JSONEncoder 子类
当项目中同时存在自定义类、datetime、date、uuid.UUID 以及 decimal.Decimal 时,散落在各处的 lambda 钩子难以维护。继承 json.JSONEncoder 并重写 default 方法是组织通用编码器的标准范式。
import json
from datetime import datetime, date
from decimal import Decimal
from uuid import UUID

class ComprehensiveJSONEncoder(json.JSONEncoder):
    """
    通用企业级 JSON 编码器:
    统一处理 datetime、date、Decimal、UUID 以及包含 to_dict/__dict__ 的自定义对象
    """
    def default(self, obj):
        # 1. 处理日期与时间类型
        if isinstance(obj, (datetime, date)):
            return obj.isoformat()

        # 2. 处理高精度高额度财务数字 Decimal
        if isinstance(obj, Decimal):
            return float(obj)

        # 3. 处理唯一标识符 UUID
        if isinstance(obj, UUID):
            return str(obj)

        # 4. 优先调用对象自带的显式序列化契约
        if hasattr(obj, "to_dict") and callable(obj.to_dict):
            return obj.to_dict()

        # 5. 支持普通 Python 对象的 __dict__ 自动映射(过滤以 _ 开头的私有属性)
        if hasattr(obj, "__dict__"):
            return {k: v for k, v in obj.__dict__.items() if not k.startswith("_")}

        # 6. 未知类型交由基类处理,标准基类会统一抛出规范的 TypeError 异常
        return super().default(obj)
使用该编码器时,只需在 json.dumps() 中通过 cls=ComprehensiveJSONEncoder 传递即可,对复杂嵌套结构(例如在字典、列表中嵌入对象和时间)天然支持递归解析:
# 完整执行测试
class OrderItem:
    def __init__(self, item_name, quantity):
        self.item_name = item_name
        self.quantity = quantity

class Order:
    def __init__(self, order_id, created_at, items):
        self.order_id = order_id
        self.created_at = created_at
        self.items = items
        self._checksum = "8f9a2b"  # 私有字段会被自动过滤

order = Order(
    order_id="ORD-2026-8888",
    created_at=datetime.now(),
    items=[OrderItem("高性能机械键盘", 1), OrderItem("无线降噪鼠标", 2)]
)

output_json = json.dumps(order, cls=ComprehensiveJSONEncoder, ensure_ascii=False, indent=2)
print(output_json)
运行结果(示例):
{
  "order_id": "ORD-2026-8888",
  "created_at": "2026-10-22T02:13:20.123456",
  "items": [
    {
      "item_name": "高性能机械键盘",
      "quantity": 1
    },
    {
      "item_name": "无线降噪鼠标",
      "quantity": 2
    }
  ]
}
五、高吞吐场景:现代高性能解决方案拓展
在追求极致吞吐量的后端 API 或批处理服务中,标准库 json 的纯 Python 反射调用可能会成为 CPU 密集型任务的瓶颈。对于这类场景,业内广泛采用以下两种解决方案:
1. Pydantic(现代 Python API 事实标准)
在 FastAPI 等现代框架中,模型继承自 pydantic.BaseModel,框架内置了对 datetime、UUID 及嵌套模型的自动化校验与序列化支持:
from datetime import datetime
from pydantic import BaseModel

class UserPayload(BaseModel):
    user_id: int
    nickname: str
    registered_at: datetime

user = UserPayload(user_id=101, nickname="Kimi", registered_at=datetime.now())

# Pydantic v2 直接输出符合标准的 JSON 字符串
json_string = user.model_dump_json()
print(json_string)
2. orjson(Rust 驱动的超快序列化库)
orjson 是目前 Python 生态中速度最快的 JSON 处理库之一。它原生支持 datetime、date、UUID 以及 dataclass,不需要编写任何 default 转换函数即可直接将 datetime 序列化为规范的 ISO-8601 字符串:
# pip install orjson
import orjson
from datetime import datetime

payload = {
    "title": "性能测试",
    "timestamp": datetime.now()
}

# 输出 bytes 类型,如需字符串可 .decode("utf-8")
byte_result = orjson.dumps(payload)
print(byte_result.decode("utf-8"))
六、避坑要点与知识总结
在将时间与对象转换为 JSON 时,开发者常常在时区、循环引用以及反向反序列化上踩坑。以下是必须注意的几个关键细节:
- 时区感知(Timezone-Aware)与朴素时间(Naive):建议所有写入 JSON 的
datetime均包含明确时区(如datetime.timezone.utc)。不带时区的时间在分布式系统中会导致时间偏差歧义。 - 循环引用陷阱:如果自定义对象存在互相引用(例如
Parent.children且Child.parent),单纯递归调用__dict__会引发RecursionError: maximum recursion depth exceeded,必须在转换时剔除反向引用或维护已访问 ID 集合。 - 反序列化(loads)逆向还原:
json.loads()输出的结果只包含纯字符串与字典。如果需要还原为datetime或类对象,需要使用object_hook参数定义逆向还原函数。
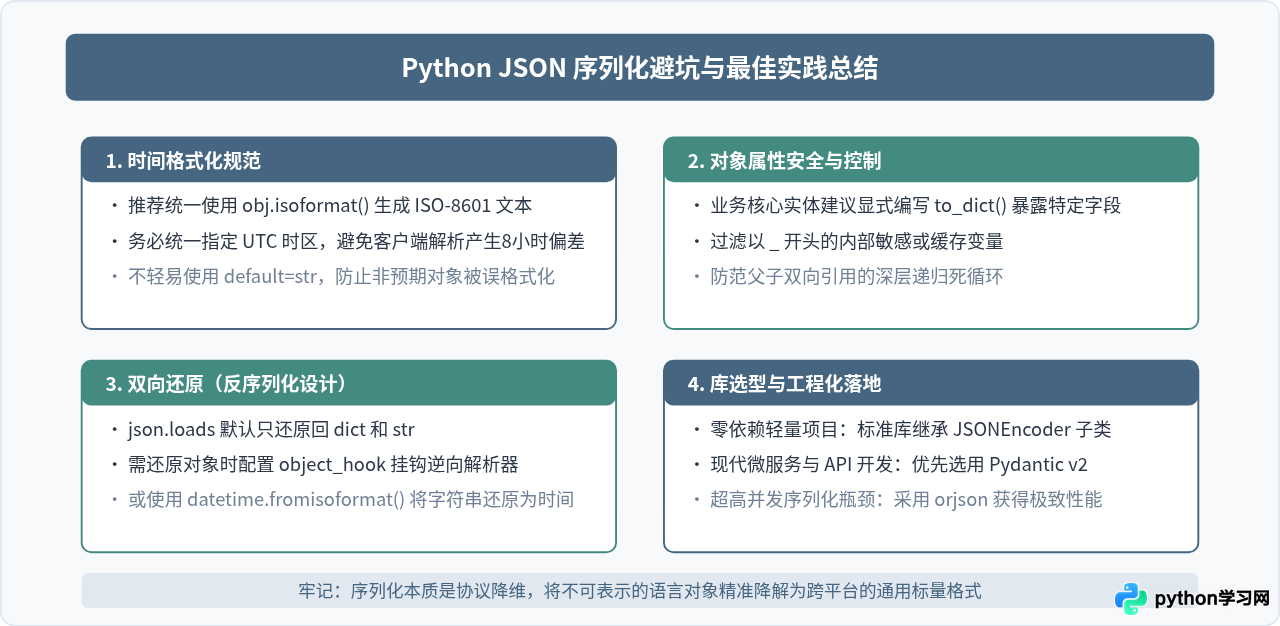
通过理解标准库 json 的扩展机制,根据实际工程规模在 default 参数、JSONEncoder 子类或 Pydantic 之间做出合适选择,便能彻底解决 Python 对象与时间序列化过程中的各类报错,构建出健壮高效的数据交换链路。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















