


Python常用内置函数速查与基础用法示例

Python 的内置函数(Built-in Functions)是解释器启动时便自动加载的核心工具集,开发者无需执行任何 import 语句即可直接调用。这些函数不仅涵盖了从类型转换、数学计算到序列迭代与对象内省等核心功能,其底层多由 C 语言直接实现,运行性能高效。本文系统梳理 Python 常用内置函数的分类体系、核心机制与具体代码示例,帮助开发者快速掌握并在实际开发中准确运用。
一、内置函数分类全景与功能速查
Python 解释器当前提供了近 70 个内置函数。在日常编程中,高频使用的函数通常可以归纳为五大核心类别:类型转换、数学聚合、序列迭代、逻辑判定以及内省环境。理解各分类的设计职责,有助于在面临具体编码任务时迅速匹配出最适合的原生函数。
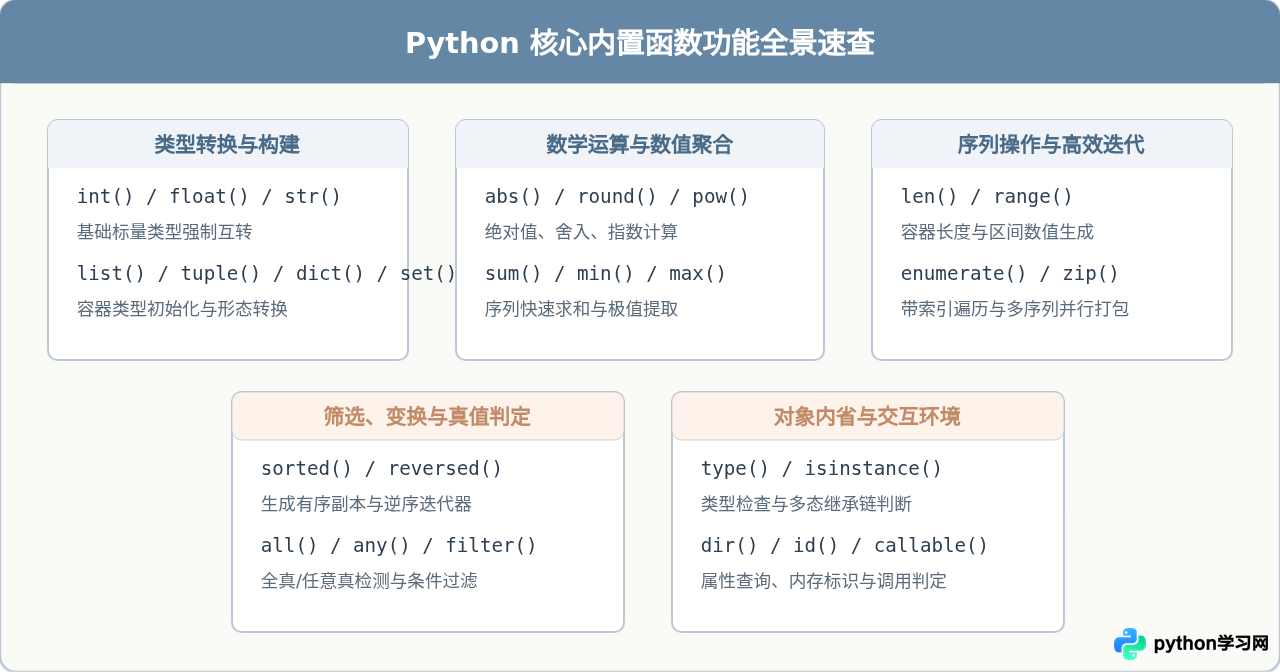
| 函数名 | 主要用途 | 返回值类型 | 使用场景提示 |
|---|---|---|---|
len(s) |
获取序列或映射的元素个数 | int |
适用于 str, list, dict 等具有 __len__ 的对象 |
range(stop) |
生成不可变的等差数字序列 | range 对象 |
用于 for 循环计数,具有惰性求值特性,节省内存 |
enumerate(iterable) |
配对生成索引与元素元组 | enumerate 迭代器 |
避免使用 range(len(...)) 计数遍历 |
zip(*iterables) |
将多个可迭代对象的同位置元素打包 | zip 迭代器 |
多列表并行循环或合成字典 |
sorted(iterable) |
构建升序或指定规则排序的新列表 | list |
原对象不变,支持 key 排序规则与 reverse 参数 |
isinstance(obj, classinfo) |
检测对象是否为指定类或其子类的实例 | bool |
支持元组多类型匹配,比 type() 更符合面向对象规范 |
all(iterable) / any() |
判断可迭代对象中元素的布尔值状态 | bool |
内置短路求值逻辑,处理批量状态校验效率高 |
二、核心内置函数的具体场景与代码示例
1. 序列迭代与组合:enumerate() 与 zip()
在处理列表或其他序列时,同时追踪序号或同步处理多个列表是常见需求。直接使用下标访问不仅语法冗长,还容易引发索引越界异常。enumerate() 与 zip() 提供了优雅且高效的原生解法。
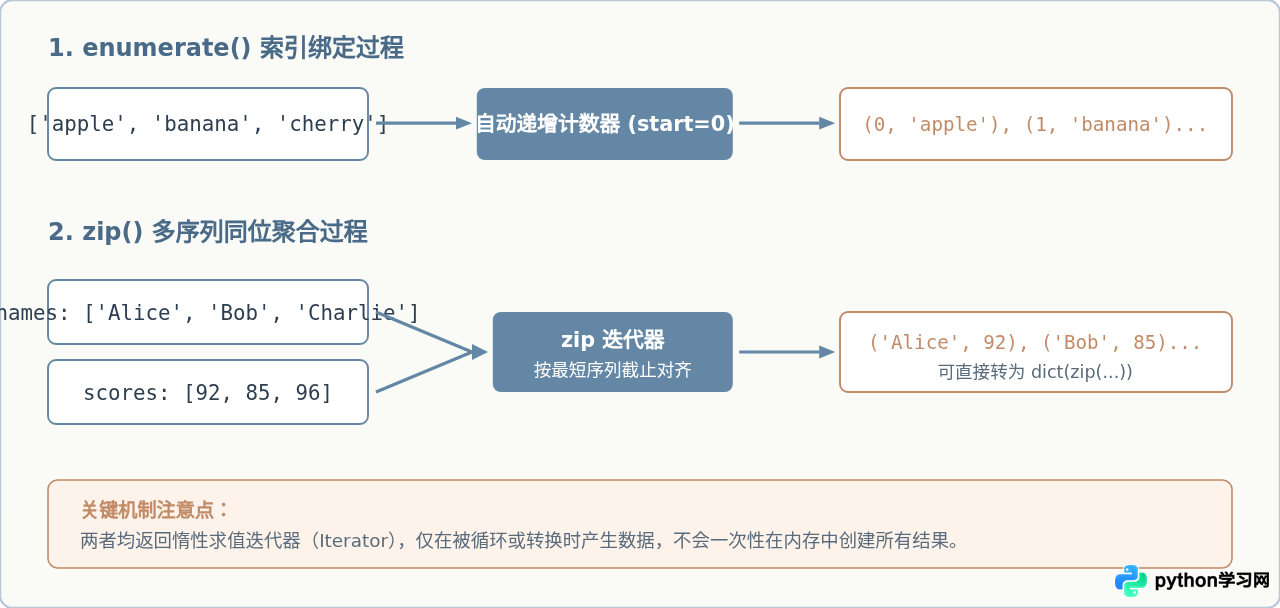
下面是日常开发中 enumerate() 与 zip() 的典型代码示例:
# 示例 1: enumerate() 指定起始序号
users = ["张三", "李四", "王五"]
for rank, name in enumerate(users, start=1):
    print(f"第 {rank} 名: {name}")

# 示例 2: zip() 配对两个长度一致的列表并快速组装字典
keys = ["host", "port", "database"]
values = ["127.0.0.1", 3306, "production_db"]

config_dict = dict(zip(keys, values))
print(config_dict)
# 示例输出: {'host': '127.0.0.1', 'port': 3306, 'database': 'production_db'}

# 示例 3: Python 3.10+ 中严格长度校验
try:
    pairs = list(zip([1, 2], ["a", "b", "c"], strict=True))
except ValueError as err:
    print(f"长度不匹配触发异常: {err}")
2. 排序与定制规则:sorted()
sorted() 能够接收任何可迭代对象(列表、元组、字典键、生成器等),并始终返回一个全新的已排序 list。它通过 key 参数支持传入单参数函数实现自定义权重排序,利用 reverse=True 支持降序输出。
# 示例:根据字典特定字段及绝对值自定义排序
records = [
    {"product": "A", "price": 120, "sales": 40},
    {"product": "B", "price": 85,  "sales": 150},
    {"product": "C", "price": 230, "sales": 15}
]

# 按销售量降序排列
sorted_by_sales = sorted(records, key=lambda item: item["sales"], reverse=True)
print("最高销量:", sorted_by_sales[0]["product"])
# 示例输出: 最高销量: B

# 混合正负数的绝对值升序排序
temperatures = [-5, 12, -2, 28, 0, -18]
sorted_temps = sorted(temperatures, key=abs)
print("按偏离零度排序:", sorted_temps)
# 示例输出: 按偏离零度排序: [0, -2, -5, 12, -18, 28]
3. 状态检测与短路求值:all() 与 any()
当需要验证容器中的元素是否全部满足条件或是否存在至少一个满足条件时,all() 与 any() 能够结合生成器表达式构成高效的布尔判断逻辑。两者均具备短路求值(Short-circuit evaluation)特性,遇到首个决定结果的元素时即刻停止后续迭代。
# 示例 1: 检查表单输入是否全部有效
user_inputs = ["admin", "secret_pass", "admin@example.com"]
is_valid_form = all(len(field.strip()) > 0 for field in user_inputs)
print("表单是否完整:", is_valid_form) # 示例输出: True

# 示例 2: 检查文件列表中是否包含指定格式的文件
filenames = ["report.pdf", "data.csv", "summary.docx"]
has_excel = any(fname.endswith((".xls", ".xlsx")) for fname in filenames)
print("是否存在表格文件:", has_excel) # 示例输出: False短路求值提示:对于空集合,all([]) 返回 True(因为没有反例),而 any([]) 返回 False(因为没有满足条件的实例)。在编写前置防御代码时需特别注意该边界表现。
4. 类型安全校验:isinstance() vs type()
在进行类型防御与参数合法性检查时,建议始终使用 isinstance() 而非 type() == ...。isinstance() 会遵循面向对象的继承层级,如果待检查对象是目标类的子类实例,同样判定为真;同时它支持传入元组进行多类型容错匹配。
class Animal:
    pass

class Dog(Animal):
    pass

my_pet = Dog()

# 使用 type() 进行精确比对
print(type(my_pet) is Dog)    # 输出: True
print(type(my_pet) is Animal) # 输出: False (无法识别继承关系)

# 使用 isinstance() 进行兼容性判断 (推荐做法)
print(isinstance(my_pet, Animal)) # 输出: True (正确识别继承)

# 支持元组多类型联合检测
data = (1, 2, 3)
if isinstance(data, (list, tuple, set)):
    print(f"容器包含 {len(data)} 个元素")
三、核心机制差异与常见认知误区
初学者在运用内置函数时,常因忽略其设计机制而引发逻辑缺陷或性能损耗。最突出的认知误区集中在原地修改与返回新对象、迭代器消耗性以及内置标识符覆盖等方面。
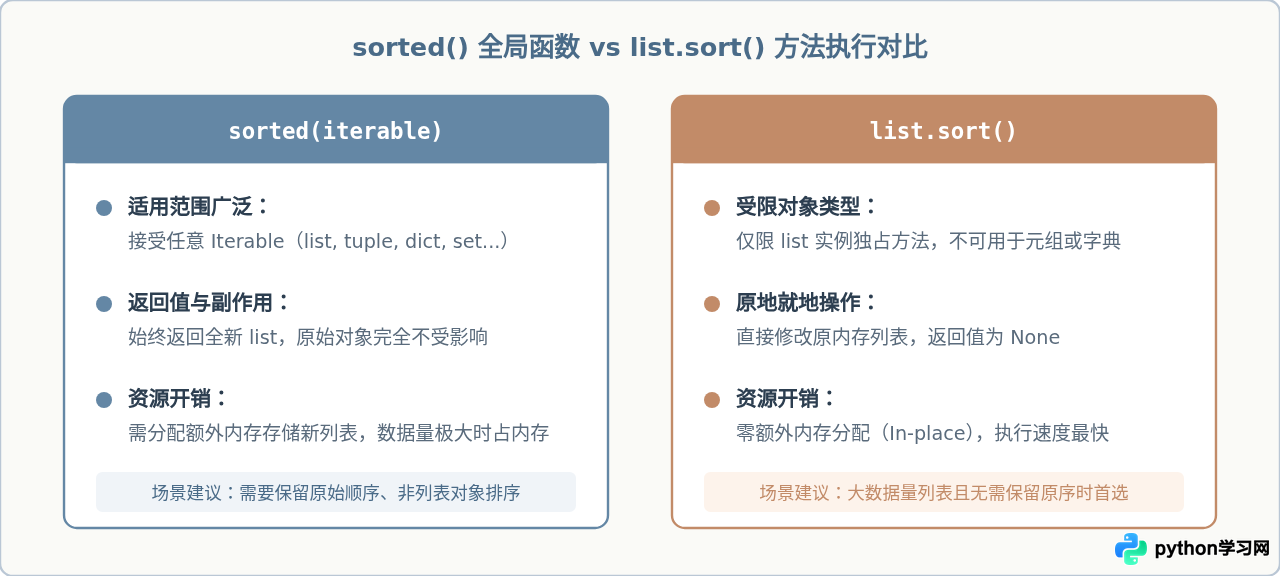
1. sorted() 与 list.sort() 的选型对比
许多开发者容易混淆 sorted() 函数与列表自带的 .sort() 方法。核心区别在于:sorted() 适用于任意可迭代对象并产生新列表,原数据保持只读;而 .sort() 仅能在列表对象上调用,直接修改原列表且返回 None。
2. 迭代器的一次性消耗特性
诸如 zip(), enumerate(), reversed(), filter() 和 map() 返回的都是迭代器对象,它们通过惰性计算来节省内存。这意味着其内部指针一旦遍历到底,对象便已消耗殆尽(exhausted),再次遍历将不会产出任何数据:
# 陷阱示例:多次遍历同一个 zip 迭代器
num_list = [1, 2, 3]
str_list = ["a", "b", "c"]

zipped_iter = zip(num_list, str_list)

# 第一次遍历正常输出
print("首轮循环:", list(zipped_iter)) # 输出: [(1, 'a'), (2, 'b'), (3, 'c')]

# 第二次遍历已无元素
print("次轮循环:", list(zipped_iter)) # 输出: [] (已耗尽,无任何数据输出)防范方法:如果需要多次重用打包结果,应显式将其转换为静态容器(如 pairs = list(zip(...))),避免隐性逻辑漏洞。
3. 变量名覆盖内置函数名
在 Python 的作用域查找链(LEGB 原则:Local > Enclosing > Global > Built-in)中,内置函数处于最底层。如果不慎将自定义变量命名为 list, dict, str, min, max 或 sum,本地作用域会覆盖对应的内置功能,导致后续正常调用崩溃:
# 危险示例:覆盖内置函数
sum = 100  # 本地定义了名为 sum 的整型变量

# 下方调用将抛出 TypeError: 'int' object is not callable
try:
    total = sum([10, 20, 30])
except TypeError as err:
    print(f"调用失败: {err}")

# 修复方案:删除局部变量引用,恢复内置函数访问
del sum
total = sum([10, 20, 30])
print("恢复正常求和:", total) # 示例输出: 60
四、内置函数选型决策与实践建议
编写高质量 Python 代码的核心准则之一是避免“重新发明轮子”。当面对数据加工、状态校验和类型排查时,可以通过以下决策路径快速选择对应的内置函数:
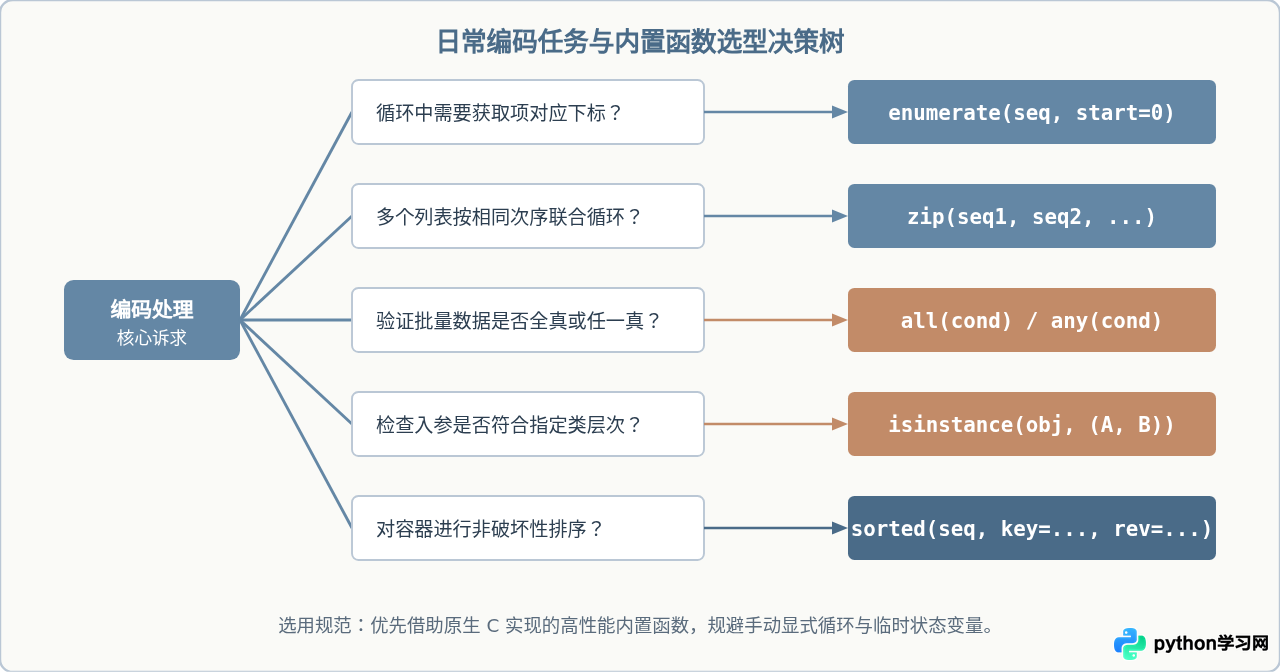
熟练运用 Python 的常用内置函数,是写出地道、简洁且高性能代码的基础。在实际工程实践中:
- 使用
enumerate()与zip()代替基于下标的循环逻辑,降低逻辑复杂度并消除越界隐患; - 使用
isinstance()代替type(),保障继承体系下的多态安全性; - 分清
sorted()与list.sort()的应用场景,在“数据不可变性”与“极端内存效率”之间做出恰当权衡; - 时刻关注变量命名,避免覆盖核心内置标识符;留意迭代器的一次性消耗特性,在多次复用时主动转为静态集合。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















