


Python sorted、enumerate和zip内置函数参数深度解析
深度解析Python三大常用内置函数sorted、enumerate和zip的形参规则、底层工作原理、求值时序及工程协同实践。
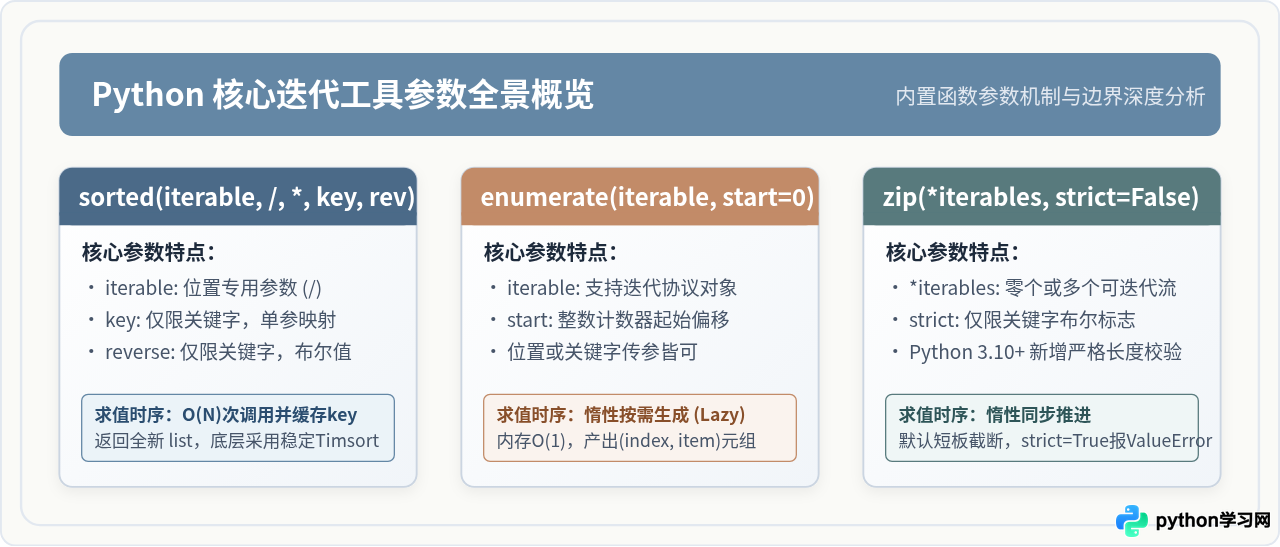
sorted()、enumerate() 与 zip() 是 Python 核心内置函数中处理序列与迭代流最基础也最高频的工具。许多开发者熟悉其最简用法,但在面对位置专用参数(/)、仅限关键字参数(*)、key 映射的评估时序与缓存机制、迭代器状态消费以及 Python 3.10 引入的 strict 边界防御时,往往容易产生偏差。本文直接聚焦这三个函数的完整形参定义、参数底层约束、内存求值表现以及在工程中的组合范式。
一、sorted() 函数参数体系与 Timsort 机制深度剖析
在 Python 官方规范中,sorted() 的完整函数签名定义如下:
sorted(iterable, /, *, key=None, reverse=False) -> list
签名中包含两个 Python 特殊形参标记:斜杠 / 与星号 *。这两个符号直接决定了调用方传参的语法合法性。
1.1 形参约束:位置专用参数(/)与仅限关键字参数(*)
形参 iterable 位于斜杠 / 之前,属于位置专用参数(Positional-Only Parameter)。这意味着调用者绝对不能以关键字形式传递此参数:
data = [5, 2, 8, 1]

# 正确调用:以位置传递
sorted_data = sorted(data)

# 错误调用:尝试显式使用形参名传参将直接引发 TypeError
# sorted(iterable=data)
# 抛出异常: TypeError: sorted() takes no keyword arguments
为什么 CPython 核心开发组要将 iterable 设为位置专用?主要原因有两个:其一是消除外部代码对内置 C 函数底层参数名称的耦合,保证底层实现自由重构;其二是在 CPython 虚拟机调用层面(METH_FASTCALL),位置专用传参省去了构建与解析关键字参数字典(kwargs dict)的开销,提升基础操作的执行速度。
与此相对,key 和 reverse 位于独立星号 * 之后,属于仅限关键字参数(Keyword-Only Parameters)。你不能通过位置将其传给函数,例如 sorted(data, lambda x: x[1]) 会触发语法或类型错误,必须明确书写形参名称 key=...。
1.2 key 参数的 DSU 机制与单次求值保证
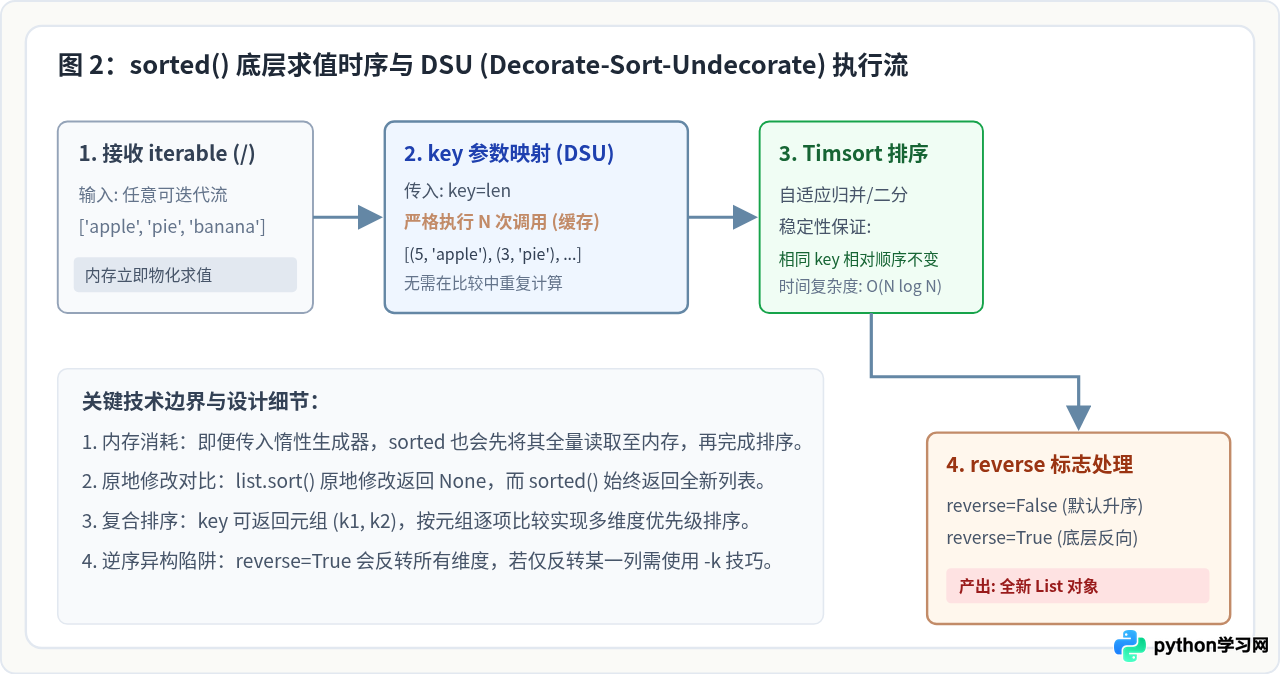
key 参数接收一个可调用对象(函数、lambda 表达式或方法)。对于输入序列中的每一个元素,key 函数负责提取一个用于大小比较的代理键(Proxy Key)。
理解 key 参数的核心是 DSU 机制(Decorate-Sort-Undecorate,装饰-排序-去装饰)。在比较排序过程中,两个元素之间可能会发生多次比较(平均 $O(N \log N)$ 次)。如果每次比较时都重复调用 key 函数,昂贵的计算开销将不可接受。CPython 的底层实现保证:对输入序列中的每个元素,$key$ 函数严格只执行一次(严格 $O(N)$ 次调用)。
底层具体步骤如下:
- 装饰阶段(Decorate):遍历输入的
iterable,对每个元素 $x$ 执行 $k = key(x)$,在 C 层构造由(k, x)组成的临时数组。 - 排序阶段(Sort):底层 Timsort(Python 3.11+ 优化为 Powersort)完全仅基于提取出的键 $k$ 进行大小比较与重排。
- 去装饰阶段(Undecorate):提取排序后结构中的原始元素 $x$,组装成全新的 Python
list返回。
1.3 reverse 参数与多字段复合排序实践
当需要依据多个字段排序时,最稳健的做法是让 key 函数返回一个元组。Python 比较元组时会从左到右依次比较,当前一位置相等时再比较下一项。
students = [
    {"name": "Alice", "grade": 2, "score": 95},
    {"name": "Bob", "grade": 1, "score": 90},
    {"name": "Charlie", "grade": 2, "score": 88},
    {"name": "David", "grade": 1, "score": 95},
]

# 需求:先按年级升序,相同年级按成绩降序
# 技巧:数值字段取负值 (-item['score']) 配合默认升序,即可避免 reverse=True 全局反转
result = sorted(
    students,
    key=lambda s: (s["grade"], -s["score"])
)

# 示例输出:
# [{'name': 'David', 'grade': 1, 'score': 95},
#  {'name': 'Bob', 'grade': 1, 'score': 90},
#  {'name': 'Alice', 'grade': 2, 'score': 95},
#  {'name': 'Charlie', 'grade': 2, 'score': 88}]
如果某个需要降序排序的字段不是数值(例如字符串),无法直接通过加负号 -s 取反。此时可利用 Timsort 的排序稳定性(Stable Sort):进行两次 sorted,先对次要键按降序排序,再对主要键按升序排序。
二、enumerate() 函数参数与惰性步进解析
enumerate() 函数主要用于在遍历序列时自动生成连续序号。其函数签名如下:
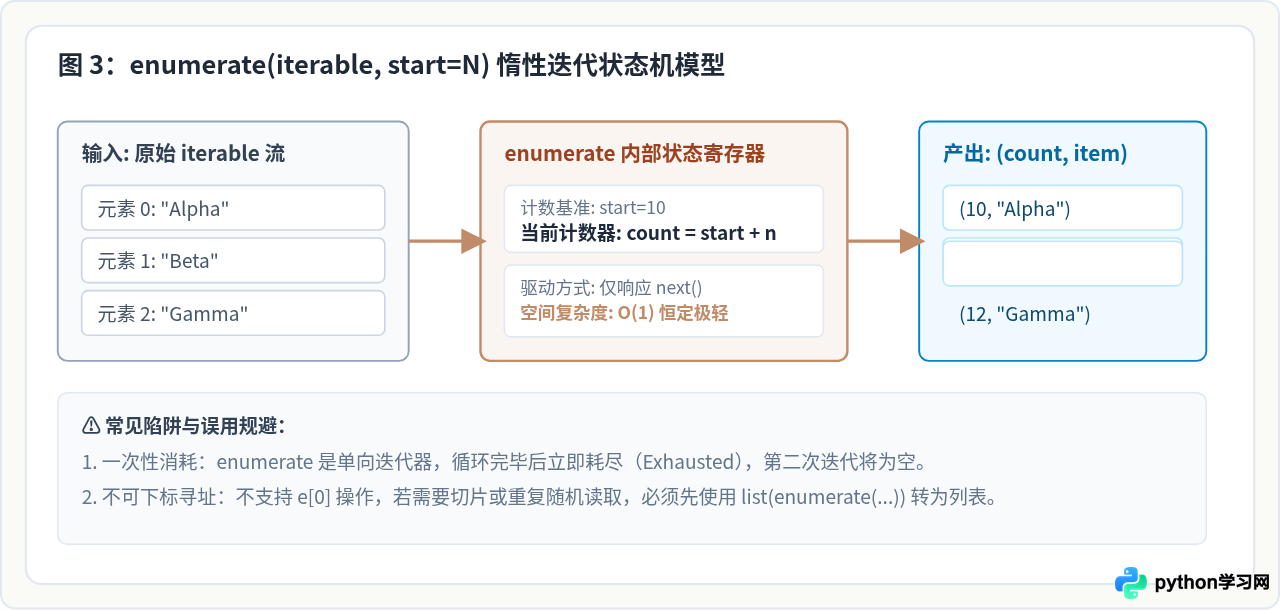
enumerate(iterable, start=0) -> enumerate object2.1 形参解析与传参规则
- iterable:任意实现了迭代协议(即具备
__iter__()或__getitem__()方法)的对象。无需支持下标索引或具备固定长度。 - start:计数器的起始整数,默认为
0。该参数既可以通过位置传递(例如enumerate(seq, 1)),也可以通过关键字传递(例如enumerate(seq, start=1))。
tasks = ["设计架构", "编写代码", "运行测试"]

# start 参数支持任意整数,包括正整数与负整数
for idx, task in enumerate(tasks, start=1):
    print(f"步骤 {idx}: {task}")

# 示例输出:
# 步骤 1: 设计架构
# 步骤 2: 编写代码
# 步骤 3: 运行测试
2.2 enumerate 的运行时机制与性能优势
很多初学者习惯使用 for i in range(len(data)): item = data[i] 的方式获取索引。相比之下,enumerate() 具备两大核心优势:
- 避免下标索引查找开销:对于列表,
data[i]会在底层经历边界校验(Bounds Checking)与指针解引用;对于非序列的生成器或链式迭代器,甚至根本无法通过索引访问。enumerate()仅通过next()单向拉取数据,速度更快。 - 常量级内存占用($O(1)$ Space Complexity):
enumerate()返回的是一个专用的enumerate迭代器对象,它不会一次性生成所有序号列表,而是在每一次调用__next__()时将当前内部整数计数器递增并与元素组装为元组返回。
三、zip() 函数参数与 strict 边界防御深度剖析
zip() 函数负责将多个可迭代对象的对应元素打包成一个个元组。在 Python 3.10 之前与之后,其形参发生了关键升级:
zip(*iterables, strict=False) -> zip object3.1 *iterables 动态变长参数的特性
开头的 *iterables 意味着 zip 能够接受 0 个、1 个或任意多个可迭代对象:
- 零参数:
zip()返回一个空的 zip 迭代器,第一次调用next()即抛出StopIteration。 - 单参数:
zip([1, 2, 3])产生形如(1,), (2,), (3,)的一元元组序列。 - 矩阵转置习语:利用解包操作符
*,zip(*matrix)可以一行代码优雅地实现二维矩阵行列对调。
3.2 strict 参数:Python 3.10 带来的工程防御变革
在 Python 3.10 之前,zip() 拥有一个历史上极其隐蔽的特性——以最短的序列为准截断(Shortest Truncation)。当传入的多个可迭代对象长度不一致时,只要最短的一个耗尽,zip() 就会静默停止,剩余序列中多出的数据被无声抛弃:
headers = ["id", "username", "email"]
values = [101, "admin"]  # 缺失了 email 数据

# Python 3.10 之前:静默截断,隐藏数据丢失 Bug
record = dict(zip(headers, values))
# 结果: {'id': 101, 'username': 'admin'} —— 'email' 被无提示忽略!
为了从根本上杜绝因数据长度不一致导致的静默 Bug,Python 3.10 在 PEP 618 中引入了仅限关键字形参 strict=False。
- strict=False(默认):维持向后兼容的传统行为,遇到任意序列耗尽立即停止。
- strict=True:启用强一致性校验。当且仅当所有传入的迭代器长度完全相同时正常执行;若某个迭代器已结束而另一个仍有元素,立即抛出
ValueError。
try:
    for h, v in zip(headers, values, strict=True):
        print(h, v)
except ValueError as e:
    print(f"捕捉到长度不一致校验失败: {e}")
    # 示例输出: 捕捉到长度不一致校验失败: zip() argument 2 is shorter than argument 1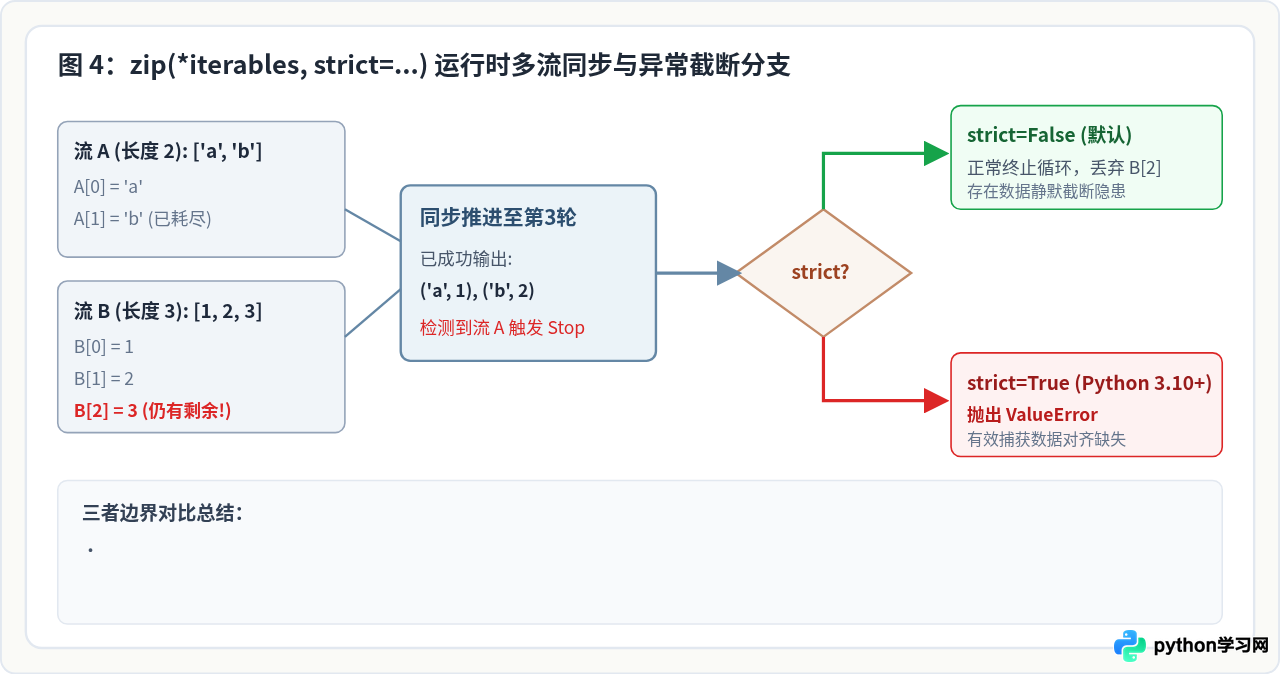
四、三大内置函数工程协同模式与核心边界规避
在真实工程场景中,sorted()、enumerate() 和 zip() 很少孤立存在,往往组合形成极高表达力的简洁数据流管道。
4.1 典型协同范式
-
多序列联动同步排序(zip + sorted):
当存在平行的两个列表(如学生名单与成绩)时,避免用复杂索引更新,直接打包装配排序:names = ["Alice", "Bob", "Charlie"] scores = [85, 95, 78] # 依据成绩降序重排,并同步带出姓名 sorted_pairs = sorted(zip(scores, names, strict=True), reverse=True) # 结果: [(95, 'Bob'), (85, 'Alice'), (78, 'Charlie')] -
原生实现稳定 ArgSort(enumerate + sorted):
在不引入 NumPy 的纯 Python 环境中,获取排序后元素在原始序列中的索引:raw_values = [40, 10, 30, 20] # 排序对象为 (原索引, 值),key 仅基于值比较 indexed_sort = sorted(enumerate(raw_values), key=lambda pair: pair[1]) original_indices = [idx for idx, val in indexed_sort] # 结果: [1, 3, 2, 0](对应原数组值 10, 20, 30, 40 的原始下标) -
结构化数据行报表打印(enumerate + zip):
cols = ["状态", "主机IP"]
data_a = ["Online", "Offline"]
data_b = ["192.168.1.10", "192.168.1.11"]

for row_no, (status, ip) in enumerate(zip(data_a, data_b, strict=True), start=1):
    print(f"#{row_no} - {ip}: {status}")
4.2 核心参数对比表
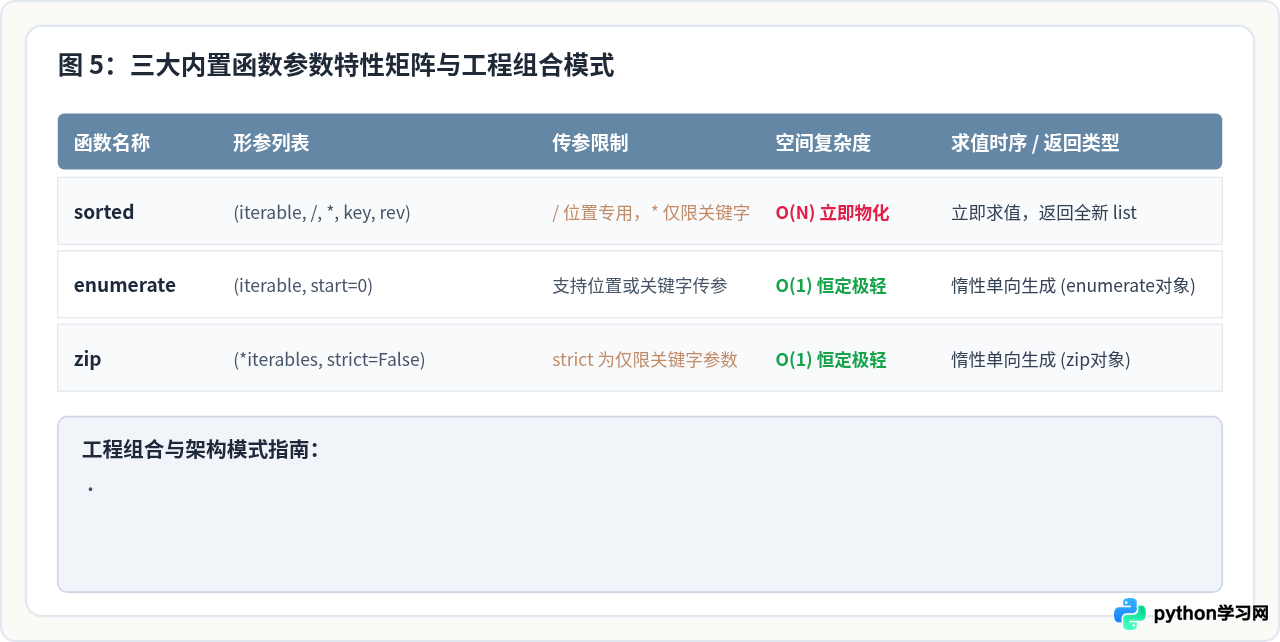
| 函数 | 输入类型支持 | 参数特性与约束 | 返回值及内存影响 | 版本注意事项 |
|---|---|---|---|---|
sorted() |
任意可迭代对象 | iterable 为位置专用;key、reverse 为仅限关键字;key 严格评估 $N$ 次。 |
全新 list;在内存中即时分配容纳全部元素的列表空间。 |
Python 3.11+ 优化为 Powersort 算法,对于部分有序数据速度进一步提升。 |
enumerate() |
任意可迭代对象 | start 指定起始计数,默认为 0,支持位置或关键字传参。 |
enumerate 迭代器;$O(1)$ 内存占用,按需产出 (index, item)。 |
Python 2.3 引入,接口长期高度稳定。 |
zip() |
0 个或多个可迭代对象 | strict 为仅限关键字参数,控制不等长输入时的静默截断或抛出异常。 |
zip 迭代器;$O(1)$ 内存占用,按需产出多元素元组。 |
Python 3.10 新增 strict 参数,是编写高鲁棒性对齐代码的推荐实践。 |
五、总结与高频注意事项清单
掌握 sorted()、enumerate() 与 zip() 的深度参数行为,不仅能让代码更精炼,更能直接规避隐蔽的运行时故障与性能瓶颈。在实际工程落地时,建议遵循以下清单:
- 牢记参数位置与关键字限定:切勿给
sorted()传递sorted(iterable=...);也切勿漏写key=关键字前缀。 - 善用 key 的单次求值与元组组合:将耗时的映射计算放心交给
key(它绝不重复计算);需要多列正反向混合排序时,优先使用key=lambda x: (x.a, -x.b),对非数值字段再回退到多次稳定排序。 - 用好 enumerate 的 start 参数:需要从 1 开始展示行号或序号时,直接使用
enumerate(seq, 1),避免在循环体内频繁编写i + 1。 - 涉及强对齐逻辑时强制 strict=True:在 Python 3.10+ 环境下,只要预期输入数据等长,一律显式声明
zip(a, b, strict=True),将数据不匹配问题及早拦截在边界处。 - 时刻注意迭代器的单次消耗特性:
enumerate与zip均为迭代器,循环或遍历一次即告耗尽;若需要后续多次使用或随机下标访问,务必显式转换为列表或元组。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















