


怎么准备AI智能体应用工程师面试:高频真题与系统设计解析

AI智能体(AI Agent)应用工程师是当下大模型落地浪潮中的关键角色。与传统后端开发不同,这个岗位不仅考察代码能力,更看重对大模型推理边界、工具调用稳定性以及复杂任务拆解的系统化思维。面试中,面试官往往不会只问“什么是Agent”,而是直接抛出“如何设计一个能自动处理客户投诉并生成工单的Agent”这类场景题。准备的核心在于将抽象的架构概念转化为可落地的工程细节,展示你如何处理幻觉、延迟和状态管理。
在开始深入技术细节前,需明确AI智能体应用工程师的核心职责:构建能够感知环境、进行推理并采取行动以达成目标的软件系统。这要求候选人熟悉主流编排框架(如LangChain、LlamaIndex),理解提示词工程的高级技巧,并具备将LLM与传统微服务结合的能力。最低准备条件包括:熟练掌握Python,至少完整复现过一个基于ReAct或Plan-and-Solve模式的Demo,并了解向量数据库的基本原理。
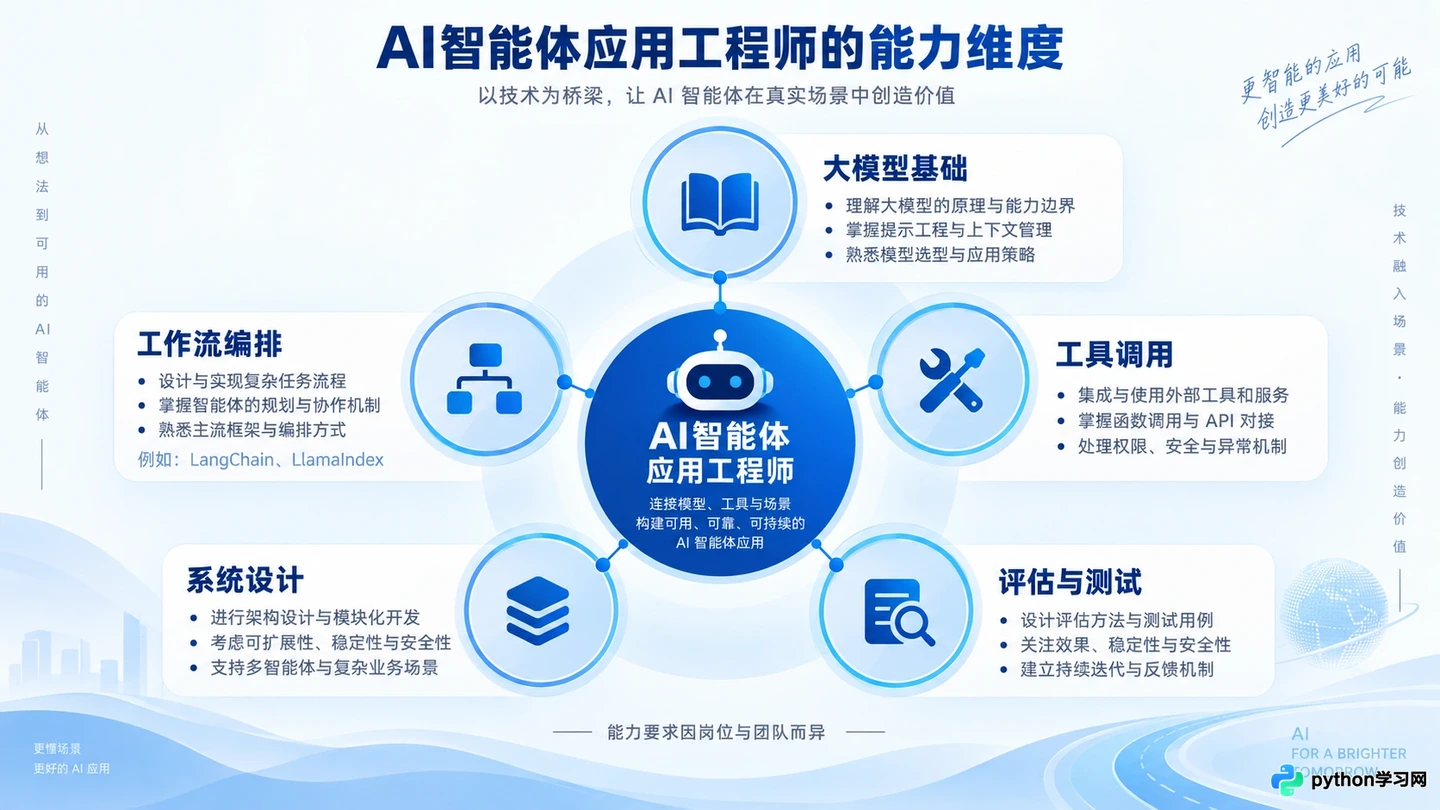
AI智能体应用工程师核心能力模型
1. 解析高频真题:工具调用与错误处理
面试中最常见的问题是:“当模型调用的工具参数格式错误时,你的系统如何应对?”这考察的是系统的鲁棒性。不要只回答“重试”,要给出具体的工程路径。
首先,在定义工具(Tool)时,必须使用严格的Pydantic模型来约束输入输出。例如,定义一个搜索工具时,明确查询字段为字符串,日期字段为标准格式。这样可以在LLM生成参数后、执行工具前,通过序列化校验拦截大部分格式错误。
其次,设计自愈机制。当工具执行抛出异常或返回空结果时,不应直接报错给用户,而是将错误信息封装成新的观察值(Observation),反馈给LLM。具体操作是在Agent的执行循环中,捕获Exception,将其转化为自然语言描述,如“搜索API返回错误:日期格式无效,请使用YYYY-MM-DD格式”,然后让LLM基于此反馈重新生成动作。这种“试错-反馈”闭环是智能体区别于普通链式调用的关键。
from langchain_core.tools import tool
from pydantic import BaseModel, Field

class SearchInput(BaseModel):
    query: str = Field(description="搜索关键词")
    date_range: str = Field(description="日期范围,格式YYYY-MM-DD")

@tool(args_schema=SearchInput)
def search_knowledge_base(query: str, date_range: str) -> str:
    """搜索内部知识库"""
    # 模拟业务逻辑
    if not is_valid_date(date_range):
        raise ValueError("日期格式错误")
    return f"关于{query}的结果..."
最后,设置最大重试次数和降级策略。如果连续三次重试失败,系统应切换到备用方案,例如返回预设的FAQ答案或转接人工客服,避免陷入无限循环或消耗过多Token。
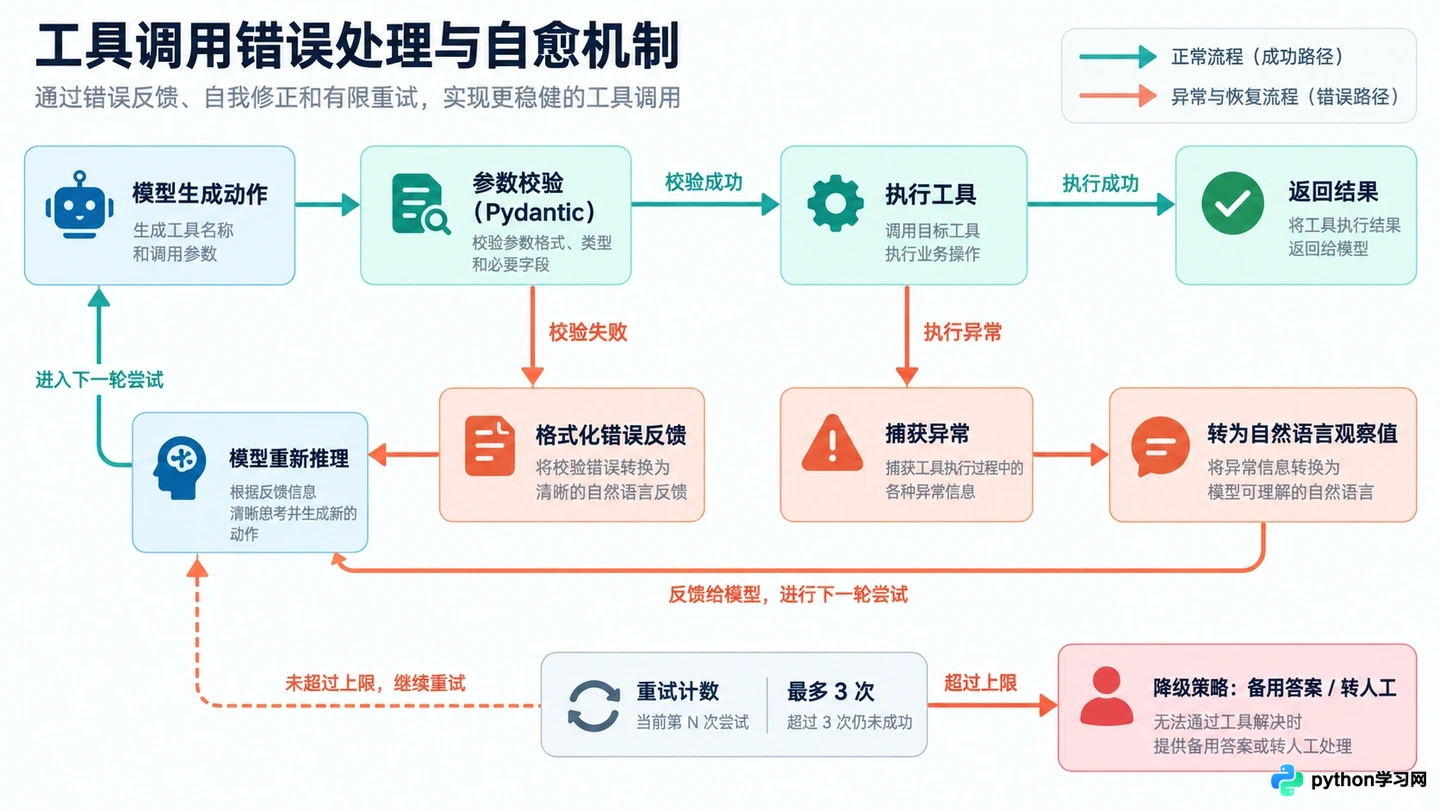
工具调用错误处理与自愈机制
2. 系统设计实战:多智能体协作架构
进阶面试常考系统设计:“设计一个自动化研报生成系统,需要联网搜索、数据分析和报告撰写。”单一大模型难以胜任如此复杂的长链路任务,此时需引入多智能体(Multi-Agent)协作。
第一步,角色拆分。将系统拆分为三个专用Agent:搜索员(Searcher)、分析师(Analyst)和作家(Writer)。搜索员负责根据主题检索最新新闻和数据;分析师负责清洗数据、提取关键指标并生成图表描述;作家负责整合所有信息,按照指定风格撰写报告。每个Agent拥有独立的System Prompt和工具集,例如分析师可访问Pandas解释器,而作家只能访问文档模板。
第二步,确定协作模式。对于线性任务,可采用顺序链(Sequential Chain);对于需要反复迭代修正的任务,推荐使用主管-员工(Supervisor-Worker)模式。主管Agent负责分解任务、分配工作并审核结果。如果分析师提供的数据不完整,主管会指令搜索员补充特定数据,而不是直接交给作家。这种动态路由能显著提高最终产出的质量。
第三步,共享记忆与状态管理。所有Agent的操作日志和中间结果应存入一个共享的状态对象或向量数据库中。例如,搜索员找到的原始链接应被保留,以便作家在生成报告时添加引用来源。使用Redis或专门的Memory模块来维护对话历史和任务进度,确保上下文的一致性。
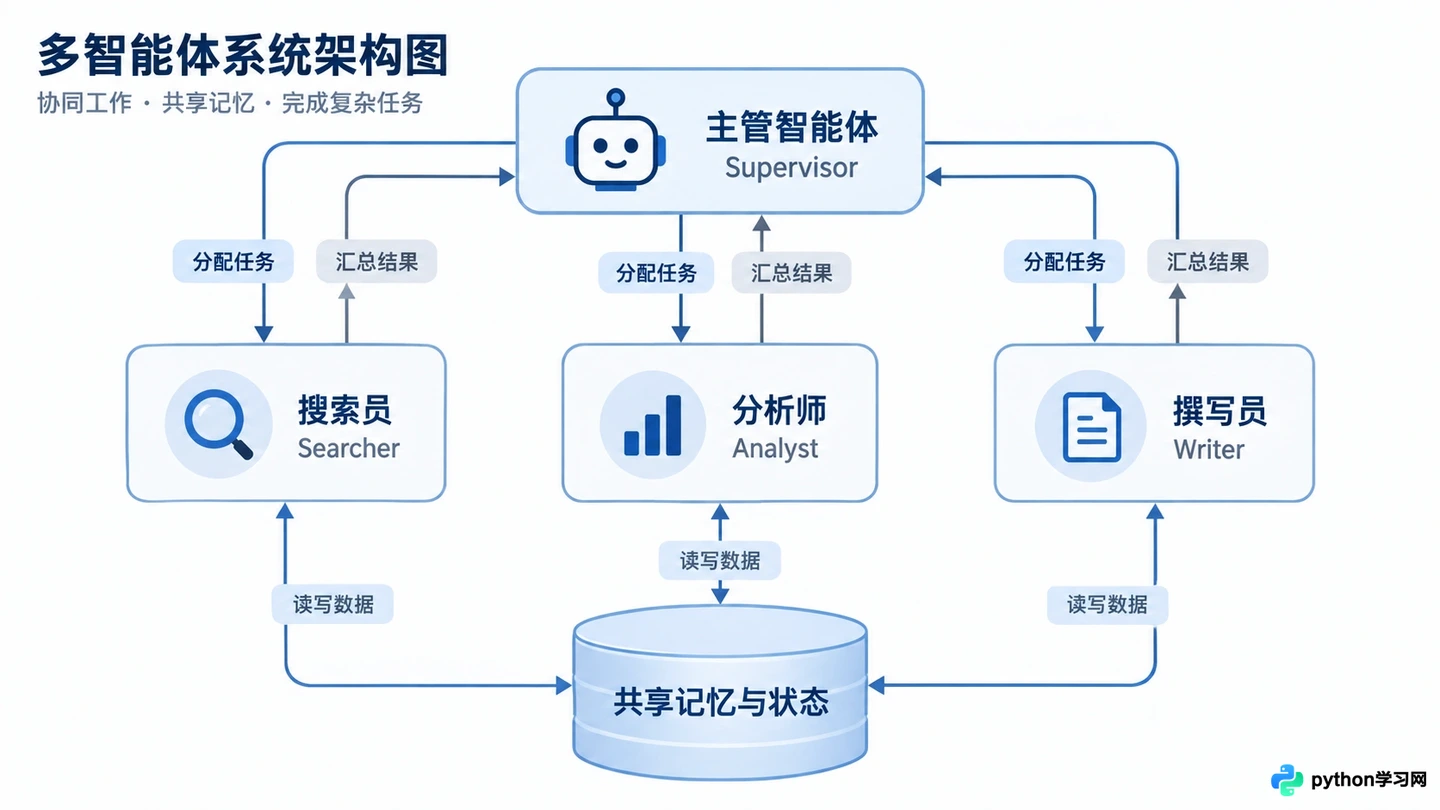
多智能体协作架构:主管-员工模式
3. 关键组件:记忆管理与长期存储
面试官可能会问:“如何让Agent记住用户上周的偏好?”这涉及短期记忆与长期记忆的区分。短期记忆通常存储在对话历史的Context Window中,受限于Token长度,需采用滑动窗口或摘要压缩策略。例如,每经过5轮对话,调用一次LLM对之前的对话进行摘要,替换掉原始细节,从而释放上下文空间。
长期记忆则依赖向量数据库。当用户提到“我喜欢科技类新闻”时,系统应将此偏好提取为结构化数据或嵌入向量,存入用户画像库。在每次新任务开始前,先检索该用户的相关偏好,并将其注入到System Prompt中。关键在于检索的准确性,需对用户输入进行意图识别,仅检索相关度高的记忆片段,避免噪声干扰。
此外,需注意隐私合规。在存储用户数据前,必须进行脱敏处理,并提供用户删除记忆的接口。这在金融、医疗等垂直领域的面试中是必考题。
4. 评估体系:如何证明你的Agent有效
很多候选人忽略了评估环节,但这恰恰是工程落地的难点。面试官常问:“你怎么知道你的Agent比上一个版本好?”不能仅凭肉眼观察,需建立自动化评估流水线。
首先,构建黄金数据集(Golden Dataset)。收集50-100个典型用户查询及其期望的标准答案或执行路径。其次,选择合适的评估指标。对于工具调用,关注准确率(是否调用了正确的工具)和参数正确率;对于文本生成,使用LLM-as-a-Judge方法,即用一个更强的模型(如GPT-4)作为裁判,从相关性、完整性、事实性三个维度打分。
最后,集成到CI/CD流程。每次代码提交后,自动运行评估脚本,生成雷达图对比前后版本的得分变化。如果关键指标下降,则阻止合并。展示你具备这种数据驱动的迭代思维,会极大增加面试官的信任感。
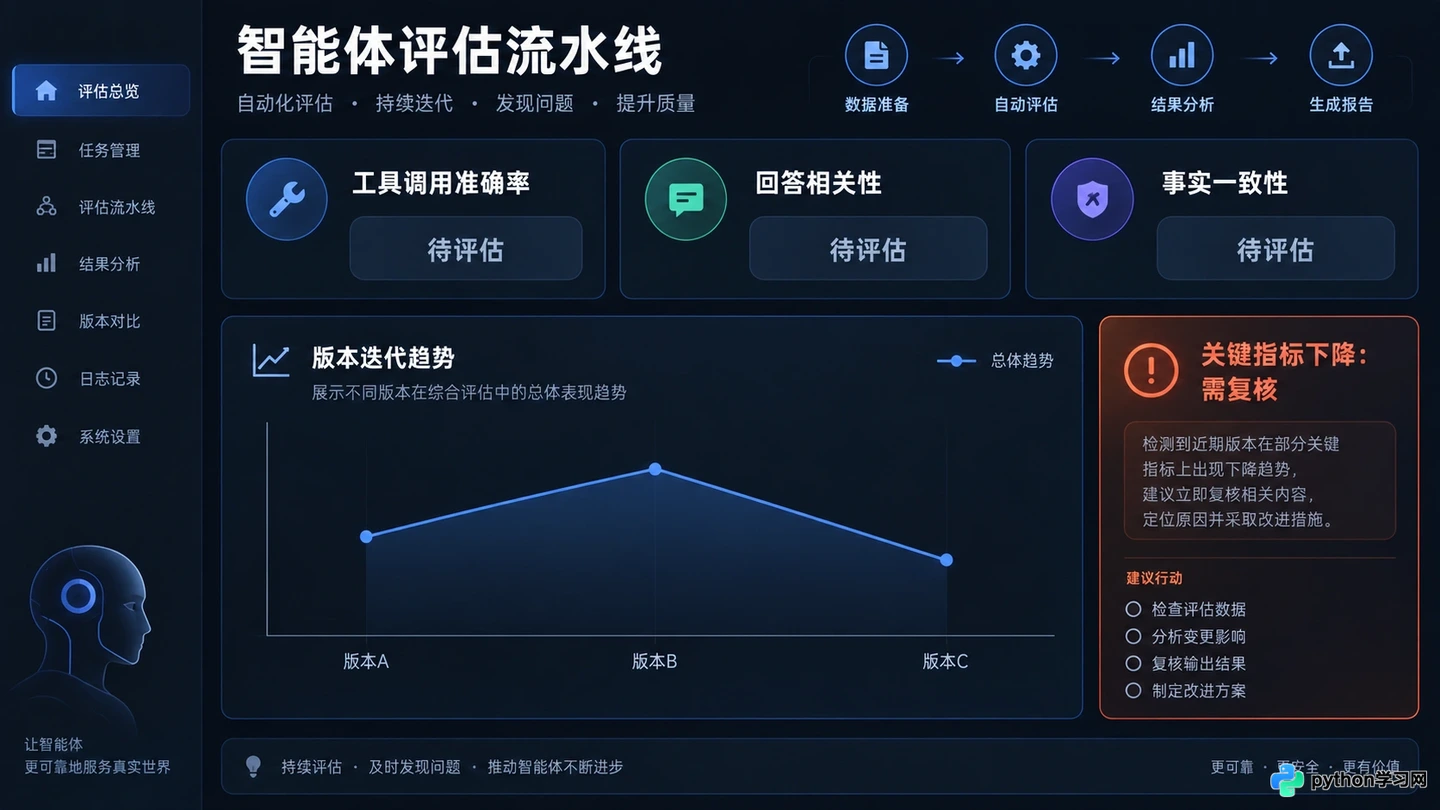
自动化评估流水线与指标监控
5. 作品集构建建议
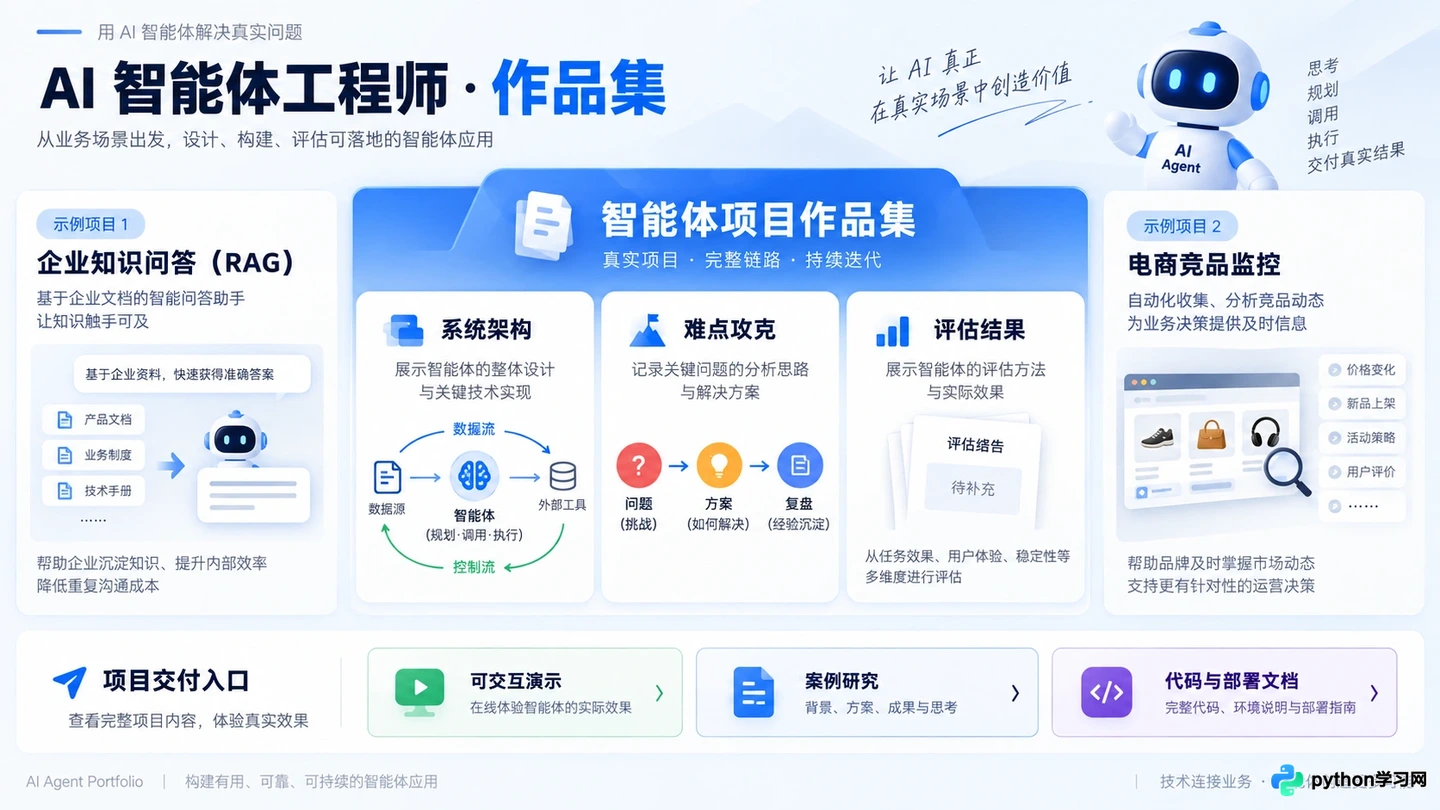
最后,一个扎实的作品集胜过千言万语。不要只放GitHub链接,要提供可交互的Demo或详细的案例研究(Case Study)。建议选择具有实际业务价值的场景,如“基于RAG的企业内部政策问答助手”或“自动化的电商竞品监控Agent”。
在作品集中,重点突出以下三点:一是架构图,清晰展示数据流和控制流;二是难点攻克,详细描述你如何解决某个具体的幻觉问题或延迟问题;三是评估结果,用数据证明系统的稳定性和准确性。确保代码规范、文档齐全,并附上部署教程,体现你的全栈工程能力。
面试不仅是知识的考核,更是工程思维的展现。通过上述步骤,将理论转化为可复现的工程实践,你就能在AI智能体应用工程师的面试中脱颖而出。保持对新技术的敏感,持续迭代你的作品集,机会自然而来。
5. 作品集构建建议
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















