


Python自学路线图:新手必学的核心语法与常用库

自学 Python 时最容易陷入的误区,是在初期被过多元语法细节或繁杂的第三方框架分散注意力,导致学了很久却依然写不出完整的实用脚本。理清学习路径的关键,在于把有限的时间聚焦在出现频次最高的核心语法上,打通控制流与数据组织逻辑,再结合两到三个高频标准库与第三方库,快速建立用代码解决日常实际问题的能力。
一、明确学习节奏:分阶段递进的路线设计
自学 Python 可以划分为四个环环相扣的阶段:先掌握基本语法构建程序骨架,再理解内置数据结构如何高效存取数据,接着利用函数与异常机制保证代码复用性,最后接入成熟的工具库完成任务。每个阶段都有明确的交付标准,无需追求大而全的知识面,达到当前阶段要求即可顺畅推进。
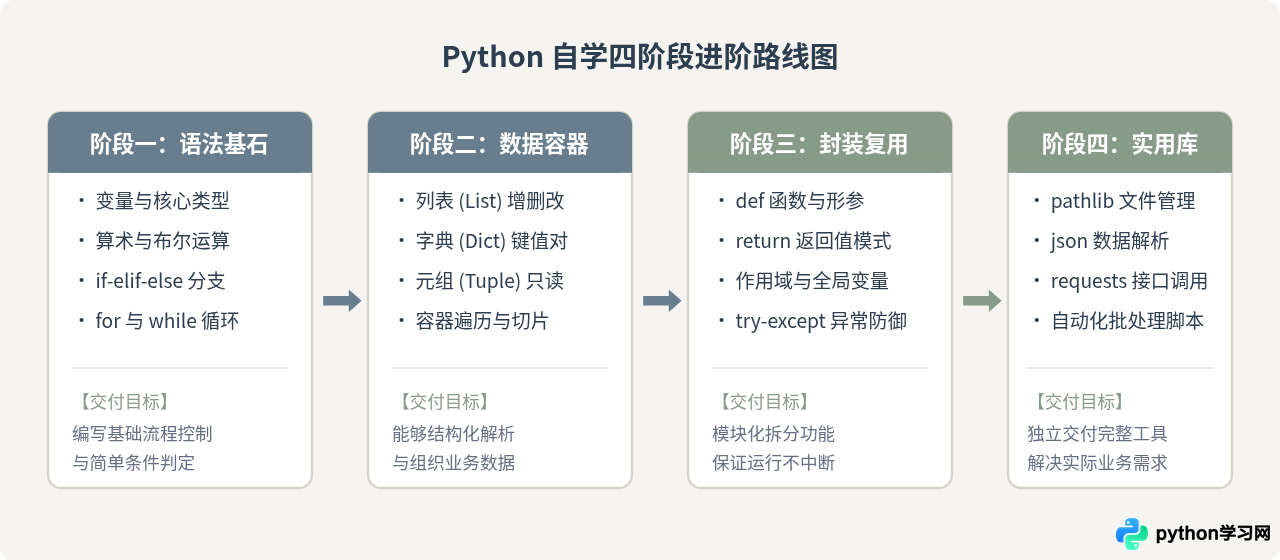
二、核心语法第一层:变量、控制流与代码结构
编写 Python 程序的第一步是理解解释器的执行顺序与作用方式。Python 使用严格的缩进来界定代码层级,而不是像 C 或 Java 那样使用大括号。四个空格作为标准缩进单位,任何缩进混用或遗漏都会直接触发 IndentationError。
1. 动态变量与基本类型
Python 是动态强类型语言。所谓“动态”,是指变量无需显式声明类型,赋值时由解释器自动推导;“强类型”则意味着不同类型之间不会发生不可控的隐式转换。例如不能将字符串直接与整数相加,必须通过 int() 或 str() 进行显式转换。
# 核心基础类型示例
item_name = "数据分析任务"   # 字符串 (str)
task_count = 5              # 整数 (int)
success_rate = 98.5         # 浮点数 (float)
is_completed = True         # 布尔值 (bool)

# 类型转换与格式化输出 (推荐使用 f-string)
summary_message = f"任务: {item_name}, 数量: {task_count}, 完成状态: {is_completed}"
print(summary_message)
2. 逻辑分支与循环控制
程序的核心逻辑由条件判定与重复操作组成。if-elif-else 结构按顺序评估表达式,一旦遇到首个值为 True 的分支便执行对应代码块并跳出结构;for 循环在 Python 中属于迭代器驱动模型,能够直接遍历任意可迭代对象,而 while 循环则用于满足特定条件时持续运行。
# 条件判断与循环配合示例
response_codes = [200, 404, 500, 200, 302]

for code in response_codes:
    if code == 200:
        print(f"状态正常: {code}")
    elif code == 404 or code == 500:
        print(f"请求异常: {code},需记录告警")
    else:
        print(f"重定向或其他状态: {code}")
三、核心语法第二层:内置数据结构与关键差异
理解数据的组织形式是自学路线中的分水岭。日常开发中最常使用的容器类型有四种:列表(list)、元组(tuple)、字典(dict)和集合(set)。掌握它们的设计差异,决定了代码的运行效率与稳定性。
两者表面上都是有序序列,但底层设计存在根本不同:列表是可变对象,支持就地追加、修改和删除;元组是不可变对象,一旦创建其内部引用便永久固定。如果数据在整个生命周期内不需要改动(例如数据库配置项、函数的坐标返回),使用元组能杜绝外部意外篡改,并在内存占用与读取速度上均优于列表。
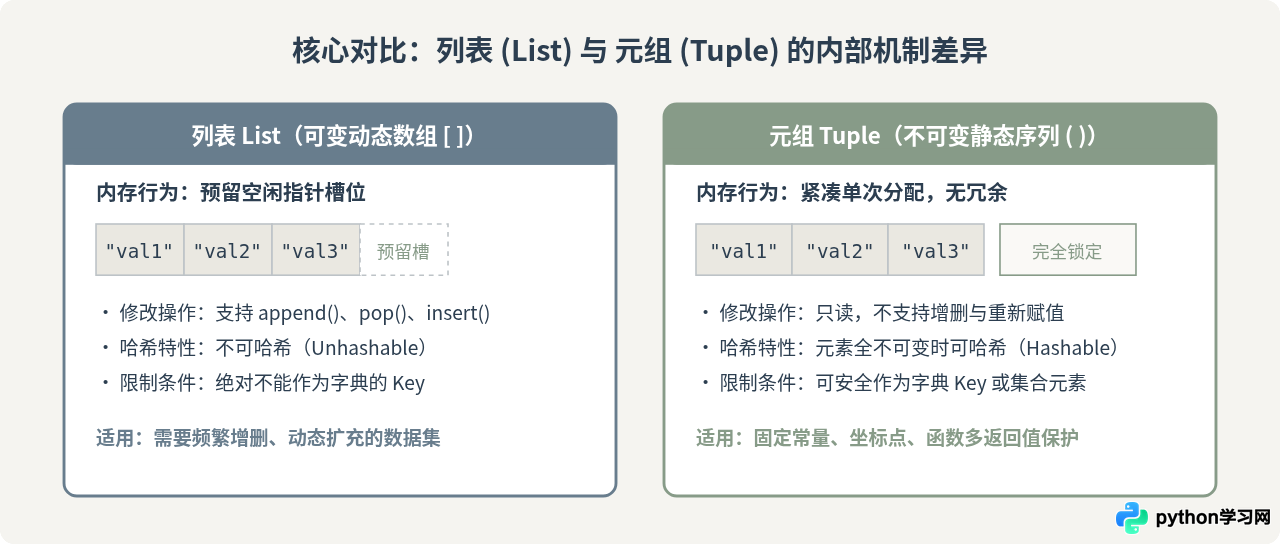
字典的快速查询技巧
字典(dict)是基于哈希表实现的键值对集合,其按键查找的时间复杂度为 O(1)。在实际编写脚本时,尽量避免直接使用 dict[key] 取值,因为当键不存在时会抛出未捕获的 KeyError。更稳健的做法是使用 dict.get(key, default):
# 字典安全操作示例
server_config = {
    "host": "127.0.0.1",
    "port": 8080,
    "environment": "production"
}

# 推荐写法:提供安全回退默认值,避免程序意外崩塌
timeout = server_config.get("timeout", 30)
print(f"当前连接超时时间设置为: {timeout} 秒")
四、核心语法第三层:函数抽象与异常防御
当一段代码在不同地方重复出现两次以上时,就应当提取为独立函数。函数使代码责任单一化,方便测试与定位问题;而异常捕获机制则保证了脚本面对脏数据或网络波动时具备足够的自愈能力。
定义函数时应明确参数与返回预期。在函数内部,尽量减少对全局变量的依赖,所有计算所需的输入通过参数传入,最终结果通过 return 产出:
def calculate_discounted_price(original_price: float, discount_rate: float) -> float:
    """计算折后价格,包含基本参数校验"""
    if original_price < 0 or not (0 <= discount_rate <= 1):
        raise ValueError("价格不可为负数,折扣率必须介于 0 和 1 之间")
    return round(original_price * discount_rate, 2)

# 使用 try-except 进行安全调用防御
try:
    final_price = calculate_discounted_price(199.0, 0.85)
    print(f"结算金额: {final_price}")
except ValueError as err:
    print(f"参数错误导致计算中断: {err}")
五、新手必学的常用库:标准库与核心第三方库
Python 之所以开发效率高,很大程度上归功于其“自带电池”(Batteries Included)的标准库体系以及成熟的第三方开源生态。新手无需记忆上千个库,掌握以下三个最核心的工具库,便能完成绝大多数自动化日常任务:
- pathlib(内置标准库):面向对象的文件路径操作库。相比传统
os.path的字符串拼接,pathlib.Path具备跨平台兼容性,能够直观进行路径拼接、目录遍历与文件读写。 - json(内置标准库):用于处理结构化 JSON 文本与 Python 字典/列表之间的相互序列化与反序列化,是配置文件存取和 Web API 交互的基石。
- requests(第三方核心库):最符合人类习惯的 HTTP 库,相比内置
urllib冗长繁琐的代码,requests只需一行即可发送 GET/POST 请求并自动解析状态码与响应体。
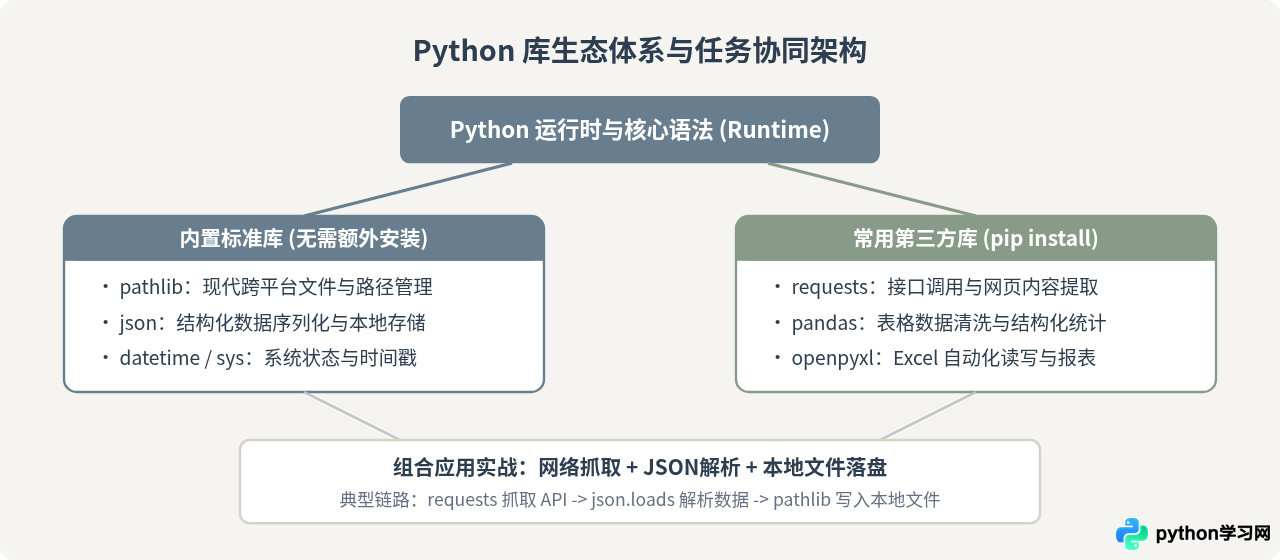
综合实战:从接口拉取数据并保存到本地
下面展示一个完整的端到端示例,结合 requests、json 与 pathlib。此脚本模拟从测试接口获取数据、验证返回状态、解析内容,并将结果持久化保存为格式化的本地 JSON 文件:
import json
from pathlib import Path
import requests

def fetch_and_save_data(api_url: str, output_directory: str, filename: str) -> bool:
    """
    从目标 API 获取 JSON 数据并安全写入指定本地目录。
    环境要求:已通过 pip install requests 安装依赖。
    """
    output_path = Path(output_directory)
    # 创建目标目录,parents=True 确保父级不存在时自动补全,exist_ok=True 避免已存在时报错
    output_path.mkdir(parents=True, exist_ok=True)
    target_file = output_path / filename

    try:
        # 发起请求并设置 10 秒超时
        response = requests.get(api_url, timeout=10)
        # 状态码非 200 系列时自动抛出 HTTPError
        response.raise_for_status()
        data = response.json()

        # 使用 UTF-8 编码写入文件,indent=2 保证可读性
        with open(target_file, "w", encoding="utf-8") as file_handle:
            json.dump(data, file_handle, ensure_ascii=False, indent=2)

        print(f"数据抓取成功,已写入: {target_file.resolve()}")
        return True

    except requests.exceptions.RequestException as net_err:
        print(f"网络请求失败: {net_err}")
    except (json.JSONDecodeError, OSError) as io_err:
        print(f"数据解析或文件写入失败: {io_err}")

    return False

# 示例调用(此处为调用示例代码)
if __name__ == "__main__":
    test_api = "https://jsonplaceholder.typicode.com/todos/1"
    fetch_and_save_data(test_api, "./output_data", "todo_item.json")
六、自学闭环:从代码片段到稳定运行的完整能力
很多初学者在学完语法后依然无法独立写代码,主要原因在于缺乏“需求拆解”与“渐进调试”的方法。遇到一个实际目标时,不要试图一气呵成写出完美脚本,而应当按照固定的自学循环推进:
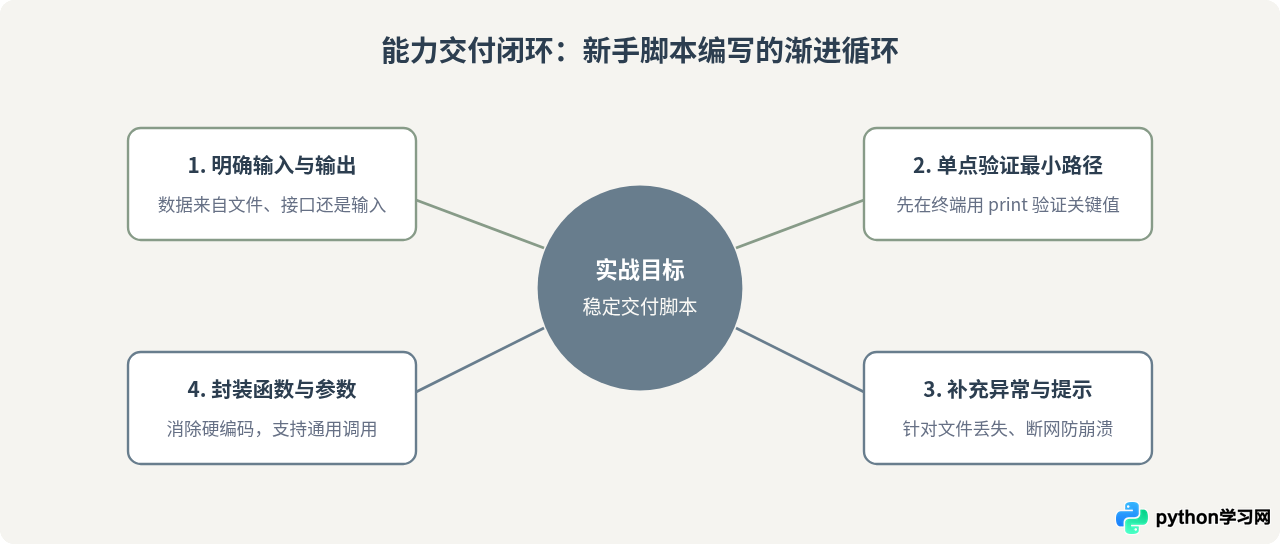
学习 Python 的真正终点不是“背完了所有语法条目”,而是形成“遇到问题用代码替代人工操作”的直觉。当你能够熟练使用条件分支、循环与列表/字典组织数据,并结合 pathlib、json 与 requests 编写出能够正常跑通的小工具时,便已经跨越了新手门槛,建立了坚实可靠的自学基座。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















