


Python在不同操作系统下获取字体名称的差异说明

在跨平台图形界面开发、图片渲染(如 PIL/Pillow)或数据可视化(如 Matplotlib)任务中,获取并指定正确的字体名称是保证文本正常显示的关键步骤。然而,直接使用 Python 获取系统字体时,经常会出现 Windows 下能识别的字体在 macOS 或 Linux 上查无此字,或者获取到的字体名称与系统设置界面显示不一致的问题。这背后的核心原因在于:操作系统对字体的物理存储、注册登记机制不同,以及不同 Python 类库在读取字体元数据(Name Table)时的解析规则存在显著差异。本文将系统阐述这些底层差异,并给出稳定可靠的跨平台处理方法。
一、操作系统字体管理机制的根本差异
不同操作系统并不会按照相同的逻辑组织字体。操作系统管理字体的方式主要可以分为三大阵营:Windows 依赖注册表与特定系统目录映射,macOS 遵循分层资源库与 CoreText 框架服务,而 Linux 则高度统一在 Fontconfig 配置体系下。
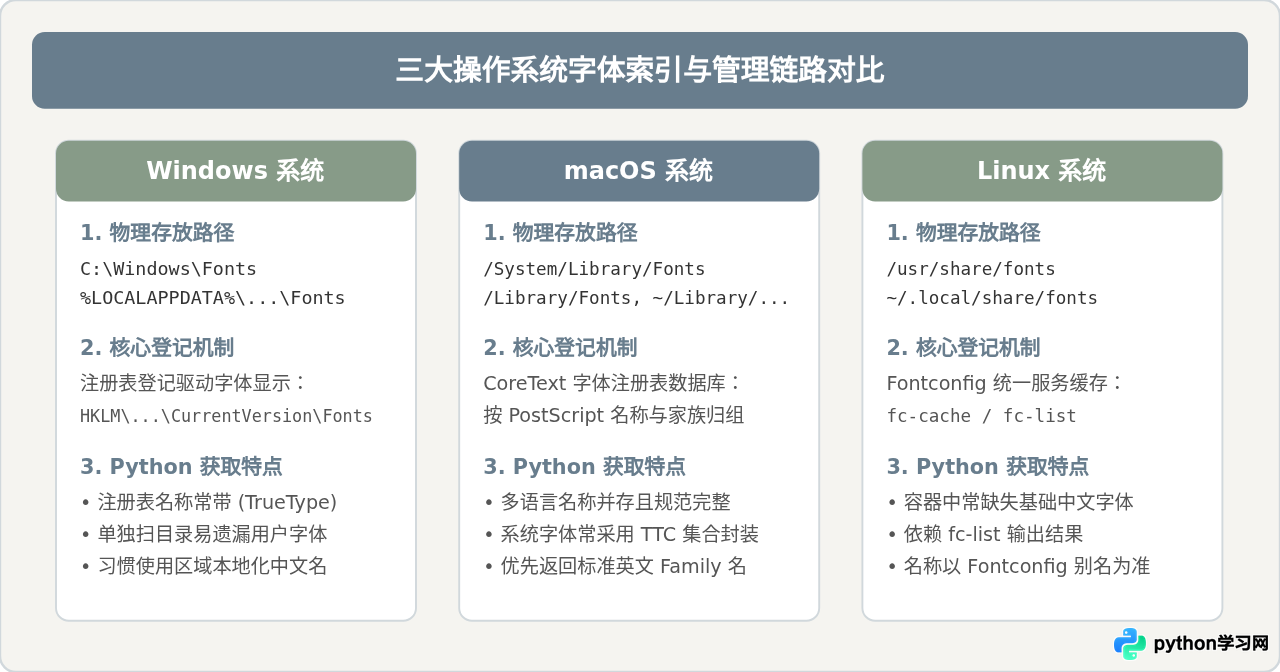
各系统的具体差异体现如下:
- Windows:字体安装分为系统级(
C:\Windows\Fonts)与当前用户级(%LOCALAPPDATA%\Microsoft\Windows\Fonts)。更关键的是,Windows 在注册表(HKLM和HKCU下的Software\Microsoft\Windows NT\CurrentVersion\Fonts)中显式保存了字体的“显示标题”与“文件文件名”对应关系。许多 Windows 软件直接读注册表中的条目作为字体名。 - macOS:具有清晰的沙盒与优先级层次,包括
/System/Library/Fonts(系统保护)、/Library/Fonts(本地所有用户)、~/Library/Fonts(当前用户)。macOS 的 CoreText 引擎天然支持字体族(Family Name)与字重变体的严格解耦。 - Linux:几乎所有现代桌面与服务器环境都通过
fontconfig维护字体缓存。Python 程序如果不借助fc-list外部工具,单纯在文件系统中遍历,就会遇到各发行版(Debian、CentOS、Alpine)目录结构不一致、符号链接繁杂的问题。
二、字体文件内部结构:Name Table 与多语言标识
无论在哪个系统上,TrueType(.ttf)和 OpenType(.otf)格式内部都包含一个名为 name 的元数据表。这个表格不是简单存储一个字符串,而是包含多个条目记录(NameRecord)。
一个完整的 NameRecord 包含四个关键维度:
- Name ID:指定名称类型。最关键的是
Name ID 1(Font Family Name,字体族名,如 "PingFang SC")和Name ID 4(Full Font Name,完整全名,如 "PingFang SC Regular")。 - Platform ID:指定运行平台。通常有 0(Unicode)、1(Macintosh)和 3(Windows)。
- Language ID:指定语言区域。例如
0x0409表示英语(美国),0x0804表示简体中文。 - Encoding ID:编码规范(如 UTF-16BE 或 MacRoman)。
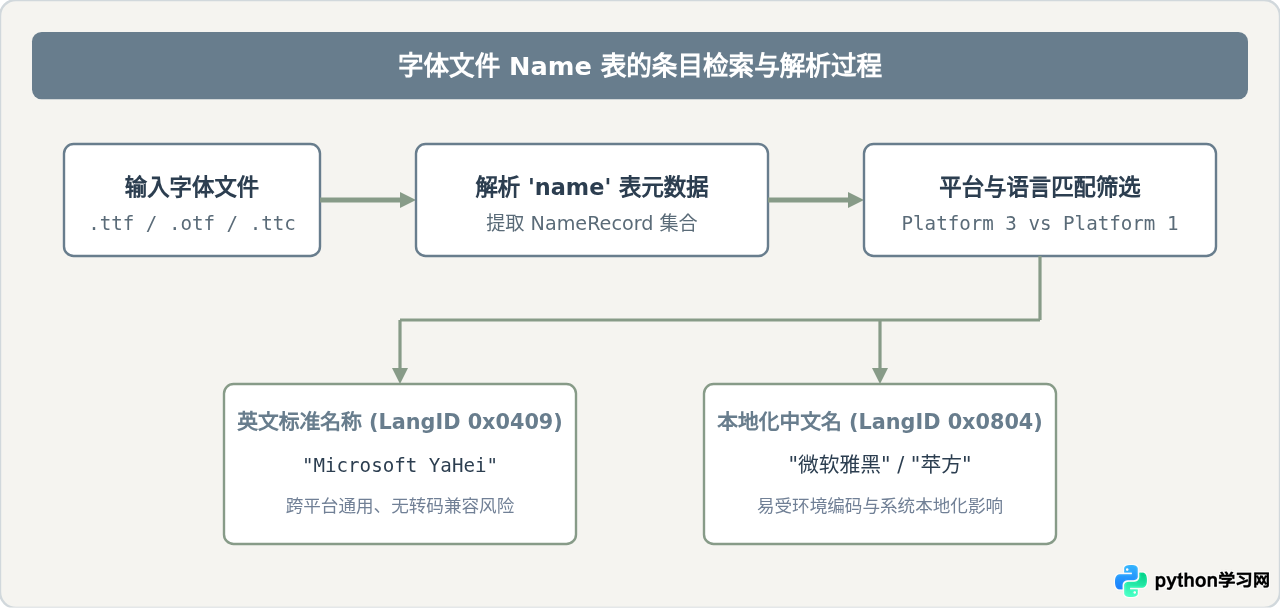
关键差异点就在这里产生:
- 同一款字体文件(例如微软雅黑
msyh.ttc),内部同时存在英文名Microsoft YaHei(Language ID1033/0x0409)和中文名微软雅黑(Language ID2052/0x0804)。 - 在中文版 Windows 下,许多 API 会默认优先读取
0x0804本地化名称;而在英文版系统、macOS 或无头 Linux 容器中,由于当前 Locale 为C.UTF-8或en_US.UTF-8,API 往往回退到英文 Name IDMicrosoft YaHei。 - 如果代码硬编码了中文名
plt.rcParams['font.sans-serif'] = ['微软雅黑'],在非中文环境运行,就会触发字体缺失回退告警(UserWarning: Glyph ... missing from current font)。
三、Python 常用方案在不同平台上的行为对比
在 Python 中获取或检索字体,通常有三种常见做法。它们在不同系统下的稳定性与结果截然不同:
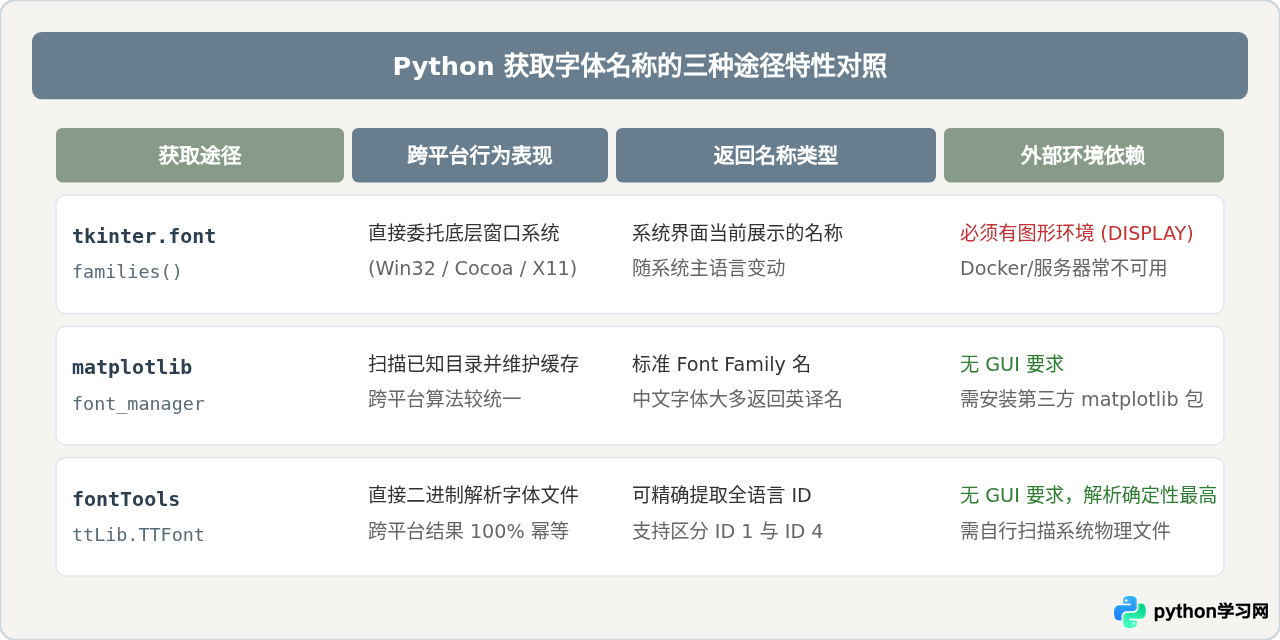
1. 使用 tkinter.font.families() 的局限
tkinter 内置于多数 Python 安装中。调用 tkinter.font.families() 会向底层操作系统窗口管理器查询字体列表。
import tkinter as tk
import tkinter.font as tkfont

root = tk.Tk()
root.withdraw()  # 隐藏主窗口
all_fonts = set(tkfont.families())
print("字体总数:", len(all_fonts))
print("包含微软雅黑:", "微软雅黑" in all_fonts)
print("包含Microsoft YaHei:", "Microsoft YaHei" in all_fonts)包含微软雅黑: True
包含Microsoft YaHei: False
包含微软雅黑: False
包含Microsoft YaHei: False (系统默认未装) / PingFang SC: True
差异表现与风险:在 Linux 服务器或 Docker 容器环境中,由于缺少 X11/Wayland 图形显示服务(即没有 DISPLAY 环境变量),执行 tk.Tk() 会直接抛出 _tkinter.TclError: no display name and no $DISPLAY environment variable,导致整个服务启动失败。
2. 使用 matplotlib.font_manager 的跨平台适配
matplotlib.font_manager 在初次执行时,会自动枚举三大操作系统的典型字体存储目录,并抽取字体元数据持久化保存在用户家目录下的缓存文件(fontlist-*.json)。
from matplotlib import font_manager

# 提取系统中所有被 Matplotlib 识别的字体 Family 名称
font_names = set(f.name for f in font_manager.fontManager.ttflist)
zh_candidates = [name for name in font_names if any(w in name for w in ['Hei', 'Song', 'Kai', 'Fang', 'YaHei', 'Sim'])]
print("部分匹配到的中文字体家族名 (英文标识优先):", zh_candidates[:6])注意:Matplotlib 的 fontManager 内部倾向于使用 Name ID 1 的英文 ASCII 形式作为规范键值。因此在 Windows 上,尽管资源管理器里写着“微软雅黑”,但在 Matplotlib 属性中必须传入 'Microsoft YaHei' 才能命中匹配;直接传入 '微软雅黑' 在某些版本可能通过名称别名(alias)匹配成功,但在跨平台部署时很容易失效。
四、编写健壮的跨平台字体探测方案
为了在不依赖图形环境、且不引入庞大依赖的前提下获取准确的字体名称,推荐结合操作系统的原生路径和轻量级 fontTools 工具。以下是一套兼容三大操作系统的完整探测代码:
import os
import sys
import platform
from pathlib import Path
from typing import Dict, List, Set

def get_system_font_paths() -> List[Path]:
    """根据当前操作系统返回字体文件搜索路径"""
    os_name = platform.system()
    search_paths = []

    if os_name == "Windows":
        # 系统级字体与当前用户独立安装字体
        win_dir = os.environ.get("WINDIR", r"C:\Windows")
        search_paths.append(Path(win_dir) / "Fonts")
        local_app = os.environ.get("LOCALAPPDATA")
        if local_app:
            search_paths.append(Path(local_app) / "Microsoft" / "Windows" / "Fonts")

    elif os_name == "Darwin":  # macOS
        search_paths.extend([
            Path("/System/Library/Fonts"),
            Path("/Library/Fonts"),
            Path.home() / "Library" / "Fonts"
        ])

    elif os_name == "Linux":
        search_paths.extend([
            Path("/usr/share/fonts"),
            Path("/usr/local/share/fonts"),
            Path.home() / ".local" / "share" / "fonts",
            Path.home() / ".fonts"
        ])

    return [p for p in search_paths if p.is_dir()]

def inspect_font_names(file_path: Path) -> Dict[str, Set[str]]:
    """
    使用 fontTools 解析字体文件内部的英文名与本地化多语言名
    返回: {'family_names': {...}, 'full_names': {...}}
    """
    try:
        from fontTools.ttLib import TTFont, TTCollection
    except ImportError:
        raise ImportError("请先安装轻量级依赖: pip install fonttools")

    results = {"family_names": set(), "full_names": set()}

    def extract_from_ttfont(font: TTFont):
        if "name" not in font:
            return
        for record in font["name"].names:
            # 仅处理 Family Name (ID 1) 与 Full Name (ID 4)
            if record.nameID in (1, 4):
                try:
                    # 获取解码后的可读名称字符串
                    name_str = record.toUnicode().strip()
                    if not name_str:
                        continue
                    if record.nameID == 1:
                        results["family_names"].add(name_str)
                    elif record.nameID == 4:
                        results["full_names"].add(name_str)
                except UnicodeDecodeError:
                    continue

    ext = file_path.suffix.lower()
    try:
        if ext == ".ttc":
            # TTC 属于字体集合,可能包含多个子字体
            ttc = TTCollection(file_path)
            for subfont in ttc.fonts:
                extract_from_ttfont(subfont)
        elif ext in (".ttf", ".otf"):
            font = TTFont(file_path)
            extract_from_ttfont(font)
    except Exception:
        pass  # 忽略损坏或非标准字体文件

    return results

if __name__ == "__main__":
    print(f"当前操作系统: {platform.system()} ({platform.release()})")
    font_dirs = get_system_font_paths()
    print("检索到的系统字体目录:")
    for d in font_dirs:
        print(f"  - {d}")

    # 简单扫描前 5 个字体文件验证输出
    count = 0
    for folder in font_dirs:
        for file in folder.glob("*.[tT][tT][fFcC]"):
            info = inspect_font_names(file)
            if info["family_names"]:
                print(f"\n文件: {file.name}")
                print(f"  字体族名 (Family): {sorted(list(info['family_names']))}")
                print(f"  完整名称 (Full):   {sorted(list(info['full_names']))}")
                count += 1
                if count >= 3:
                    break
        if count >= 3:
break检索到的系统字体目录:
- C:\Windows\Fonts
- C:\Users\Username\AppData\Local\Microsoft\Windows\Fonts
文件: msyh.ttc
字体族名 (Family): ['Microsoft YaHei', '微软雅黑']
完整名称 (Full): ['Microsoft YaHei Regular', '微软雅黑']
五、场景选型与最佳实践
在工程实践中,切忌使用单一的硬编码字符串指代中文字体。下图展示了根据不同部署环境与技术栈选型字体检测策略的决策路径:
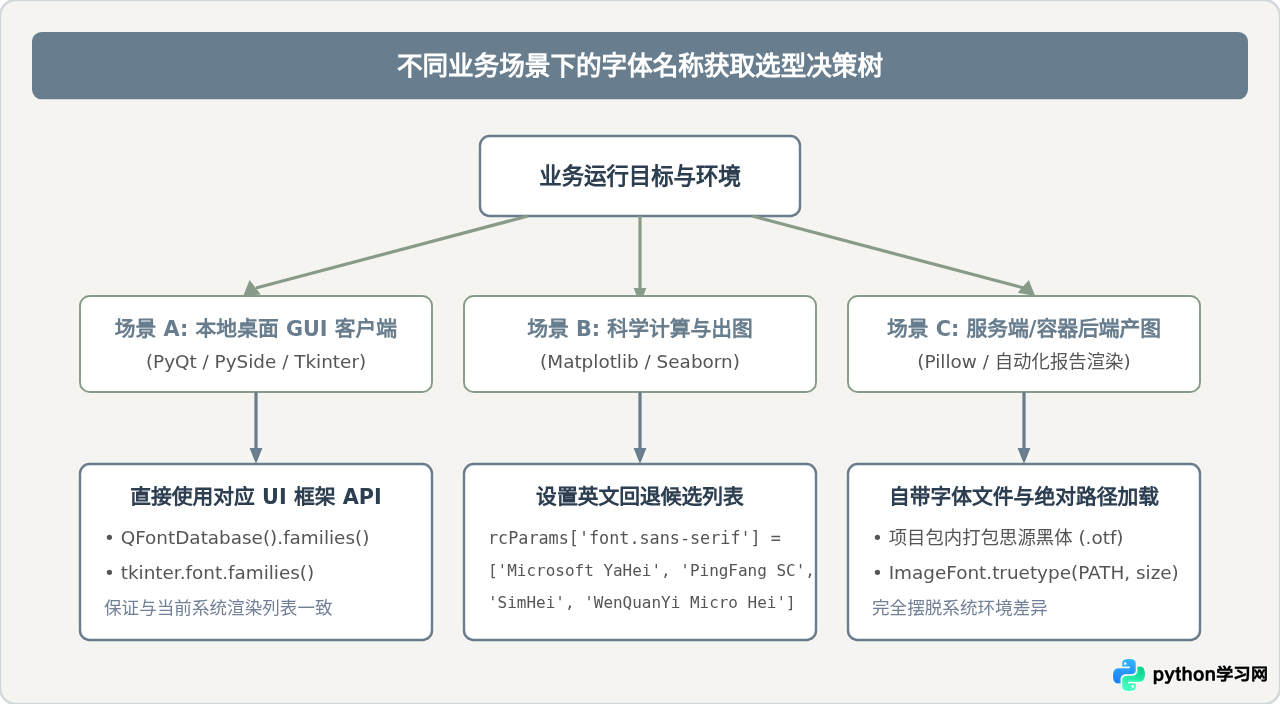
总结起来,应对 Python 在各操作系统下获取字体名称的差异,遵循以下三条准则即可彻底避免乱码和回退失败:
- 优先采用英文 Family 标识符:例如同时定义
['PingFang SC', 'Microsoft YaHei', 'Source Han Sans SC', 'SimHei'],它比纯中文名称能更好地被各类绘图后端解析。 - 无头服务器不要假定系统预装中文字体:Linux 最小化镜像(如 Alpine 或 Ubuntu minimal)默认不包含任何 CJK 字体,任何获取操作都会返回空或拉丁字体,需先通过
apt-get install -y fonts-noto-cjk安装。 - 严谨业务使用具体字体路径加载:在自动化图表生成与服务端绘图中,将开源字体文件(如思源黑体)固化在项目资源包内并使用绝对物理路径加载,是确保全平台 100% 渲染一致的最优解。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















