


小型脚本与大型Python库的项目结构设计差异

小型脚本的核心目标是“低开销与快速执行”,解决特定单点任务;而大型Python库的核心目标是“高可靠复用、跨环境分发与协同演进”。两者看似都由 .py 文件组成,但在项目目录排布、导入隔离机制、API暴露控制以及打包构建元数据上存在根本性设计差异。理解这些差异,可以帮助开发者在项目起步时避免过度设计,并在业务规模增长时能够从容重构与迁移。
一、形态与组织目标的本质分野
在设计Python工程结构之前,首先需要明确当前代码究竟是“自用运行的脚本”还是“供他人调用的公共资产”:
- 小型脚本(Scripts & Automation):通常以单文件或扁平目录形态存在。代码通常从上到下执行,生命周期与宿主机器紧密绑定,主要关注逻辑直观性与即改即跑的便捷度。
- 大型Python库(Libraries & Packages):属于被动依赖,需要安装在不受控的第三方虚拟环境中。其结构设计必须应对命名冲突、意外导入穿透、多平台构建分发以及长期的向后兼容要求。
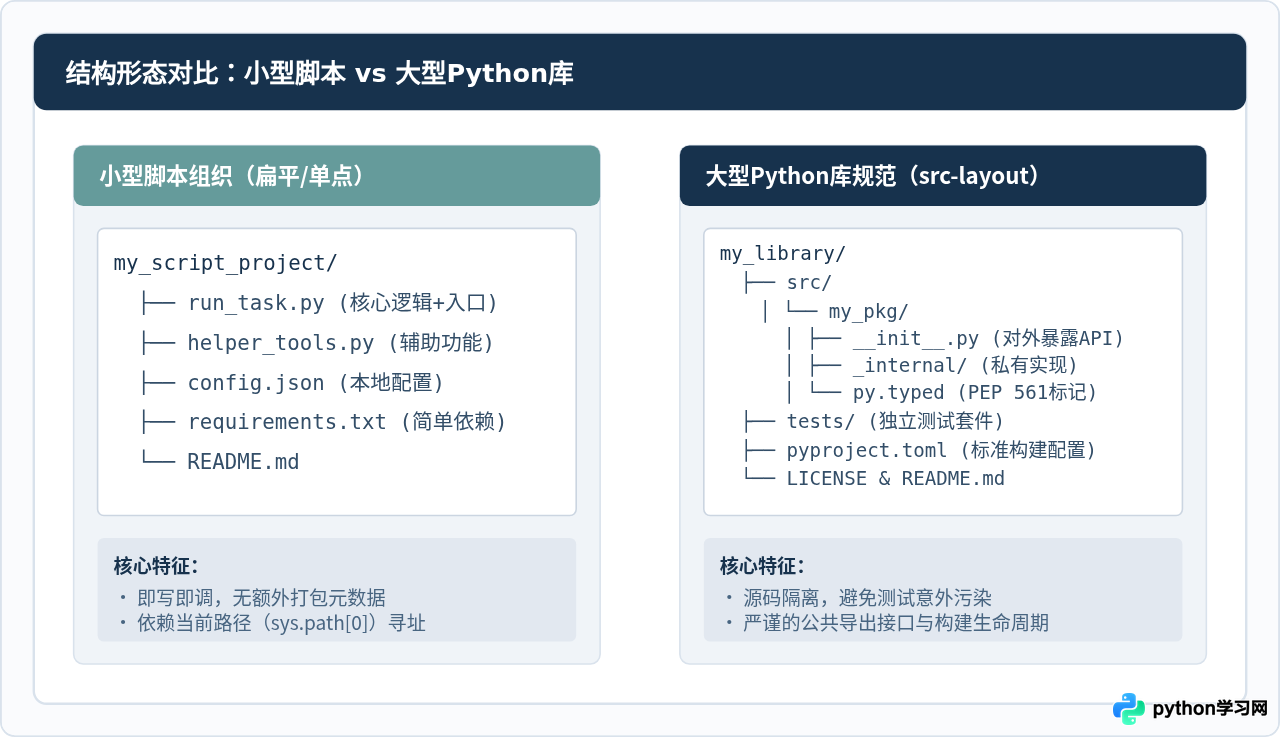
二、目录布局与导入机制:扁平布局与 src-layout
项目结构设计最直观的差异在于目录排布。许多人在编写脚本时习惯将模块直接存放在仓库根目录下(即所谓的 Flat Layout),但对于大型库而言,这种排布隐藏着严重的导入陷阱。
1. 扁平布局(Flat Layout)在脚本中的便利
在简单自动化任务中,直接运行 python run_task.py 会自动将当前工作目录添加到解释器的 sys.path[0] 中。这使得脚本无需执行安装命令即可直接引用同目录下的 helper_tools.py。对于单人维护、短期运行的小工具而言,这种结构开销极小且直观有效。
2. 大型库为何首选 src-layout
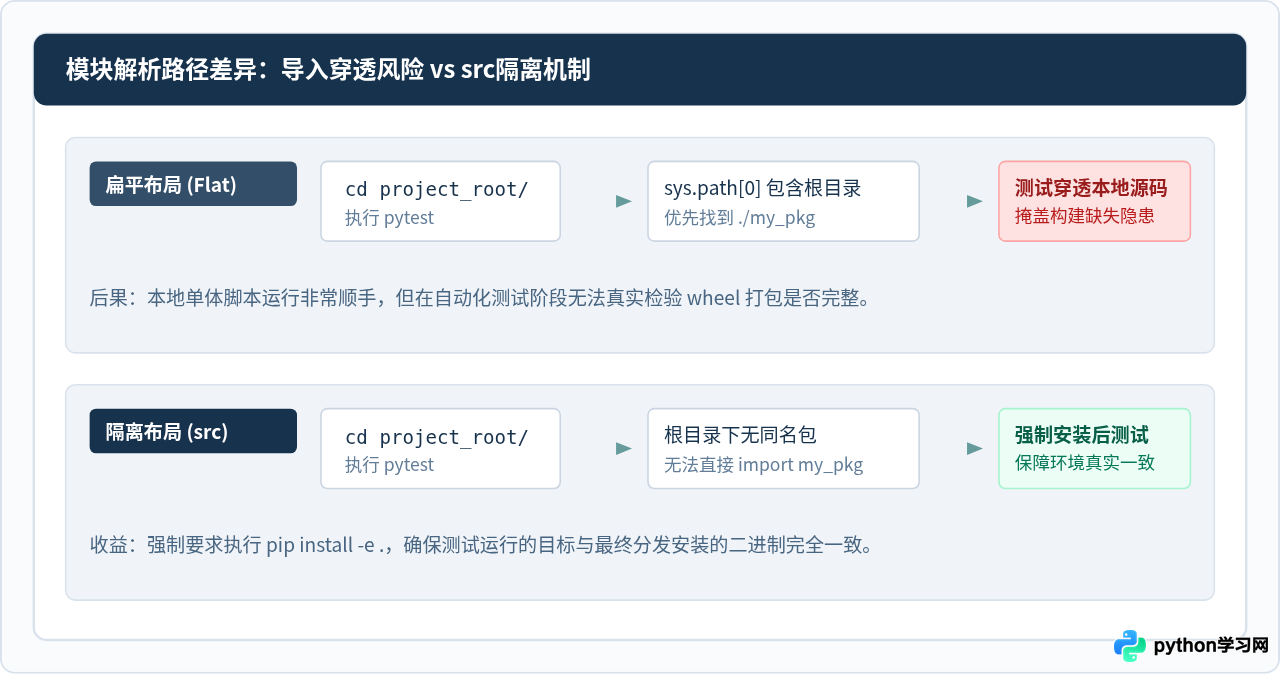
对于大型项目或准备发布的开源包,将包源码置于 src/ 目录之下(例如 src/my_pkg/)已经成为现代Python社区的标准实践。其核心目的是环境隔离与防污染:
- 防止本地未打包源码遮蔽安装包:在根目录下运行
pytest时,由于根目录存在与包名同名的文件夹,解释器会优先导入未编译、未打包的本地代码,而不是测试环境通过pip install -e .安装的版本。这会导致缺少文件、编译扩展遗漏等严重缺陷在本地测试中被掩盖。 - 避免根目录文件被错误打包:扁平结构下,根目录的临时测试脚本、数据文件容易被构建工具打包进最终发布的 Wheel 中,造成产物体积膨胀与安全隐患。
三、入口机制与 API 暴露边界
1. 程序入口的演进
小型脚本的入口通常紧凑简单,核心逻辑直接附带执行保护块:
if __name__ == "__main__":
    main()
而大型库通常面向两种受众:一是 Python 代码层面的调用者,二是命令行用户。对于命令行工具,现代库不再直接提供可执行脚本文件,而是通过 pyproject.toml 注册入口点(Entry Points):
[project.scripts]
my-cli = "my_pkg.cli:main"
安装后,pip 会在虚拟环境的 bin/ 或 Scripts/ 目录下自动生成匹配当前操作系统的轻量级可执行代理,无需手动编写复杂的跨平台启动脚本。
2. 公开 API 与内部私有实现(__all__ 与 _internal)
在脚本中,所有顶级函数和变量通常默认全局可见。但在大型库中,**API 边界控制**至关重要:
__init__.py的网关作用:库的顶级__init__.py是唯一对外的门面。应在其中精选核心接口,并通过__all__显式导出:# src/my_pkg/__init__.py from my_pkg.core.engine import Engine from my_pkg.core.client import Client __all__ = ["Engine", "Client"]- 私有模块隔离:非公开的算法细节、兼容性垫片应当置于下划线开头的子目录(如
_internal/或_compat.py)。这清晰地向使用者传达:这些接口随时可能重构,不享受语义化版本(SemVer)的向后兼容保证。 - 类型支持文件
py.typed:根据 PEP 561 规范,大型库应在根包中放置一个空的py.typed文件,向mypy等静态分析工具声明本库附带完整的类型注解。
四、依赖规范与元数据构建
小型脚本依赖管理往往停留在 requirements.txt,甚至仅通过文档说明运行前需要执行的 pip install ... 命令。这种方式存在以下局限:
- 无法清晰区分“运行核心依赖”、“开发调试依赖”与“扩展可选依赖”。
- 无法自动声明项目版本号、作者、授权协议及支持的 Python 运行时范围。
大型项目统一采用声明式构建配置文件 pyproject.toml(基于 PEP 517/518/621 规范),将所有元数据汇聚在单一文件中:
[build-system]
requires = ["hatchling"]
build-backend = "hatchling.build"

[project]
name = "enterprise-toolkit"
version = "1.0.0"
description = "企业级高可用数据处理库"
readme = "README.md"
requires-python = ">=3.10"
dependencies = [
    "pydantic>=2.0",
    "httpx>=0.24.0",
]

[project.optional-dependencies]
dev = [
    "pytest>=8.0",
    "mypy>=1.8",
]
redis = [
    "redis>=5.0",
]
五、从一次性脚本向标准 Python 库演进的操作步骤
当一个脚本被越来越多的同事复制粘贴,或者开始在多个微服务中重复使用时,就必须启动结构标准化演进。以下是经过实践验证的 4 步演进路径:
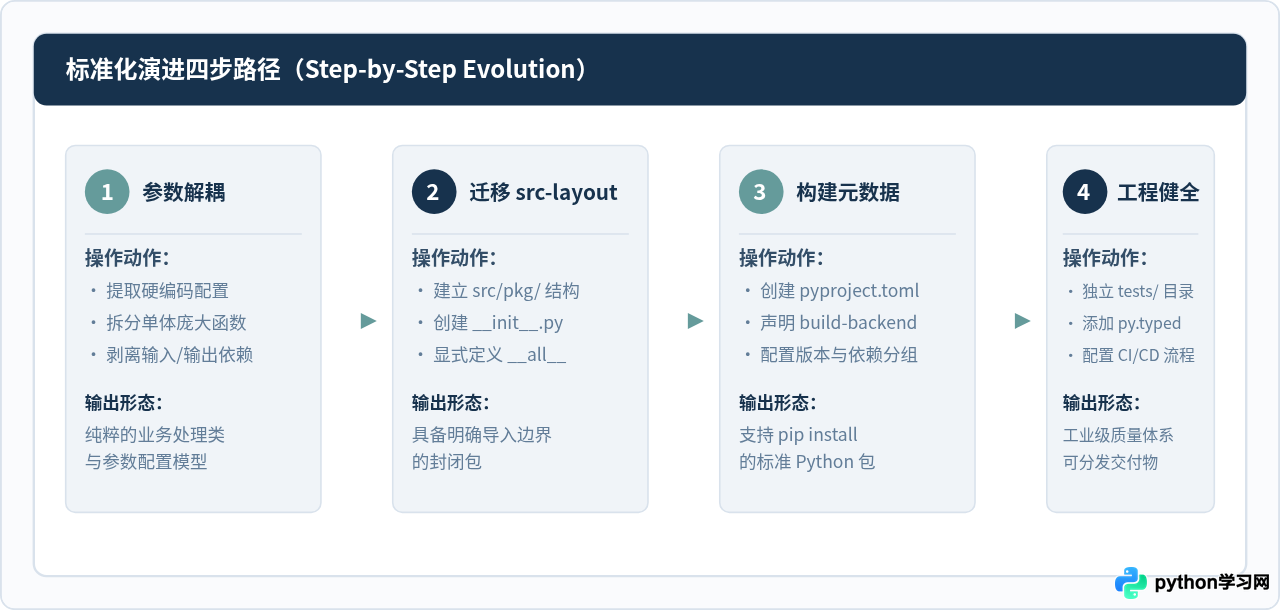
具体实操步骤:
- 剥离副作用与硬编码:将原来写在文件顶层的全局变量(如数据库连接字符串、文件绝对路径)抽取为函数参数或配置类对象。消除执行导入时的副作用代码。
- 建立
src/目录:在根目录下建立src/目录,将核心代码转移至src/your_package/内。在包内使用相对导入(如from .core import Processor),而在外部导入时一律使用绝对包名。 - 配置现代构建元数据:删除遗留的
setup.py,编写规范的pyproject.toml,明确依赖以及 Python 版本兼容限制。 - 可编辑模式安装并验证测试:在项目根目录下执行:
若能在不设置python -m venv .venv source .venv/bin/activate pip install -e ".[dev]" pytestPYTHONPATH的前提下顺利运行测试,说明项目已具备健全的库组织架构。
六、决策依据与关键特征对比
在实际团队研发中,并不需要将所有脚本都改造为大型库形态。为了帮助团队精准选型,下表对关键工程要素进行了系统性归纳:
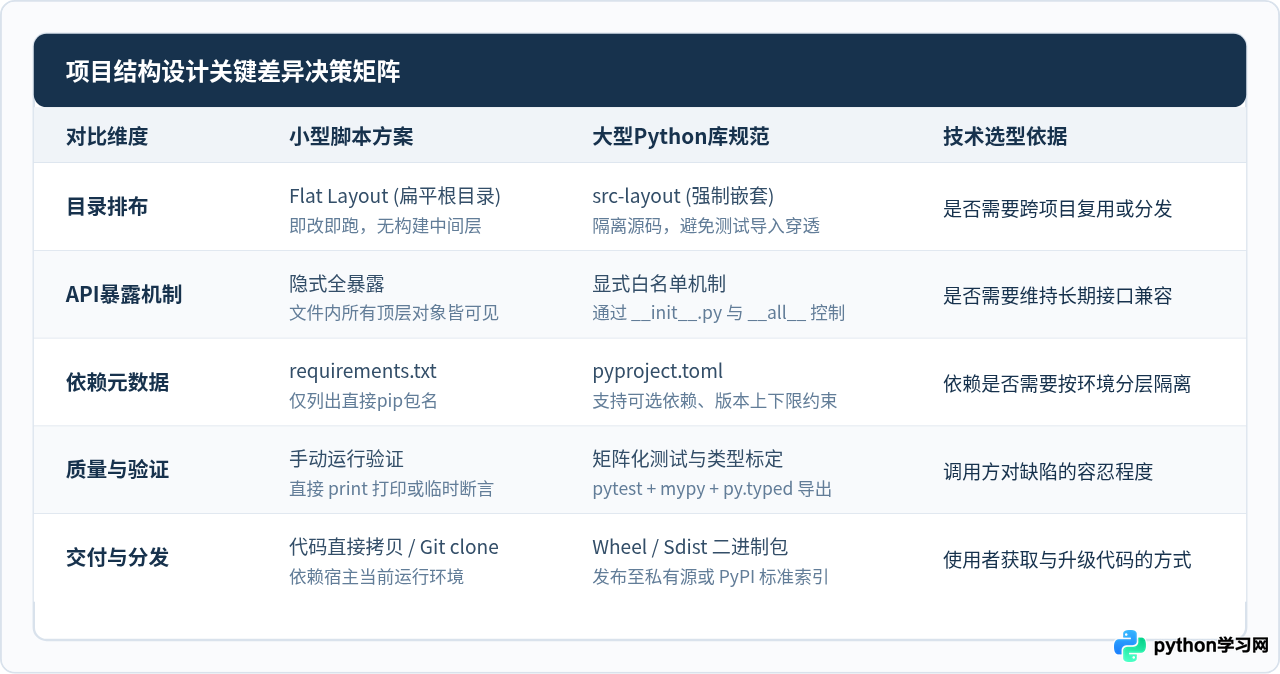
架构设计原则总结:对于生命周期少于两周或运行环境严格受限的探索性任务,应坚定保持小型脚本的扁平精简,避免过早引入打包工具链;一旦模块被超过两个独立代码库引入,或需要跨机器分发,就应严格遵循 src-layout 与 pyproject.toml 规范,用工程结构守住系统的稳定性与兼容底线。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















