


Python用列表推导式遍历字典并格式化输出

在 Python 中,使用列表推导式遍历字典并进行格式化输出,核心解决路径是通过调用字典的 .items() 方法同时解包键与值,并在推导式前端使用格式化字符串字面值(f-string)进行组装。最典型、直接的语法形态为 [f"{k}: {v}" for k, v in data.items()]。这种方式不仅语法凝练、运行效率高于传统的循环累加,还能灵活融入对齐占位符、数值精度控制以及条件过滤,从而快速产出整洁的字符串列表。
一、核心概念:字典遍历机制与推导式装配
在展开具体写法前,需要明确字典在 Python 中的迭代行为。字典本身是键到值的映射容器。若直接对字典变量执行迭代(如 for x in data),Python 默认只会产出字典的键。为了在格式化文本中同时呈现键与值,必须显式调用能够提供键值二元组的迭代接口。
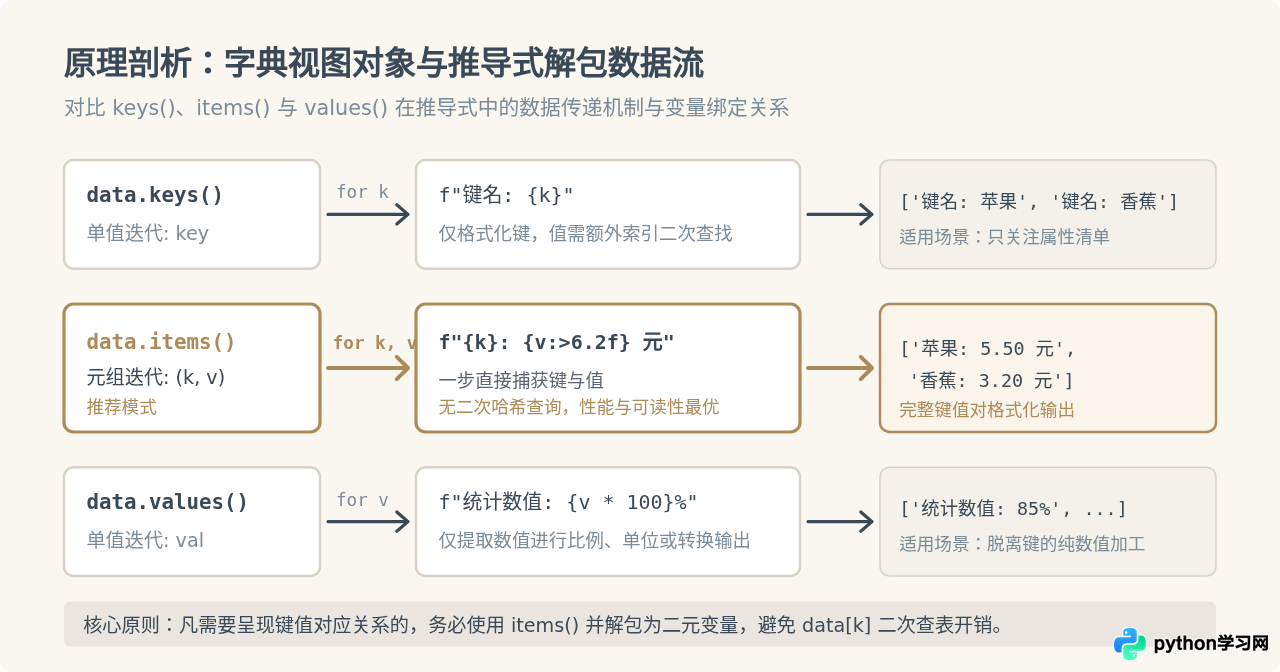
Python 字典主要提供三种迭代视图:
dict.keys():仅产出字典的键,与直接遍历字典对象行为一致。dict.values():仅产出字典的值,丢弃键的信息。dict.items():产出包含(key, value)的动态视图对象,支持二元变量直接解包。
列表推导式通过在外层包裹方括号 [...],将原本多行的循环与追加操作压缩为一个自包含的高性能表达式,内部利用底层 C 级别的字节码优化直接构造列表,避免了反复调用 list.append() 带来的额外函数栈开销。
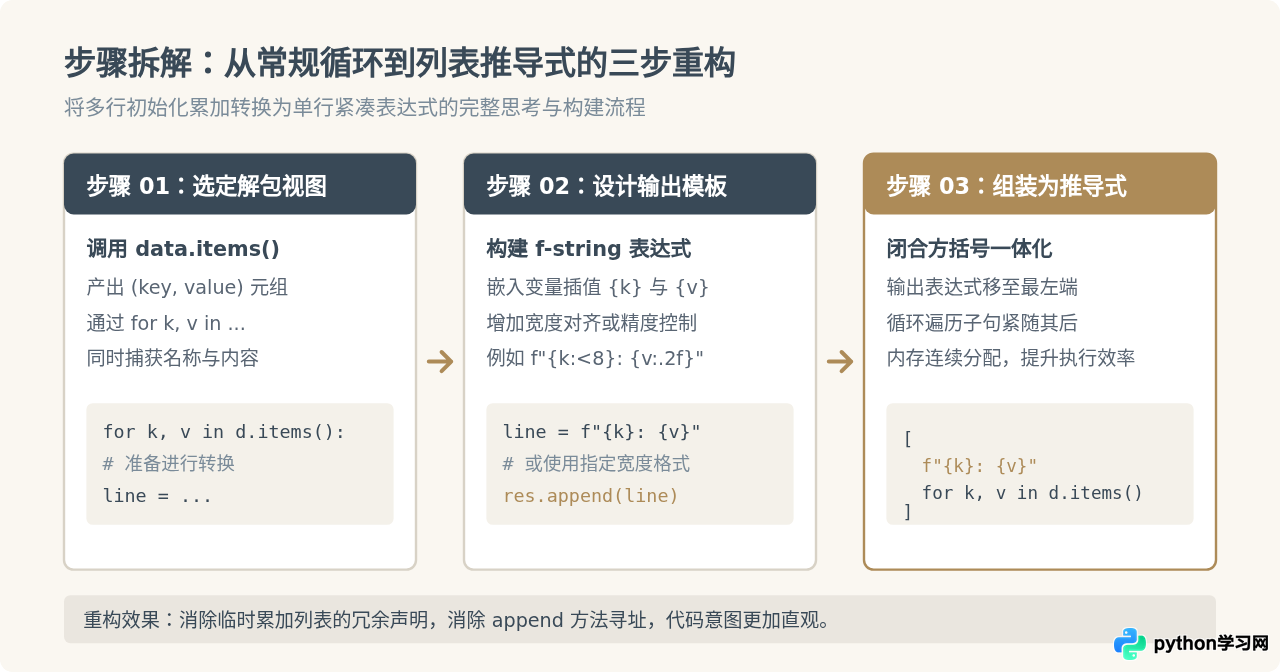
二、标准操作示例:基础格式化输出
在日常开发中,最普遍的需求是将字典中的键值对转换为易读的键值字符串列表,进而写入文件或打入日志。以下代码展示了传统方法与列表推导式实现的具体对比。
1. 传统循环追加写法
# 示例字典:商品与库存
inventory = {"笔记本电脑": 15, "无线鼠标": 120, "机械键盘": 45}

# 传统做法:先创建空列表,再循环追加
formatted_list = []
for item, count in inventory.items():
    formatted_list.append(f"商品: {item} | 库存数量: {count}件")

print(formatted_list)
# 示例输出:
# ['商品: 笔记本电脑 | 库存数量: 15件', '商品: 无线鼠标 | 库存数量: 120件', '商品: 机械键盘 | 库存数量: 45件']
2. 列表推导式等价实现
使用列表推导式,上述四行逻辑可以收敛为单行表达式:
inventory = {"笔记本电脑": 15, "无线鼠标": 120, "机械键盘": 45}

# 列表推导式写法
formatted_list = [f"商品: {item} | 库存数量: {count}件" for item, count in inventory.items()]

print(formatted_list)
# 示例输出:
# ['商品: 笔记本电脑 | 库存数量: 15件', '商品: 无线鼠标 | 库存数量: 120件', '商品: 机械键盘 | 库存数量: 45件']
如果后续需要将这个列表合并为一个多行文本字符串,可以直接使用 "\n".join(...) 进行连接:
summary_text = "\n".join([f"- {item}: {count} 件" for item, count in inventory.items()])
print(summary_text)
# 示例输出:
# - 笔记本电脑: 15 件
# - 无线鼠标: 120 件
# - 机械键盘: 45 件
三、原理探究:遍历视图与数据解包流向
为什么推导式中必须使用 for k, v in data.items() 而不能写成 for k, v in data?理解底层的数据流向能够帮助开发者避免最常见的解包异常。
当执行 for k, v in data 时,Python 尝试对每个产出的元素进行解包赋值给 k 和 v。因为直接遍历字典只产生单个键(例如字符串 "笔记本电脑"),对单个字符串进行二元解包,会导致 Python 抛出 ValueError: too many values to unpack 或 ValueError: not enough values to unpack(取决于字符串长度是否恰好为 2)。只有 .items() 产生的每一个元素本身就是长度为 2 的元组,能够安全解包。
四、进阶格式化:对齐、精度与分支逻辑
在实际控制台报表或文本生成中,常常需要统一字段宽度以形成整齐的列,或者对浮点数进行四舍五入。此外,很多场景需要根据值的大小进行条件过滤或文字转换。
1. 列宽对齐与浮点数精度
利用 f-string 内部的格式说明符,可以在推导式中精确控制每个字段的展示样式:
{k:<12}:左对齐,总宽占 12 个字符。{k:>10}:右对齐,总宽占 10 个字符。{v:^8}:居中对齐,总宽占 8 个字符。{v:>8.2f}:右对齐,总宽 8 个字符,保留 2 位小数。
prices = {"Apple": 4.5, "Watermelon": 23.8, "Banana": 2.75}

# 格式化要求:商品名左对齐占 12 字符,价格右对齐保留两位小数
formatted_table = [f"商品: {name:<12} 单价: {price:>6.2f} 元" for name, price in prices.items()]

for line in formatted_table:
    print(line)

# 示例输出:
# 商品: Apple        单价:   4.50 元
# 商品: Watermelon   单价:  23.80 元
# 商品: Banana       单价:   2.75 元
2. 末尾 if 过滤 vs 表达式内 if-else 转换
列表推导式中可以包含两种形式的条件控制,二者的位置与功能完全不同,需要明确区分:
- 末尾 if(过滤器):位于推导式的最后,作用是决定当前键值对是否被保留到结果列表中。若条件为假,该项被直接丢弃,结果列表元素数量可能减少。
- 前端三元 if-else(值转换器):位于前面的格式化表达式内,作用是决定当前项以何种内容格式输出,不能省略 else。所有项均会生成,列表总长度不变。
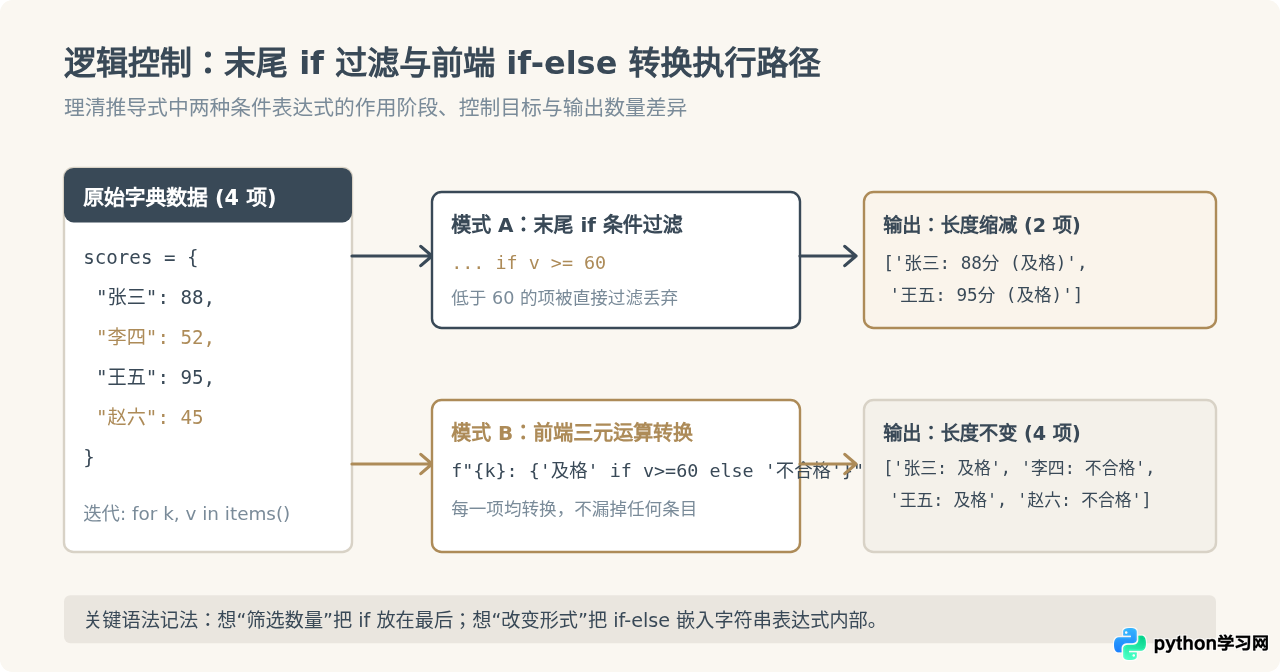
以下代码清晰演示了这两种写法的代码差异与运行效果:
scores = {"张三": 88, "李四": 52, "王五": 95, "赵六": 45}

# 场景 A:只保留及格学生并输出(末尾 if 过滤)
passed_students = [f"优秀学生: {name} ({score}分)" for name, score in scores.items() if score >= 60]
print(passed_students)
# 示例输出:
# ['优秀学生: 张三 (88分)', '优秀学生: 王五 (95分)']

# 场景 B:全员输出,但标记合格状态(前端三元表达式)
status_report = [
    f"姓名: {name:<4} 成绩: {score:>2} | 评定: {'合格' if score >= 60 else '需补考'}"
    for name, score in scores.items()
]
for r in status_report:
    print(r)
# 示例输出:
# 姓名: 张三   成绩: 88 | 评定: 合格
# 姓名: 李四   成绩: 52 | 评定: 需补考
# 姓名: 王五   成绩: 95 | 评定: 合格
# 姓名: 赵六   成绩: 45 | 评定: 需补考
五、处理复杂结构与排序输出
在工程实践中,字典的值经常是嵌套的子字典或对象,或者需要按特定次序(如按键名或按数值大小)输出文本。
1. 嵌套字典属性提取
当字典的值为另一个字典时,解包后的 v 可以继续通过键进行索引访问:
servers = {
    "web-01": {"ip": "192.168.1.10", "status": "running", "cpu": 45.2},
    "web-02": {"ip": "192.168.1.11", "status": "stopped", "cpu": 0.0},
    "db-master": {"ip": "192.168.1.20", "status": "running", "cpu": 78.5},
}

# 提取关键信息并格式化
server_logs = [
    f"主机: {host:<10} | 地址: {info['ip']:<14} | 状态: {info['status'].upper():<7} | CPU: {info['cpu']:>5.1f}%"
    for host, info in servers.items()
    if info["status"] == "running"
]

for log in server_logs:
    print(log)
# 示例输出:
# 主机: web-01     | 地址: 192.168.1.10   | 状态: RUNNING | CPU:  45.2%
# 主机: db-master  | 地址: 192.168.1.20   | 状态: RUNNING | CPU:  78.5%
2. 结合 sorted() 保持有序输出
Python 3.7+ 字典保证按插入顺序保存键值对。若希望按某种规则输出(例如按分值从高到低),可以对 data.items() 进行包裹排序:
rankings = {"Alice": 820, "Bob": 950, "Charlie": 710, "Diana": 890}

# 按分值从大到小降序输出
sorted_cards = [
    f"第 {idx} 名: {user:<8} 得分: {score}"
    for idx, (user, score) in enumerate(
        sorted(rankings.items(), key=lambda item: item[1], reverse=True),
        start=1
    )
]

for card in sorted_cards:
    print(card)
# 示例输出:
# 第 1 名: Bob      得分: 950
# 第 2 名: Diana    得分: 890
# 第 3 名: Alice    得分: 820
# 第 4 名: Charlie  得分: 710
六、常见错误排查与使用边界
错误现象:执行 [f"{k}:{v}" for k, v in my_dict] 抛出 ValueError: too many values to unpack (expected 2)。
原因分析:未调用 .items(),推导式直接遍历字典键,导致 Python 试图将单个键解构成两个变量。
修复方案:在字典后显式追加 .items()。
错误现象:在推导式中编写形如 [print(f"{k}: {v}") for k, v in d.items()]。
原因分析:print() 的返回值始终是 None,这会无意义地在内存中分配一个全是 None 的临时列表(例如 [None, None, ...]),浪费内存且不符合推导式旨在产出数据的语义。
规范做法:若目的只是打印到屏幕而不保留结果,应使用标准 for 循环,或使用 "\n".join(...) 一次性打印。
决策界限:当一个列表推导式内部出现多重循环、超过两个嵌套条件或长度超过屏幕阅读宽度时,应当果断退回传统 for 循环。列表推导式的核心优势在于简洁明了,一旦失去可读性,推导式就失去了工程价值。
七、常用模式全景速查
为了在实际编码时快速查阅并套用,以下图示和表格汇总了字典推导式格式化输出的四大常见模式:
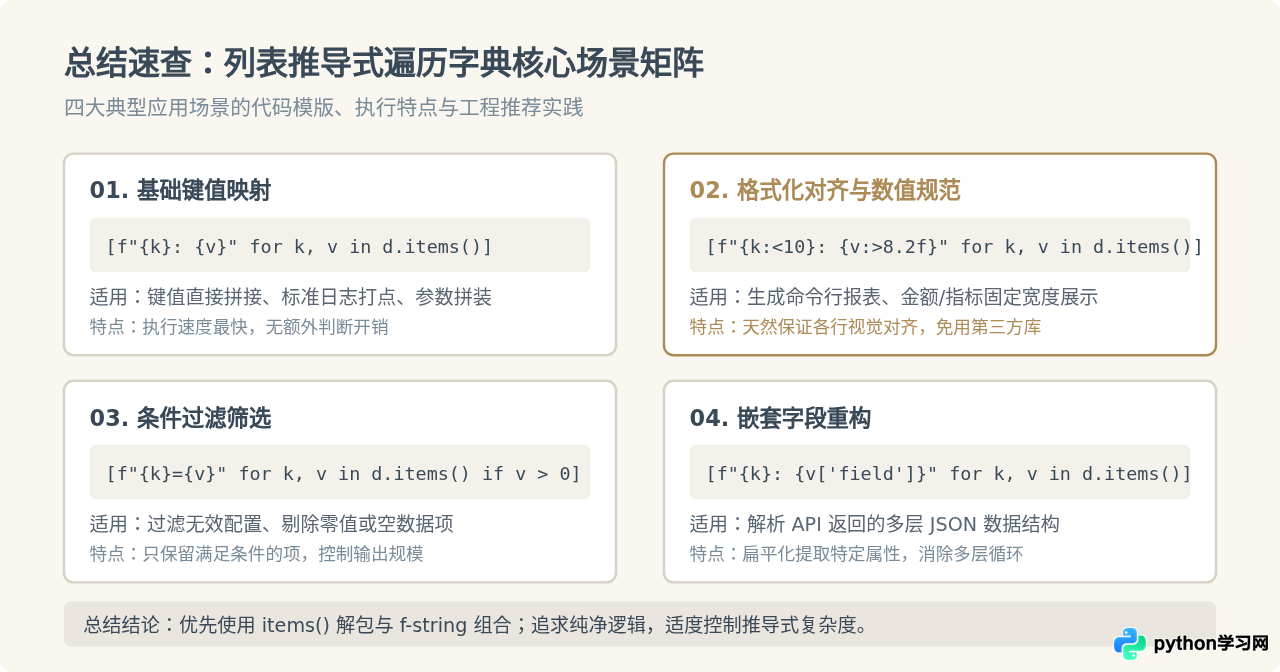
| 应用场景 | 核心代码模版 | 主要输出效果 |
|---|---|---|
| 基础键值输出 | [f"{k}: {v}" for k, v in d.items()] |
['a: 1', 'b: 2'] |
| 格式化对齐 | [f"{k:<8}: {v:>6.2f}" for k, v in d.items()] |
保持字段宽度固定,浮点数对齐 |
| 条件过滤 | [f"{k}: {v}" for k, v in d.items() if v > 10] |
只输出满足 v > 10 的条目 |
| 值转换标记 | [f"{k}: {'高' if v > 80 else '低'}" for k, v in d.items()] |
基于条件替换值的呈现文案 |
| 排序格式化 | [f"{k}: {v}" for k, v in sorted(d.items())] |
按键名字母顺序有序产出列表 |
掌握以上核心要素,开发者即可在保证代码高可读性与健壮性的前提下,充分发挥 Python 列表推导式与 f-string 的协同威力,高效完成字典数据的提取与格式化呈现。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















