


大模型指令微调数据怎么准备?JSONL格式规范与清洗技巧

指令微调是让通用大模型适应特定任务或领域风格的关键步骤,而数据质量直接决定了微调后的模型表现。许多开发者在准备数据时,往往卡在格式不规范或内容噪声过多这两个问题上。构建一个合格的微调数据集,核心在于将非结构化的原始语料转化为模型可理解的结构化指令对,并严格遵循通用的存储格式。
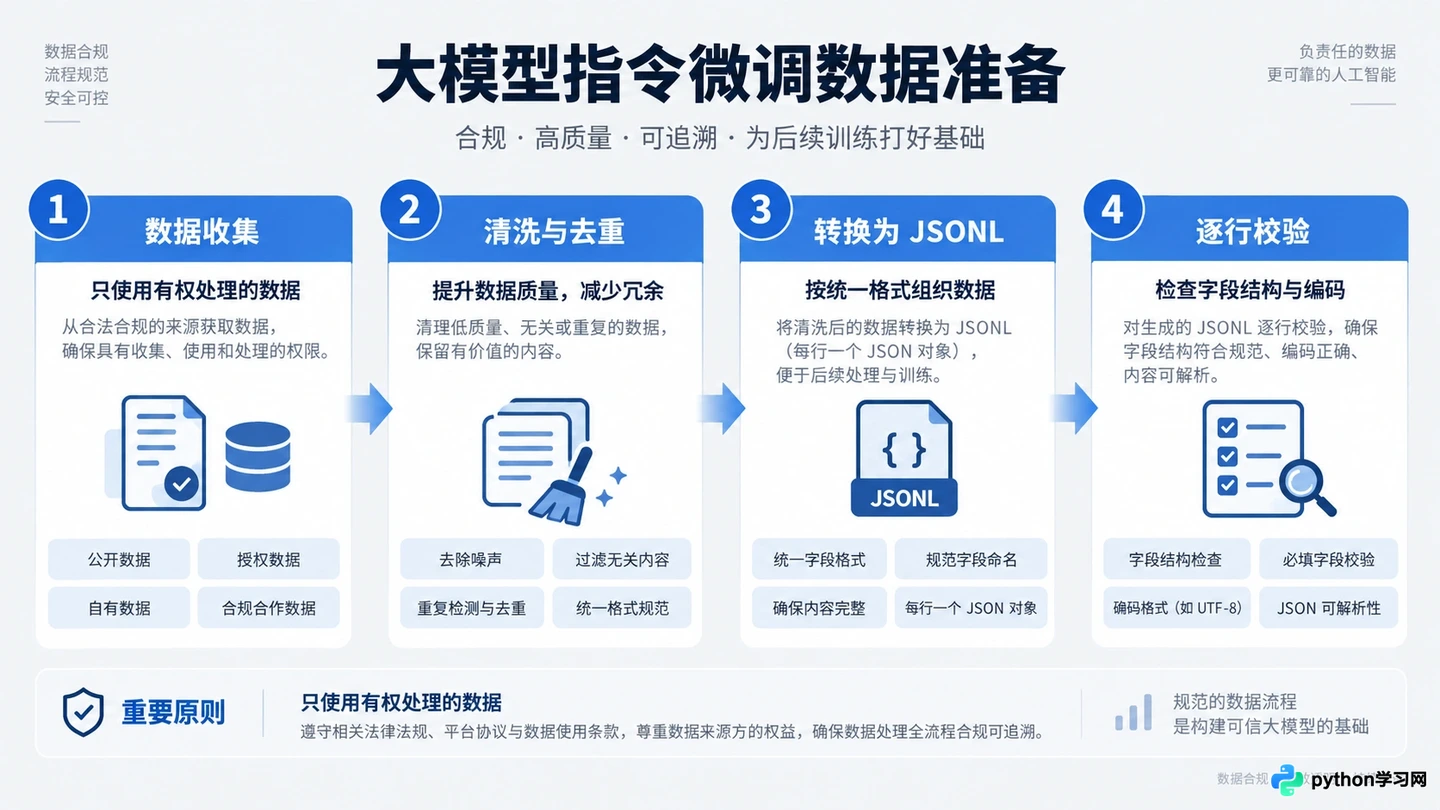
大模型微调数据准备全流程示意图
关于 JSONL 文件格式
JSONL(JSON Lines)是大模型微调中最常见的数据存储格式。与普通的 JSON 数组不同,JSONL 要求每一行都是一个独立的、合法的 JSON 对象,行与行之间没有逗号分隔,整个文件也不被方括号包裹。
这种格式的优势在于流式读取。当数据集达到数百万条时,无需一次性加载到内存,训练框架可以逐行读取并进行处理。一个标准的微调数据文件通常以 .jsonl 为后缀。
在创建文件时,需确保每行数据都能被独立解析。如果某一行出现语法错误(如缺少引号或括号不匹配),大多数训练脚本会在预处理阶段报错并停止运行。因此,保持每行的独立性是基础要求。
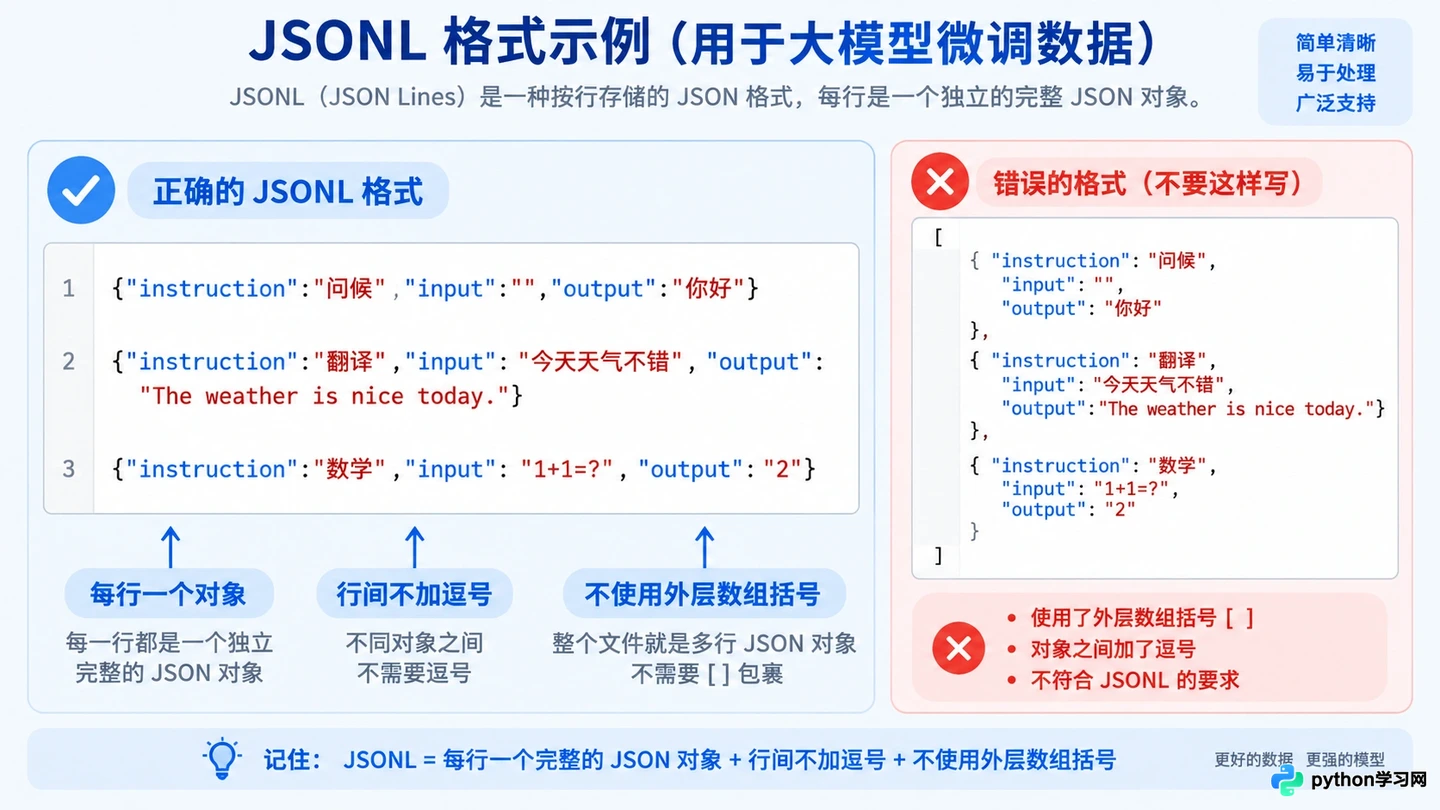
关于 JSONL 文件格式
关于 核心字段定义
虽然不同框架(如 LLaMA-Factory、Axolotl)对字段名有细微偏好,但主流指令微调数据通常包含三个核心部分:指令、输入和输出。
- instruction:描述任务的要求,例如“请将以下中文翻译成英文”或“总结这段文字的主旨”。这是模型必须遵循的核心意图。
- input:任务的上下文或具体素材。对于不需要额外上下文的任务(如常识问答),该字段可以为空字符串。
- output:期望模型生成的理想回答。这是监督信号的主要来源,要求准确、完整且符合指令要求。
部分数据集还会包含 system 字段,用于设定模型的全局角色或行为准则,如“你是一个专业的Python编程助手”。在某些格式规范中,system 内容会被拼接到 instruction 之前。
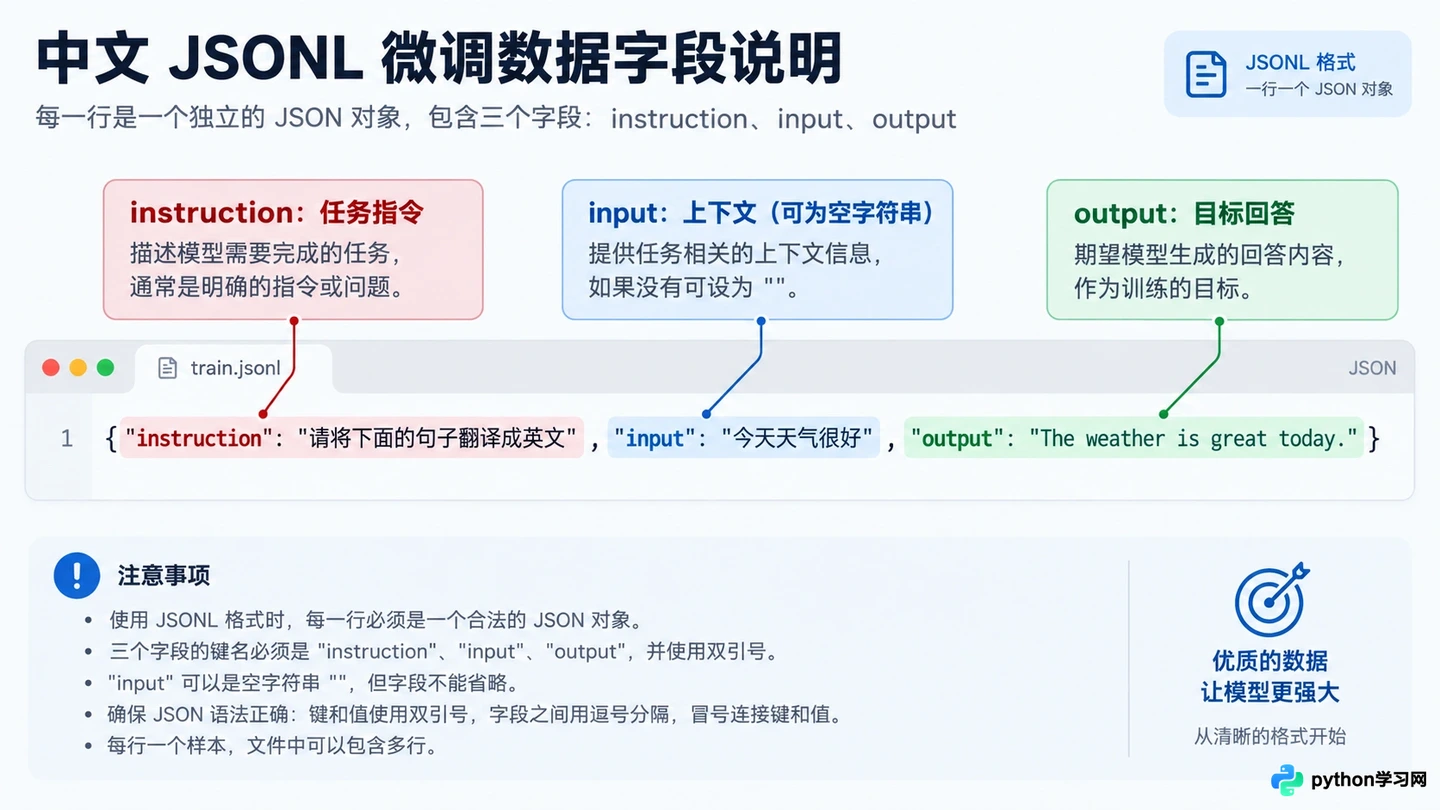
JSONL数据核心字段结构示意图
关于 数据清洗技巧
原始数据往往包含大量噪声,直接用于微调会导致模型学习到错误的格式或无关信息。清洗过程主要关注去重、格式统一和内容过滤。
首先进行去重处理。完全重复的样本不仅浪费计算资源,还可能导致模型过拟合。可以使用哈希算法对 instruction 和 input 的组合进行去重。对于语义相似但表述不同的样本,需谨慎处理,避免误删有价值的变体。
其次是长度过滤。过短的样本(如少于5个字符)可能缺乏足够的语义信息,而过长的样本可能超出模型的上下文窗口或包含无关冗余。通常建议设置最小和最大 token 数阈值,剔除极端值。
最后检查特殊字符和控制符。原始网页抓取的数据常包含 HTML 标签、不可见控制字符或乱码。应使用正则表达式移除这些非文本内容,确保只保留纯净的自然语言文本。
关于 格式转换与验证
在完成清洗后,需要将数据转换为标准的 JSONL 格式。可以使用 Python 脚本批量处理,确保每个 JSON 对象的键名一致,且值为字符串类型。
转换过程中,需注意转义字符的处理。如果 output 中包含双引号或换行符,必须在 JSON 序列化时正确转义,否则会导致解析失败。建议使用标准库中的 json.dumps 方法生成每一行数据,以保证格式的合法性。
验证环节不可或缺。编写一个简单的校验脚本,逐行读取 JSONL 文件,尝试解析每一行,并检查必需字段是否存在且非空。同时,随机抽样查看几条数据,人工确认指令与回答的逻辑一致性,确保没有发生错位或截断。
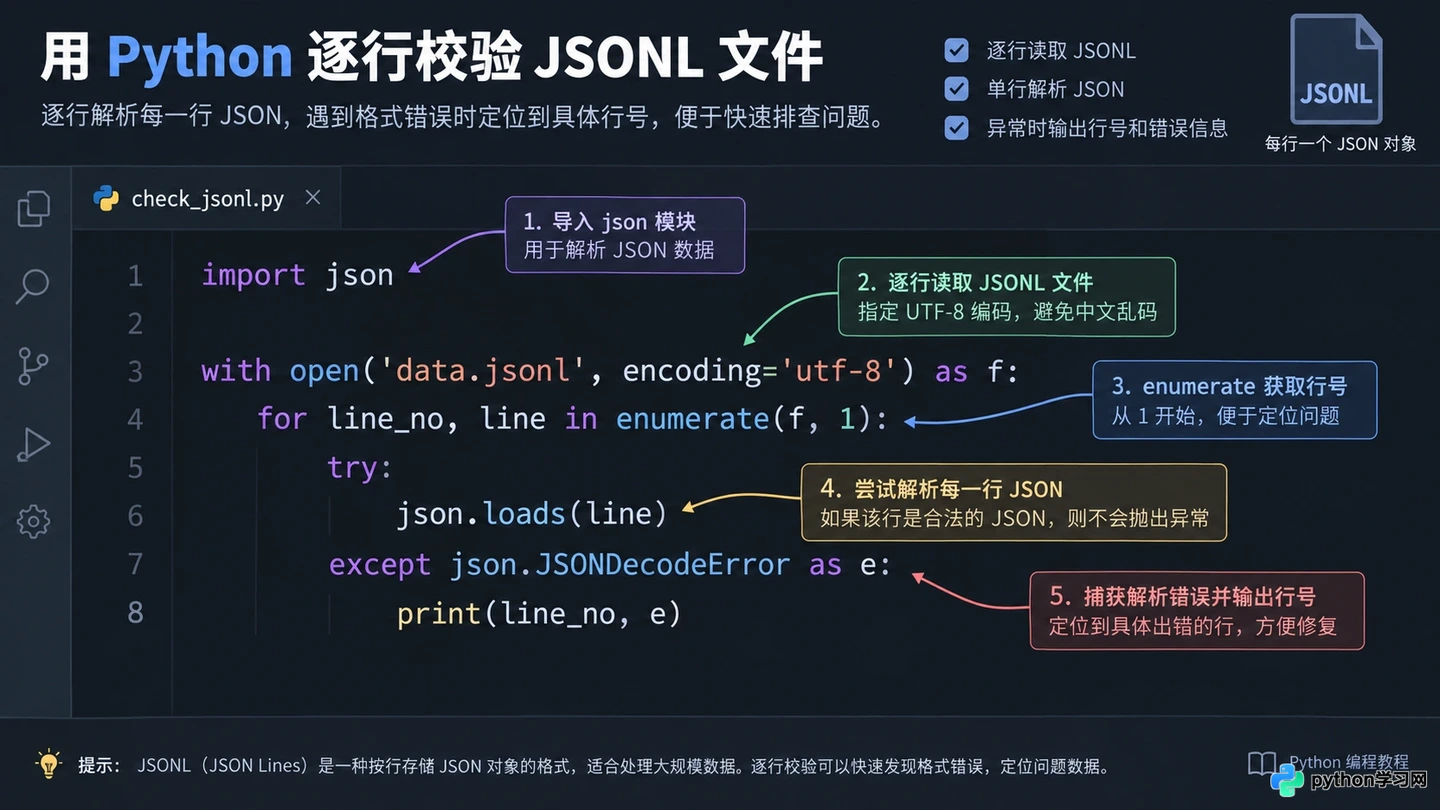
Python验证JSONL格式代码片段
关于 常见错误规避
在实际操作中,有几个高频错误需要特别留意。一是字段缺失,某些样本可能只有 instruction 而没有 output,这类样本无法提供监督信号,应予以剔除或标记为仅预训练数据。
二是格式混用。不要在同一个 JSONL 文件中混合不同的字段结构,例如前一半数据使用 prompt/response,后一半使用 instruction/output。统一的字段命名有助于训练框架的正确映射。
三是编码问题。确保文件保存为 UTF-8 编码,避免中文或其他多字节字符出现乱码。在 Linux 或 macOS 环境下,可使用 file 命令检查文件编码,或在 Python 中指定 encoding='utf-8' 进行读写操作。
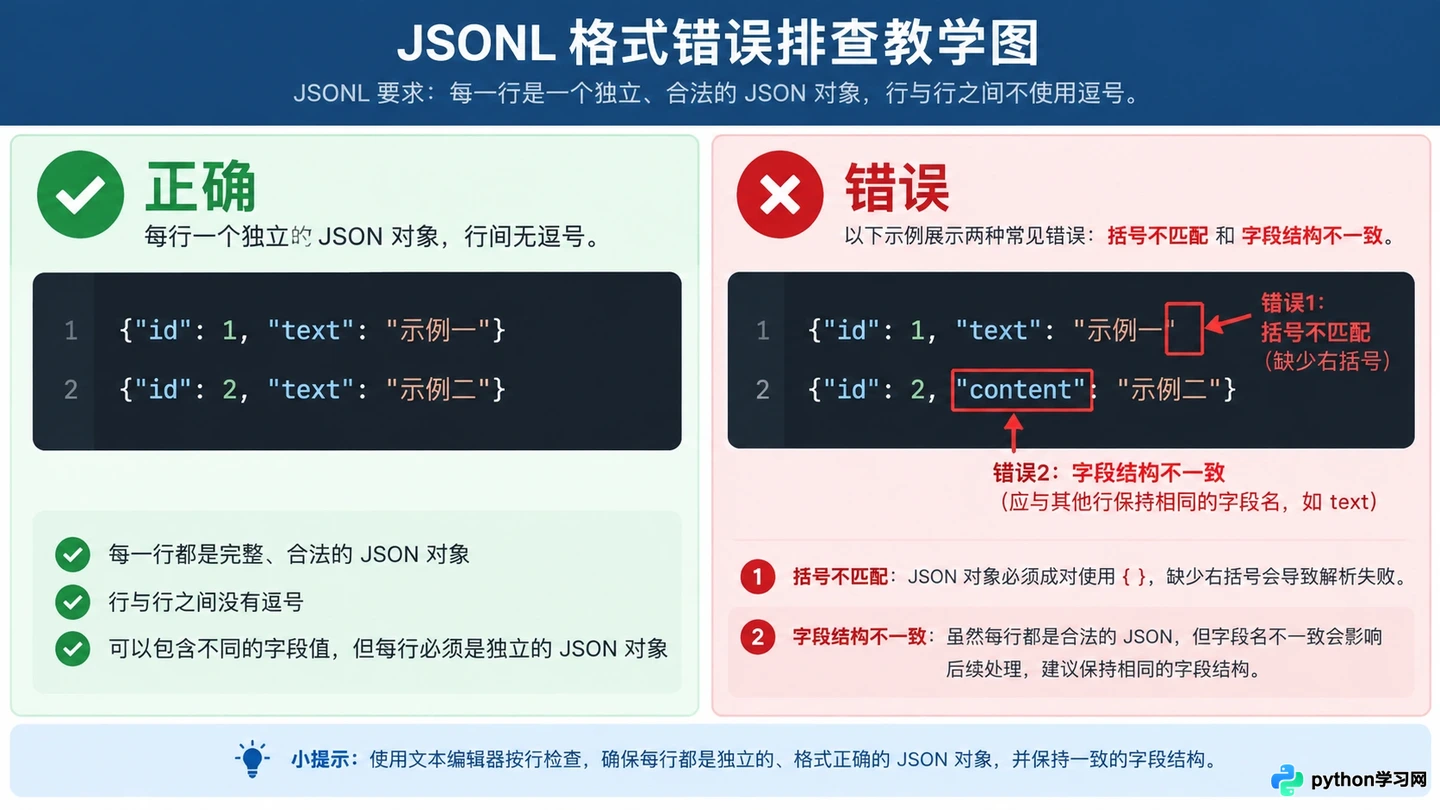
正确与错误JSONL格式对比图
准备高质量微调数据是一个迭代过程。从初步构建到最终验证,每一步都影响着模型的最终能力。遵循规范的 JSONL 格式,执行严格的数据清洗,并避开常见的格式陷阱,能为后续的模型训练打下坚实基础。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















