


适合零基础的Python实战小项目:爬虫与数据处理入门案例

如果你刚刚学完 Python 的基础语法(变量、列表、循环和函数),往往会面临不知道能用它做什么的困惑。网络爬虫与数据处理是检验编程基础最直观的方向:你只需要编写几十行代码,就能直接从互联网抓取真实的公开网页数据,完成清理并将它保存为日常使用的表格文件。本文以公开开放的练习站点为抓手,完整走通从发送网络请求、定位网页元素,到脏数据清洗与 CSV 文件持久化的全过程,帮助初学者建立扎实的数据收集与处理链路。
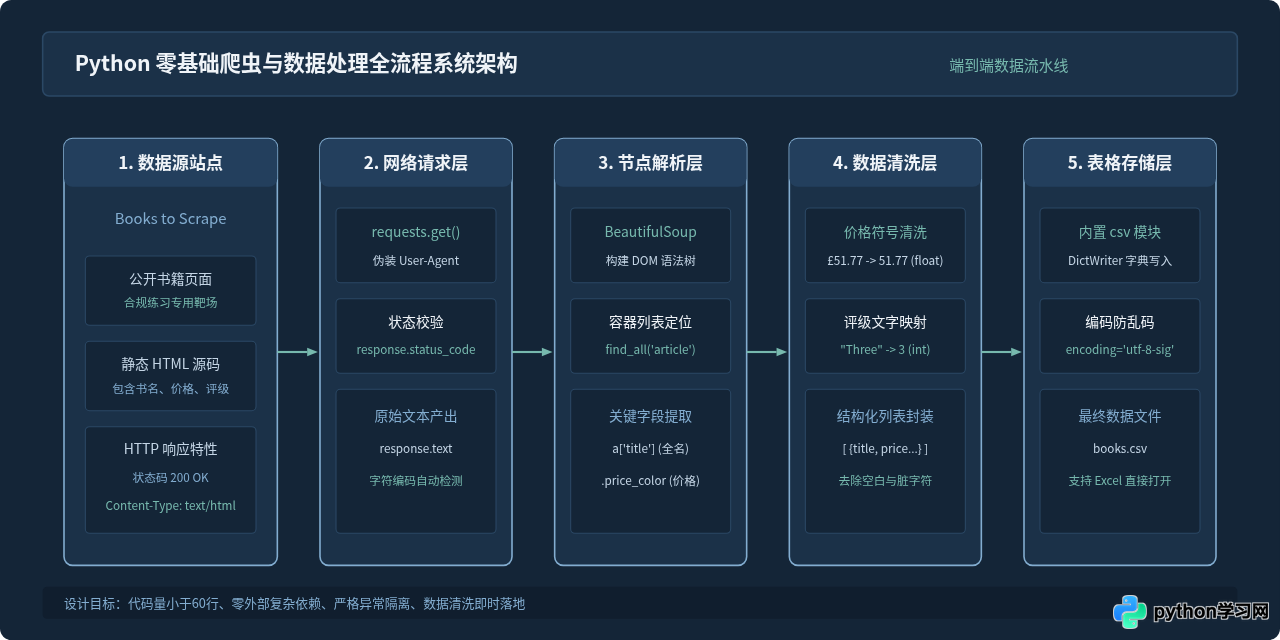
一、实战目标与环境准备
在开始写代码前,我们先明确本次实战的核心目标。我们选择业界公认的合规爬虫练习靶场 http://books.toscrape.com/ 作为数据源。该站点专为爬虫教学设计,页面结构稳定、无反爬验证码干扰,非常适合用来验证解析与清洗逻辑。
我们需要抓取并处理以下四个核心字段:
- 完整书名(Title):解决前端页面因排版缩略导致的标题截断问题;
- 价格(Price):剥离货币符号,转换为可参与数学计算的浮点数(float);
- 星级评级(Rating):将英文单词(如 One、Three)映射为整数 1 到 5;
- 库存状况(In Stock):提取并整理是否有货的明确状态。
1. 依赖库安装
本项目仅需两个轻量级第三方库:requests(用于发送网络请求并接收 HTML 内容)和 beautifulsoup4(用于解析 HTML 树结构并提取目标数据)。文件保存使用 Python 自带的 csv 标准库,无需额外安装。
在你的命令行(终端或 PowerShell)中执行以下安装命令:
pip install requests beautifulsoup4建议使用 Python 3.8 及以上版本。安装完成后,可以在命令行输入 python -c "import requests, bs4; print('环境准备就绪')" 进行验证,若输出提示语且无报错,即可进入下一步。
二、发送网络请求与检查响应状态
爬虫的第一步是让程序模仿浏览器的行为,向目标网址发起 HTTP GET 请求,并拿回服务器返回的网页源代码。很多初学者写爬虫最容易遇到的问题是:请求发出了,但拿到的是 403 拒绝访问或空内容。这是因为默认的 Python 请求头没有携带浏览器标识。
通过在请求中添加简单的 headers 参数,指定常见的 User-Agent,可以避免大部分基础的客户端拦截。
import requests

url = "http://books.toscrape.com/catalogue/page-1.html"
headers = {
    "User-Agent": "Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/120.0.0.0 Safari/537.36"
}

response = requests.get(url, headers=headers, timeout=10)

if response.status_code == 200:
    print(f"请求成功,获取网页长度:{len(response.text)} 字符")
else:
    print(f"请求失败,HTTP 状态码:{response.status_code}")
当执行上述代码并看到 请求成功 时,说明 response.text 中已经存储了完整的 HTML 文档。接下来我们需要深入文档内部,找到每本书对应的 HTML 标签。
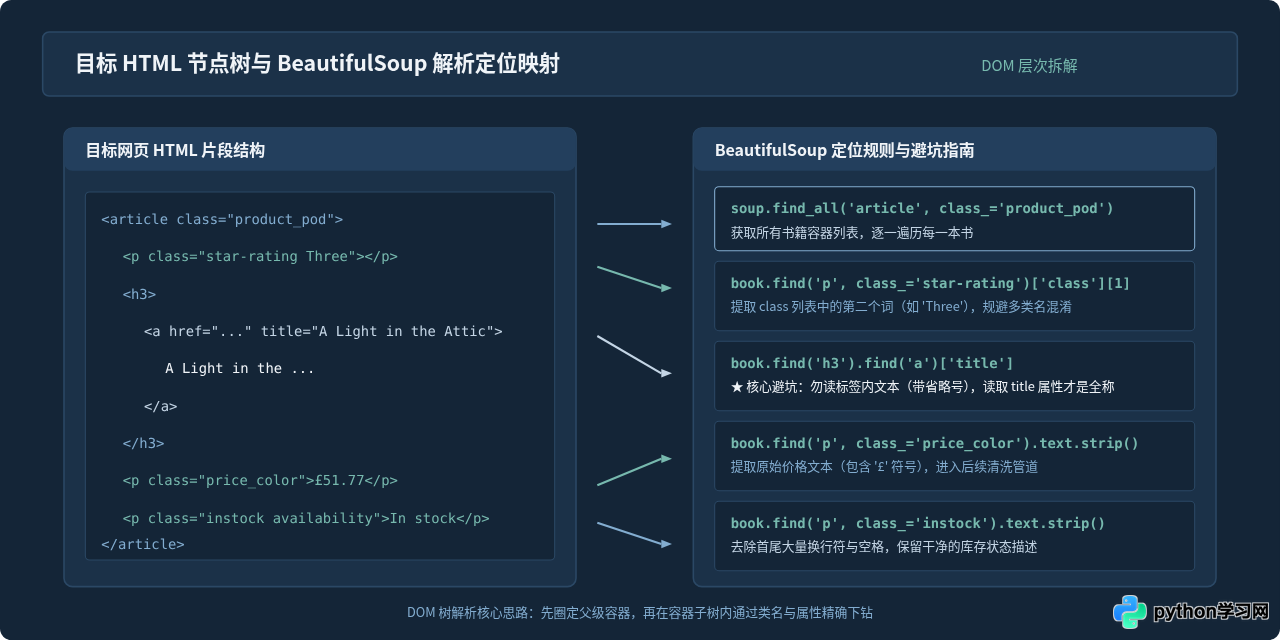
三、解析 HTML 节点与规避常见陷阱
在拿到 response.text 之后,我们使用 BeautifulSoup(response.text, "html.parser") 将其转化为可遍历的 DOM 对象。初学者在定位元素时,最容易踩进两个陷阱:
- 书名截断问题:在页面上,长书名通常显示为
A Light in the ...。如果你使用a.text,提取到的只是不完整的缩略文本。在审查元素时可以发现,完整书名被完整保存在<a>标签的title属性中。因此应使用a["title"]提取属性值。 - 多类名(Class)解析:星级评级标签的类名为
star-rating Three。BeautifulSoup 在解析class属性时会返回一个列表['star-rating', 'Three']。直接提取列表第二个元素即可获取具体的评级英文词汇。
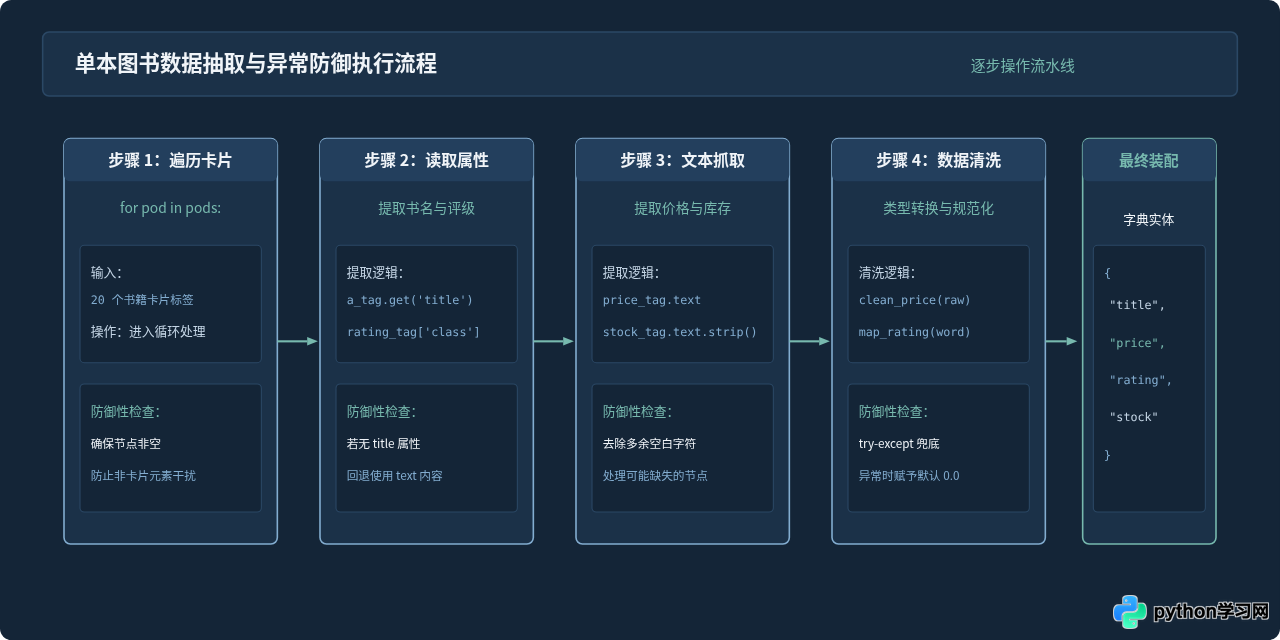
四、数据清洗与结构化转换
直接从网页提取出的数据被称为“脏数据”:数字带有货币符号(如 £51.77)、评级是纯英文单词(如 Three)、库存描述包含多余的前后换行与空格。如果直接写入表格,后续将无法进行价格排序、计算平均价格或按评分筛选。
数据清洗的核心任务就是把文本字符串转换成标准类型:
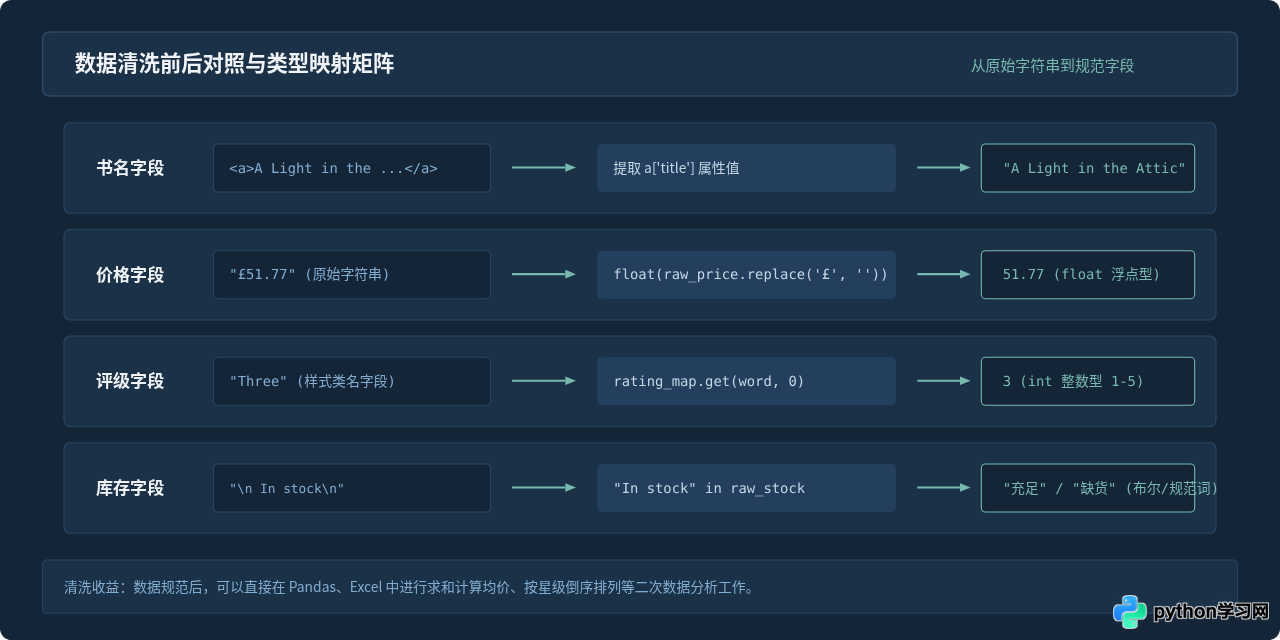
五、完整实战代码与数据持久化
下面是将网络请求、节点提取、数据清洗与 CSV 存储串联起来的完整可执行代码。我们使用内置的 csv.DictWriter,以字典列表的形式批量写入数据。为了防止在 Windows 系统下的 Excel 打开 CSV 时出现中文乱码,我们显式指定编码格式为 utf-8-sig。
import csv
import requests
from bs4 import BeautifulSoup

def clean_price(price_str):
    """剔除货币符号并转换为浮点数"""
    clean_str = price_str.replace("£", "").replace("Â", "").strip()
    try:
        return float(clean_str)
    except ValueError:
        return 0.0

def clean_rating(rating_class_list):
    """将英文评分映射为对应的整数 1-5"""
    rating_map = {
        "One": 1,
        "Two": 2,
        "Three": 3,
        "Four": 4,
        "Five": 5
    }
    for item in rating_class_list:
        if item in rating_map:
            return rating_map[item]
    return 0

def scrape_books(target_url):
    """请求网页并提取结构化图书数据"""
    headers = {
        "User-Agent": "Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/120.0.0.0 Safari/537.36"
    }
    response = requests.get(target_url, headers=headers, timeout=10)
    response.encoding = "utf-8"

    if response.status_code != 200:
        print(f"请求失败,状态码: {response.status_code}")
        return []

    soup = BeautifulSoup(response.text, "html.parser")
    book_pods = soup.find_all("article", class_="product_pod")

    books_data = []
    for pod in book_pods:
        # 1. 提取完整书名
        a_tag = pod.find("h3").find("a")
        title = a_tag.get("title", a_tag.text.strip())

        # 2. 提取并清洗价格
        raw_price = pod.find("p", class_="price_color").text
        price = clean_price(raw_price)

        # 3. 提取并映射星级
        rating_tag = pod.find("p", class_="star-rating")
        rating_classes = rating_tag.get("class", [])
        rating = clean_rating(rating_classes)

        # 4. 提取库存状态
        stock_text = pod.find("p", class_="instock").text.strip()
        in_stock = "有货" if "In stock" in stock_text else "缺货"

        books_data.append({
            "书名": title,
            "价格(英镑)": price,
            "星级评级": rating,
            "库存状态": in_stock
        })

    return books_data

def save_to_csv(data_list, output_filename="books.csv"):
    """将数据安全保存为 UTF-8-SIG 编码的 CSV 文件"""
    if not data_list:
        print("未获取到有效数据,跳过保存。")
        return

    fieldnames = ["书名", "价格(英镑)", "星级评级", "库存状态"]
    with open(output_filename, mode="w", newline="", encoding="utf-8-sig") as f:
        writer = csv.DictWriter(f, fieldnames=fieldnames)
        writer.writeheader()
        writer.writerows(data_list)

    print(f"数据已成功保存至 {output_filename},共计 {len(data_list)} 条记录。")

if __name__ == "__main__":
    target_page = "http://books.toscrape.com/catalogue/page-1.html"
    print("开始抓取图书数据...")
    scraped_data = scrape_books(target_page)
    save_to_csv(scraped_data, "books.csv")
运行结果与示例输出
在安装好依赖的环境中直接运行该脚本,终端将输出:
开始抓取图书数据...
数据已成功保存至 books.csv,共计 20 条记录。
在脚本同目录下会生成名为 books.csv 的文件。使用 Excel 或文本编辑器打开,其内容示例如下:
| 书名 | 价格(英镑) | 星级评级 | 库存状态 |
|---|---|---|---|
| A Light in the Attic | 51.77 | 3 | 有货 |
| Tipping the Velvet | 53.74 | 1 | 有货 |
| Soumission | 50.10 | 1 | 有货 |
| Sharp Objects | 47.82 | 4 | 有货 |
| Sapiens: A Brief History of Humankind | 54.23 | 5 | 有货 |
六、零基础避坑与进阶指引
完成单页抓取与存储后,你在向多页爬虫或更复杂项目扩展时,需要注意以下常见问题:
- AttributeError: 'NoneType' object has no attribute 'text':这是初学爬虫最频繁遇到的报错。原因在于页面上某些卡片缺失特定元素,
find()返回了None,对其调用.text时程序崩溃。建议始终对可能缺失的标签进行非空判断或封装带有try-except的提取辅助函数。 - 分页 URL 的生成规律:观察第二页、第三页的地址,例如
catalogue/page-2.html。你可以利用 Python 的f-string(例如f"http://books.toscrape.com/catalogue/page-{page}.html")写一个简单的for page in range(1, 6):循环,轻松实现抓取前 5 页的 100 本图书。 - 请求礼貌与抓取间隔:当抓取多页数据时,必须在每次循环中导入
time模块并调用time.sleep(1),主动在请求之间停顿 1 秒左右。这不仅是网络爬虫的道德准则,也能有效防止因并发过高而被对端服务器临时拉黑 IP。
七、总结
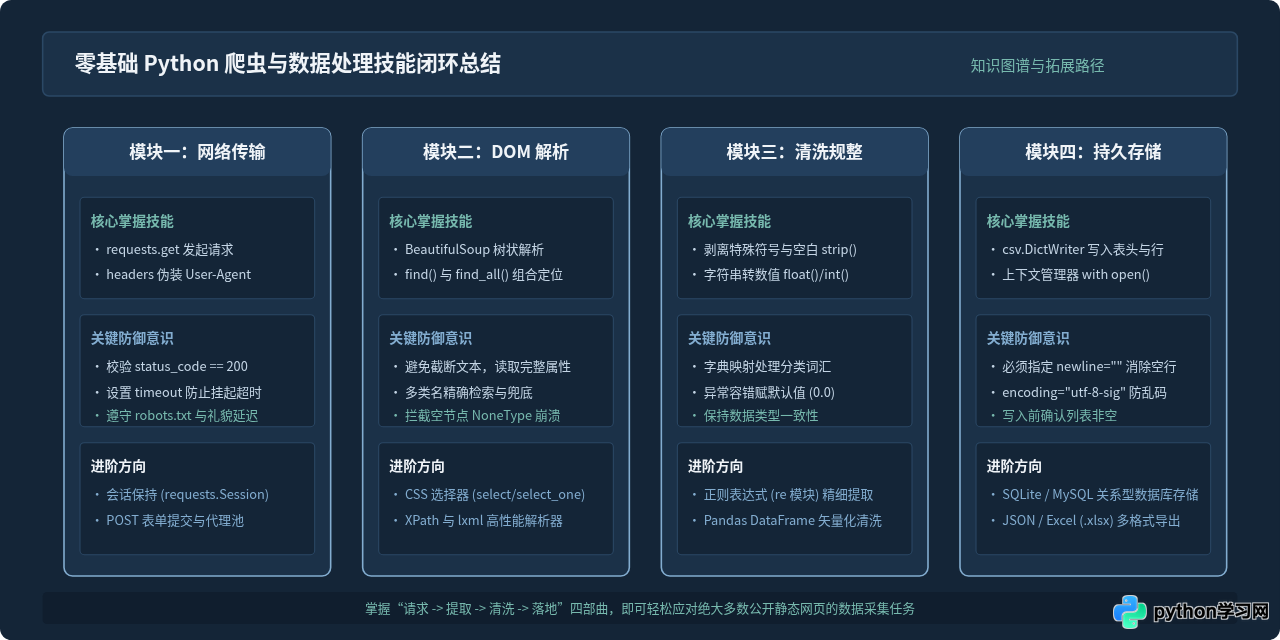
通过这个小项目,我们不仅掌握了 requests 和 BeautifulSoup 的核心语法,更重要的是建立了一套严谨的数据处理思维:网络数据并非“抓下来就算完成”,它必然经历网络请求拦截防御、精准 DOM 节点寻址、字段类型转换清洗以及最终的规范化持久存储。掌握这一完整的闭环流程后,无论面对何种类型的公开静态网页,你都能从容设计出稳定可靠的自动化数据采集脚本。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















